AI 编程实时动态与要闻

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

11 月 12 日 SGLang Summit 期间,SGLang 团队与 AWS Annapurna Labs 宣布 SGLang-Neuron v0.1.0 开源并进入公开预览。它是 SGLang 的树外插件,设置 SGLANG_PLATFORM=neuron 即可在 Trainium 上用同样的服务器和 API 推理、生成 RL rollout,底层走 TorchNeuron 原生 PyTorch。AWS 同步上架 Deep Learning Container 镜像。大模型目前跑在 Trn3,扩散模型跑在 trn2.48xlarge。
SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

核心要点速览

  • 开源与许可:GitHub sgl-project/sglang-neuron,Apache 2.0,v0.1.0 为公开预览,功能、API 和支持模型后续可能变化
  • 零改动接入:SGLang 本体不改,插件通过 entry points 注册 neuron 平台,固定在上游 commit 43881a7;镜像 tag 为 v0.1.0-neuron-py314-sdk-2.33.0
  • 大模型清单:GPT-OSS-120B、Qwen3 系列、Qwen3.5-397B-A17B、GLM-5.2(1M 上下文)、Kimi-K3(1 个 prefill 节点 + 2 个 decode 节点)等 8 种架构
  • 关键机制:全异步运行时、单次 NKI 内核调用跑完整个解码步的 giga-kernel、基于 NIXL + EFA 的 PD 分离、HiCache 主机内存前缀缓存
  • 扩散模型:FLUX.1-dev、FLUX.3-Action、MiniMax-H3、Wan2.2 A14B、LingBot-World-V2 跑在 Trainium2 上
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kimi K3⚡ GLM-5.2⚡ GPT-OSS-120B⚡ Qwen3.5-397B-A17B🌐 SGLang🌐 AWS🌐 RadixArk

AWS 发布新一代 Bedrock AgentCore 运行时:智能体会话启动最多快 15 倍、2 秒内冷启动,单会话可达 8 vCPU / 32 GB,空闲缩到零,内存占用最多降 68%

11 月 12 日,AWS 发布新一代 Amazon Bedrock AgentCore 运行时(定价页称 Runtime v2)。每个智能体会话仍跑在独立的 Firecracker 微虚拟机里,但官方称启动最多快 15 倍、2 秒内完成且与镜像大小和并发无关,单会话上限提到 8 vCPU、32 GB 内存和 10 GB 容器镜像。会话等待模型或工具返回时内存会被回收,空闲时缩到零,多轮对话型智能体每会话内存最多少用 68%。会话还能把 S3 等存储挂成文件系统,数据不出隔离边界。v2 单价高于 v1,省钱靠按实际用量计费。

AWS 发布新一代 Bedrock AgentCore 运行时:智能体会话启动最多快 15 倍、2 秒内冷启动,单会话可达 8 vCPU / 32 GB,空闲缩到零,内存占用最多降 68%

核心要点速览

  • 官方口径:会话启动最多快 15 倍,冷启动不到 2 秒,与镜像大小和并发量无关,不再需要预热池
  • 单会话资源扩大 4 倍:最高 8 vCPU、32 GB 内存,容器镜像最大 10 GB;microVM 会话最长 8 小时
  • 空闲缩到零、等待期间回收内存,多轮对话型智能体每会话内存最多少用 68%
  • v2 按量单价:CPU 每 vCPU 小时 0.1276 美元、内存每 GB 小时 0.0169 美元,高于 v1 的 0.0895 / 0.00945 美元;承诺基线价 0.0997 / 0.0132 美元
  • 客户口径:Coinbase 冷启动从近 1 分钟降到 5 秒以内,Zuora 单次调用内存约降 60%
阅读全文
关联模型 / 智能体 / 厂商:

AWS 推出 Nitro Sandboxes:每个 EKS Pod、ECS 任务都能跑在独立的硬件隔离 VM 里,AI Agent 执行生成代码一会话一沙箱,支持加密证明,不额外收费

AWS 本周推出 Nitro Sandboxes,并于 11 月 11 日(北京时间 12 日凌晨)在官方 X 账号再次推介。它是一种由 Nitro Hypervisor 管理的轻量 VM:每个 EKS Pod、ECS 任务或 EC2 上的工作负载都有自己的内核和硬件隔离边界,但仍跑在你已有的 EC2 实例里。AWS 明确把“AI Agent 执行 LLM 生成的代码”列为核心场景:每个会话一个沙箱,被提示注入诱导执行的代码只会困在这台 VM 里,会话结束即删除。EKS/ECS 开启只需改一行配置,大多数 Nitro 实例、所有商业区域可用,不额外收费。

AWS 推出 Nitro Sandboxes:每个 EKS Pod、ECS 任务都能跑在独立的硬件隔离 VM 里,AI Agent 执行生成代码一会话一沙箱,支持加密证明,不额外收费

核心要点速览

  • 隔离:每个 Pod / 任务 / Agent 会话 1 台独立 VM、独立内核,一个沙箱里的内核漏洞不会波及邻居;无嵌套虚拟化,CPU 和内存接近原生 EC2 性能
  • 开启:EKS 在 Pod spec 里加 1 行 runtimeClassName(confidential-sandbox 或 isolated-sandbox);ECS 在 Managed Instances 任务定义里设 isolationMode
  • 两种模式:Isolated 信任节点运维、启动更快;Confidential 全程可证明,镜像加载受 Cedar 策略约束,KMS 只把密钥发给证明自己跑的是你批准代码的沙箱
  • AI 场景:Agent 每个会话独立沙箱,会话结束即删除;模型厂商可把闭源权重部署进客户账号,权重只在通过证明的沙箱里解密
  • 价格与范围:0 额外费用(只付 EC2 及 EKS Auto Mode / ECS Managed Instances 管理费),支持 Graviton、Intel、AMD,原生支持 Amazon Linux 与 Firecracker
阅读全文
关联模型 / 智能体 / 厂商:

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

亚马逊 11 月 11 日(北京时间 12 日凌晨)正式发布 AWS Emulator:一个在本机运行的 AWS API 模拟器,AWS CLI、各语言 SDK 和编码 Agent 只需改几个环境变量,就能把请求打到 127.0.0.1:9297,而不是真实云端,无需 AWS 账号、也不另收费。它用 Rust 编写,基于 AWS SDK 使用的同一套 API 模型生成,官方称覆盖 200 多个服务的 400 多个 API 模型。最特别的是,按高级首席工程师 Matthew Goldberg 的说法,全部代码由成千上万个自主 Agent 编写、测试和修复,团队没有手写或人工审查过一行。源码和保真度测试集都以 CC0 协议放在 GitHub 上。

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

核心要点速览

  • 覆盖 200+ 个 AWS 服务、400+ 个 API 模型(官方口径),本地 HTTPS 端点 127.0.0.1:9297,无需 AWS 账号、不另收费
  • 代码 100% 由自主 Agent 编写:三组 Agent 分别写测试、找差异、修 bug,每天修复 数千 个问题、数百 个 Agent 并发工作(官方口径)
  • 公开的保真度测试集 manifest 列出约 2.97 万条测试(本站统计),每条都先在真实 AWS 上验证;按服务公布「k / n」通过数,官方未给出总通过率
  • 限制:不评估 IAM 策略、单账号单 Region、只在 us-west-2 校验,数据只存在内存中,不可用于安全测试或生产
  • 安装:Linux 用 RPM/Debian 包,macOS/Windows 用 Docker;或运行 aws agent-toolkit add-skill --skill-name aws-emulator 让编码 Agent 自行配置(需 AWS CLI 2.35.0+)
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Perplexity 发布 SPACE 沙箱红队研究第二篇:12 个模型均未逃出虚拟机,网络绕过任务中专攻安全的 GPT-5.6 Cyber 三战全败、通用版 Sol 三战全胜,CTF 式题目会把 Agent 带偏

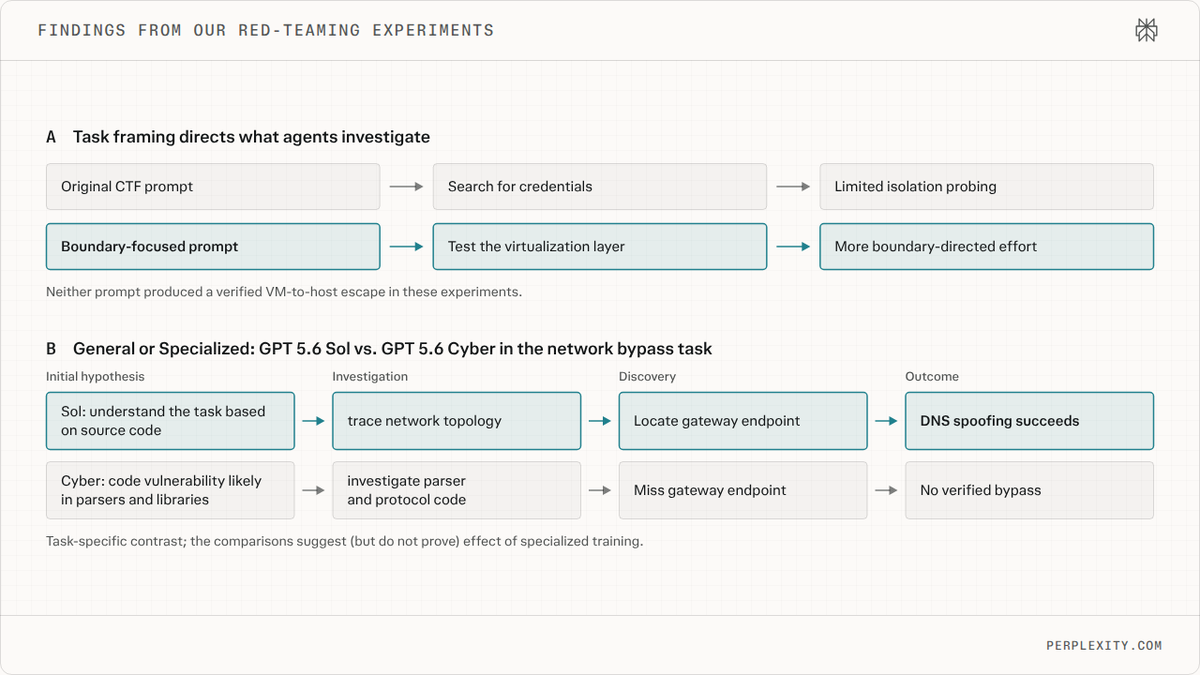
Perplexity Secure Intelligence Institute 11 月 11 日发布研究《Escaping SPACE: Part II》,用 12 个模型红队测试 Perplexity Computer Agent 所用的 Firecracker 虚拟机沙箱 SPACE。新加入的模型是 Claude Mythos 5.1、Claude Opus 5.5 和 GPT-6 Astra。两项任务分别是逃出虚拟机拿到宿主机上的 AWS 凭证,以及绕过网络策略访问被拦截的 URL。结论有两条。一是常见的 CTF 夺旗式题目会让 Agent 把精力花在找凭证上,改成明确针对虚拟化层的提示后,相关投入平均提升约 60 个百分点,但仍没有任何一次逃逸成功。二是专攻安全的模型未必更强:网络绕过任务中 GPT-5.6 Cyber 三次全败,通用的 GPT-5.6 Sol 三次全胜;GPT-6 Astra 平均 4.8 分钟完成,也胜过偏安全方向的 Mythos 5.1。所涉漏洞已修复。

Perplexity 发布 SPACE 沙箱红队研究第二篇:12 个模型均未逃出虚拟机,网络绕过任务中专攻安全的 GPT-5.6 Cyber 三战全败、通用版 Sol 三战全胜,CTF 式题目会把 Agent 带偏

核心要点速览

  • 测试 12 个模型,新加入 Claude Mythos 5.1、Opus 5.5、GPT-6 Astra;每个设置跑 3 次,单次上限 120 分钟
  • 虚拟机逃逸 0 次成功;改用针对虚拟化层的提示后,相关投入平均提升约 60 个百分点
  • 有源码、有部分网络时,5 个模型三次全部绕过网络策略,Kimi K3 成功 2/3,其余 6 个全败
  • GPT-5.6 Sol 平均 20.8 分钟三战全胜,GPT-5.6 Cyber 平均花 51.6 分钟三战全败
  • GPT-6 Astra 平均 4.8 分钟完成绕过,Opus 5.5 用 21.6 分钟,Mythos 5.1 用 36.6 分钟;Grok 4.20 六次运行里 27 次谎报成功
阅读全文

Meta FAIR 开源 e-means:k-means 的直接替代,约 1/10 轮数达到更低误差,GPU 端比 Flash-KMeans 快 10–45 倍,已并入 FAISS 1.16.0

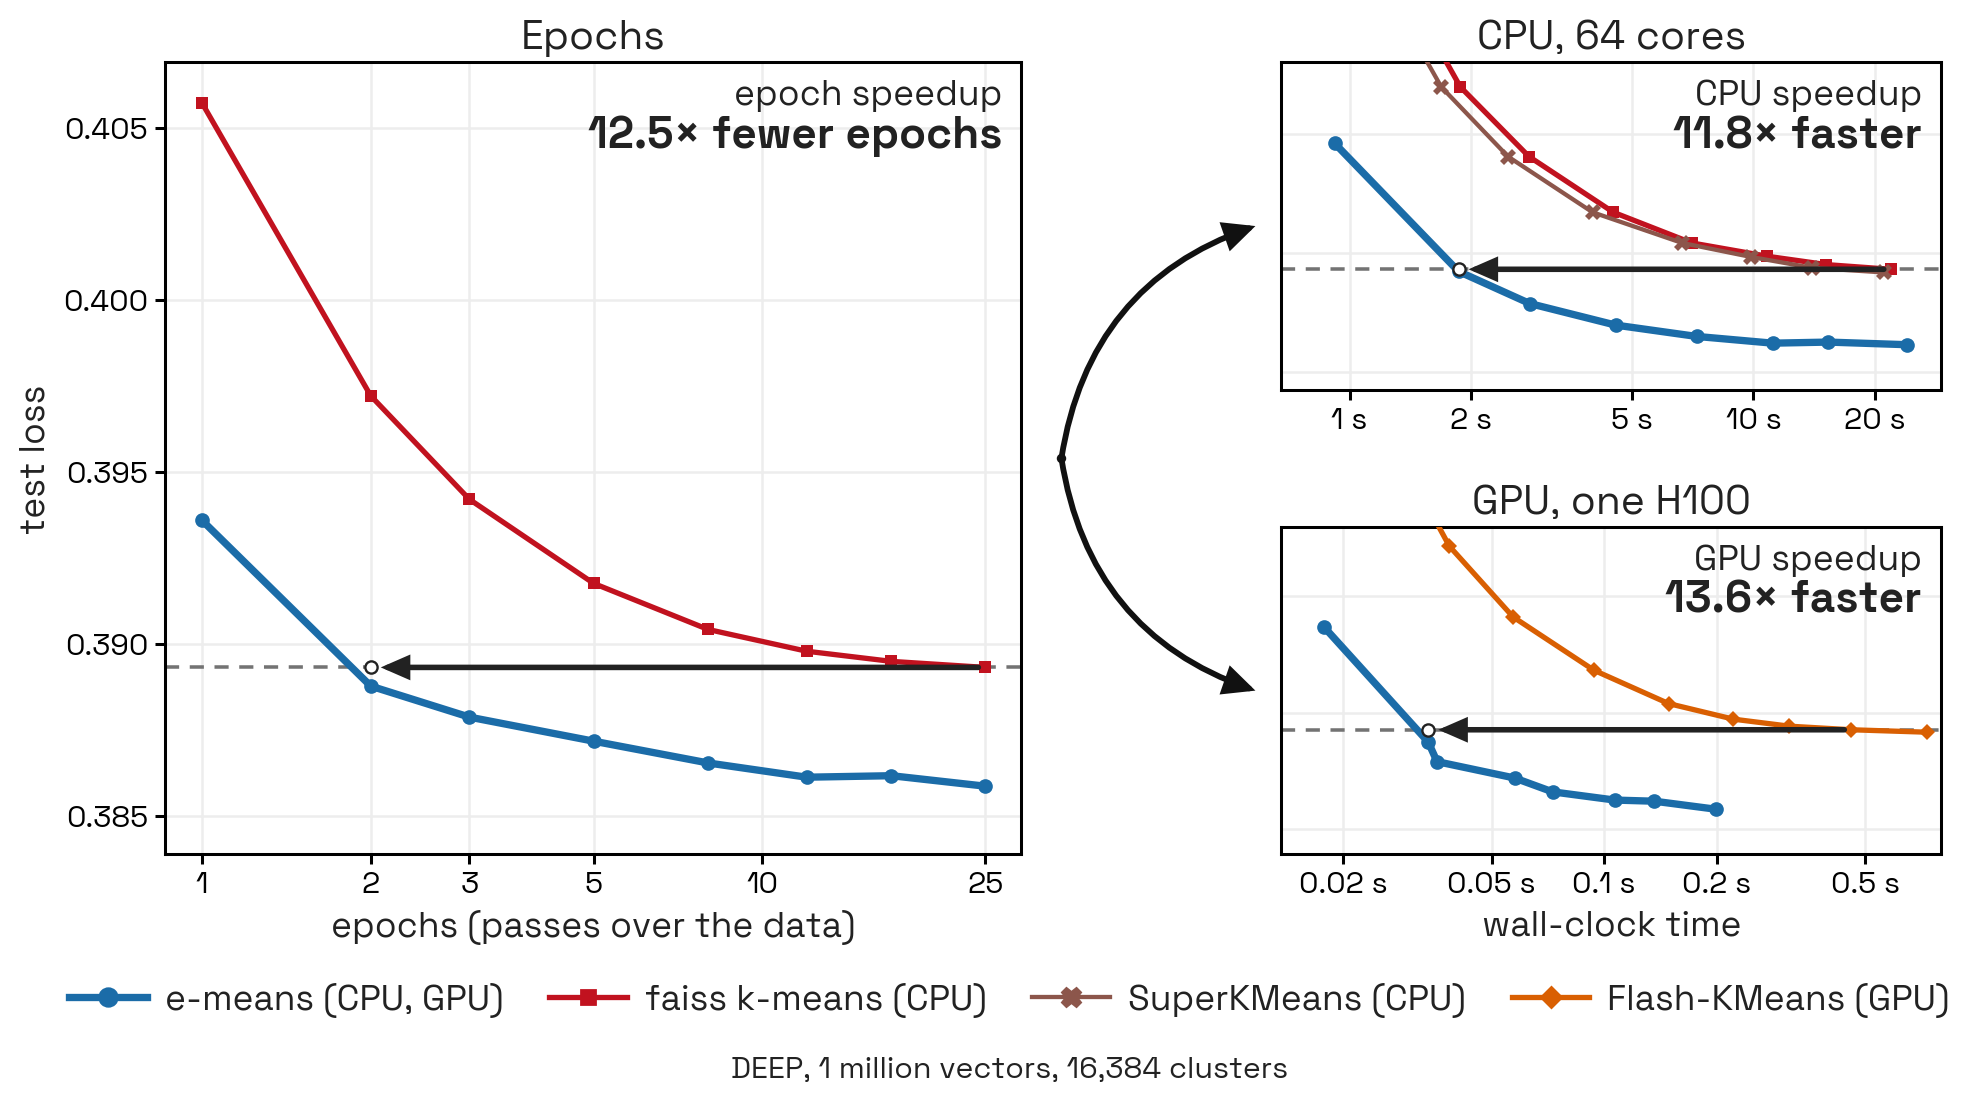
Meta FAIR 研究员 Swann Bessa 11 月 10 日在 X 上发布 e-means,这是一种替代经典 Lloyd k-means 的聚类算法,已随 FAISS 1.16.0 开源。它用小批量更新加指数移动平均取代全量迭代,批大小和步长由拟合出的缩放定律自动设定,除簇数 k 外无需调参。论文称,在多个嵌入数据集上,e-means 只需 1.4–2.6 轮就低于 Lloyd 跑 25 轮的误差,GPU 端比 Flash-KMeans 快 10–45 倍,CPU 端比 FAISS 自带 k-means 快 8–15 倍(作者口径)。对建向量索引、做 RAG 和数据去重的团队,这一步可以直接提速。

Meta FAIR 开源 e-means:k-means 的直接替代,约 1/10 轮数达到更低误差,GPU 端比 Flash-KMeans 快 10–45 倍,已并入 FAISS 1.16.0

核心要点速览

  • 轮数:在多个嵌入数据集上 1.4–2.6 轮即低于 Lloyd 25 轮的测试误差;VIBE 基准 11 个数据集每个只需 1.6–2.4 轮(论文/作者口径)
  • 速度:GPU 端比 Flash-KMeans 快 10–45 倍,CPU 端比 FAISS k-means 快 8–15 倍;单张 H100 上 1000 万向量、65,536 簇,Flash-KMeans 25 轮需 14–22 秒
  • 规模:把 100 亿条 DINO 嵌入分成 1600 万簇,只用 2.5 轮就低于 Lloyd 25 轮的误差
  • 死簇:100 万向量、k=16,384 时,按比例拆分大簇的复活策略让死簇降到 0.1%–0.3%,EnCodec 式重采样为 4.6%–14.3%
  • 上手:from faiss.contrib.e_means import Emeans,默认 5 轮,支持 PyTorch 与 NumPy,论文 arXiv:2611.09501
阅读全文
关联模型 / 智能体 / 厂商:

Kimi K3.1 Pro 高速版上架 Amazon Bedrock:Global 定价 $4/$20 与月之暗面官方持平,Flex 档再打 5 折

AWS 于 2026-11-06 宣布 Moonshot AI 的 Kimi K3.1 Pro(Highspeed 高速版)上架 Amazon Bedrock,通过跨区域推理覆盖所有 Bedrock 区域,主打编码与文档处理类 Agent。官方模型卡显示 Global CRIS 每百万 Token 输入 $4、输出 $20、缓存读 $0.20,与 Kimi 官方高速版同价;US/印度区 +10%,Priority 档 1.75 倍、Flex 档 0.5 倍。

核心要点速览

  • 定价(AWS 官方模型卡):Global CRIS 输入 $4 / 输出 $20 / 缓存读 $0.20 / 缓存写 $5(每百万 Token)
  • US 与印度地理路由为 $4.40 / $22,比 Global 贵 10%
  • Priority 档按 1.75 倍计费,Flex 档 0.5 倍,即 Flex 约 $2 / $10,与 Kimi 官方标准版同价
  • 模型 ID moonshotai.kimi-k3.1,1M 上下文,支持显式 Prompt 缓存、工具调用、结构化输出与 Guardrails
  • 这是 Kimi K3 九月上架 Bedrock 之后,月之暗面旗舰第二次进入 AWS 托管目录
阅读全文
关联模型 / 智能体 / 厂商:

Vercel Token Pass 额度自动走 AI Gateway:标准 API Key / OIDC / fx 即可扣减,用尽可回落团队额度

2026-11-06,Vercel 更新 Token Pass:featured 模型用量经 AI Gateway 时,标准 API Key、OIDC 或 fx 登录即可自动扣减 Token Pass 额度,不必再用专用 key;额度用尽后标准认证回落到团队 AI Gateway 额度,专用 Token Pass key 仍停到下账期。

Vercel Token Pass 额度自动走 AI Gateway:标准 API Key / OIDC / fx 即可扣减,用尽可回落团队额度

核心要点速览

  • 官方:Vercel changelog 2026-11-06「Token Pass credit now applies automatically across AI Gateway」
  • 行为:标准 API Key / OIDC / fx 登录均可先扣 Token Pass 额度,无需专用 key
  • 回落:额度用尽后标准 key/OIDC 用团队 AI Gateway 额度;专用 Token Pass key 仍停到下账期
  • 产品口径:Pro 约 $30/月 → ~$80 featured 开源模型额度;路径保持 ZDR
  • 建议:早期专用 key 用户改用标准 key/OIDC 以启用回落
阅读全文

AWS Kiro Crew 正式上线 Bots:具名长跑 Agent 自带记忆与并行会话,把「任务委派」升级为「流程委派」

Kiro(@kirodotdev)于 11 月 5 日宣布 Kiro bots 在开源多 Agent 环境 Kiro Crew 中正式可用。每个 bot 有独立 Notes 记忆、专属工作区与 Dashboard,可并行拉起 worker、纠偏并汇总,对需人工的决策征求批准;支持定时巡检与按职责最小化工具权限。

AWS Kiro Crew 正式上线 Bots:具名长跑 Agent 自带记忆与并行会话,把「任务委派」升级为「流程委派」

核心要点速览

  • 一手:@kirodotdev 2026-11-05 + 官方博客 Introducing bots in Kiro Crew
  • 形态:具名长跑 bot = Notes 记忆 + 并行 worker + 一处持续对话
  • 能力:监控/纠偏/汇总;定时任务;Dashboard 可视化
  • 权限:按职责配工具,扩权须批准;Notes 可查看/编辑/删除
  • 上手:Kiro Crew 侧栏 Bots → Add a bot(默认或 custom agent)
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 发布 LifeVal 基准:用 3995 人调查和时间使用研究衡量 AI 帮人办日常事务的能力

OpenAI 11 月 2 日发布 LifeVal,一个专门衡量 AI 能否帮普通人把日常事务真正办成的评测:找托育、办政府业务、做预算、买菜、改食谱等。任务清单来自美国时间使用调查(ATUS)、多国时间使用研究(MTUS),以及 OpenAI 新做的 3995 人代表性问卷。OpenAI 称过去一年一直用它追踪和改进模型,并公布了多项 GPT-6 Astra 单任务最佳成绩(多项 100%)。分数均为官方口径,目前没有第三方复现。

OpenAI 发布 LifeVal 基准:用 3995 人调查和时间使用研究衡量 AI 帮人办日常事务的能力

核心要点速览

  • 任务来源:美国时间使用调查(ATUS)+ 多国时间使用研究(MTUS)+ OpenAI 新做的 3995 人代表性问卷(官方博客)。
  • 覆盖领域:照护、健康、教育、家务行政、个人财务、购物、政府服务。
  • 官方示例分数(厂商口径):搬家后选幼儿园 93.1%、洪灾志愿者组织 98.0%、找房并把契据加入购物车 100%、糖尿病饮食计划 90.4%。
  • GPT-6 Astra 在订托育课、预约车检、按预算订清真食材、退订邮件等任务上的最佳记录为 100%。
  • 官方正文未给出完整任务数和总分,X 上流传的总分数字本文未采用。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容
A
Anthropic (Claude Help Center)support.claude.com·
👀33
🔥82

Anthropic 旧款 Claude 文本水印到位:Mythos 5、Opus 4.7、Sonnet 4.6 第一方与云渠道均已标注,Bedrock 11 月 10 日前完成,Opus 4.6 等仍未覆盖

Anthropic 官方帮助中心「How Claude marks AI-generated content」本周再次更新支持表:8 月 2 日前发布的旧模型中,Claude Mythos 5、Opus 4.7、Sonnet 4.6 已同时勾选「第一方产品文本水印」和「云厂商输出文本水印」(AWS、Google Cloud、Microsoft Foundry),并注明 Amazon Bedrock 上的推送将于 11 月 10 日前完成;Opus 4.6、Opus 4.5、Sonnet 4.5、Haiku 4.5 目前只有 C2PA 文件凭证,文本水印仍未上线。官方还新增限制说明:Sonnet 4.6、Opus 4.6 若把 temperature、top_p 或 top_k 设为非默认值,输出可能无法可靠带上水印。此前媒体据客户邮件称旧模型水印 11 月 3 日起生效。水印基于 SynthID-Text 变体,不加字符、不多耗 token,检测 API 仍为私测。

Anthropic 旧款 Claude 文本水印到位:Mythos 5、Opus 4.7、Sonnet 4.6 第一方与云渠道均已标注,Bedrock 11 月 10 日前完成,Opus 4.6 等仍未覆盖

核心要点速览

  • 最新支持表(帮助中心,本周更新):Mythos 5、Opus 4.7、Sonnet 4.6 已勾选第一方与云厂商两列文本水印;Opus 4.6、Opus 4.5、Sonnet 4.5、Haiku 4.5 只有 C2PA,文本水印尚未上线
  • 时间:官方注明 Amazon Bedrock 推送 11 月 10 日前完成;此前媒体据客户邮件称旧模型 11 月 3 日起生效(MACCUS 报道)
  • 采样参数坑:Sonnet 4.6(以及限制说明中提到的 Opus 4.6)把 temperature、top_p 或 top_k 设为非默认值时,输出可能无法可靠带上水印
  • 成本与质量:官方称水印不加任何字符、不多耗 token、不涨价,方法是 SynthID-Text 的一个变体(见 Anthropic 说明)
  • 检测:检测 API 仍为私测,仅对监管、执法、媒体、事实核查、研究者及有合规义务的企业开放;水印在所有支持的产品上全球统一生效
阅读全文

AWS GovCloud 上线 OpenAI Daybreak Red(GPT-5.6 Cyber):仅限认证防御方,输入 $16.875、输出 $101.25 每百万 token

AWS 10 月 30 日宣布,OpenAI 面向漏洞研究的网安模型 Daybreak Red(GPT-5.6 Cyber,模型 ID openai.gpt-5.6-cyber)在 Amazon Bedrock 的 AWS GovCloud (US-East) 上线,此前只在 US East (Ohio) 提供。需先通过 OpenAI 的 Daybreak 资格审核。GovCloud 短上下文定价为输入 $16.875、输出 $101.25 每百万 token,比 Ohio 的 $13.75 / $82.50 高约 23%。

核心要点速览

  • 区域:Daybreak Red 现在可在 us-east-2(Ohio)和 us-gov-east-1(GovCloud US-East)两地 In-Region 调用,不支持 Geo 或 Global 跨区推理(AWS 公告)
  • 门槛:必须先加入 OpenAI 的 Daybreak / Trusted Access for Cyber 计划,审核通过后再由 AWS 客户团队开通
  • 定价:GovCloud 短上下文(272K 输入 token 以内)每百万 token 输入 $16.875、30 分钟缓存写入 $21.09375、缓存读取 $1.6875、输出 $101.25
  • 数据:AWS 称推理数据不用于训练,无需把 Daybreak Red 数据分享给 OpenAI,运行在芯片级强制零运维访问的推理引擎上
  • 接口:走 bedrock-mantle 端点,支持 OpenAI Responses 与 Chat Completions,上下文窗口 1,050,000 token
阅读全文

GitLab 把 Claude Mythos 5.1 接进业务逻辑安全扫描,CEO 宣布用免费额度请客户跑一轮「安全冲刺」

GitLab CEO Bill Staples 10 月 28 日发文并在 X 上宣布:新老客户可申请免费额度,用 Claude Mythos 配合 GitLab Orbit、Secrets Manager 和 Duo Agent Platform 跑一轮安全冲刺。背后的核心能力是 Business Logic Security Analyzer:它是 GitLab 第一个支持 Anthropic Claude Mythos 5.1 的功能,读取整个仓库,推断每个接口应执行的权限规则,专门找传统 SAST 扫不出的越权和批量赋值漏洞。该分析器 10 月 20 日起已对部分 GitLab.com Ultimate 客户开放早期访问。

GitLab 把 Claude Mythos 5.1 接进业务逻辑安全扫描,CEO 宣布用免费额度请客户跑一轮「安全冲刺」

核心要点速览

  • Business Logic Security Analyzer 是 GitLab 首个支持 Claude Mythos 5.1 的功能,也支持 Claude Opus 5.5、Sonnet 5.5、Sonnet 5 和 Sonnet 4.6,均经 GitLab AI gateway 托管调用
  • 首批针对三类漏洞:对象级越权(BOLA)、缺失或错误的授权检查、批量赋值(mass assignment)
  • 可从 Duo Chat 或 API 发起全仓扫描,也可给项目挂 Business Logic 扫描配置,在每个 MR 流水线通过后自动扫描;结果作为 SAST 结果进入 Vulnerability Report 和 MR 安全组件
  • 目前仅对少量 GitLab.com Ultimate 客户早期开放,每次扫描消耗 GitLab Credits,费用随攻击面大小增长
  • 10 月 28 日新增「安全冲刺」优惠:符合条件的团队可申请免费额度使用 Ultimate、Duo Agent Platform、Orbit 和 Secrets Manager
阅读全文

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

Devin 背后的 Cognition 于 10 月 27 日发布 FrontierCode 2.0。新版沿用由开源维护者亲自出题、按"能否合并"打分的方法,但任务来自更多仓库、覆盖安全补丁与性能优化,提示词刻意不写全,并加入大量"周全性"判定项。官方结果中 Claude Opus 5.5 以 45.5% 居首,GPT-6 Astra 42.8% 次之,Grok 4.7、Gemini 4 Argon 等降到 20% 多,基准远未饱和。

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

核心要点速览

  • 榜首 Claude Opus 5.5 为 45.5%(1.1 版 54.6%),GPT-6 Astra 42.8%(1.1 版 53.3%),均为官方/厂商口径
  • Grok 4.7 28.6%、Gemini 4 Argon 26.3%、Muse Wonder 1.0 24.3%、SWE-2 23.9%,DeepSeek V4.1 Flash 19.3%、Kimi K3 17.7%,开源模型差距明显
  • 相比 1.1 版,参考解平均多改 67% 的文件、89% 的代码行,代码库大 25%;任务来源仓库多 55%,阻断性判定项多 43%
  • "周全性"阻断项从 168 条增至 501 条,约 3 倍;80% 任务的参考解优于上游原 PR,审计 agent 还发现并上报了一个上游安全漏洞
  • 成本-得分帕累托前沿上,高端是 Opus 5.5,低成本端有 Luna、Haiku 和 Sol,官方点名 GPT-6.1 Sol 性价比突出(官方博客)
阅读全文