AI 编程实时动态与要闻

vLLM 在英伟达 Vera Rubin NVL72 上跑 DeepSeek-V4.1-Flash:每用户 387 token/s 时单卡 170 万 token/s,为 GB300 NVL72 的 58 倍;峰值吞吐则是 2.7 倍

11 月 12 日,vLLM 发布 DeepSeek-V4.1-Flash 系列第三篇博客(Inferact 主导):在一台 Vera Rubin NVL72 上,用 SemiAnalysis AgentX 负载测得每用户 P90 387 token/s 时单 GPU 总吞吐 170 万 token/s,是 GB300 NVL72 同一交互速度下的 58 倍;峰值吞吐 252 万 token/s/GPU,是 GB300 的 2.7 倍。58 倍只对应高交互速度这一点,Rubin 数据为预览结果。
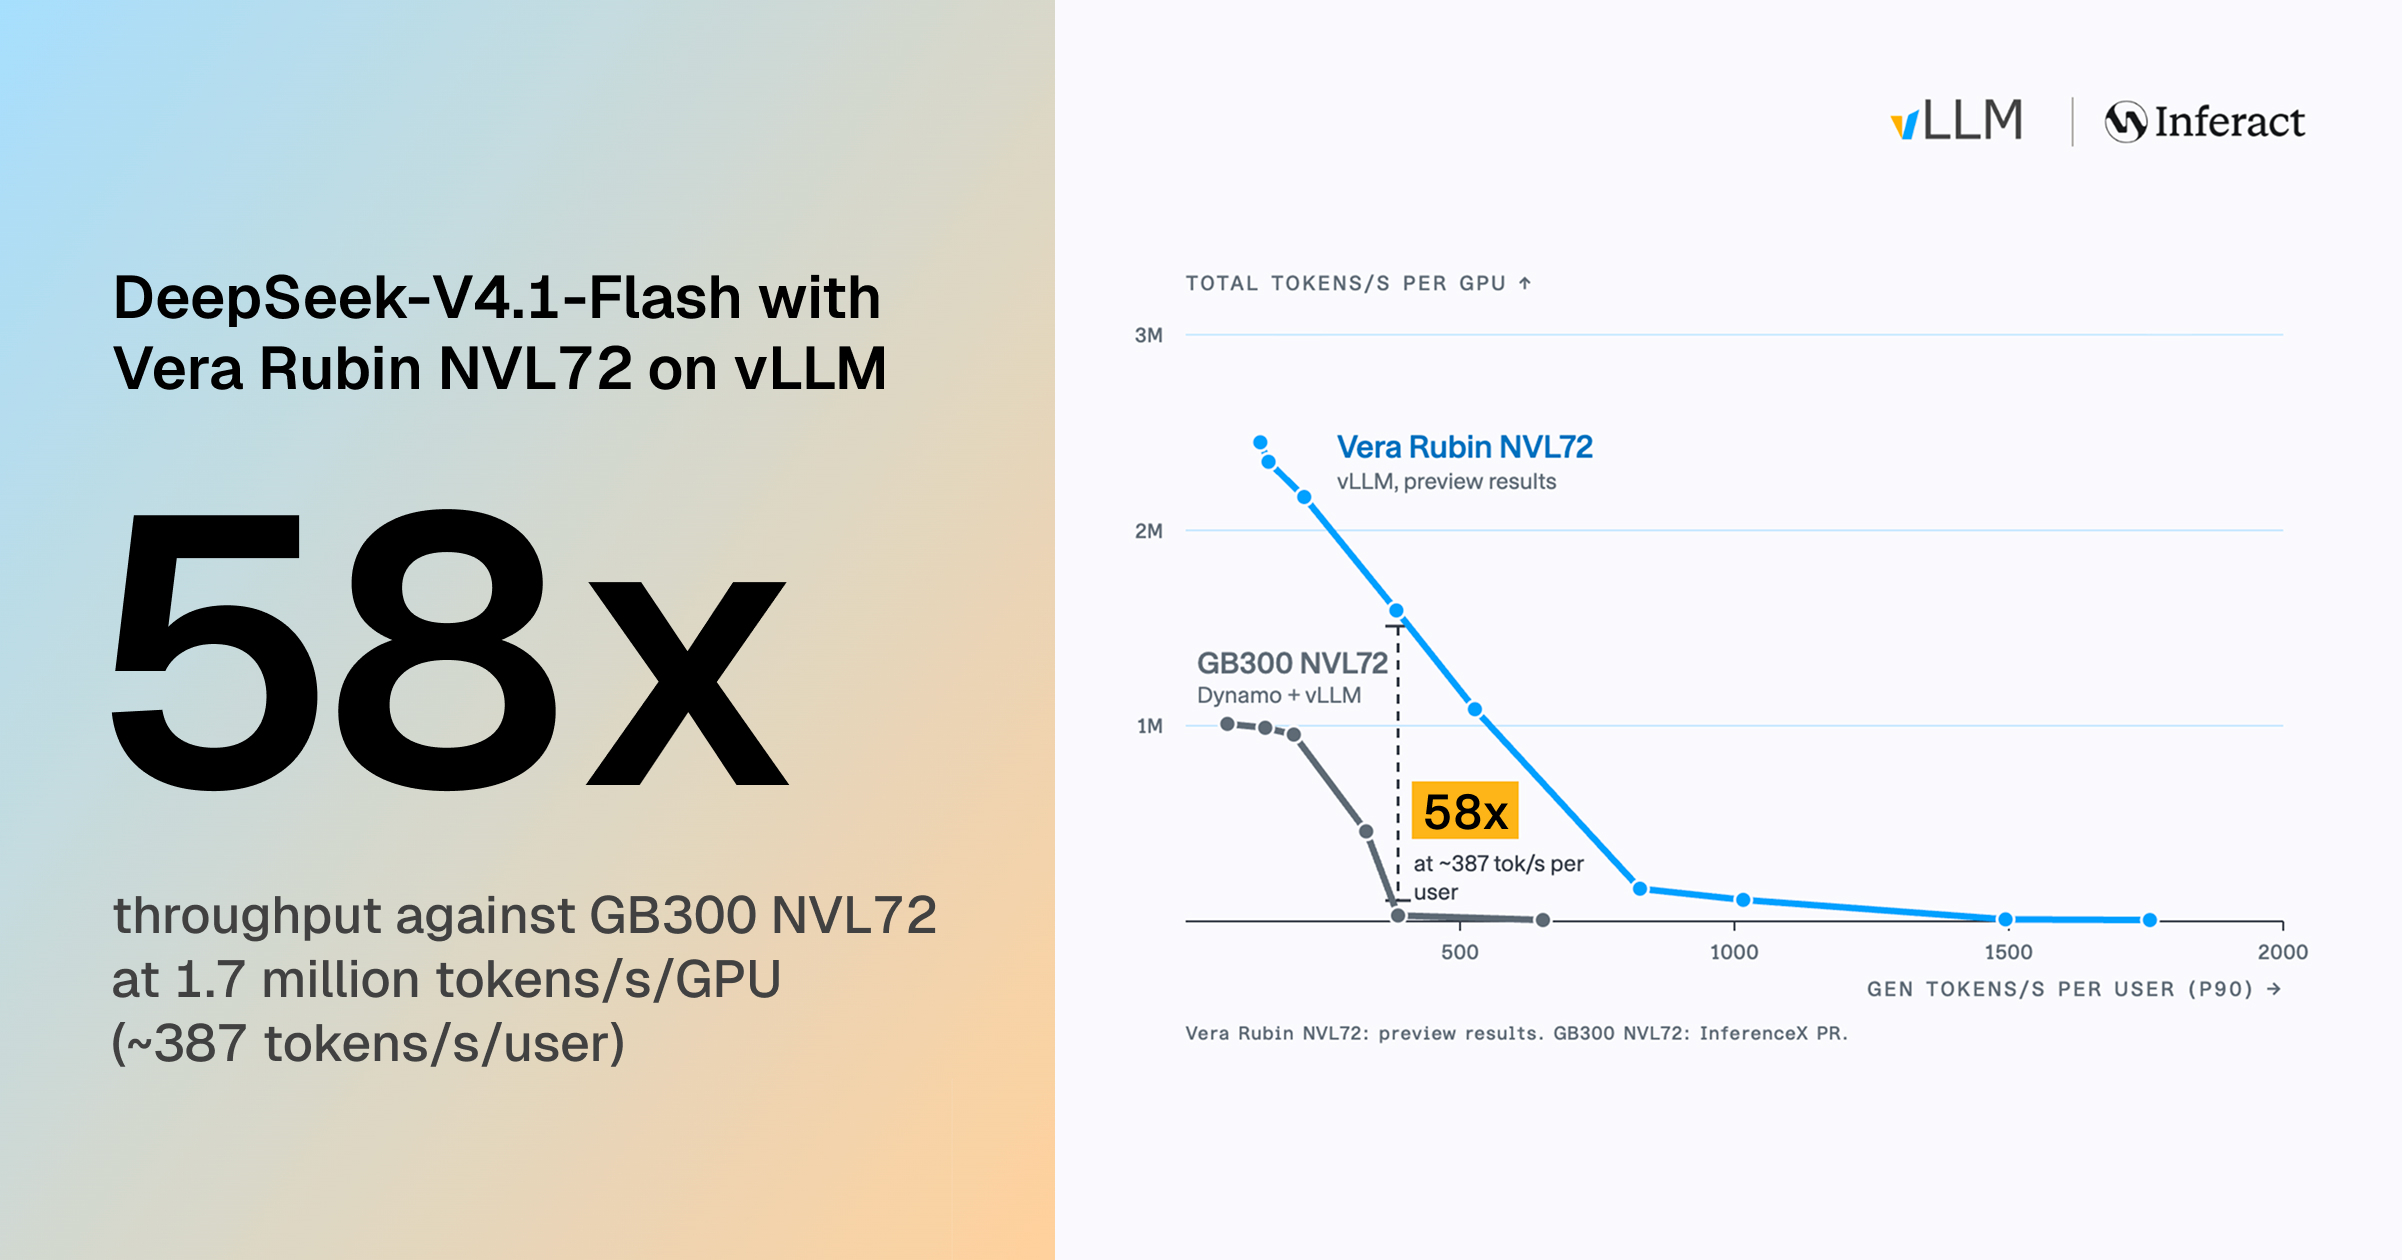
vLLM 在英伟达 Vera Rubin NVL72 上跑 DeepSeek-V4.1-Flash:每用户 387 token/s 时单卡 170 万 token/s,为 GB300 NVL72 的 58 倍;峰值吞吐则是 2.7 倍

核心要点速览

  • 两个倍数要分开看(vLLM 口径):每用户 387 token/s 时 170 万 token/s/GPU,是 GB300 的 58 倍;峰值吞吐 252 万 token/s/GPU,是 GB300 的 2.7 倍
  • 单用户延迟:TP8 跨两个计算托盘的专用解码路径,并发 1 时 P90 达 1,810 token/s,P50 从 1,117 提升到 1,844 token/s
  • 内核重写:针对 Rubin 的双内存域和 SM107 新 MMA 指令,DEP2 prefill 步约快 28%,DEP decode 步约快 25%
  • 机架级内存池:Mooncake KV 池从 DRAM 扩到空闲 HBM,Engram 表分片到各 GPU HBM;并发 4,800 时请求量多 68%,TTFT P50 从 29.8 秒降到 4.2 秒
  • 数据性质:Rubin 结果为预览数据,GB300 对比来自 InferenceX PR,部分点为插值
阅读全文

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

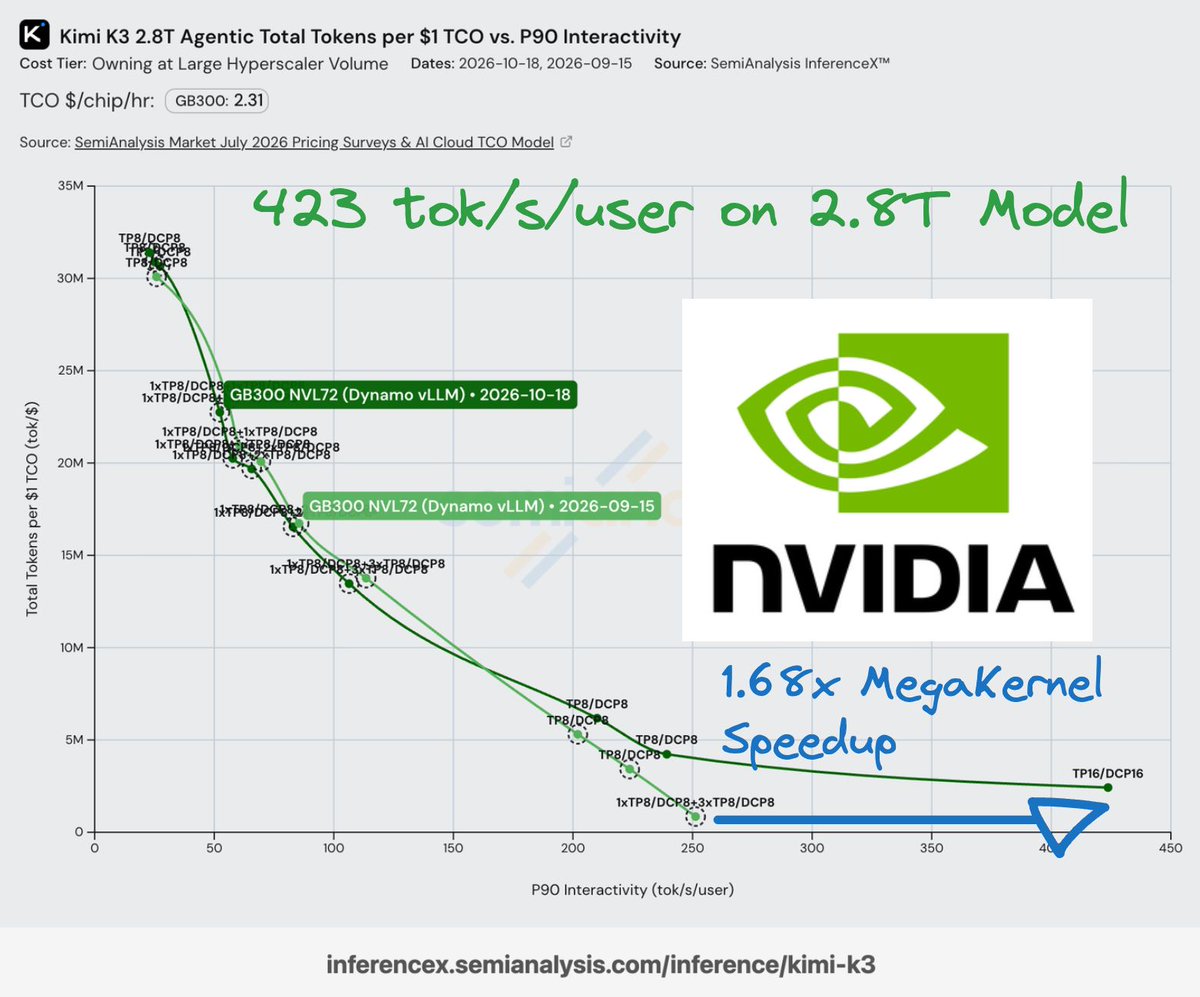
vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

核心要点速览

  • NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
  • 在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
  • 在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
阅读全文
关联模型 / 智能体 / 厂商:

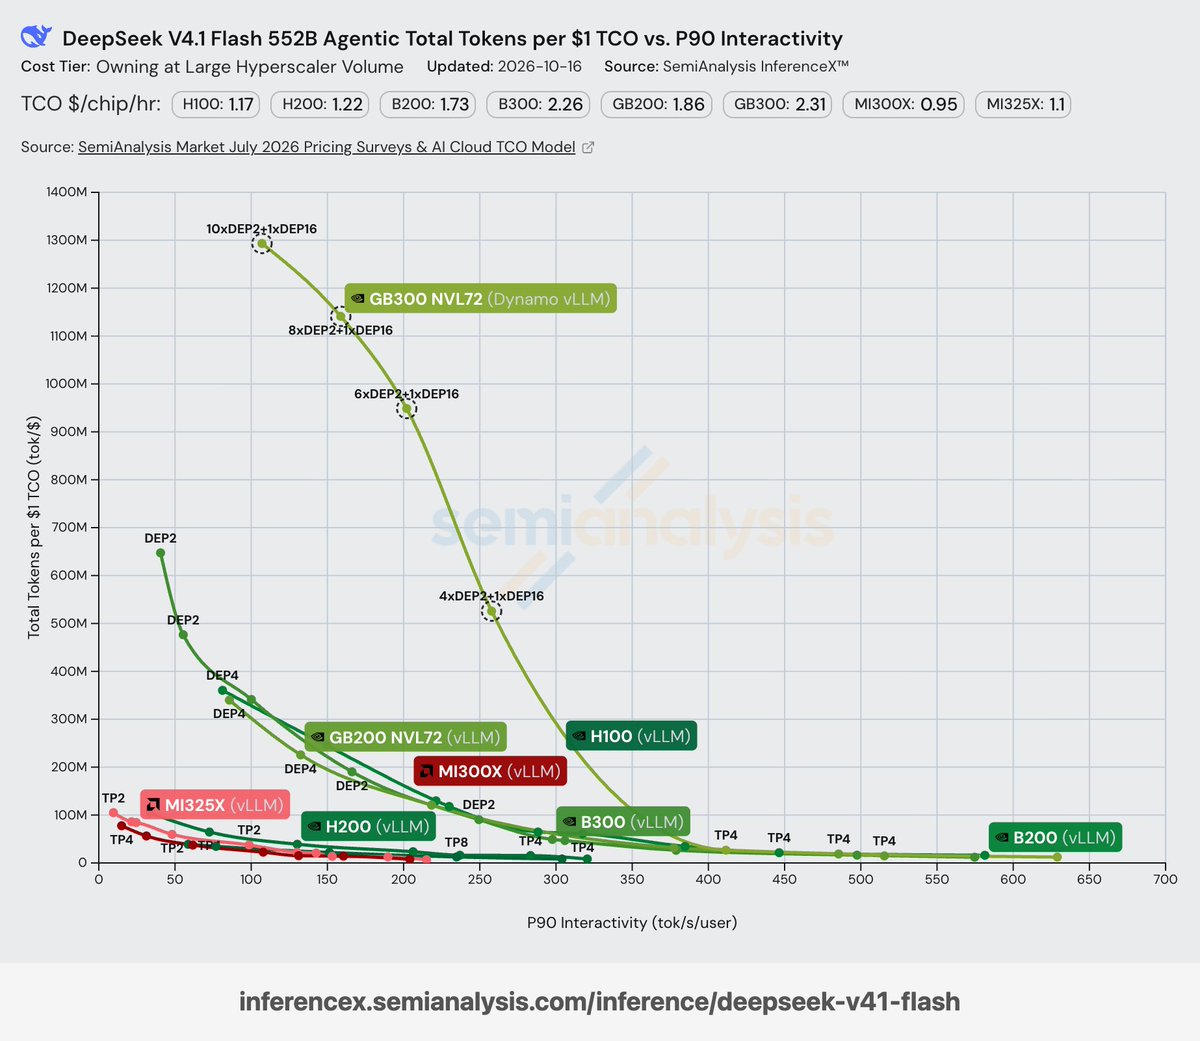
SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

权威半导体与 AI 算力研究机构 SemiAnalysis 披露了 AgentX 基准实现每美元 TCO 产出 13 亿 Token 的底层架构细节:vLLM 联合 Inferact 采用预填充/解码分离式推理(Disaggregated Serving),在超大规模云商批量计价下单位成本性能达到 NVIDIA B300 聚合式(Aggregated)部署的 4 倍;与此同时,开源编程智能体 Cline 公布实测,指出 DeepSeek-V4.1-Flash-1017 仅靠在多套异构 Coding Agent Harness 上扩展强化学习,便以低 17 倍的成本在 Terminal-Bench 上击败 GPT-5.6-Sol、较前代提分 35%。

SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

核心要点速览

  • SemiAnalysis 实测确认:vLLM 联合 Inferact 采用预填充/解码分离式架构,在 AgentX 上实现每美元 TCO 产出 13 亿 Token,性价比达 NVIDIA B300 聚合式配置的 4 倍
  • Cline 官方实测指出 DeepSeek-V4.1-Flash-1017 在 Terminal-Bench 上较前代跃升 35%,以低约 17 倍的成本击败 GPT-5.6-Sol
  • 这一 35% 的性能跃升在“零算法创新”下完成,核心归功于在多套真实 Coding Agent Harness 上直接进行强化学习后训练
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

紧随 DeepSeek-V4.1-Flash-1017 开源发布,vLLM 官宣 Day-0 深度适配,在 SemiAnalysis AgentX 评测中创下每美元 TCO 产出 13 亿 Token、单 GPU 吞吐高达 830K tok/s(保障单用户 100 tok/s 交互速率)的纪录,较初代提速 5 倍;OpenRouter 亦同步上线,第三方供应商最低仅需 $0.10/M 输入与 $0.50/M 输出。

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

核心要点速览

  • vLLM 在 SemiAnalysis AgentX 基准上为 DeepSeek-V4.1-Flash-1017 实现单 GPU 830K tok/s 吞吐(保障单用户 100 tok/s 速率),每美元 TCO 产出高达 13 亿 Token,较初代提速 5 倍
  • 模型在 DeepSWE v1.1 上斩获 77.0%(超越 Claude Opus 5 的 74.0%),NL2Repo-Bench 达 68.2%,Apex Bench 达 72.1%,且输出更加精炼
  • OpenRouter 同步上线 deepseek/deepseek-v4.1-flash-1017,最低仅 $0.10/M 输入与 $0.50/M 输出;官方 API(deepseek-flash)维持 $0.15/$0.60 不变
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

vLLM 团队联合 Inferact、Red Hat 与 NVIDIA 于 10 月 9 日发布 Rubin 早期支持:基于 CUDA 13.4 的每日镜像已可在 Vera Rubin NVL72 上服务 DeepSeek、Kimi、GLM、MiniMax。官方口径下,SemiAnalysis AgentX 上 MiniMax M3 同等交互性单卡吞吐最高为 GB200 的 7.84 倍;MLPerf Inference v6.1 的 VLM 项上 Qwen3-VL-235B-A22B 相对 GB300 NVL72 最高 3.7 倍。

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

核心要点速览

  • 硬件对比 GB200 NVL72:NVFP4 算力 5 倍、HBM4 带宽约 2.4 倍、NVLink 双向带宽 1.7 倍,softmax 指数运算快 2–4 倍(vLLM 博文)
  • AgentX + MiniMax M3:同等交互性单卡吞吐最高 7.84 倍,150 TPS 约束下 5.18 倍(官方口径,早期结果)
  • MLPerf Inference v6.1:Qwen3-VL-235B-A22B 经 vLLM + Dynamo,相对 GB300 NVL72 最高 3.7 倍
  • CUDA 13.4 locality domain 拆分 MoE 权重,小 token decode 场景 MoE 层平均提速约 1.2 倍
  • 开箱镜像:vllm/vllm-openai:cu134-nightly(CUDA 13.4 + PyTorch 2.15)
阅读全文

SemiAnalysis AgentX:AMD MI355x 在较低交互档位上 tokens/$ TCO 超越 B300

SemiAnalysis 在 AgentX(面向多轮长上下文智能体负载的基准)上指出,新的 AMD MI355x 提交在较低交互性区间的总拥有成本(tokens per $ TCO)上击败 B300,并点名 vLLM、AMD 与 LMCache 工程团队。对选型推理硬件与 agentic serving 栈有参考价值。

核心要点速览

  • 基准:AgentX 衡量多轮、长上下文智能体真实流量。
  • 结果:AMD MI355x 在较低交互档位 tokens/$ TCO 优于 B300。
  • 栈:点名 vLLM、AMD、LMCache 协作推进 agentic 优化。
阅读全文
关联模型 / 智能体 / 厂商: