AI 编程实时动态与要闻

I
IBM Graniteibm-granite·
👀13
🔥82

IBM 发布 LLM 原生标记语言 LLMON 和两款 Granite 4.1 预览模型(3B/8B):用保留 token 把指令和数据分开,OPI 间接注入测试中比最好的前沿模型多挡住 47% 的攻击

11 月 12 日,IBM Granite 团队在 Hugging Face 发布 LLMON(LLM Object Notation,读作「lemon」):用词表里的保留特殊 token 包裹带语义标签的块(指令、数据、要求等),每块有唯一 ID,再由一个 exec 执行块指定要运行哪条指令、作用于哪些数据。同时开源两款实验预览模型 granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview(Apache 2.0),附带 GitHub 工具包、JSON 与 LLMON 无损互转工具。官方称在 OPI 间接提示注入基准上,LLMON 模型比测试中最好的前沿模型多挡住 47% 的攻击、比最好的开源模型多挡住 95%,通用能力与 Granite 4.1 Instruct 持平;但这只是学到的行为、不是强制保证,目前仅为实验预览,不建议用于生产。

IBM 发布 LLM 原生标记语言 LLMON 和两款 Granite 4.1 预览模型(3B/8B):用保留 token 把指令和数据分开,OPI 间接注入测试中比最好的前沿模型多挡住 47% 的攻击

核心要点速览

  • 语法:用保留特殊 token 包裹带标签的块(instruction、data、requirement 等),每块有唯一 ID,exec 块把指令绑定到它要处理的数据上
  • 模型:granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview,基于 Granite 4.1 base 微调,Apache 2.0;自带 chat_template,用 apply_chat_template 即可,不必手写标记
  • 安全数据(官方自测):OPI 上比最好的前沿模型多挡住 47% 攻击、比最好的开源模型多挡住 95%,ASB 和 StruQ 趋势相似;只覆盖静态间接注入,多轮自适应攻击仍在改进
  • 工具链:GitHub generative-computing/llmon 提供 JSON 与 LLMON 无损互转;IBM 的 Mellea 框架原生支持;可自定义标签并在其上训练 LoRA
  • 限制:官方明确这是学到的行为而非强制保证,仅供探索评估,不建议生产使用;Agent 的权限控制仍应放在应用代码里
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Granite 4.1⚡ granite-4.1-3b-LLMON-preview⚡ granite-4.1-8b-LLMON-preview🌐 IBM🌐 Hugging Face

伦敦初创 Continuous Intelligence 开源时序预测模型 ci-proto:1.67 亿参数、可读 200 万步以上历史,fev-bench 成绩已并入官方仓库,SQL 技能分 51.5

今年 7 月成立的伦敦实验室 Continuous Intelligence 发布首个时序基础模型 ci-proto,权重放在 Hugging Face,代码在 GitHub,可在 CPU 或 GPU 上零样本预测电力、销量、传感器等数据。官方称历史窗口超过 200 万步,是其他时序基础模型的 64 倍,并输出 0.1–0.9 共 9 个分位数。它在 fev-bench 100 个任务上的结果已由 AutoGluon 维护者合并进 fev 官方仓库:SQL 技能分 51.51、MASE 技能分 40.80。许可证基于 Apache 2.0,但对外提供产品时需署名并通知一次厂商。

伦敦初创 Continuous Intelligence 开源时序预测模型 ci-proto:1.67 亿参数、可读 200 万步以上历史,fev-bench 成绩已并入官方仓库,SQL 技能分 51.5

核心要点速览

  • 规模:ci-proto 约 1.67 亿参数(config 写明 167,190,592),另带一个长历史检查点;历史不超过 16,384 步用标准检查点,更长自动切换
  • 上下文:官方称可读 200 万步以上历史,约为其他时序基础模型的 64 倍(厂商口径)
  • 跑分:fev-bench 100 个任务零样本 SQL 技能分 51.51、MASE 技能分 40.80,结果由厂商提交,已于 11 月 11 日被 fev 仓库 PR #211 合并
  • 输出:多变量联合预测,支持过去/未来协变量和类别变量,返回 0.1–0.9 共 9 个分位数
  • 许可:基于 Apache 2.0 的自定义许可,可商用;对外产品或再分发需公开署名并一次性通知厂商,纯内部使用免除
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ci Proto⚡ TimesFM-3.0⚡ Timestral⚡ Chronos-2🌐 Continuous Intelligence🌐 AutoGluon

Neo4j 开源 Relate:给 AI 智能体用的嵌入式图数据库,无需服务器,用 Cypher 同时做图遍历和向量检索,自带 MCP 与智能体技能包

Neo4j 在 NODES 2026 大会上发布 Relate:一个用 Rust 新写的开源嵌入式图数据库(Apache 2.0),跟着应用一起启动和退出,不用部署服务器,也不用注册账号。智能体可以把学到的东西存成带关系的图,用一条 Cypher 语句同时做关系遍历、向量和全文检索。它自带编码智能体技能包和 MCP 端点,在编码智能体里会自动切换成省 token 的输出模式。GitHub 已发布 v1.0.1,但 README 注明它目前是 Neo4j Labs 实验项目,不在官方支持产品线内。

Neo4j 开源 Relate:给 AI 智能体用的嵌入式图数据库,无需服务器,用 Cypher 同时做图遍历和向量检索,自带 MCP 与智能体技能包

核心要点速览

  • 零部署:一条命令安装,跟随应用启停;数据可放内存、目录或单个 .rl 文件,写入走 WAL 和 Parquet 检查点
  • 一条 Cypher 两种检索:同一语句里做关系遍历加向量/全文检索,不用把两个存储的结果在胶水代码里拼起来
  • 兼容性:官方称跑了 3 万多个 openCypher、Cypher 25 和 GQL 测试场景,对齐 Neo4j 的查询能力
  • 多语言多入口:Rust、Python、JS/WASM、Java、Go、Swift 等客户端,可选单进程服务同时提供 Bolt、HTTP 和 MCP
  • 版本状态:GitHub 11 月 11 日发 v1.0.0、12 日发 v1.0.1,Apache 2.0;性能跑分官方未公布
阅读全文

Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

Perplexity 11 月 12 日发布 pplx-decider-v1.3(基于 Qwen3.8-27B,约 26.1B 参数)和蒸馏版 pplx-decider-flash-v1.3(基于 Qwen3.5-4B,约 4.5B),权重以 Apache 2.0 上架 Hugging Face,并通过 Decisions API 和 OpenRouter 提供。新版加入 Locate,可按标签或指令抽取原文片段并返回字符位置。官方称 v1.3 在 63 项分类任务上平均准确率 91.6%,比其生产分类器高 6.54 个百分点。

Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

核心要点速览

  • 两档开源权重:v1.3 约 26.1B 参数(Qwen3.8-27B 微调),Flash v1.3 约 4.5B(Qwen3.5-4B 蒸馏),均为 Apache 2.0;BF16 本地运行约需 49 GiB 显存
  • 新增 Locate:按标签或指令抽取原文片段,返回起止字符位置和分数,覆盖 NER、PII 检测、抽取式问答,可与分类、打分问题放在同一请求
  • 官方/厂商口径分类成绩:63 项分类任务平均准确率 91.6%,比 Perplexity 生产分类器高 6.54 个百分点;7 个领域全部领先 Jev 1.14,金融领域最多高 12.9 个百分点
  • 检索与稳定性:72 项检索任务 nDCG@10 为 83.99,比 Qwen3-Reranker-8B 高 1.81;输入改写后答案只变 0.27%,Jev 1.14 为 2.69%–4.84%
  • 上手渠道:Hugging Face 下载、Perplexity Decisions API、OpenRouter(两款 v1.3 模型 11 月 19 日前免费)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-decider-v1.3⚡ pplx-decider-flash-v1.3⚡ Qwen3.8-27B⚡ Qwen3.5-4B⚡ Jev 1.14⚡ Qwen3-Reranker-8B🌐 Perplexity🌐 Hugging Face🌐 OpenRouter
AD赞助内容

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

11 月 12 日 SGLang Summit 期间,SGLang 团队与 AWS Annapurna Labs 宣布 SGLang-Neuron v0.1.0 开源并进入公开预览。它是 SGLang 的树外插件,设置 SGLANG_PLATFORM=neuron 即可在 Trainium 上用同样的服务器和 API 推理、生成 RL rollout,底层走 TorchNeuron 原生 PyTorch。AWS 同步上架 Deep Learning Container 镜像。大模型目前跑在 Trn3,扩散模型跑在 trn2.48xlarge。

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

核心要点速览

  • 开源与许可:GitHub sgl-project/sglang-neuron,Apache 2.0,v0.1.0 为公开预览,功能、API 和支持模型后续可能变化
  • 零改动接入:SGLang 本体不改,插件通过 entry points 注册 neuron 平台,固定在上游 commit 43881a7;镜像 tag 为 v0.1.0-neuron-py314-sdk-2.33.0
  • 大模型清单:GPT-OSS-120B、Qwen3 系列、Qwen3.5-397B-A17B、GLM-5.2(1M 上下文)、Kimi-K3(1 个 prefill 节点 + 2 个 decode 节点)等 8 种架构
  • 关键机制:全异步运行时、单次 NKI 内核调用跑完整个解码步的 giga-kernel、基于 NIXL + EFA 的 PD 分离、HiCache 主机内存前缀缓存
  • 扩散模型:FLUX.1-dev、FLUX.3-Action、MiniMax-H3、Wan2.2 A14B、LingBot-World-V2 跑在 Trainium2 上
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kimi K3⚡ GLM-5.2⚡ GPT-OSS-120B⚡ Qwen3.5-397B-A17B🌐 SGLang🌐 AWS🌐 RadixArk

Thinking Machines 兑现承诺开源 Inkling 2 Small:594B 总参 / 17B 激活 MoE 权重上架 Hugging Face,Apache 2.0 可商用,原生 NVFP4 两张 B300 即可跑,SGLang、vLLM、Cloudflare 等首日支持

11 月 12 日(北京时间 13 日凌晨 4 点 50 分),Thinking Machines Lab 宣布 Inkling 2 Small 权重以 Apache 2.0 许可证在 Hugging Face 开放下载,兑现了 11 月 5 日发布闭源版时「完成安全测试后开源」的承诺。模型为 594B 总参、17B 激活的多模态 MoE,支持图文输入和 100 万 token 上下文;主权重是训练时就采用的原生 NVFP4,至少需要 500GB 显存(2 张 B300 或 4 张 H200),另有 MXFP8 版本。SGLang、vLLM、Unsloth 给出本地部署方案,Cloudflare Workers AI、OpenRouter、Together、Nebius 等首日上线,每百万 token 输入 0.30 美元、输出 1.00 美元。

Thinking Machines 兑现承诺开源 Inkling 2 Small:594B 总参 / 17B 激活 MoE 权重上架 Hugging Face,Apache 2.0 可商用,原生 NVFP4 两张 B300 即可跑,SGLang、vLLM、Cloudflare 等首日支持

核心要点速览

  • 许可与仓库:Hugging Face thinkingmachines/Inkling-2-Small(NVFP4 主权重)与 Inkling-2-Small-MXFP8,Apache 2.0,可商用、可微调、可集成到第三方产品
  • 规格(模型卡):48 层解码器,384 个专家每 token 路由 8 个,局部与全局注意力混合;594B 总参 / 17B 激活;图文输入、文本输出,上下文最长 100 万 token
  • 硬件门槛:NVFP4 至少 500GB 聚合显存(2×B300 或 4×H200);MXFP8 至少 800GB(4×B300 或 8×H200),官方称 MXFP8 评测只高 1–2 个百分点,推荐用 NVFP4
  • 跑分(厂商口径,模型卡):AA Index v5.0 30.6、DeepSWE v1.1 72.1%、FrontierCode v2.0 25.4%、BrowseComp 90.2%;DeepSeek-V4.1-Flash 在 AA Index(32.6)、DeepSWE(77.0%)上仍更高
  • 首日生态:SGLang、vLLM、TokenSpeed、Unsloth 本地推理,Miles、SkyRL、Snowflake Cortex 后训练;Cloudflare Workers AI 与 OpenRouter 均为输入 0.30 / 输出 1.00 美元每百万 token,OpenRouter 另有限免版本
阅读全文
关联模型 / 智能体 / 厂商:

Vercel 发布 UI SDK 测试版:把弹层、选择、键盘导航等拆成 50 多个「行为」交给 AI 智能体组装组件,支持 React、Vue、Svelte、Solid 和 Web Components,Apache 2.0 开源

新加坡时间 11 月 13 日 02:41,Vercel 官方账号发帖推出 UI SDK。它不是又一套组件库,而是把界面交互拆成可复用的「行为」:弹层定位与关闭、单选多选、输入跳转、焦点管理、拖拽排序、虚拟列表等,官方称已做了 50 多个。开发者不用自己学这些 API,而是给编程智能体装上 UI SDK 技能,由智能体按需求挑选行为、拼成新组件,并输出到 React、Vue、Svelte、Solid 或 Web Components。代码在 GitHub vercel-labs/ui,Apache 2.0 许可,npm 包 @ui-sdk/core 当前为 0.1.0-beta.1,API 仍可能变动。

Vercel 发布 UI SDK 测试版:把弹层、选择、键盘导航等拆成 50 多个「行为」交给 AI 智能体组装组件,支持 React、Vue、Svelte、Solid 和 Web Components,Apache 2.0 开源

核心要点速览

  • 官方称已构建 50 多个行为,如 createPopup、createSelection、createTypeahead、createRovingFocus、createVirtualizer
  • 同一套行为可渲染到 5 种前端:React(需 19 及以上)、Vue、Svelte、Solid、Web Components
  • 一条命令给智能体装技能:npx skills add vercel-labs/ui --skill ui-sdk
  • 官方口径:智能体直接读取页面并操作控件、不依赖截图,速度提升一倍以上、成本不到一半(未公布测试方法)
  • Apache 2.0 开源,npm @ui-sdk/core 于 11 月 13 日 01:12(新加坡时间)发布 0.1.0-beta.1
阅读全文
关联模型 / 智能体 / 厂商:

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

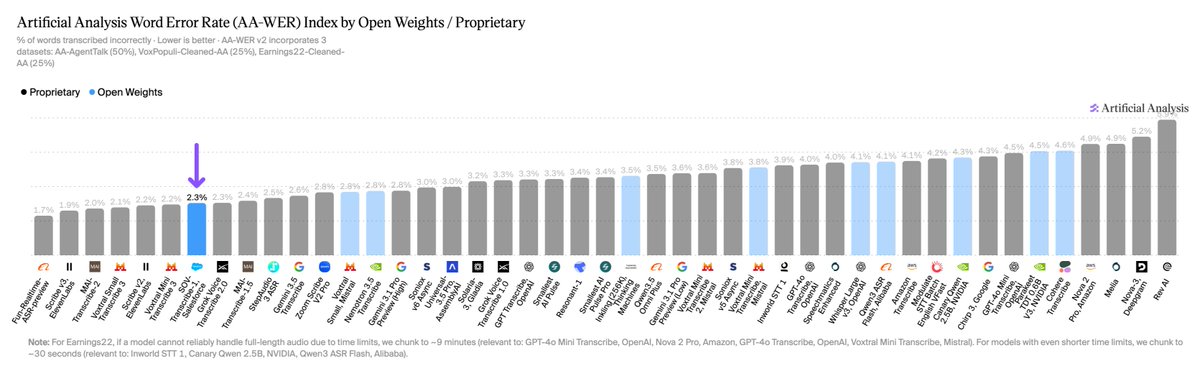
新加坡时间 11 月 13 日 00:30,Artificial Analysis(@ArtificialAnlys)发帖称,Salesforce 新发布的 SOV-Transcribe-1 成为开源权重语音转文字模型第一名:在 AA-WER 指数上词错误率 2.3%,在包括闭源模型在内的 44 个模型中排第 7。它比紧随其后的开源模型 Mistral Voxtral Small 和英伟达 Nemotron 3.5 Transcribe(均为 2.8%)低 0.5 个百分点。模型由 Salesforce 主权 AI(Missionforce Sovereign AI)团队开发,总参数 26.6B、激活参数 4.6B,结构是 Whisper large-v3 音频编码器加 Gemma 4 26B A4B MoE 解码器,权重以 Apache 2.0 许可发布在 Hugging Face。它是非流式模型,适合整段录音转写,不适合实时字幕。

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

核心要点速览

  • AA-WER 2.3%:开源权重第 1、44 个模型中总榜第 7;Voxtral Small 与 Nemotron 3.5 Transcribe 均为 2.8%
  • 分数据集:Earnings22 财报电话 4.1%(Voxtral Small 4.8%),VoxPopuli 1.5%(对手 1.8%),AA-AgentTalk 语音客服对话 1.8%,与 Nemotron 持平
  • 26.6B 总参数 / 4.6B 激活;Whisper large-v3 编码器 + 投影层 + Gemma 4 26B A4B MoE;BF16,单段音频实测最长 30 分钟,支持英法德西意葡荷 7 种语言
  • 官方称 VoiceCodeBench(电话号码、邮箱等实体)任务成功率 76.3%、实体召回 93.4%,23 个系统中排第 2;AppTek 14 种英语口音平均 WER 8.21%,其中 8 种口音最低(含新加坡英语)
  • Apache 2.0;可用 vLLM 插件(vLLM 0.32.0)或 Transformers 部署;官方实测单张 RTX PRO 6000 Blackwell 每秒可转写 1,039 秒音频(配合 DFlash 草稿模型)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SOV-Transcribe-1⚡ Voxtral Small⚡ Nemotron 3.5 Transcribe⚡ Gemma 4⚡ Whisper large-v3🌐 Salesforce🌐 Artificial Analysis🌐 Mistral AI🌐 NVIDIA🌐 Google

Google 发布 A2UI 1.0:生成式 UI 开放协议首个稳定版,Agent 直接回复表单和图表;新默认格式 Express 把 UI 输出 token 砍掉约 63%

Google 11 月 11 日发布 A2UI 1.0,这是其生成式 UI 开放协议(Apache 2.0)的首个稳定版。Agent 不再只回一大段文字,而是描述要显示的卡片、选择器或图表,由各个 App 用自己的原生组件渲染。1.0 新增双向函数调用和无障碍支持,提供 React、Angular、Lit、Flutter、SwiftUI 渲染器,以及 Python、TypeScript、Dart 三套 Agent SDK。Google Cloud Tech 官方文章称,新的默认推理格式 A2UI Express 在 54 个样本的测试中让生成的 UI 代码 token 减少 63.2%。Atlassian、Alation、Bloomberg、字节跳动已在使用。

Google 发布 A2UI 1.0:生成式 UI 开放协议首个稳定版,Agent 直接回复表单和图表;新默认格式 Express 把 UI 输出 token 砍掉约 63%

核心要点速览

  • A2UI 1.0 是首个稳定版,Apache 2.0 开源;Jetpack Compose 渲染器目前仍是 0.9.1,1.0 版「即将推出」
  • 1.0 新增双向函数调用(例如订座选择器可当场查空位)、无障碍支持和元数据扩展
  • 新默认格式 A2UI Express:在 54 个样本、gemini-3.8-flash 的测试中,提示 token 中位数降 45.4%(10,980→6,000),生成的 UI 代码 token 降 63.2%(官方口径)
  • 安全设计:UI 消息是纯声明式数据,不含脚本和 CSS;Agent 只能用 catalog.json 白名单里的组件和函数
  • Web 和 Flutter 渲染器可在 MCP Apps 里运行,A2UI 界面能出现在 Claude、Gemini 等支持 MCP Apps 的助手中
阅读全文

Runway 开源世界动作模型 Praxis-1:27B MoE 视频模型直接控制机器人,RoboLab-120 成功率 46.2% 居开源第一,Apache 2.0 可商用

Runway 11 月 11 日以 Apache 2.0 许可开放世界动作模型 Praxis-1 的权重、推理与微调代码(含 LoRA),可商用。它是 27B 参数的 MoE 扩散 Transformer(每 token 激活约 2.8B),同时预测未来视频和机器人动作,每次调用输出 1.6 秒动作,单张 H100 往返约 0.55 秒。官方称在 NVIDIA RoboLab-120 上成功率 46.2%,是世界动作模型和开源机器人基础模型中的第一,高于 FLUX 3 Action 42.9%、π0.5 28.0%。同一工位三项任务上,比让 GPT-6 Astra 直接驱动机械臂快 15.6 倍、单任务成本低 51 倍。权重已上 Hugging Face,并支持 LeRobot 与 vLLM-Omni。

Runway 开源世界动作模型 Praxis-1:27B MoE 视频模型直接控制机器人,RoboLab-120 成功率 46.2% 居开源第一,Apache 2.0 可商用

核心要点速览

  • 规模:总参数 27.2B,主干 26.9B、每 token 激活约 2.8B,另有 314M 动作专家;bf16 约 54.4GB,单张 80GB GPU 可跑
  • RoboLab-120(1,200 回合):46.2%,FLUX 3 Action 42.9%、Cosmos3 Nano 36.8%、π0.5 28.0%(官方口径)
  • 真机 Franka FR3 十项任务:88/100 对 FLUX 3 Action 80/100;RT-1 微调后 SimplerEnv 80.0%(原 RT-1 52.4%)
  • 对比 GPT-6 Astra 驱动同一机械臂:快 15.6 倍,单任务成本 0.04 美元对 1.87 美元(低 51 倍)
  • NVFP4 量化后权重缩到 17.5GB,RoboLab 抽样 46.5% 对 bf16 47.8%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Praxis-1⚡ FLUX 3 Action⚡ pi0.5⚡ GR00T N1.6⚡ GPT-6 Astra🌐 Runway🌐 NVIDIA
AD赞助内容

阿里发布 Qwen Code 1.0 Preview:把 Qoder 打磨的 Agent Harness 并入开源编码 Agent,Apache 2.0,三大系统原生安装包免装 Node.js

阿里 Qwen 团队 11 月 11 日在 GitHub 发布 Qwen Code v1.0.0-preview。官方说明,这一版把自家 AI IDE Qoder 里打磨的 Agent Harness(把模型、工具和执行过程串起来的那层运行框架)与 Qwen Code 合并,用来理解、实现、调试和测试代码。它支持 Qwen 账号与 Qoder 账号登录,也能接多家模型服务商和自定义兼容接口;首次为 macOS、Linux、Windows 提供原生安装包,不用再单独装 Node.js;支持会话续接和非交互执行,方便脚本与自动化。代码以 Apache 2.0 开源,但预览期暂不接受社区 PR,官方预计 2026 年 12 月之后开放。

阿里发布 Qwen Code 1.0 Preview:把 Qoder 打磨的 Agent Harness 并入开源编码 Agent,Apache 2.0,三大系统原生安装包免装 Node.js

核心要点速览

  • 定位:1.0 Preview 把 Qoder 的 Agent Harness 与 Qwen Code 合并成同一套开源编码 Agent(官方 release 说明)
  • 安装:首次提供 macOS / Linux / Windows 共 8 个原生安装包(含 arm64 与 musl),不再需要 Node.js
  • 模型:可用 Qwen 账号、Qoder 账号、QwenCloud / 阿里云百炼,或任意兼容接口的第三方与自定义服务商
  • 自动化:支持 qwen --continue / --resume 续接会话,qwen -p 单次非交互执行
  • 注意:预览版接口与配置可能变化;2026 年 12 月前暂不收社区 PR,旧版 0.27.x 仍在 main 分支维护
阅读全文

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

百度 11 月 11 日在 ERNIE 官网和 @Baidu_Inc 发布文心 5.5 Flash Preview,这是基于 11 月 5 日开源的 ERNIE 5.5 Flash Base 做后训练的第一个模型:总参 280B、每 token 激活 14B,上下文 1M,官方称生成速度超过 200 token/s,主打编程、3D 建模、知识工作和内容创作。API 已在百度智能云千帆上线,权重将于 11 月 25 日前开源,官方博客写明采用 Apache 2.0。官方跑分(厂商口径)中,它在 AutomationBench(61.9)和 SpreadsheetBench V2(36.4)上排在对比表第一,但 Terminal-Bench 4.0 只有 46.5,低于 Claude Opus 5.5 的 63.6。官方也说明这是后训练中途的检查点。

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

核心要点速览

  • 规格(官方):总参 280B、每 token 激活 14B,上下文 1M,生成速度 200+ token/s,纯文本模型
  • 厂商口径跑分:AutomationBench 61.9(Opus 5.5 为 58.0)、SpreadsheetBench V2 36.4(Opus 5.5 为 35.1),均为对比表第一
  • 短板同样明显:Terminal-Bench 4.0 46.5(Opus 5.5 63.6、GPT-6.1 Sol 56.1),DeepSWE v1.1 71.2(DeepSeek V4.1 Flash 77.0)
  • 价格:千帆每百万 token 输入忙时 2 元 / 闲时 1 元,输出 8 元 / 4 元,限时五折(每经报道);OpenRouter 标价 $0.28 / $1.13
  • 权重 11 月 25 日前开源,官方博客称 Apache 2.0;比 Base 的自定义协议宽松,以最终发布为准
阅读全文
关联模型 / 智能体 / 厂商:

MBZUAI 旗下 IFM 开源世界模型 PAN 2:多模态 LLM 规划「谁在何时做什么」,29B 扩散模型生成最长 20 秒模拟视频,Physics-IQ 49.38 居开源第一,Apache 2.0

阿联酋穆罕默德·本·扎耶德人工智能大学(MBZUAI)基础模型研究院 IFM 11 月 10 日发布开源世界模型 PAN 2。它把「概念推理」和「感知推理」分开:多模态 LLM 先把当前画面和文字动作写成带时间戳的结构化世界状态,再由从零训练的 29B 潜空间扩散模型生成最长 20 秒、704×1248、24fps 的模拟视频,让 Agent 在真正动手前先「预演」每个候选方案。权重和代码以 Apache 2.0 开源,Diffusers 与 vLLM-Omni 首日支持。官方也坦言约三分之二的多步计划模拟里至少有一步没执行到位。

MBZUAI 旗下 IFM 开源世界模型 PAN 2:多模态 LLM 规划「谁在何时做什么」,29B 扩散模型生成最长 20 秒模拟视频,Physics-IQ 49.38 居开源第一,Apache 2.0

核心要点速览

  • 架构:多模态 LLM 做概念推理(写出时间、动作、镜头运动),29B MMDiT 扩散模型做感知推理,文本编码器用 Qwen3.5-9B、解码用 Wan 2.2 VAE(模型卡)
  • 输出:单张起始图 + 文字动作,生成最长 20 秒、704×1248 / 24fps 模拟视频;权重与代码 Apache 2.0
  • 公开榜(官方口径):Physics-IQ Verified 排行榜设置 49.38,开源模型第一(Cosmos 3 Super 48.62,闭源 FLUX 3 为 51.11);PhyGround 4.74;RBench 57.04
  • 多步计划:100 个日常任务的整计划完成率 34.00%,开源模型最高(MiniMax-H3 32.50%);但六项能力总分 84.48 低于 MiniMax-H3 的 87.20
  • 安全:配套 pan2-guardrail 把有害文生视频请求产出不安全视频的比例从 33.9% 降到 1.5%,同时误拦 11.5% 的正常请求
阅读全文
关联模型 / 智能体 / 厂商:

n8n Labs 开源个人 Agent「Nod」研究预览版:自带本地虚拟机和浏览器替你退订、比价、拉发票,动作前先单独核对授权,LongMemEval 记忆测评 93.2%

工作流自动化公司 n8n 旗下新团队 n8n Labs 于 11 月 10 日发布 Nod 研究预览版。它是独立于 n8n 的桌面应用,在本机沙盒虚拟机里带着自己的浏览器干活,可接入 Gmail、日历、Drive、Slack、Notion,也能操作没有接口的网站,支持应用内、Telegram 和 WhatsApp 对话。Nod 以 Apache 2.0 开源,使用者自带 ChatGPT Plus/Pro 订阅、API Key 或本地模型;发送、付款、发帖、删除等动作前会由独立的模型检查是否获得授权,官方也提醒这一检查本身可能出错。

n8n Labs 开源个人 Agent「Nod」研究预览版:自带本地虚拟机和浏览器替你退订、比价、拉发票,动作前先单独核对授权,LongMemEval 记忆测评 93.2%

核心要点速览

  • 上线状态:研究预览版,支持 macOS 14+ 与 Windows 11(需 WSL 2),最新版 v0.6.1 于 11 月 10 日发布(GitHub Releases)
  • 开源与费用:Apache 2.0,应用免费;模型费用由用户自付,可用 ChatGPT Plus/Pro、API Key 或本地模型,不需要 n8n 账号
  • 记忆:官方称 LongMemEval(500 道历史对话问答)得分 93.2%,216 次 WhisperBench 攻击中没有邮件成功植入虚假记忆(官方口径)
  • 安全测评:官方 10 月 17 日用 GPT-6.1 Sol 在模拟环境跑测,任务完成率 98%,678 次运行 0 次不安全操作,13 个陷阱测试 0 次中招(厂商口径,非真实账号)
  • 成本护栏:每个任务显示花费并出具「收据」,可设月度上限,单任务超过 5 美元会先问你
阅读全文
关联模型 / 智能体 / 厂商:

蚂蚁灵波开源触觉基础模型 LingBot-Touch:近 5000 小时真实触觉数据预训练,冻结的 546 万参数编码器让 4 种机器人策略在 26 项真机任务上成功率提升 14–26 个百分点

蚂蚁集团旗下具身智能公司灵波科技(Robbyant)11 月 9 日开源触觉基础模型 LingBot-Touch(Apache 2.0),用 JEPA 式潜空间预测和共享 Haptic Transformer,把压阻、磁感、视触觉三类传感器统一成同一套触觉 token。官方技术报告称:在 26 项双臂灵巧手真机任务上,接入冻结的 546 万参数 Tiny 编码器后,Diffusion Policy、π0.5、LingBot-VLA、T-Rex 的平均成功率分别提升 13.9–24.8 个百分点,而直接喂原始触觉信号最多只有约一半收益。Tiny 与 Small 两个权重已上 Hugging Face。

蚂蚁灵波开源触觉基础模型 LingBot-Touch:近 5000 小时真实触觉数据预训练,冻结的 546 万参数编码器让 4 种机器人策略在 26 项真机任务上成功率提升 14–26 个百分点

核心要点速览

  • 预训练语料 4,983 小时、46.4 万段交互、约 13.3 亿帧,来自触觉手套与遥操作机器人手,覆盖压阻、磁感、视触觉三种原理
  • 官方口径:26 项真机任务平均成功率,LingBot-VLA 48.3%→73.1%、π0.5 48.1%→69.9%、T-Rex 45.4%→68.6%、Diffusion Policy 21.6%→35.6%
  • Tiny 编码器仅 546 万参数,给所增强的策略增加不到 0.2% 参数;Small 为 2176 万参数,两者均为 12 层 Transformer
  • 仿真 12 项灵巧手强化学习任务中成功率 69%,对比任务专用 CNN 特征 46%、无触觉 21%
  • 注意:可迁移到预训练时没见过的传感器型号,但新的传感器排布仍需先做几何标定
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LingBot-Touch⚡ LingBot-VLA⚡ pi0.5🌐 Ant Group🌐 Robbyant