AI 编程实时动态与要闻

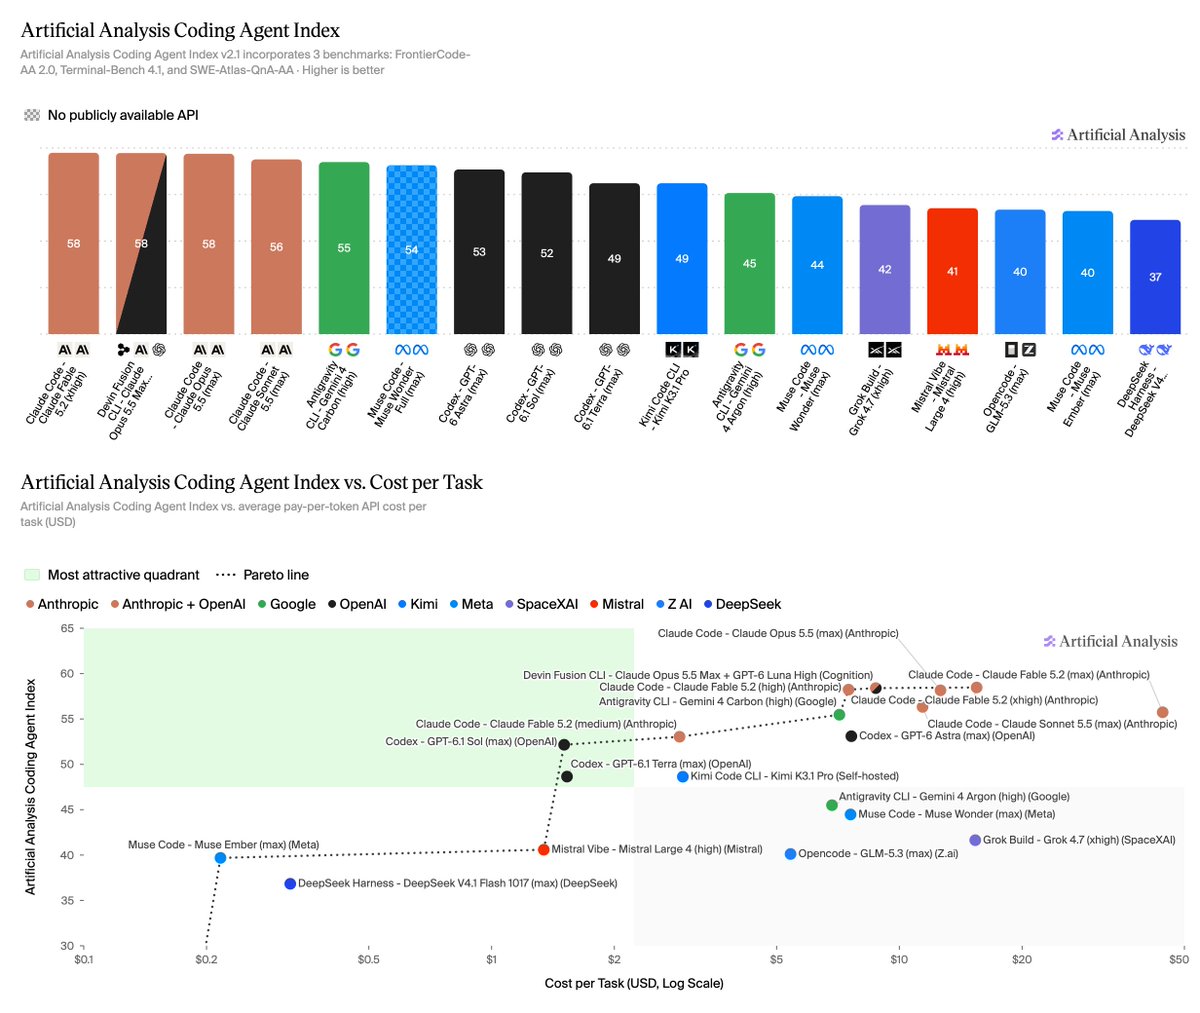
Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

Artificial Analysis 11 月 14 日发布编码智能体指数 v2.1:把 FrontierCode 从 1.1 换成 Cognition 的 FrontierCode 2.0(132 个真实任务,按维护者是否愿意合并评分),Terminal-Bench 从 4.0 升到 4.1,保留 SWE-Atlas-QnA-AA。Claude Code + Claude Fable 5.2(xhigh/high)和 Claude Opus 5.5(max)并列 58 分居首;因新版 FrontierCode 更难,各配置平均降 5 分,只有 Codex + GPT-6.1 Terra(max)基本没掉分。
Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

核心要点速览

  • v2.1 构成:FrontierCode-AA 2.0(132 个真实编码任务,按仓库维护者是否会合并评分)、Terminal-Bench 4.1(同样 66 题,更新验证器以提高可靠性、防奖励投机)、SWE-Atlas-QnA-AA
  • 并列第一 58 分:Claude Code + Claude Fable 5.2(xhigh 与 high 均为 58)、Claude Code + Claude Opus 5.5(max),以及 Devin Fusion CLI(Opus 5.5 max + GPT-6 Luna High);其后为 Claude Sonnet 5.5(max)56、Antigravity CLI + Gemini 4 Carbon(high)55
  • 23 个两版都测过的配置在 FrontierCode-AA 2.0 上全部低于 v1.1,均值从 45% 降到 29%;Claude Code + Fable 5.2 以 49% 领先。Terminal-Bench 4.1 各配置变化都不到 3 分,Kimi Code CLI + Kimi K3.1 Pro 以 68% 居首
  • 成本差约 30 倍:48 分以上配置中,Codex + GPT-6.1 Sol(max,52 分)每题 1.51 美元,Claude Code + Fable 5.2(max,56 分)每题 44.22 美元;Fable 5.2 在 medium/high/xhigh 分别为 2.89/7.51/15.47 美元
  • Claude Code 与 Devin Fusion CLI 遇到安全拒答会切换到备用模型:Devin Fusion CLI 与 Opus 5.5(max)约 9% 的尝试由备用模型完成,Fable 5.2(xhigh)6%,Sonnet 5.5 5%
阅读全文

Artificial Analysis Controlled Voice Arena:Speechify Simba 3.5 以 1192 Elo 登顶,与 HeyGen Voice 统计持平,每百万字符 6.58 美元仅为后者约五分之一

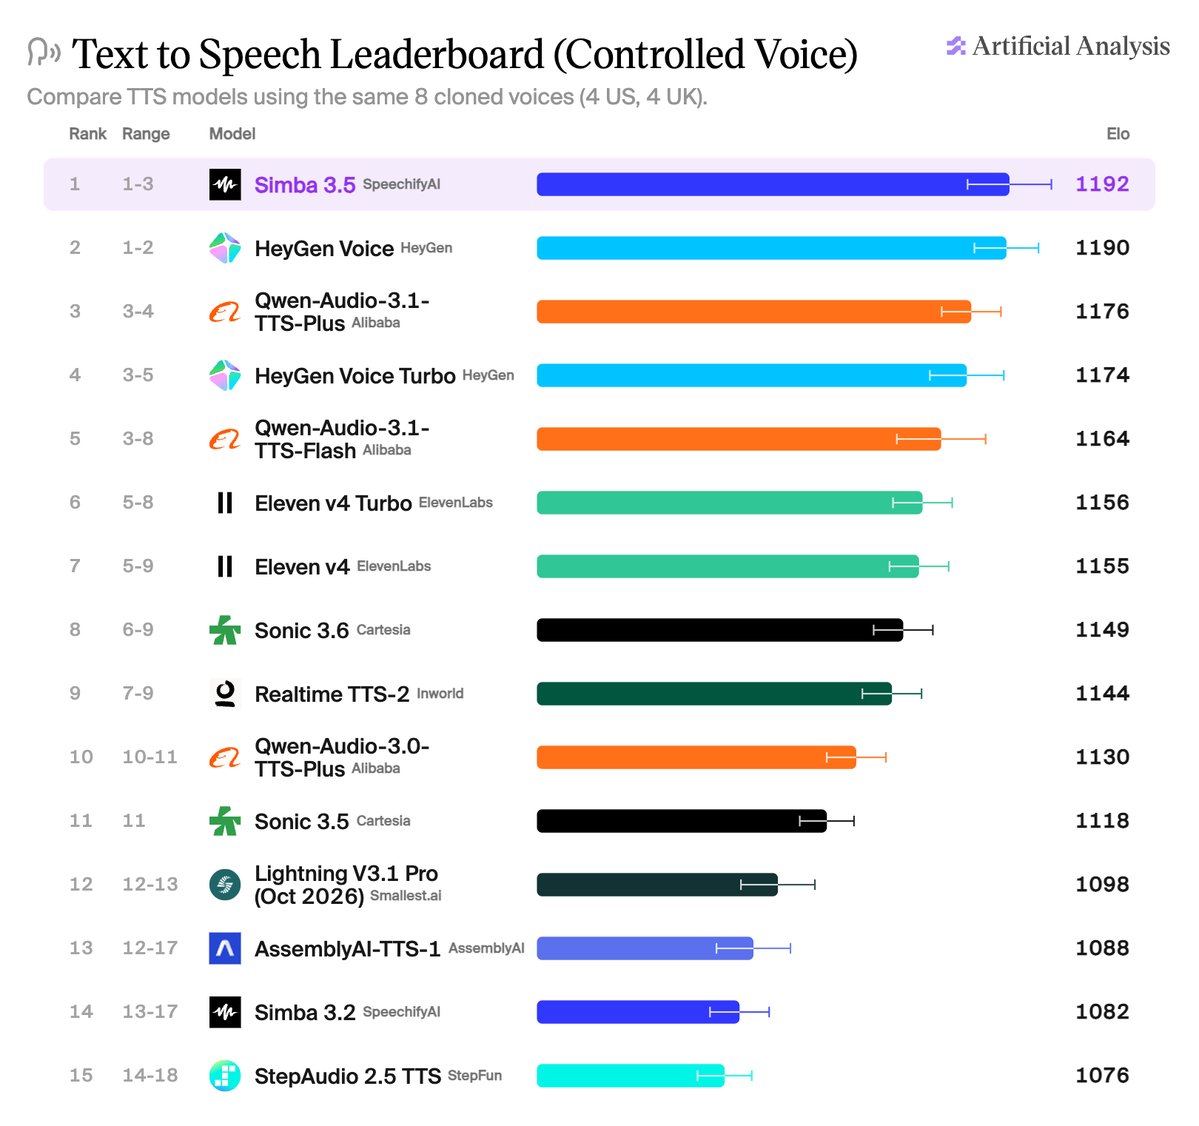
Artificial Analysis 11 月 13 日公布,Speechify 的语音合成模型 Simba 3.5 在 Controlled Voice Arena 排名第一,与 HeyGen Voice 统计持平。该榜所有模型都用同一组 8 个克隆声音(4 个美音、4 个英音)朗读,用户盲听投票,比的是模型本身而非演示音色。榜单显示 Simba 3.5 为 1192±17 Elo(1,783 个样本),HeyGen Voice 1190±13,Qwen-Audio-3.1-TTS-Plus 1176 居第三;Simba 3.5 API 价每百万字符 6.58 美元,HeyGen Voice 为 30 美元。

Artificial Analysis Controlled Voice Arena:Speechify Simba 3.5 以 1192 Elo 登顶,与 HeyGen Voice 统计持平,每百万字符 6.58 美元仅为后者约五分之一

核心要点速览

  • Controlled Voice Arena 让所有模型使用同一组 8 个克隆声音(4 美音、4 英音),用户盲听投票,排除「挑一个好听的演示音色」带来的偏差
  • Simba 3.5 为 1192±17 Elo(95% 区间 1175–1209,1,783 个样本),名次区间 1–3;HeyGen Voice 1190±13,名次区间 1–2,两者统计上持平
  • 第三至第五:Qwen-Audio-3.1-TTS-Plus 1176、HeyGen Voice Turbo 1174、Qwen-Audio-3.1-TTS-Flash 1164;Eleven v4 Turbo 1156、Eleven v4 1155 分列第六、第七
  • 价格(按各家 API 生成 100 万字符计):Simba 3.5 6.58 美元,HeyGen Voice 30 美元,HeyGen Voice Turbo 4 美元,Eleven v4 80 美元
  • 同一榜单上 Speechify 的上一代 Simba 3.2 为 1082 Elo,排第 14;AA 帖子还称 Simba 3.5 在 Provider Voice(厂商自带音色)榜排第 5
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Simba 3.5⚡ HeyGen Voice⚡ Qwen-Audio-3.1-TTS-Plus⚡ Eleven v4🌐 Artificial Analysis🌐 Speechify🌐 HeyGen🌐 Alibaba🌐 ElevenLabs

Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

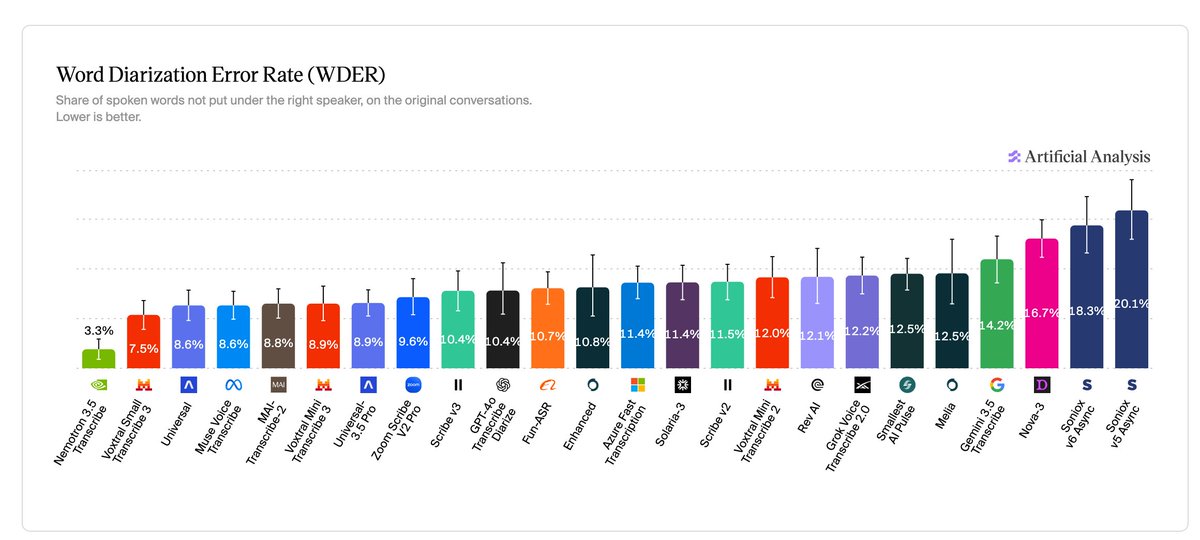
Artificial Analysis 11 月 13 日发布 Diarization Index,专门衡量语音转文字 API 能否把每个词归到真正说话的人:指标是 WDER(被分给错误说话人或无人说话的词占比),测试集为 97 段 2–8 人英文对话,按 2 人、3–4 人、5–8 人三档等权平均。NVIDIA 开源权重的 Nemotron 3.5 Transcribe 以 3.3% 居首,Voxtral Small Transcribe 3 以 7.5% 排第二,也是有标价 API 里最准的;MAI-Transcribe-2 为 8.8%,速度最快之一。

Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

核心要点速览

  • 新指标 WDER =(分错说话人的词 + 无人说话时段的词)÷ 参与评分的参考词数,越低越好;AA 称不用 DER,因为对 API 而言 DER 主要在考词时间戳而不是谁在说话
  • 测试集 97 段对话、每段约 2–9 分钟、总时长约 6.8 小时,真实与合成语音混合,大部分音频为私有留出集,另含约 126 分钟公开的 NOTSOFAR-1 会议录音
  • 评测时直接调用各 API 并开启说话人分离,不告诉模型有几个人在说话,整段音频一次送入;价格包含单独收费的分离功能
  • Nemotron 3.5 Transcribe 2 人对话 WDER 1.7%,5–8 人时也只有 5.6%;在人数最多的一档,其他所有 API 的 WDER 都超过 10%
  • Voxtral Small Transcribe 3 为 7.5%、每千分钟 4 美元;MAI-Transcribe-2 为 8.8%、每千分钟 1.67 美元,每等 1 秒可转写 93.7 秒音频;Nemotron 3.5 Transcribe 是开源权重模型,AA 未列价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe⚡ Voxtral Small Transcribe 3⚡ MAI-Transcribe-2🌐 Artificial Analysis🌐 NVIDIA🌐 Mistral AI🌐 Microsoft

Artificial Analysis 网络安全指数:腾讯 Hy4 得 58 分排第 3,在 CWE-Bench-AA 漏洞修复测试中以 76% 登顶,每题成本 0.92 美元

独立评测机构 Artificial Analysis 11 月 13 日公布腾讯混元 Hy4 在其网络安全指数(Cyber Index)上的结果:综合 58 分,排第 3,比 DeepSeek V4.1 Flash 1017(max)高 1 分,落后于 Kimi K3.1 Pro(64)和仅限受信任访问的 GPT-6 Sol(Daybreak Blue,max,69)。在三项子测之一的 CWE-Bench-AA 上,Hy4 以 76% 的单次通过率排第 1,领先第 2 名 DeepSeek 6 到 7 个百分点。每道题平均成本 0.92 美元,平均输出 6.4 万 token,处在能力与成本的帕累托前沿上。

Artificial Analysis 网络安全指数:腾讯 Hy4 得 58 分排第 3,在 CWE-Bench-AA 漏洞修复测试中以 76% 登顶,每题成本 0.92 美元

核心要点速览

  • 综合排名:Cyber Index 58 分排第 3,前两名为 GPT-6 Sol(Daybreak Blue,max,仅受信任访问)69 分、Kimi K3.1 Pro 64 分;DeepSeek V4.1 Flash 1017(max)57 分紧随其后
  • 单项第一:CWE-Bench-AA 单次通过率 76%,DeepSeek V4.1 Flash 1017(max)69%、Grok 4.7(xhigh)68%
  • 性价比:每题 0.92 美元,比 Grok 4.7(xhigh)高 2 分而成本约为其 1/11;比 DeepSeek 高 1 分,成本约为其 2 倍
  • 输出更省:每题约 6.4 万输出 token,比 DeepSeek 少 43%、比 Grok 4.7 少 37%,但比 Kimi K3.1 Pro 多 49%
  • 评测口径:AA 按 0.834/2.501 美元每百万输入/输出 token 计价;OpenRouter 目前把 tencent/hy4 标为 0.417/1.25 美元,实际成本可能更低
阅读全文
AD赞助内容

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

新加坡时间 11 月 13 日 02:02,Google DeepMind、Google AI 和 Gemini 官方账号同时宣布 Gemini 4 Hydrogen 正式上线,Gemini API 更新日志标注为 GA,模型 ID 是 gemini-4-hydrogen。按官方口径,它在默认 high 思考档位下的 Artificial Analysis 智能指数为 51,高于 Gemini 4 Argon 的 50,新增的 xhigh 档位可到 54;完成任务的速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 得分从 18.2% 提高到 57%。价格在 100 万 token 上下文内统一为输入 1.5 美元、输出 7.5 美元(每百万 token),免费层也能用。它同时成为 Gemini 应用、Google 搜索和 Antigravity 托管智能体的默认模型。昨天站内报道过的 SKU 价目表泄露,今天由官方证实。Cursor 官方随后宣布 Hydrogen 已上线编辑器,默认努力档(high)在 CursorBench 4.0 上为 54.3%,高于 Gemini 3.8 Flash 的 39.6%。

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

核心要点速览

  • 官方口径:AA 智能指数 51(默认 high 档),高于 Gemini 4 Argon 的 50;新增 xhigh 档可达 54
  • 速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 从 18.2% 升到 57%,捏造陈述减少 5 倍以上
  • 定价:每百万 token 输入 1.5 美元、输出 7.5 美元,100 万 token 上下文内不分段加价,免费层可用
  • Antigravity 新功能 Orchestrator 在 Carbon 和 Hydrogen 之间自动切换:Terminal-Bench 4.0 成功率接近纯 Carbon,额度少用 24%,速度快 19%
  • 合作方实测:复杂图、SQL 和数据类企业任务比 3.8 Flash 快 2–2.8 倍,token 用量少 12%–23%
  • Cursor:官方宣布 Hydrogen 已上线编辑器;CursorBench 4.0 默认 High 54.3%(每任务约 5.59 美元),高于 Gemini 3.8 Flash 的 39.6%;Medium 46.7%(约 1.76 美元),Low 27.9%(约 0.28 美元);属第三方模型,不计入套餐包含用量(Cursor 文档、CursorBench)
阅读全文

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

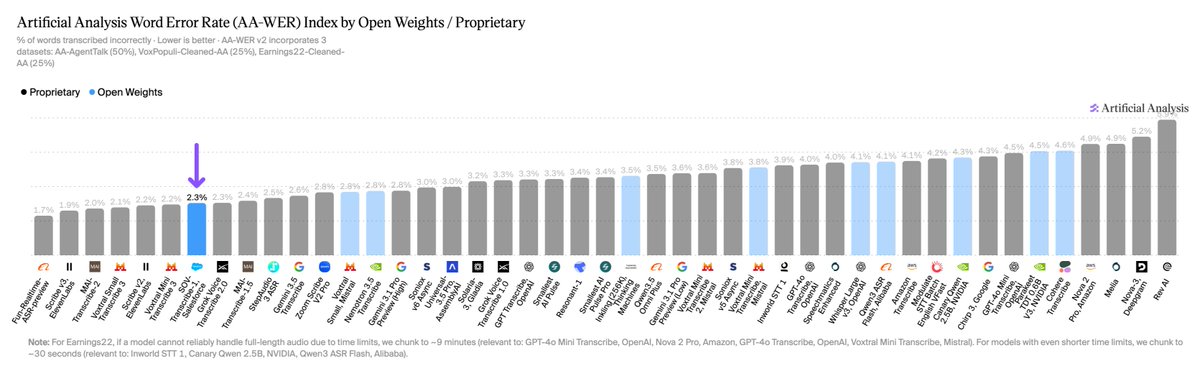
新加坡时间 11 月 13 日 00:30,Artificial Analysis(@ArtificialAnlys)发帖称,Salesforce 新发布的 SOV-Transcribe-1 成为开源权重语音转文字模型第一名:在 AA-WER 指数上词错误率 2.3%,在包括闭源模型在内的 44 个模型中排第 7。它比紧随其后的开源模型 Mistral Voxtral Small 和英伟达 Nemotron 3.5 Transcribe(均为 2.8%)低 0.5 个百分点。模型由 Salesforce 主权 AI(Missionforce Sovereign AI)团队开发,总参数 26.6B、激活参数 4.6B,结构是 Whisper large-v3 音频编码器加 Gemma 4 26B A4B MoE 解码器,权重以 Apache 2.0 许可发布在 Hugging Face。它是非流式模型,适合整段录音转写,不适合实时字幕。

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

核心要点速览

  • AA-WER 2.3%:开源权重第 1、44 个模型中总榜第 7;Voxtral Small 与 Nemotron 3.5 Transcribe 均为 2.8%
  • 分数据集:Earnings22 财报电话 4.1%(Voxtral Small 4.8%),VoxPopuli 1.5%(对手 1.8%),AA-AgentTalk 语音客服对话 1.8%,与 Nemotron 持平
  • 26.6B 总参数 / 4.6B 激活;Whisper large-v3 编码器 + 投影层 + Gemma 4 26B A4B MoE;BF16,单段音频实测最长 30 分钟,支持英法德西意葡荷 7 种语言
  • 官方称 VoiceCodeBench(电话号码、邮箱等实体)任务成功率 76.3%、实体召回 93.4%,23 个系统中排第 2;AppTek 14 种英语口音平均 WER 8.21%,其中 8 种口音最低(含新加坡英语)
  • Apache 2.0;可用 vLLM 插件(vLLM 0.32.0)或 Transformers 部署;官方实测单张 RTX PRO 6000 Blackwell 每秒可转写 1,039 秒音频(配合 DFlash 草稿模型)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SOV-Transcribe-1⚡ Voxtral Small⚡ Nemotron 3.5 Transcribe⚡ Gemma 4⚡ Whisper large-v3🌐 Salesforce🌐 Artificial Analysis🌐 Mistral AI🌐 NVIDIA🌐 Google

X 热议:Artificial Analysis 称 Gemini 4 Carbon 在机械臂评测 AA-Robotics 里连跑 7 小时 33 分,把夹爪撞坏了,重试是否该算分引发讨论

独立评测机构 Artificial Analysis(AA)11 月 12 日中午(新加坡时间)在官方账号发帖:Google 的 Gemini 4 Carbon 在 AA-Robotics v0.1 实验室里一共跑了 7 小时 33 分钟,过程中把机械臂「撞来撞去」,弄坏了一个夹爪,AA 给了它一次重试。帖子附 11 秒现场视频,约 2 万浏览、300 余赞、40 余条回复。讨论集中在三点:重试成绩是否该单列、通用模型连续操控真实硬件 7 个多小时意味着什么、以及物理评测里的设备损耗和安全看护成本。AA 尚未公布 Carbon 在该榜的得分。以下为评测方分享与社区讨论,不代表最终榜单。

X 热议:Artificial Analysis 称 Gemini 4 Carbon 在机械臂评测 AA-Robotics 里连跑 7 小时 33 分,把夹爪撞坏了,重试是否该算分引发讨论

核心要点速览

  • AA 口径:Gemini 4 Carbon 在 AA-Robotics v0.1 实验室累计 7 小时 33 分,撞坏 1 个夹爪,AA 给了 1 次重试
  • AA 尚未公布 Carbon 的得分,也没说明重试成绩如何计入;当前榜首仍是 Claude Fable 5.2(75 分)
  • 按 8 项任务粗算约合每题近 1 小时;首发榜单上 GPT-6 Astra 平均每题约 30 分钟,人类约 20 秒
  • 热度:约 2 万 浏览、300+ 赞、40+ 回复、16 条引用
  • Carbon API 介绍期价格每百万输入 / 输出 token 2 / 10 美元,11 月 30 日后为 4 / 20 美元(Google 官方口径)
阅读全文

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

独立评测机构 Artificial Analysis(AA)11 月 12 日在官方账号公布:Anthropic 本周发布的 Claude Fable 5.2 在 AA-Robotics v0.1 上得分 75,成为新榜首,高于此前第一的 GPT-6 Astra(69)和 GPT-6.1 Sol(65)。这项评测让编码 Agent 通过 HTTP API 操控一台 6 轴机械臂完成 8 项桌面任务。AA 称 Fable 5.2 是第一个在「测量盒子尺寸」任务上得分的模型:它只靠摄像头视频,把场景里的卷尺当作比例尺来估算盒子尺寸。上一代 Fable 5.1 在 10 月首发榜单上只有 46.3 分。

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

核心要点速览

  • AA-Robotics v0.1 新榜首:Claude Fable 5.2 75 分,GPT-6 Astra 69、GPT-6.1 Sol 65(AA 口径)
  • 比上一代大跳:Fable 5.1 在 10 月首发榜单上为 46.3,Opus 5.5 为 48.8
  • 「量盒子」任务(长宽高误差需在约 2 毫米内)此前所有模型均未得分,Fable 5.2 是第一个
  • Fable 5.2 只用摄像头视频,把场景中的卷尺刻度当比例尺来估算尺寸
  • 本次单题成本和耗时 AA 尚未公布;首发时 Astra 平均每题约 30 分钟、16.36 美元
阅读全文

Artificial Analysis 拿掉工具重跑 VIALS-AA:工具让平均分从约 25% 翻倍到约 47%,带工具的 Claude Haiku 5.5 胜过不带工具的 Fable 5.2,成本仅约十分之一

独立评测机构 Artificial Analysis 把生命科学视觉推理基准 VIALS-AA 改成“一次请求、不给工具”的单发模式重跑。结果显示,工具让各模型平均分从约 25% 升到约 47%。榜首 Claude Fable 5.2 (max) 带工具 67%、每题 4.20 美元,不带工具只有 44%、0.73 美元;Claude Haiku 5.5 (max) 带工具 49%、每题 0.07 美元。同日 AA 另指出:在 Claude 产品线里,升一档模型通常比把推理强度开到最大更划算。

Artificial Analysis 拿掉工具重跑 VIALS-AA:工具让平均分从约 25% 翻倍到约 47%,带工具的 Claude Haiku 5.5 胜过不带工具的 Fable 5.2,成本仅约十分之一

核心要点速览

  • 工具让 VIALS-AA 各模型平均分从约 25% 升至约 47%(AA 口径)
  • Fable 5.2 (max):带工具 67%/每题 4.20 美元,不带工具 44%/0.73 美元,成本差 5.8 倍
  • Haiku 5.5 (max) 带工具 49%、每题 0.07 美元;Opus 5.5 不带工具仅 34%、0.33 美元
  • 23 道细胞计数题上,Fable 从 65% 跌到 9%,Opus 5.5 (max) 从 57% 跌到 4%
  • Claude 线:Opus 5.5 (xhigh, 57) 超过 Sonnet 5.5 (max, 55),每题成本低 40%、耗时约减半
阅读全文

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

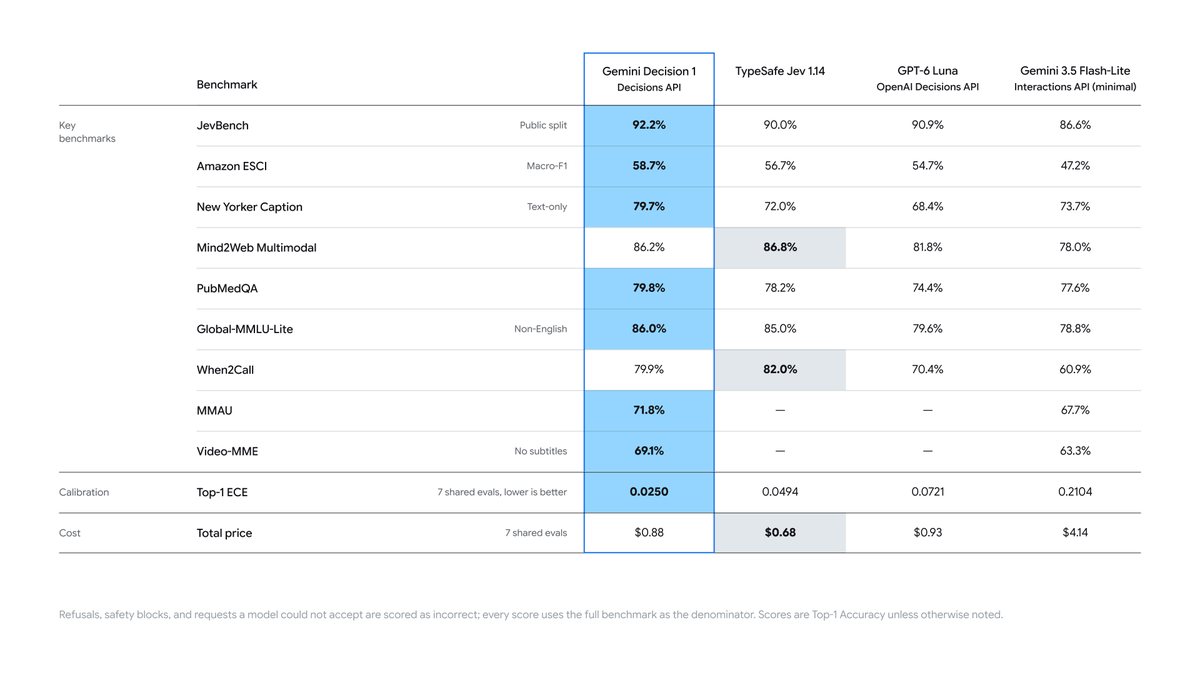
Google 11 月 11 日(北京时间 12 日凌晨)由 Sundar Pichai、@Google、@GoogleAIStudio 和 Logan Kilpatrick 正式宣布 Gemini Decisions API 与专用判定模型 Gemini Decision 1(gemini-decision-1)。它不逐 token 生成文字,而是一次前向计算给最多 1,000 个是否、单选(2–255 个选项)、打分题给出概率和置信度,支持文本、图片、音频、视频和 PDF,上下文 256K。官方称端到端延迟 150–250 毫秒,1 到 100 题延迟几乎不变;输入每百万 token 0.10 美元,输出不计费,在共享评测集上总成本约为 Gemini 3.5 Flash-Lite 的五分之一。官方跑分表中,它在 9 项评测里 7 项第一,7 项共享评测的 Top-1 校准误差 0.0250,低于 TypeSafe Jev 1.14 和 OpenAI 的 GPT-6 Luna。此前本站依据 API 更新日志报道时官方尚未公告,现已正式发布,此前「模型被撤下」的说法不成立。第三方 Artificial Analysis 测得其 Decision Index 为 66 分,尚未登顶。

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

核心要点速览

  • 官方正式发布:Sundar Pichai、@Google、@GoogleAIStudio、Logan Kilpatrick 同步宣布,模型 ID gemini-decision-1
  • 单次最多 1,000 个问题、上下文 256K;模型计算中位数 50–100 毫秒,端到端 150–250 毫秒(官方口径)
  • 官方跑分:9 项评测 7 项第一,如 JevBench 92.2%、Amazon ESCI 58.7%;Mind2Web 多模态 86.2% 和 When2Call 79.9% 落后 TypeSafe Jev 1.14
  • Top-1 校准误差 0.0250,TypeSafe Jev 1.14 为 0.0494、GPT-6 Luna 为 0.0721、Gemini 3.5 Flash-Lite 为 0.2104;第三方 Artificial Analysis:Decision Index v2.1 66 分,落后榜首 Drex Max v1.1 / GLiDE v1.2(73)7 分,Brier 0.18
  • 价格:输入 0.10 美元/百万 token、输出 0;7 项共享评测总花费 0.88 美元,Flash-Lite 为 4.14 美元,TypeSafe Jev 1.14 为 0.68 美元更便宜
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini Decision 1⚡ Gemini Decision 1🌐 Google
AD赞助内容

ACE Studio 新音乐模型 ACE Music v1 登顶 Artificial Analysis 人声音乐榜:Elo 1160,领先 Suno v6 的 1144,暂无 API

第三方评测机构 Artificial Analysis 11 月 11 日公布,ACE Studio 的新音乐生成模型 ACE Music v1 以 Elo 1160 首次上榜即排在 AA-Music-Vocal v1.1 第 1,领先 Suno v6(1144)和 Suno v6-mini(1132)。排名来自 AA 认证私有评审员的盲测投票。ACE Music v1 能根据文字描述或用户自己的歌词生成带人声或纯器乐的完整歌曲,AA 实测它在雷鬼/舞厅和古典/管弦乐提示上表现最好。该模型目前没有 API,只能在 ACE Music 应用里用,免费档每天 20 积分,付费档按年付最低每月 7.90 美元。

ACE Studio 新音乐模型 ACE Music v1 登顶 Artificial Analysis 人声音乐榜:Elo 1160,领先 Suno v6 的 1144,暂无 API

核心要点速览

  • 榜单:AA-Music-Vocal v1.1 前 5 为 ACE Music v1(Elo 1160)、Suno v6(1144)、Suno v6-mini(1132)、Mureka V9.5(1101)、Mureka V9(1063),领先第 2 名 16 分
  • 评测方式:AA 认证私有评审员盲测投票,AA 称 ACE Music v1 在雷鬼/舞厅、古典/管弦乐两类提示上最强
  • 可用性:没有 API,只在 ACE Music 应用内使用;免费档每天 20 积分(约 10 首),不能下载、不可商用
  • 定价(官网口径,按年付):Creator 每月 7.90 美元,1000 积分(约 500 首)并含商用授权;Artist 每月 16.58 美元,约 1250 首
  • 背景:ACE Studio 成立于 2018 年,以 AI 歌声合成起家,并与阶跃星辰(StepFun)合作开发开源权重音乐模型系列 ACE-Step
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ace Music V1⚡ Suno V6⚡ Suno V6 mini⚡ mureka-v9.5⚡ ace-step-1.5🌐 ACE Studio🌐 Artificial Analysis🌐 Suno🌐 StepFun

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

Google DeepMind 11 月 10 日与 Artificial Analysis 联合推出 MKA(Multimodal Knowledge Agent)基准,测 Agent 能否读懂建筑图纸、工程原理图、临床影像等视觉密集文件,并交付幻灯片、表格、报告和标注图。200 个私有任务覆盖 10 个行业、83 种职业,每题约 70 条专家评分项。Artificial Analysis 首批测了 21 个模型:Claude Fable 5.2(max)Climb WSR 57% 居首,Gemini 4 Carbon(high)54%,Claude Opus 5.5(max)53%;Fable 平均每题 31.97 美元,Carbon 为 6.29 美元。另有 10 道公开题已上 Hugging Face。

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

核心要点速览

  • 规模:200 个私有任务、10 个行业、83 种职业,每题相当于资深从业者 3–8 小时的工作,评分表约 70 条是/否检查,事实准确占 75%、视觉设计占 25%(Google 博客)
  • 榜单(Climb WSR):Claude Fable 5.2(max)57%、Gemini 4 Carbon(high)54%、Claude Opus 5.5(max)53%,共测 21 个模型(AA 榜单)
  • 成本:Fable 5.2 平均每题 $31.97,是 Carbon($6.29)的 5 倍多、GPT-6.1 Sol($1.11)的约 29 倍;最便宜的是 GPT-6 Luna(Max)$0.18
  • 没有全能冠军:Fable 5.2 领先 5 个行业,Opus 5.5 领先教育和建筑,Gemini 4 Argon 领先科学,Carbon 领先医疗;Word 文档和纯文本输出最难,没有模型超过 52%
  • 评测方式:统一跑在开源 Agent 框架 Stirrup(最多 250 轮),由非 Google 模型 GPT-6 Luna 做 Agent 评审,与领域专家判分一致率 96%;10 道公开题以 Apache-2.0 发布在 Hugging Face
阅读全文

Artificial Analysis 第三方评测:Claude Fable 5.2 登顶 AA-3D 交互式 3D 场景榜(1271 Elo,领先第二名 67 分),并以 67% 拿下科学图像推理 VIALS-AA 第一

独立评测机构 Artificial Analysis 11 月 10 日公布两项新结果。在考察“让模型当 Agent 用 three.js 搭交互式 3D 网页”的 AA-3D 榜上,Claude Fable 5.2(Max)拿到 1271 Elo,比第二名 Claude Sonnet 5.5(1204)高 67 分,95% 置信区间 1246–1297 与其他模型不重叠,领先超出误差范围;比上一代 Fable 5.1(1139)高 132 分,也高于 OpenAI 最高的 GPT-6 Astra(1168)和 Google 最高的 Gemini 4 Argon(1147)。在生命科学图像推理榜 VIALS-AA 上,Fable 5.2 得 67%,超过此前领先的 Gemini 4 Carbon(64%)和 GPT-6 Astra(63%)。AA 还发现两家路线相反:Fable 每题平均约 37 次工具调用,Astra 只有约 8 次。

Artificial Analysis 第三方评测:Claude Fable 5.2 登顶 AA-3D 交互式 3D 场景榜(1271 Elo,领先第二名 67 分),并以 67% 拿下科学图像推理 VIALS-AA 第一

核心要点速览

  • AA-3D:Fable 5.2(Max)1271 Elo,第二名 Sonnet 5.5 1204、Opus 5.5 1202;95% 置信区间 1246–1297,与其他模型不重叠
  • 代际提升:比 Fable 5.1(1139)高 132 分;OpenAI 最高 GPT-6 Astra 1168,Google 最高 Gemini 4 Argon 1147
  • AA-3D 规则:模型在离线沙箱里当 Agent,最多 3 小时 / 250 轮,可用 Blender、Rapier 物理、Python 和无头浏览器自测;真人评委盲选两两对比,每个场景至少看 30 秒
  • VIALS-AA:Fable 5.2 67%,Gemini 4 Carbon 64%,GPT-6 Astra 63%
  • 工具使用路线相反:Fable 每题约 37 次工具调用、每轮平均 1.60 次(榜上最高);Astra 约 8 次,为 AA 测过的最少
阅读全文

Meta 发布最小最省的 Muse Ember:每百万 token 输入 0.10 美元、输出 0.50 美元,1M 上下文,AA 智能指数 36 分追平 Claude Haiku 5.5,单任务成本约为其三分之一

北京时间 11 月 10 日凌晨,AI at Meta 官方账号发布 Muse Ember,称其是 Meta 目前最小、最高效的模型,面向 Agent 每天反复执行的工作:工具调用、编码子任务、路由、信息抽取和长文档解析。Muse Ember 支持 1M token 上下文、最多 512K 输出,原生理解文本、图像、音频和视频。定价为每百万 token 输入 0.10 美元、缓存输入 0.004 美元、输出 0.50 美元,已在 Meta Model API(模型名 muse-ember-1.0)和 Muse Code 上线。Artificial Analysis 测得其智能指数 36 分,与 Claude Haiku 5.5(max)持平,但单任务成本约 0.14 美元,只有后者的约三分之一。它是第一个用 Muse Wonder Full 训练出来的模型,权重不开放。

Meta 发布最小最省的 Muse Ember:每百万 token 输入 0.10 美元、输出 0.50 美元,1M 上下文,AA 智能指数 36 分追平 Claude Haiku 5.5,单任务成本约为其三分之一

核心要点速览

  • 定位:Meta 最小、最高效的模型,专做 Agent 的高频小任务(工具调用、编码子任务、路由、抽取、长文档解析);官方建议「Muse Wonder 负责规划,Muse Ember 负责跑量」
  • 规格:1M 上下文、最多 512K 输出,原生支持 文本/图像/音频/视频 输入,支持 Responses API
  • 定价:输入 $0.10、缓存输入 $0.004、输出 $0.50 / 百万 token;输入价约为 Muse Spark 1.3($1.25)的 1/12
  • 跑分(Artificial Analysis):智能指数 36,与 Claude Haiku 5.5(max)持平,单任务成本 $0.14 vs $0.41;Coding Agent Index 46(Haiku 5.5 在 Claude Code 中为 37,GPT-6 Luna 在 Codex 中为 31),但 FrontierCode 2.0 27.2% 落后 Haiku 的 34.9%
  • 短板:AA-Omniscience 知识准确率仅 21.1%,主要因为它拒答 64% 的问题,幻觉率因此只有 17.4%;不开放权重,只能通过 Meta Model API 和 Muse Code 使用
阅读全文

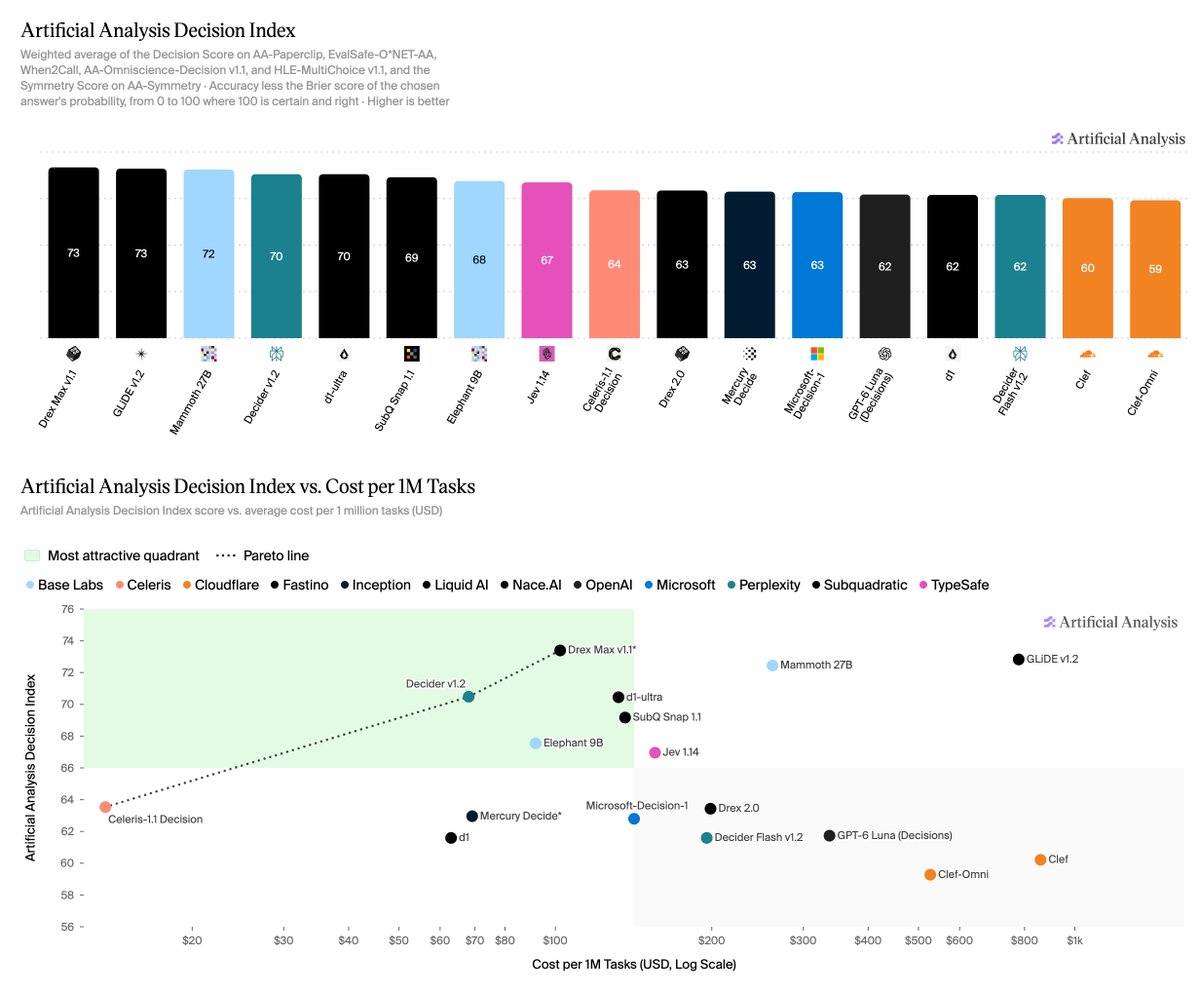
Artificial Analysis 发布 Decision Index v2:改用奖励「校准置信度」的 Decision Score,私有数据占比升至 45%,Drex Max v1.1 以 73 分险胜

11 月 8 日(北京时间 11 月 9 日早上),独立评测机构 Artificial Analysis 发布决策模型榜单 Decision Index 第二版。新版把头号指标换成同时看「答对没有」和「置信度准不准」的 Decision Score,私有数据占比从 v1 的 25% 提到 45%,新增 1,500 份私有文档的 AA-Paperclip 和测一致性的 AA-Symmetry。决策模型中 Nace AI 的 Drex Max v1.1 与 Fastino 的 GLiDE v1.2 同为 73 分,Drex Max 以小数微弱领先,Base Labs 的 Mammoth 27B 72 分。通用大模型 Claude Haiku 5.5 (Max) 77 分、GPT-6 Luna (Max) 76 分更高,但每百万任务成本分别为 6,240 和 1,530 美元,远高于 Drex Max 的 102 美元。

Artificial Analysis 发布 Decision Index v2:改用奖励「校准置信度」的 Decision Score,私有数据占比升至 45%,Drex Max v1.1 以 73 分险胜

核心要点速览

  • 新指标(官方榜单):单题得分 = 50 ×(1 + c −(p − c)²),整体等于 50 ×(1 + 准确率 − Brier 分数),答对必高于 50、答错必低于 50,置信度在各自半区内拉开差距
  • 权重重排:AA-Paperclip 30%、AA-Symmetry 15%、EvalSafe-O*NET-AA 15%、AA-Omniscience-Decision v1.1 15%、HLE-MultiChoice v1.1 15%、NVIDIA When2Call 10%(v1 为 25%),饱和的 WildGuardTest 被移除
  • 决策模型前三(官方口径):Drex Max v1.1 73、GLiDE v1.2 73、Mammoth 27B 72;通用模型 Claude Haiku 5.5 (Max) 77、GPT-6 Luna (Max) 76
  • 成本差距超 60 倍:Celeris-1.1 Decision 每百万任务 14 美元、Drex Max v1.1 102 美元、Clef 859 美元;GLiDE v1.2 每道题重复计费输入,成本 780 美元,约为 Drex Max 的 8 倍
  • 速度:Celeris-1.1 Decision 单任务 56 毫秒、Elephant 9B 70 毫秒;GPT-6 Luna (Max) 11.34 秒、Claude Haiku 5.5 (Max) 32.65 秒
阅读全文
关联模型 / 智能体 / 厂商: