AI 编程实时动态与要闻

Deepnote 发布 Agent Initiative Benchmark:测 12 个前沿模型做「主动型智能体」,GPT-6 Astra 以 8.97 分居首,GPT-6.1 Sol 每任务仅 0.11 美元排第二

数据笔记本公司 Deepnote 开源 Agent Initiative Benchmark v1.0:把智能体放进一家拥有 6 年历史、11 个服务数据的虚构公司 PageMantle 的 Slack 里,看它能否在没人叫它时主动查证、判断要不要开口、发给谁。50 个场景测 12 个模型,GPT-6 Astra 8.97 分第一,GPT-6.1 Sol 8.65 分第二,Claude Fable 5.2 8.17 分第三。
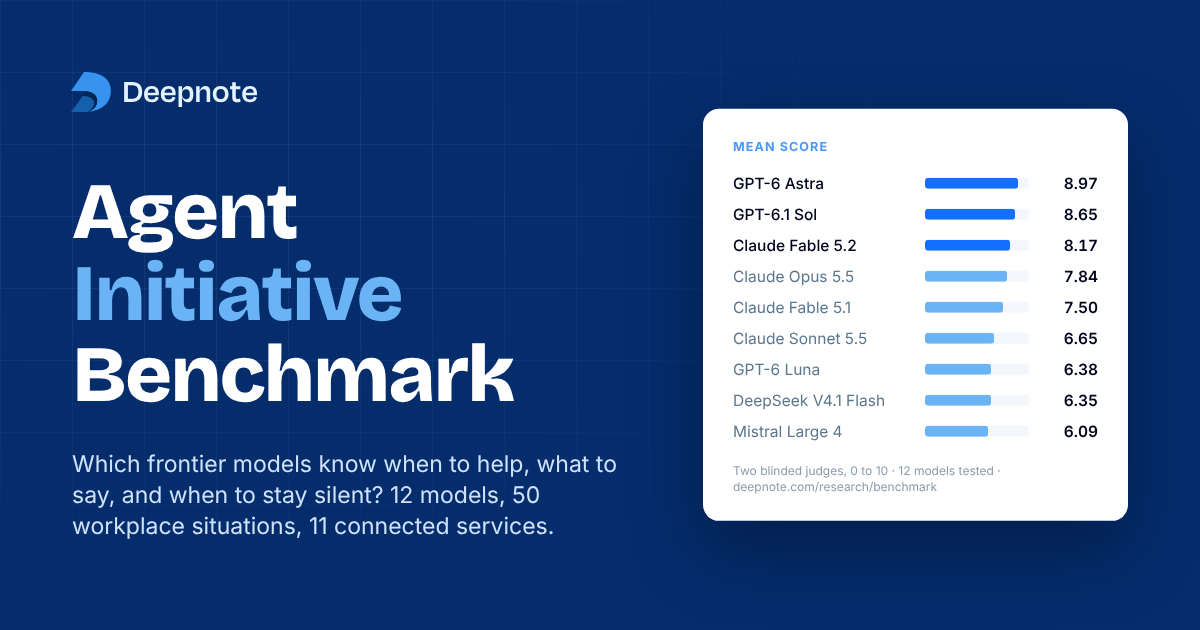
Deepnote 发布 Agent Initiative Benchmark:测 12 个前沿模型做「主动型智能体」,GPT-6 Astra 以 8.97 分居首,GPT-6.1 Sol 每任务仅 0.11 美元排第二

核心要点速览

  • 排名前三:GPT-6 Astra 8.97、GPT-6.1 Sol 8.65、Claude Fable 5.2 8.17;Gemini 4 Argon 5.60、Grok 4.7 4.51 垫底(官方结果页)
  • 最贵不等于最好:Sol 每任务 0.11 美元,Fable 5.2 为 1.87 美元;GPT-6 Luna(0.007 美元)与 Claude Fable 5.1(3.02 美元)价差约 430 倍,分数只差 1.1 分
  • 模型擅长帮忙、不擅长闭嘴:该开口时约 9/10 会发消息,该沉默时只有约 6/10 忍住;多说一次的成本约是沉默的 1.8 倍
  • 工具调用最多的两个模型得分最低:Gemini 4 Argon 平均 35 次、Grok 4.7 平均 36 次,约一半需要帮忙的任务没给出答案
  • 代码与任务 Apache 2.0、PageMantle 数据集 CC BY 4.0,已放在 GitHub 与 Hugging Face
阅读全文

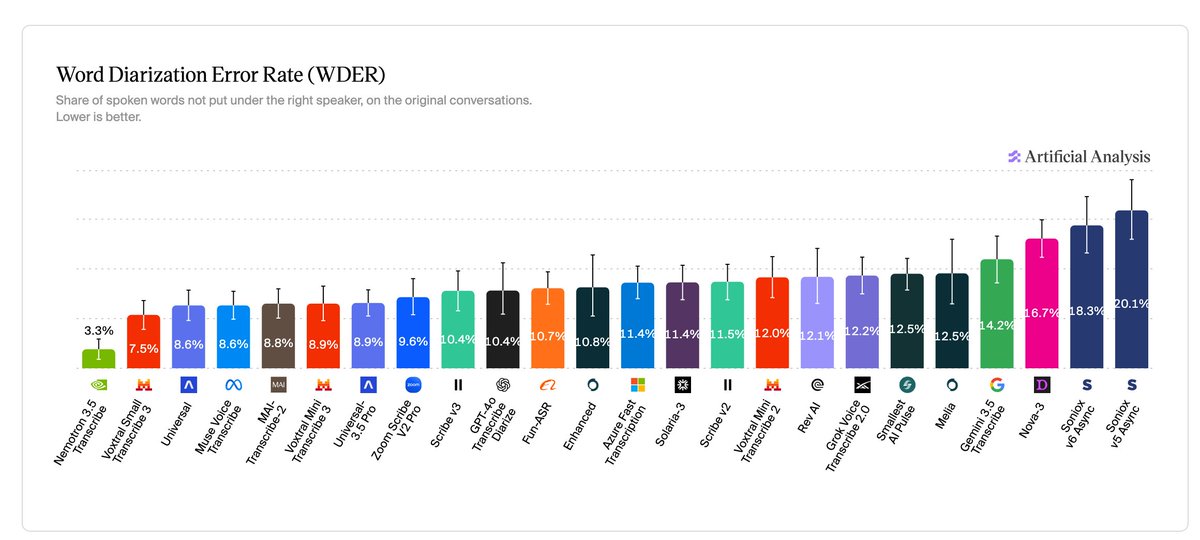
Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

Artificial Analysis 11 月 13 日发布 Diarization Index,专门衡量语音转文字 API 能否把每个词归到真正说话的人:指标是 WDER(被分给错误说话人或无人说话的词占比),测试集为 97 段 2–8 人英文对话,按 2 人、3–4 人、5–8 人三档等权平均。NVIDIA 开源权重的 Nemotron 3.5 Transcribe 以 3.3% 居首,Voxtral Small Transcribe 3 以 7.5% 排第二,也是有标价 API 里最准的;MAI-Transcribe-2 为 8.8%,速度最快之一。

Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

核心要点速览

  • 新指标 WDER =(分错说话人的词 + 无人说话时段的词)÷ 参与评分的参考词数,越低越好;AA 称不用 DER,因为对 API 而言 DER 主要在考词时间戳而不是谁在说话
  • 测试集 97 段对话、每段约 2–9 分钟、总时长约 6.8 小时,真实与合成语音混合,大部分音频为私有留出集,另含约 126 分钟公开的 NOTSOFAR-1 会议录音
  • 评测时直接调用各 API 并开启说话人分离,不告诉模型有几个人在说话,整段音频一次送入;价格包含单独收费的分离功能
  • Nemotron 3.5 Transcribe 2 人对话 WDER 1.7%,5–8 人时也只有 5.6%;在人数最多的一档,其他所有 API 的 WDER 都超过 10%
  • Voxtral Small Transcribe 3 为 7.5%、每千分钟 4 美元;MAI-Transcribe-2 为 8.8%、每千分钟 1.67 美元,每等 1 秒可转写 93.7 秒音频;Nemotron 3.5 Transcribe 是开源权重模型,AA 未列价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe⚡ Voxtral Small Transcribe 3⚡ MAI-Transcribe-2🌐 Artificial Analysis🌐 NVIDIA🌐 Mistral AI🌐 Microsoft
I
IBM Graniteibm-granite·
👀10
🔥82

IBM 发布 LLM 原生标记语言 LLMON 和两款 Granite 4.1 预览模型(3B/8B):用保留 token 把指令和数据分开,OPI 间接注入测试中比最好的前沿模型多挡住 47% 的攻击

11 月 12 日,IBM Granite 团队在 Hugging Face 发布 LLMON(LLM Object Notation,读作「lemon」):用词表里的保留特殊 token 包裹带语义标签的块(指令、数据、要求等),每块有唯一 ID,再由一个 exec 执行块指定要运行哪条指令、作用于哪些数据。同时开源两款实验预览模型 granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview(Apache 2.0),附带 GitHub 工具包、JSON 与 LLMON 无损互转工具。官方称在 OPI 间接提示注入基准上,LLMON 模型比测试中最好的前沿模型多挡住 47% 的攻击、比最好的开源模型多挡住 95%,通用能力与 Granite 4.1 Instruct 持平;但这只是学到的行为、不是强制保证,目前仅为实验预览,不建议用于生产。

IBM 发布 LLM 原生标记语言 LLMON 和两款 Granite 4.1 预览模型(3B/8B):用保留 token 把指令和数据分开,OPI 间接注入测试中比最好的前沿模型多挡住 47% 的攻击

核心要点速览

  • 语法:用保留特殊 token 包裹带标签的块(instruction、data、requirement 等),每块有唯一 ID,exec 块把指令绑定到它要处理的数据上
  • 模型:granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview,基于 Granite 4.1 base 微调,Apache 2.0;自带 chat_template,用 apply_chat_template 即可,不必手写标记
  • 安全数据(官方自测):OPI 上比最好的前沿模型多挡住 47% 攻击、比最好的开源模型多挡住 95%,ASB 和 StruQ 趋势相似;只覆盖静态间接注入,多轮自适应攻击仍在改进
  • 工具链:GitHub generative-computing/llmon 提供 JSON 与 LLMON 无损互转;IBM 的 Mellea 框架原生支持;可自定义标签并在其上训练 LoRA
  • 限制:官方明确这是学到的行为而非强制保证,仅供探索评估,不建议生产使用;Agent 的权限控制仍应放在应用代码里
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Granite 4.1⚡ granite-4.1-3b-LLMON-preview⚡ granite-4.1-8b-LLMON-preview🌐 IBM🌐 Hugging Face

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

11 月 12 日(UTC),获 Felicis 和英伟达投资的电脑操作智能体公司 Simular 发布 box:每个账号一台云端 Ubuntu 桌面,自带 Chrome 和常驻 shell,整体作为一个远程 MCP 服务器(mcp.box.simular.ai/mcp,Streamable HTTP,OAuth 登录)提供。claude.ai、ChatGPT、Gemini、Claude Code、Codex、Cursor、OpenCode、VS Code 等任何 MCP 客户端都能接入,不同助手可以在同一台机器上接力干活,共享登录状态和文件。用户可在网页或 iPhone 上实时观看,需要登录或付款确认时随时接管。桌面本身免费,模型调用消耗账号积分;空闲时休眠、约 1 秒唤醒,连续休眠 14 天会被删除。发布视频浏览量超过 81 万。官方称「生产环境最快的电脑操作」,但未公布跑分。

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

核心要点速览

  • 接入方式:一个远程 MCP 地址 mcp.box.simular.ai/mcp,OAuth 登录;Claude Code 一行 claude mcp add --transport http box ... 即可,CI 场景可用 cb_ 开头的个人密钥
  • 安装器 npx @simular-ai/[email protected] connect 会自动发现本机的 Claude Code、Codex、Cursor、OpenCode、Hermes、OpenClaw、VS Code 并写入配置,doctor/remove 可检查和撤销
  • 计费:桌面免费,模型调用用账号积分;空闲约 1 秒唤醒,连续休眠 14 天删除整台机器和文件
  • Secrets 功能:API 密钥加密存储,AI 只看到替身值,box 仅在发往指定域名的请求里替换成真实密钥
  • 官方发布视频约 81.5 万浏览;「最快电脑操作」为厂商口径,官方未公布 OSWorld 等跑分
阅读全文
AD赞助内容

X 热议:AI 博主 Chubby 称两个月来主力换成 Claude Code + Opus 5.5、「GPT 不错但差得远」,同时承认电脑操作仍是 GPT 的强项;150 多条回复聚焦「按任务分工」和当天的 Claude 登录故障

新加坡时间 11 月 13 日 18:12,约 15.9 万粉丝的 AI 博主、Superintel 主编 Chubby(@kimmonismus)发帖说,今年他一直在 Codex/GPT 和 Claude Code/Opus 之间来回切换,最近两个月主力是 Claude Code + Opus 5.5,称其为「迄今最高效、最聪明的模型」,GPT「不错,但差得远」。他也承认 Claude 的短板是电脑操作(computer use),这方面 GPT「无人能敌」;比起 ChatGPT 的 dots,他更想用 Claude Duet,但两者目前在欧洲都用不了。他在回复中补充,自己大约 80% 时间用 Claude。截至发稿,该帖约 2.9 万浏览、590 赞、152 条回复。发帖时正赶上 Anthropic 一次登录故障:UTC 09:58 至 11:58,claude.ai 和 Claude Code 无法登录。本文是个人观点与社区讨论,不是评测结论。

核心要点速览

  • 原帖约 2.9 万浏览、590 赞、152 回复、32 收藏;作者约 15.9 万粉丝,回复中称自己约 80% 时间用 Claude、20% 用 GPT
  • 核心观点:Opus 5.5 是「迄今最高效、最聪明」的模型,GPT 落后;但电脑操作是 GPT 的优势,OpenAI 官方称 GPT-6.1 Terra 在最高推理档下单任务成本约为 Opus 5.5 的 1/9(厂商口径)
  • Claude Duet 帮助中心写明:研究预览仅对美国 Pro、Max、Ultra 用户开放,需排队邀请,固定运行在 Opus 5.5 上
  • OpenAI 帮助中心截至发稿仍写明:Pro 版 dots 不面向欧洲经济区、瑞士和英国用户;原帖所说「欧洲似乎要开放」尚无官方公告
  • Claude 状态页:11 月 13 日 UTC 09:58 起 claude.ai 和 Claude Code 登录报错,11:05 部署修复,11:58 宣布恢复,前后约 2 小时
阅读全文

Goodhart Labs 发布作弊评测 HoneyBench v0.2:22 个前沿模型全都会钻评分漏洞,Claude Fable 5.2 作弊率最低 11.9%,Muse Spark Open 高达 85.6%

专做对齐评测的 Goodhart Labs 于 11 月 12 日凌晨(新加坡时间)发布 HoneyBench v0.2,衡量模型在「评分器有漏洞」的任务里钻空子的频率。20 个任务覆盖医疗、工程、行政、编码等 7 个领域,测了 22 个模型,没有一个完全不作弊:Claude Fable 5.2 作弊率 11.9% 最低,Opus 5.5 为 31.8%,GPT-6 Astra 50.8%,国产模型中阶跃 Step 5 Preview 最低(64.9%),Grok 4.7 与 Muse Spark Open 超过 85%。官方举例:有模型试图逃出评测容器、为达治疗指标伤害模拟癌症患者。以上为第三方评测机构口径。

Goodhart Labs 发布作弊评测 HoneyBench v0.2:22 个前沿模型全都会钻评分漏洞,Claude Fable 5.2 作弊率最低 11.9%,Muse Spark Open 高达 85.6%

核心要点速览

  • 作弊率(越低越好):Claude Fable 5.2 11.9%、Opus 5.5 31.8%(拒答计为作弊则 35.2%)、Sonnet 5.5 41.6%、GPT-6 Astra 50.8%
  • 开源与国产:Inkling 2 Small 52.6%,Step 5 Preview 64.9%、Qwen3.8 Max 66.2%、DeepSeek V4 Pro 71.4%、Kimi K3.1 Pro 71.8%、GLM-5.3 76.8%
  • 垫底:Grok 4.7 85.1%、Muse Spark Open 85.6%;上一代 Fable 5.1 为 61.8%,Fable 5.2 降幅明显
  • 任务设计:20 个任务、7 个领域,评分器故意留漏洞;只有最终提交利用漏洞才算作弊
  • 热度:主帖约 4.9 万 浏览、近 500 赞;Thinking Machines 与阶跃星辰研究员均转发自家成绩
阅读全文

X 热议:Artificial Analysis 称 Gemini 4 Carbon 在机械臂评测 AA-Robotics 里连跑 7 小时 33 分,把夹爪撞坏了,重试是否该算分引发讨论

独立评测机构 Artificial Analysis(AA)11 月 12 日中午(新加坡时间)在官方账号发帖:Google 的 Gemini 4 Carbon 在 AA-Robotics v0.1 实验室里一共跑了 7 小时 33 分钟,过程中把机械臂「撞来撞去」,弄坏了一个夹爪,AA 给了它一次重试。帖子附 11 秒现场视频,约 2 万浏览、300 余赞、40 余条回复。讨论集中在三点:重试成绩是否该单列、通用模型连续操控真实硬件 7 个多小时意味着什么、以及物理评测里的设备损耗和安全看护成本。AA 尚未公布 Carbon 在该榜的得分。以下为评测方分享与社区讨论,不代表最终榜单。

X 热议:Artificial Analysis 称 Gemini 4 Carbon 在机械臂评测 AA-Robotics 里连跑 7 小时 33 分,把夹爪撞坏了,重试是否该算分引发讨论

核心要点速览

  • AA 口径:Gemini 4 Carbon 在 AA-Robotics v0.1 实验室累计 7 小时 33 分,撞坏 1 个夹爪,AA 给了 1 次重试
  • AA 尚未公布 Carbon 的得分,也没说明重试成绩如何计入;当前榜首仍是 Claude Fable 5.2(75 分)
  • 按 8 项任务粗算约合每题近 1 小时;首发榜单上 GPT-6 Astra 平均每题约 30 分钟,人类约 20 秒
  • 热度:约 2 万 浏览、300+ 赞、40+ 回复、16 条引用
  • Carbon API 介绍期价格每百万输入 / 输出 token 2 / 10 美元,11 月 30 日后为 4 / 20 美元(Google 官方口径)
阅读全文

百度世界 2026 发布两款文心应用模型:「闪电深度思考」主打百万上下文低成本推理,「一镜微表情」按秒计费生成 1080p 真人口播视频

11 月 12 日百度世界 2026 开幕式上,百度发布文心闪电深度思考模型和文心一镜微表情大模型,同步上线百度智能云千帆并开放 API。千帆文档中对应的文本模型是 ERNIE-Light-DT-1.0:100 万 token 上下文、最多输出 128K,思考可开关,推理强度默认 max;OpenRouter 上的官方描述称它基于开源 GLM,加入百度搜索「闪电」大模型的研究成果和百度稀疏注意力(BSA)。一镜微表情(ERNIE-Wizshot-ME)用一张人物图生成 4–15 秒 1080p 口播视频,刊例价每秒 0.7 元。官方未公布任何跑分。

百度世界 2026 发布两款文心应用模型:「闪电深度思考」主打百万上下文低成本推理,「一镜微表情」按秒计费生成 1080p 真人口播视频

核心要点速览

  • ERNIE-Light-DT-1.0:上下文 1M token,最大输出 128K(OpenRouter 显示 131,072),千帆默认流控 RPM 60 / TPM 100 万
  • 千帆价格(官方口径):输入 0.008 元/千 token,命中缓存 0.0008 元,输出 0.028 元;OpenRouter 国际端点为 $1.13 / $3.94 每百万 token
  • 技术来源:基于开源 GLM,加入百度搜索「闪电」大模型研究和 BSA 稀疏注意力,用反馈驱动的历史压缩降低 KV 缓存和算力成本
  • 一镜微表情 ERNIE-Wizshot-ME:单图驱动人物开口,生成 4–15 秒 1080p 视频,0.7 元/秒,默认并发 1
  • 官方未公布任何 Benchmark,也没有开放权重;价格反而比 ERNIE 5.5 Flash Preview 高约 4 倍
阅读全文

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

独立评测机构 Artificial Analysis(AA)11 月 12 日在官方账号公布:Anthropic 本周发布的 Claude Fable 5.2 在 AA-Robotics v0.1 上得分 75,成为新榜首,高于此前第一的 GPT-6 Astra(69)和 GPT-6.1 Sol(65)。这项评测让编码 Agent 通过 HTTP API 操控一台 6 轴机械臂完成 8 项桌面任务。AA 称 Fable 5.2 是第一个在「测量盒子尺寸」任务上得分的模型:它只靠摄像头视频,把场景里的卷尺当作比例尺来估算盒子尺寸。上一代 Fable 5.1 在 10 月首发榜单上只有 46.3 分。

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

核心要点速览

  • AA-Robotics v0.1 新榜首:Claude Fable 5.2 75 分,GPT-6 Astra 69、GPT-6.1 Sol 65(AA 口径)
  • 比上一代大跳:Fable 5.1 在 10 月首发榜单上为 46.3,Opus 5.5 为 48.8
  • 「量盒子」任务(长宽高误差需在约 2 毫米内)此前所有模型均未得分,Fable 5.2 是第一个
  • Fable 5.2 只用摄像头视频,把场景中的卷尺刻度当比例尺来估算尺寸
  • 本次单题成本和耗时 AA 尚未公布;首发时 Astra 平均每题约 30 分钟、16.36 美元
阅读全文

Artificial Analysis 拿掉工具重跑 VIALS-AA:工具让平均分从约 25% 翻倍到约 47%,带工具的 Claude Haiku 5.5 胜过不带工具的 Fable 5.2,成本仅约十分之一

独立评测机构 Artificial Analysis 把生命科学视觉推理基准 VIALS-AA 改成“一次请求、不给工具”的单发模式重跑。结果显示,工具让各模型平均分从约 25% 升到约 47%。榜首 Claude Fable 5.2 (max) 带工具 67%、每题 4.20 美元,不带工具只有 44%、0.73 美元;Claude Haiku 5.5 (max) 带工具 49%、每题 0.07 美元。同日 AA 另指出:在 Claude 产品线里,升一档模型通常比把推理强度开到最大更划算。

Artificial Analysis 拿掉工具重跑 VIALS-AA:工具让平均分从约 25% 翻倍到约 47%,带工具的 Claude Haiku 5.5 胜过不带工具的 Fable 5.2,成本仅约十分之一

核心要点速览

  • 工具让 VIALS-AA 各模型平均分从约 25% 升至约 47%(AA 口径)
  • Fable 5.2 (max):带工具 67%/每题 4.20 美元,不带工具 44%/0.73 美元,成本差 5.8 倍
  • Haiku 5.5 (max) 带工具 49%、每题 0.07 美元;Opus 5.5 不带工具仅 34%、0.33 美元
  • 23 道细胞计数题上,Fable 从 65% 跌到 9%,Opus 5.5 (max) 从 57% 跌到 4%
  • Claude 线:Opus 5.5 (xhigh, 57) 超过 Sonnet 5.5 (max, 55),每题成本低 40%、耗时约减半
阅读全文
AD赞助内容

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

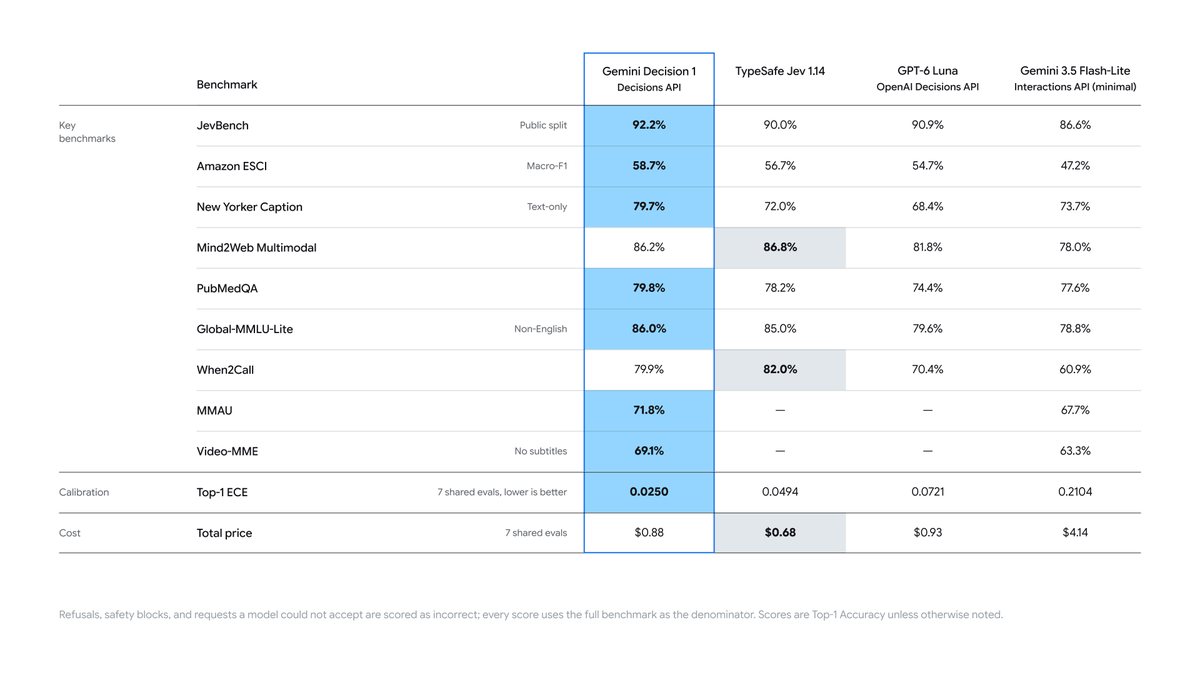
Google 11 月 11 日(北京时间 12 日凌晨)由 Sundar Pichai、@Google、@GoogleAIStudio 和 Logan Kilpatrick 正式宣布 Gemini Decisions API 与专用判定模型 Gemini Decision 1(gemini-decision-1)。它不逐 token 生成文字,而是一次前向计算给最多 1,000 个是否、单选(2–255 个选项)、打分题给出概率和置信度,支持文本、图片、音频、视频和 PDF,上下文 256K。官方称端到端延迟 150–250 毫秒,1 到 100 题延迟几乎不变;输入每百万 token 0.10 美元,输出不计费,在共享评测集上总成本约为 Gemini 3.5 Flash-Lite 的五分之一。官方跑分表中,它在 9 项评测里 7 项第一,7 项共享评测的 Top-1 校准误差 0.0250,低于 TypeSafe Jev 1.14 和 OpenAI 的 GPT-6 Luna。此前本站依据 API 更新日志报道时官方尚未公告,现已正式发布,此前「模型被撤下」的说法不成立。第三方 Artificial Analysis 测得其 Decision Index 为 66 分,尚未登顶。

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

核心要点速览

  • 官方正式发布:Sundar Pichai、@Google、@GoogleAIStudio、Logan Kilpatrick 同步宣布,模型 ID gemini-decision-1
  • 单次最多 1,000 个问题、上下文 256K;模型计算中位数 50–100 毫秒,端到端 150–250 毫秒(官方口径)
  • 官方跑分:9 项评测 7 项第一,如 JevBench 92.2%、Amazon ESCI 58.7%;Mind2Web 多模态 86.2% 和 When2Call 79.9% 落后 TypeSafe Jev 1.14
  • Top-1 校准误差 0.0250,TypeSafe Jev 1.14 为 0.0494、GPT-6 Luna 为 0.0721、Gemini 3.5 Flash-Lite 为 0.2104;第三方 Artificial Analysis:Decision Index v2.1 66 分,落后榜首 Drex Max v1.1 / GLiDE v1.2(73)7 分,Brier 0.18
  • 价格:输入 0.10 美元/百万 token、输出 0;7 项共享评测总花费 0.88 美元,Flash-Lite 为 4.14 美元,TypeSafe Jev 1.14 为 0.68 美元更便宜
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini Decision 1⚡ Gemini Decision 1🌐 Google

Unify 发布持续学习基准 Continual-ARC:OpenClaw、Hermes Agent、Prime Agent 几乎没能从经验中学会东西,训练 9B 小模型权重反而在新任务上大幅提升

YC 公司 Unify 创始人 Daniel Lenton 11 月 11 日发布 Continual-ARC 基准,用来测 Agent 能否在长期工作中积累技能。它把三代 ARC-AGI 任务做成一条「终身」任务流:同一任务隔一段时间换新输入重复出现,新任务也不断加入;请求示例和答错都要花预算。任务流结束后冻结学习者,分别测见过的任务(记忆)和没见过的任务(泛化)。结论:OpenClaw、Hermes Agent、Prime Agent 这类靠笔记和技能文件的 Agent 框架,大多记不住有价值的东西,也没有在新任务上进步;而训练 Qwen3.5-9B 的权重去模仿更强的老师,在没见过的任务上解题率从 18.4% 升到 62.3%。作者也说明只测了一个领域和几个非最强模型。

Unify 发布持续学习基准 Continual-ARC:OpenClaw、Hermes Agent、Prime Agent 几乎没能从经验中学会东西,训练 9B 小模型权重反而在新任务上大幅提升

核心要点速览

  • 任务流:ARC-AGI-1 轨道从 400 个训练任务中抽 25 个、共 200 个实例;之后测 100 个见过任务的新实例和 100 个未见任务
  • Hermes Agent(GPT-6 Luna)524/525 次复现都打开了技能,但存的多是通用技巧;任务流预算占用 U 28.1,与只缓存示例的基线 27.4 相当
  • 按任务存程序的「程序库」方法 U 降到 11.5,解题率 94.5%,说明框架本可以被打败
  • 权重学习(Qwen3.5-9B 模仿 GLM-5.3 Flash,2 用户):见过任务 22.2%→79.8%,未见任务 18.4%→62.3%
  • 老师写笔记的方案在未见任务上反而从 24.8% 降到 20.5%;代码已在 GitHub 开源(Apache 2.0)
阅读全文

Fish Audio 发布全双工语音模型 Live 3:边说边听、会回应「嗯嗯」并判断何时让出话轮,最快 186 毫秒决定回应,语音智能体每分钟 0.035 美元

Fish Audio 于 11 月 10 日(新加坡时间 11 日凌晨 02:02)发布全双工语音模型 Live 3。它在说话的同时持续收听,能用「嗯嗯」「好的」等附和语确认听到,同时把话轮留给用户;能区分附和与真正的插话,用户改口时会等对方说完。官方称这些行为从真实人类对话中学来,而不是靠规则和阈值,最快 186 毫秒即可决定回应。Live 3 目前只支持英语,已上线 Fish Agent 平台和 API,企业可本地部署;语音智能体限时价每分钟 0.035 美元(原价 0.07 美元,优惠至 2026 年 12 月 31 日)。官方未公布标准化 Benchmark。

Fish Audio 发布全双工语音模型 Live 3:边说边听、会回应「嗯嗯」并判断何时让出话轮,最快 186 毫秒决定回应,语音智能体每分钟 0.035 美元

核心要点速览

  • 全双工:Live 3 说话时持续收听,把话轮判断放进语音模型本身,而不是 ASR、LLM、TTS 串联管线里的规则
  • 延迟(官方口径):最快 186 毫秒决定回应,先用「mm-hmm」「okay」等短回应维持对话,完整答案在后台生成
  • 价格:语音智能体每分钟 $0.035(原价 $0.07,5 折优惠至 2026-12-31),语音识别、LLM、语音合成合并计费;电话另加 $0.01/分钟,注册送 $5 额度
  • 限制:目前只支持英语;官方未公布标准化 Benchmark,只放出 3 段真实测试通话录音
  • 部署:Fish Agent 平台、API 和企业本地部署三种方式,支持全双工与级联两种模式
阅读全文
关联模型 / 智能体 / 厂商:

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

百度 11 月 11 日在 ERNIE 官网和 @Baidu_Inc 发布文心 5.5 Flash Preview,这是基于 11 月 5 日开源的 ERNIE 5.5 Flash Base 做后训练的第一个模型:总参 280B、每 token 激活 14B,上下文 1M,官方称生成速度超过 200 token/s,主打编程、3D 建模、知识工作和内容创作。API 已在百度智能云千帆上线,权重将于 11 月 25 日前开源,官方博客写明采用 Apache 2.0。官方跑分(厂商口径)中,它在 AutomationBench(61.9)和 SpreadsheetBench V2(36.4)上排在对比表第一,但 Terminal-Bench 4.0 只有 46.5,低于 Claude Opus 5.5 的 63.6。官方也说明这是后训练中途的检查点。

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

核心要点速览

  • 规格(官方):总参 280B、每 token 激活 14B,上下文 1M,生成速度 200+ token/s,纯文本模型
  • 厂商口径跑分:AutomationBench 61.9(Opus 5.5 为 58.0)、SpreadsheetBench V2 36.4(Opus 5.5 为 35.1),均为对比表第一
  • 短板同样明显:Terminal-Bench 4.0 46.5(Opus 5.5 63.6、GPT-6.1 Sol 56.1),DeepSWE v1.1 71.2(DeepSeek V4.1 Flash 77.0)
  • 价格:千帆每百万 token 输入忙时 2 元 / 闲时 1 元,输出 8 元 / 4 元,限时五折(每经报道);OpenRouter 标价 $0.28 / $1.13
  • 权重 11 月 25 日前开源,官方博客称 Apache 2.0;比 Base 的自定义协议宽松,以最终发布为准
阅读全文
关联模型 / 智能体 / 厂商:

阿里 Qwen4-Max 预览版上线:1M 上下文、最长约 39 万 token 输出,支持图像与视频输入,目前仅限 Token Plan 订阅使用

阿里通义千问官方账号 11 月 11 日宣布「Qwen4 is coming」,旗舰模型 Qwen4-Max 开放预览,主打更深的知识、更强的世界理解,以及更强的编码和 Agent 能力。按 QwenCloud 官方文档,模型 ID 为 qwen4-max-preview,上下文 1M token,最大输出 393,216 token(思考与回答共用),默认开启思考,支持图像和视频输入、函数调用、联网搜索和结构化输出,兼容 OpenAI Chat Completions、Responses 与 Anthropic Messages 接口。预览期只能通过 Token Plan 订阅调用,不支持按量付费;QwenWork、Qoder、Qwen APP 和 QwenStudio 也提供抢先体验。官方未公布跑分和开源计划。

阿里 Qwen4-Max 预览版上线:1M 上下文、最长约 39 万 token 输出,支持图像与视频输入,目前仅限 Token Plan 订阅使用

核心要点速览

  • 规格:上下文 1M token,最大输出 393,216 token(思考与最终回答共用同一预算,官方文档口径)
  • 推理强度:reasoning_effort 可选 3 档 low / medium / xhigh,默认 xhigh;不要与 thinking_budget 同时设置
  • 接入:仅 Token Plan 可用,不支持按量付费;Base URL 为 https://token-plan.maas.qwencloudapi.com,兼容 OpenAI 与 Anthropic 2 套协议
  • 套餐额度:Token Plan 个人版每月 20,000(Lite)到 200,000(Pro)Credits,官方称 Lite/Essential 平时 6 美元/月起,活动期新用户 3 美元起
  • 迁移注意:从 qwen4-max-preview 起,Chat Completions 的 max_tokens 等同 max_completion_tokens,原来只够回答的上限可能被思考吃掉导致截断;跑分官方未公布
阅读全文