AI 编程实时动态与要闻

Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

Perplexity 11 月 12 日发布 pplx-decider-v1.3(基于 Qwen3.8-27B,约 26.1B 参数)和蒸馏版 pplx-decider-flash-v1.3(基于 Qwen3.5-4B,约 4.5B),权重以 Apache 2.0 上架 Hugging Face,并通过 Decisions API 和 OpenRouter 提供。新版加入 Locate,可按标签或指令抽取原文片段并返回字符位置。官方称 v1.3 在 63 项分类任务上平均准确率 91.6%,比其生产分类器高 6.54 个百分点。
Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

核心要点速览

  • 两档开源权重:v1.3 约 26.1B 参数(Qwen3.8-27B 微调),Flash v1.3 约 4.5B(Qwen3.5-4B 蒸馏),均为 Apache 2.0;BF16 本地运行约需 49 GiB 显存
  • 新增 Locate:按标签或指令抽取原文片段,返回起止字符位置和分数,覆盖 NER、PII 检测、抽取式问答,可与分类、打分问题放在同一请求
  • 官方/厂商口径分类成绩:63 项分类任务平均准确率 91.6%,比 Perplexity 生产分类器高 6.54 个百分点;7 个领域全部领先 Jev 1.14,金融领域最多高 12.9 个百分点
  • 检索与稳定性:72 项检索任务 nDCG@10 为 83.99,比 Qwen3-Reranker-8B 高 1.81;输入改写后答案只变 0.27%,Jev 1.14 为 2.69%–4.84%
  • 上手渠道:Hugging Face 下载、Perplexity Decisions API、OpenRouter(两款 v1.3 模型 11 月 19 日前免费)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-decider-v1.3⚡ pplx-decider-flash-v1.3⚡ Qwen3.8-27B⚡ Qwen3.5-4B⚡ Jev 1.14⚡ Qwen3-Reranker-8B🌐 Perplexity🌐 Hugging Face🌐 OpenRouter
Anthropic 发布 Claude 选型指南:多数编码任务先用 Opus 5.5(medium),换模型前先调 effort,子 Agent 交给 Haiku 5.5 省钱

Anthropic 开发者博客 claude.dev 11 月 9 日发布 Addy Osmani 撰写的选型指南《Which Claude model should you build with?》,ClaudeDevs 推文获约 9200 赞、1.2 万收藏。核心建议:大多数编码和知识工作先用 Opus 5.5、effort 设 medium(Claude Code 默认);范围明确的修 bug、按规格开发降到 Sonnet 5.5;分类、路由、抽取和读日志类子 Agent 用 Haiku 5.5;大型重构、迁移和深度研究再升到 Fable 5.2。换模型之前先调 effort,并先给模型加上自我验证手段。指南还列出四款模型价格、默认 effort 和迁移时会触发 400 错误的兼容性差异。

Anthropic 发布 Claude 选型指南:多数编码任务先用 Opus 5.5(medium),换模型前先调 effort,子 Agent 交给 Haiku 5.5 省钱

核心要点速览

  • 价格(官方口径,每百万 token 输入/输出):Haiku 5.5 $0.10/$0.50(100K 以上 $0.50/$2.50)、Sonnet 5.5 $2/$10、Opus 5.5 $4/$20、Fable 5.2 $8/$40,四款均为 1M 上下文、128K 最大输出
  • Anthropic 自测 FrontierCode 2.0:Fable 5.2(high)45.3% 与 Opus 5.5(max)45.5% 基本持平,单任务成本约为一半;Opus 拉到 high 以上前建议先试 Fable 5.2
  • SWE-bench Pro 子集:Opus 5.5 先用 low 跑、失败再用 high 重跑,通过率约 97%、每题约 $0.17,全部用 high 为 95.3%、$0.29
  • Opus 5.5 统领最多 25 个并行 Sonnet 5.5 子 Agent 搜索约 2200 万 token 代码,成本比 Opus 单跑低约三分之一,得分相近
  • 迁移坑:Fable 5.2 对所有 API 账号启用 preserved thinking,改动历史上下文会报 400;Sonnet/Opus 5.5 与 Fable 5.2 上 tool_choice 为 any/tool 也会报 400
阅读全文

Axiom 用 AI Agent 集群 24 天完成「有限单群分类定理」Lean 全形式化:约 4310 万行代码,史上最长数学证明首次被计算机完整验证

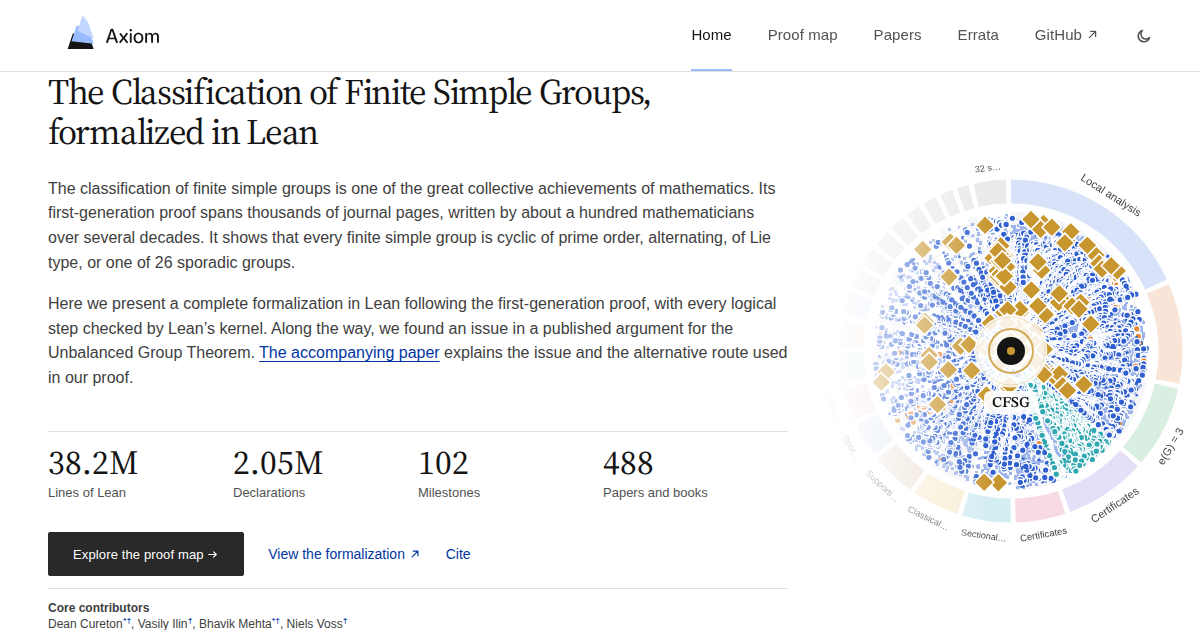
AI 数学公司 Axiom 10 月 27 日宣布,用数十个 AI Agent 组成的集群,在 24 天内把有限单群分类定理(CFSG,原证明约 1.5 万页、500 多篇论文、约 100 位数学家)完整形式化到 Lean 证明助手,产出约 4310 万行 Lean 代码、205 万条声明,并在 GitHub 开放仓库。过程中发现文献里 34 处值得注意的偏差,AxiomProver 还为「不平衡群定理」给出新的替代论证。

Axiom 用 AI Agent 集群 24 天完成「有限单群分类定理」Lean 全形式化:约 4310 万行代码,史上最长数学证明首次被计算机完整验证

核心要点速览

  • 官方口径:24 天、数十个 AI Agent 集群,产出约 4310 万行 Lean 代码、205 万条声明、100 个里程碑,引用 715 篇论文和专著
  • CFSG 原证明约 1.5 万页、500 多篇论文、约 100 位数学家,被称为「巨大定理」;这是它首次被计算机完整检查
  • 形式化暴露出文献中 34 处值得注意的偏差,最重要的是 Walter 1986 年不平衡群定理论证中的闭包断言存在反例(如 PSL₂(49))
  • AxiomProver 基于 Solomon 1976 年的理论给出替代论证,并证明新定理「Preservation of simple tops」,论文发布在 Hexagon(2610.00575)
  • 人类仍不可少:Richard Lyons、Ronald Solomon 等原 CFSG 学者参与审阅;勘误表将与群论专家顾问组持续公开
阅读全文
关联模型 / 智能体 / 厂商:
⚡ AxiomProver🌐 Axiom

Baseten 开源两款决策模型 mammoth-1(27B)与 elephant-1(9B):不生成文本直接输出选项概率,Jev 决策榜第一

10 月 21 日,Baseten 旗下研究团队 Base Labs 发布开源决策模型 mammoth-1(27B)与 elephant-1(9B),基于 Qwen3.5 全量微调,不生成文本,一次前向传播即返回每个选项的概率,适合分流、分类、打分和路由。官方口径下 mammoth-1 以 71.24 分登顶 Jev Decision Index 0.4,elephant-1 在 Artificial Analysis Decision Index 上并列第一。权重已上 Hugging Face,Baseten API 免费开放至 10 月 27 日。

Baseten 开源两款决策模型 mammoth-1(27B)与 elephant-1(9B):不生成文本直接输出选项概率,Jev 决策榜第一

核心要点速览

  • 跑分(官方口径):mammoth-1 在 Jev Decision Index 0.4 得 71.24 分,208 个决策模型中排名第一;AA Decision Index 65.9
  • elephant-1(9B):Jev 62.6 分、9B 级第一;AA Decision Index 65.2,与 d1-ultra 并列第一
  • 训练:基于 Qwen3.5-27B / 9B 全量微调,621 万条决策样本,含弃答与安全数据
  • 机制:块状双向注意力 + 共享前缀缓存,一次前向返回多问题概率;官方称比推理模型最高快约 10 倍
  • 上手:Hugging Face 权重(MIT),Baseten API 免费至 10/27 23:59 PT,默认零数据保留
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mammoth 1⚡ Elephant 1⚡ Qwen3.5-27B⚡ Qwen3.5-9B🌐 Baseten🌐 Base Labs
AD赞助内容

微软发布 Microsoft-Decision-1 决策模型:基于 Qwen3.5-9B 后训练,输入 $0.042/百万 Token、输出免费,已上 Foundry 与 OpenRouter

微软 10 月 9 日发布首个自研决策模型 Microsoft-Decision-1:不生成文本,而是对给定选项输出校准概率,面向路由、分类、校验、Agent 护栏与 AI 评审。官方称其在 36 项盲测基准上准确率最高、P50 延迟约为 GPT-6 Sol 的 1/35,扰动下决策翻转率 1.3%;已在 Microsoft Foundry、OpenRouter 可用,32K 上下文。

微软发布 Microsoft-Decision-1 决策模型:基于 Qwen3.5-9B 后训练,输入 $0.042/百万 Token、输出免费,已上 Foundry 与 OpenRouter

核心要点速览

  • 价格:输入 $0.042/百万 Token、输出 $0,32,768 Token 上下文(OpenRouter 模型页)
  • 官方口径:36 项训练盲测基准、近 15 万题准确率第一;比第二名 H2O-Lightning-4B v1.1 快 2.5 倍,比 GPT-6 Sol 快 35 倍(微软博客)
  • 鲁棒性:同一请求做 8 类扰动,平均决策翻转率 1.3%,选项改写/倒序/打乱时为 0 次翻转
  • 底座:由 Qwen3.5-9B 后训练为单次前向打分,微软称后续将换到 MAI 与 OpenAI 底座
  • 内部实测:Xbox Research 标注 1 万+ 条反馈,质量接近 GPT-6 Sol,速度快 14 倍以上、成本低约 200 倍(厂商口径)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Microsoft-Decision-1⚡ Qwen3.5-9B⚡ GPT-6 Sol🌐 Microsoft🌐 OpenRouter

Anthropic 正式发布 Claude Haiku 5.5:输入 $0.10/M、OSWorld 72.4%,平均比 Haiku 4.5 便宜约 75%

Anthropic 10 月 7 日上线 Claude 5.5 家族最后一块拼图 Haiku 5.5(模型 ID claude-haiku-5-5),定位高频、低成本的摘要、上下文压缩、分类与编码子 Agent,官方称是其最快模型。≤100K 提示每百万 token 输入 $0.10、输出 $0.50;首个支持 effort 档位的 Haiku。OSWorld 2.1 离线子集 72.4%(Haiku 4.5 为 15.7%),Terminal-Bench 4.0 39.2%。同日 Sonnet 5.5 缓存读降价 50%,Max/Team 订阅每月附送 API 额度。

Anthropic 正式发布 Claude Haiku 5.5:输入 $0.10/M、OSWorld 72.4%,平均比 Haiku 4.5 便宜约 75%

核心要点速览

  • 价格:≤100K 提示输入 $0.10 / 输出 $0.50 / 缓存读 $0.01(每百万 token),>100K 为 $0.50 / $2.50;Haiku 4.5 为 $1 / $5,官方折算平均便宜约 75%(官方发布页)
  • OSWorld 2.1 离线子集 72.4%,对比 Haiku 4.5 15.7%、GPT-6 Luna 48.9%、Sonnet 5.5 83.9%
  • Terminal-Bench 4.0 39.2%(Haiku 4.5 0.0%、GPT-6 Luna 16.4%);FrontierCode 1.1 Main 46.4%(Sonnet 5.5 xhigh 52.1%)
  • 首个支持 low / medium / high / xhigh / max effort 的 Haiku;Claude Code v2.1.293 已将其设为 API 默认 Haiku,1M 上下文(Release notes)
  • 同日:Sonnet 5.5 缓存读从 $0.20 降至 $0.10/M(多数 Agent 任务约省 20%);Max 5x / 20x 每月 $100 / $200 API 额度,Team 每席 $20(Standard)/ $100(Premium)合池、上限 $500;不含交互式 Claude Code,不结转(条款)
阅读全文

Ollama 0.35.0:原生 Decision Models,经 /v1/systemone 接 Jev;Nimble/Tev1 上线,返回选择概率与置信度

Ollama 于 2026-09-28 发布 v0.35.0(GitHub 标记 prerelease):新增基于 TypeSafe Jev 的 Decision Models,HTTP 入口为 /v1/systemone。模型不再吐自由文本,而是对 choice/noul/score 三类问题返回选项、概率与置信度,覆盖工单分流、模型路由与内容分类。首批模型为 Bespoke Labs 的 Nimble 与 Together AI 的 Tev1;相对 v0.34.4 约 7 commits / 66 files,并修复 Settings 阻塞、macOS 更新菜单与 MLX 下载挂起。

Ollama 0.35.0:原生 Decision Models,经 /v1/systemone 接 Jev;Nimble/Tev1 上线,返回选择概率与置信度

核心要点速览

  • 发版:v0.35.0(2026-09-28,prerelease);对比 v0.34.4...v0.35.0 ≈7 commits / 66 files
  • 新 API:POST /v1/systemone,基于 TypeSafe Jev;问题类型 choice(带概率)、noul(条件为真概率)、score(有序准则打分)
  • 首批决策模型:Nimble、Tev1;ollama pull nimble 后即可本地调用
  • 示例响应含 probabilities 与 confidence(如 bug≈0.978 / confidence≈0.89),usage.input_tokens/output_tokens 可观测
  • 体验修复:Settings 不再等模型发现;macOS 更新菜单/图标;MLX 下载挂起;废弃参数 typical_p 改为告警而非失败
阅读全文

OpenRouter 上线 Jev Labs 示例:用决策模型做分流、工具选择与工单标签,附完整代码

OpenRouter 发文解释 TypeSafe Jev 作为决策模型:面向是/否与多选题并返回置信度,称相对 LLM 可做到约 10 倍更便宜更快。团队在 OpenRouter Labs 开放含源码的迷你应用示例,覆盖客服工单标签、Agent 工具选择、X 回复分类与会议笔记实时动作等场景,并给出模型页链接。

核心要点速览

  • 决策模型定位:并行回答是/否与多选题并带置信度,适合每条消息/每次工具调用。
  • Labs 提供可运行迷你应用与源码:openrouter.ai/labs/jev。
  • 模型页:openrouter.ai/~typesafe/jev-latest。
阅读全文
关联模型 / 智能体 / 厂商: