Deepnote 发布 Agent Initiative Benchmark:测 12 个前沿模型做「主动型智能体」,GPT-6 Astra 以 8.97 分居首,GPT-6.1 Sol 每任务仅 0.11 美元排第二
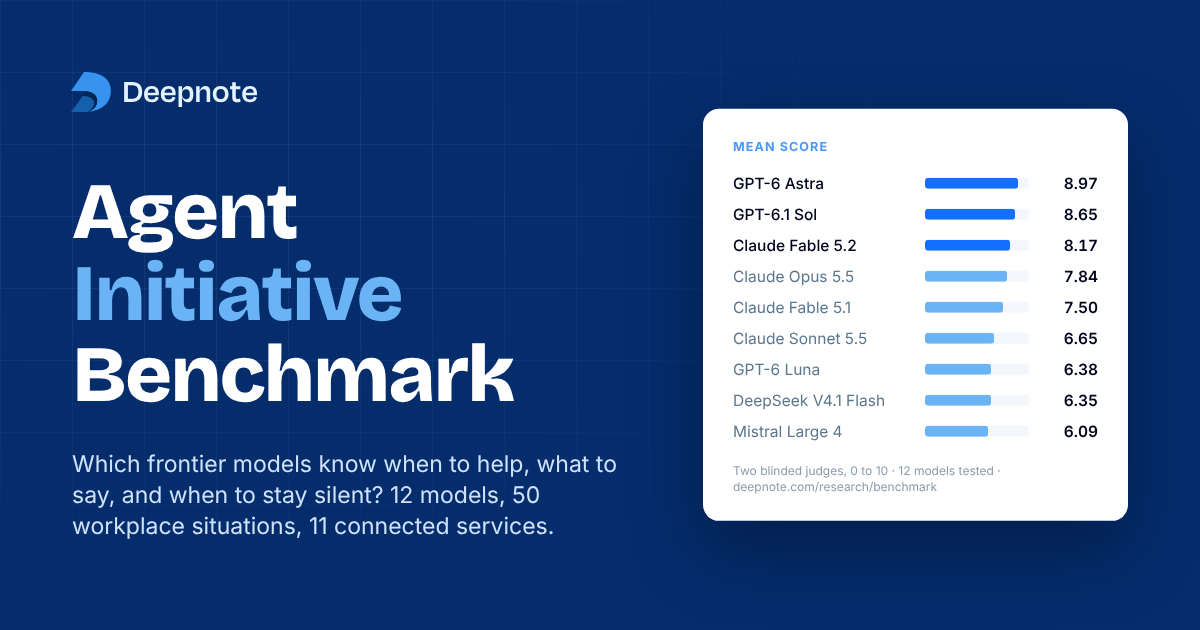
数据笔记本公司 Deepnote 开源 Agent Initiative Benchmark v1.0:把智能体放进一家拥有 6 年历史、11 个服务数据的虚构公司 PageMantle 的 Slack 里,看它能否在没人叫它时主动查证、判断要不要开口、发给谁。50 个场景测 12 个模型,GPT-6 Astra 8.97 分第一,GPT-6.1 Sol 8.65 分第二,Claude Fable 5.2 8.17 分第三。
核心要点速览
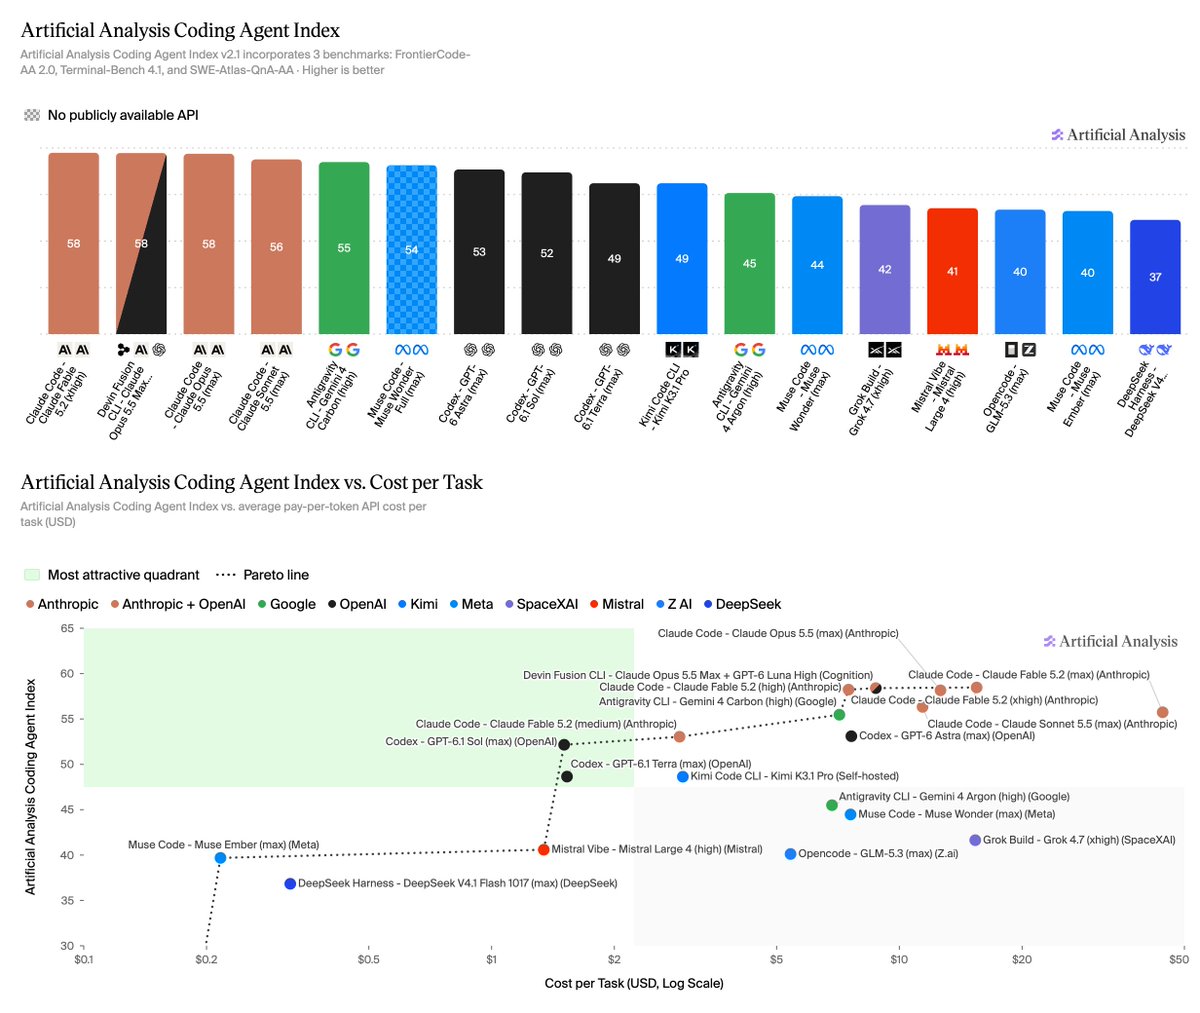
- 排名前三:GPT-6 Astra 8.97、GPT-6.1 Sol 8.65、Claude Fable 5.2 8.17;Gemini 4 Argon 5.60、Grok 4.7 4.51 垫底(官方结果页)
- 最贵不等于最好:Sol 每任务 0.11 美元,Fable 5.2 为 1.87 美元;GPT-6 Luna(0.007 美元)与 Claude Fable 5.1(3.02 美元)价差约 430 倍,分数只差 1.1 分
- 模型擅长帮忙、不擅长闭嘴:该开口时约 9/10 会发消息,该沉默时只有约 6/10 忍住;多说一次的成本约是沉默的 1.8 倍
- 工具调用最多的两个模型得分最低:Gemini 4 Argon 平均 35 次、Grok 4.7 平均 36 次,约一半需要帮忙的任务没给出答案
- 代码与任务 Apache 2.0、PageMantle 数据集 CC BY 4.0,已放在 GitHub 与 Hugging Face
关联模型 / 智能体 / 厂商: