AI 编程实时动态与要闻

ClickHouse 开源 Loom:给编码智能体的共享记忆 + 实时代码索引,代码问答得分 0.78→0.84

ClickHouse 发布开源(Apache-2.0)的智能体记忆系统 Loom,把记忆、代码索引和运行日志放进同一个 ClickHouse 库,记忆与代码关联,代码变动时标记可能过时的记忆。支持 MCP、HTTP API、Python/TS SDK,提供 Claude Code 和 Codex 插件。官方测试中代码问答平均分从 0.78 升到 0.84。
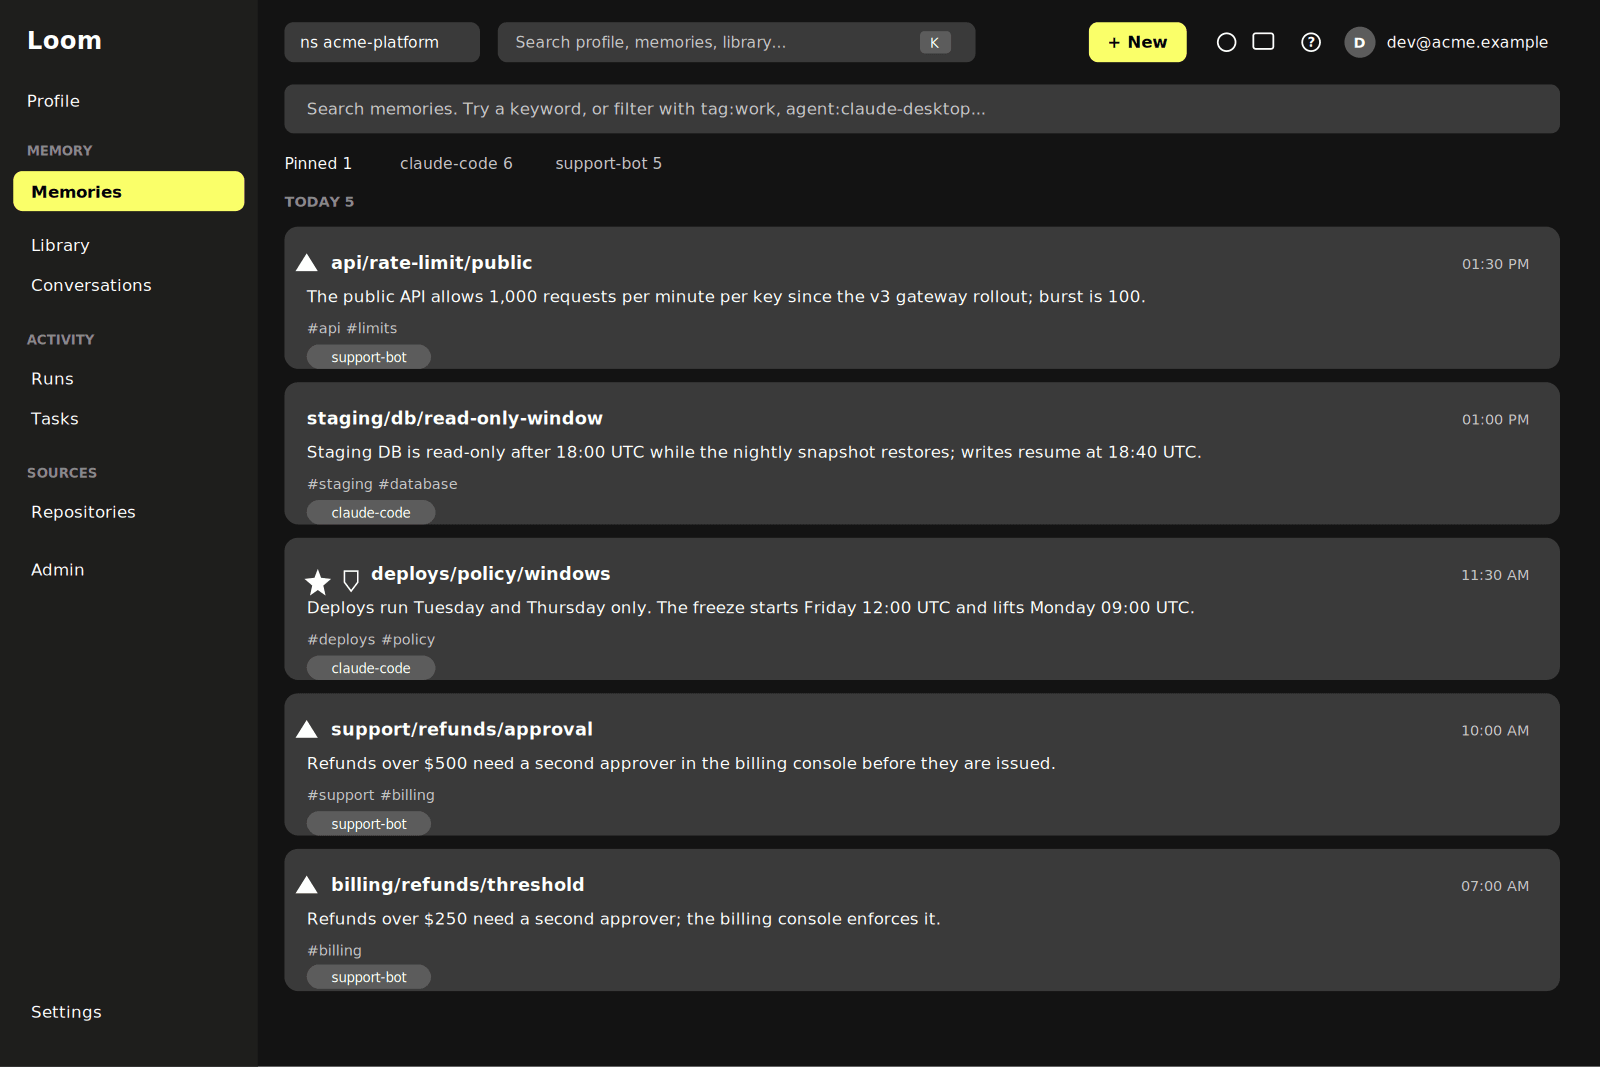
ClickHouse 开源 Loom:给编码智能体的共享记忆 + 实时代码索引,代码问答得分 0.78→0.84

核心要点速览

  • 代码问答(24 题×3 次)平均分 0.78→0.84,单题平均成本 $0.212→$0.17(官方口径,博客)
  • 找文件任务(36 题×10 次)准确率 91.4%→96.4%
  • LongMemEval-S 100 题:检索记忆 94% 对比塞入完整历史 90%,读取 token 少约 90%;完整 500 题 memory.ask 96.6%(官方口径)
  • 记忆与代码索引同库:函数改名会跟随,被重写则标记待复核,不自动改写
  • Apache-2.0 开源,需 ClickHouse 26.5+(推荐 26.8+),一行脚本用 Docker 启动
阅读全文

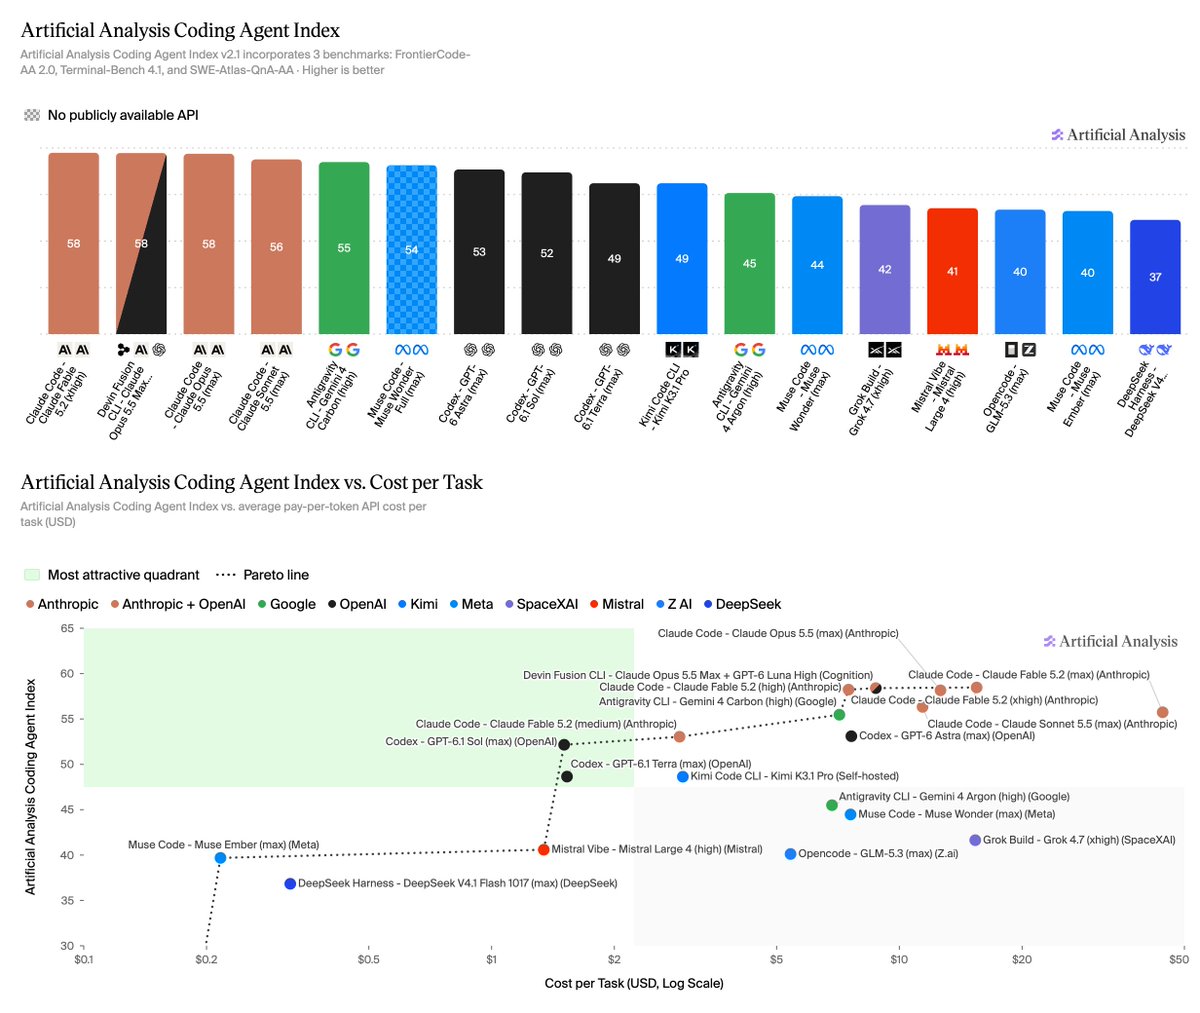
Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

Artificial Analysis 11 月 14 日发布编码智能体指数 v2.1:把 FrontierCode 从 1.1 换成 Cognition 的 FrontierCode 2.0(132 个真实任务,按维护者是否愿意合并评分),Terminal-Bench 从 4.0 升到 4.1,保留 SWE-Atlas-QnA-AA。Claude Code + Claude Fable 5.2(xhigh/high)和 Claude Opus 5.5(max)并列 58 分居首;因新版 FrontierCode 更难,各配置平均降 5 分,只有 Codex + GPT-6.1 Terra(max)基本没掉分。

Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

核心要点速览

  • v2.1 构成:FrontierCode-AA 2.0(132 个真实编码任务,按仓库维护者是否会合并评分)、Terminal-Bench 4.1(同样 66 题,更新验证器以提高可靠性、防奖励投机)、SWE-Atlas-QnA-AA
  • 并列第一 58 分:Claude Code + Claude Fable 5.2(xhigh 与 high 均为 58)、Claude Code + Claude Opus 5.5(max),以及 Devin Fusion CLI(Opus 5.5 max + GPT-6 Luna High);其后为 Claude Sonnet 5.5(max)56、Antigravity CLI + Gemini 4 Carbon(high)55
  • 23 个两版都测过的配置在 FrontierCode-AA 2.0 上全部低于 v1.1,均值从 45% 降到 29%;Claude Code + Fable 5.2 以 49% 领先。Terminal-Bench 4.1 各配置变化都不到 3 分,Kimi Code CLI + Kimi K3.1 Pro 以 68% 居首
  • 成本差约 30 倍:48 分以上配置中,Codex + GPT-6.1 Sol(max,52 分)每题 1.51 美元,Claude Code + Fable 5.2(max,56 分)每题 44.22 美元;Fable 5.2 在 medium/high/xhigh 分别为 2.89/7.51/15.47 美元
  • Claude Code 与 Devin Fusion CLI 遇到安全拒答会切换到备用模型:Devin Fusion CLI 与 Opus 5.5(max)约 9% 的尝试由备用模型完成,Fable 5.2(xhigh)6%,Sonnet 5.5 5%
阅读全文

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

11 月 12 日(UTC),获 Felicis 和英伟达投资的电脑操作智能体公司 Simular 发布 box:每个账号一台云端 Ubuntu 桌面,自带 Chrome 和常驻 shell,整体作为一个远程 MCP 服务器(mcp.box.simular.ai/mcp,Streamable HTTP,OAuth 登录)提供。claude.ai、ChatGPT、Gemini、Claude Code、Codex、Cursor、OpenCode、VS Code 等任何 MCP 客户端都能接入,不同助手可以在同一台机器上接力干活,共享登录状态和文件。用户可在网页或 iPhone 上实时观看,需要登录或付款确认时随时接管。桌面本身免费,模型调用消耗账号积分;空闲时休眠、约 1 秒唤醒,连续休眠 14 天会被删除。发布视频浏览量超过 81 万。官方称「生产环境最快的电脑操作」,但未公布跑分。

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

核心要点速览

  • 接入方式:一个远程 MCP 地址 mcp.box.simular.ai/mcp,OAuth 登录;Claude Code 一行 claude mcp add --transport http box ... 即可,CI 场景可用 cb_ 开头的个人密钥
  • 安装器 npx @simular-ai/[email protected] connect 会自动发现本机的 Claude Code、Codex、Cursor、OpenCode、Hermes、OpenClaw、VS Code 并写入配置,doctor/remove 可检查和撤销
  • 计费:桌面免费,模型调用用账号积分;空闲约 1 秒唤醒,连续休眠 14 天删除整台机器和文件
  • Secrets 功能:API 密钥加密存储,AI 只看到替身值,box 仅在发往指定域名的请求里替换成真实密钥
  • 官方发布视频约 81.5 万浏览;「最快电脑操作」为厂商口径,官方未公布 OSWorld 等跑分
阅读全文

X 热议:AI 博主 Chubby 称两个月来主力换成 Claude Code + Opus 5.5、「GPT 不错但差得远」,同时承认电脑操作仍是 GPT 的强项;150 多条回复聚焦「按任务分工」和当天的 Claude 登录故障

新加坡时间 11 月 13 日 18:12,约 15.9 万粉丝的 AI 博主、Superintel 主编 Chubby(@kimmonismus)发帖说,今年他一直在 Codex/GPT 和 Claude Code/Opus 之间来回切换,最近两个月主力是 Claude Code + Opus 5.5,称其为「迄今最高效、最聪明的模型」,GPT「不错,但差得远」。他也承认 Claude 的短板是电脑操作(computer use),这方面 GPT「无人能敌」;比起 ChatGPT 的 dots,他更想用 Claude Duet,但两者目前在欧洲都用不了。他在回复中补充,自己大约 80% 时间用 Claude。截至发稿,该帖约 2.9 万浏览、590 赞、152 条回复。发帖时正赶上 Anthropic 一次登录故障:UTC 09:58 至 11:58,claude.ai 和 Claude Code 无法登录。本文是个人观点与社区讨论,不是评测结论。

核心要点速览

  • 原帖约 2.9 万浏览、590 赞、152 回复、32 收藏;作者约 15.9 万粉丝,回复中称自己约 80% 时间用 Claude、20% 用 GPT
  • 核心观点:Opus 5.5 是「迄今最高效、最聪明」的模型,GPT 落后;但电脑操作是 GPT 的优势,OpenAI 官方称 GPT-6.1 Terra 在最高推理档下单任务成本约为 Opus 5.5 的 1/9(厂商口径)
  • Claude Duet 帮助中心写明:研究预览仅对美国 Pro、Max、Ultra 用户开放,需排队邀请,固定运行在 Opus 5.5 上
  • OpenAI 帮助中心截至发稿仍写明:Pro 版 dots 不面向欧洲经济区、瑞士和英国用户;原帖所说「欧洲似乎要开放」尚无官方公告
  • Claude 状态页:11 月 13 日 UTC 09:58 起 claude.ai 和 Claude Code 登录报错,11:05 部署修复,11:58 宣布恢复,前后约 2 小时
阅读全文
AD赞助内容

Expo 推出 Expo Simulators:给 Claude Code、Codex、Cursor 等编程智能体按需开云端 iOS 模拟器和安卓模拟器,自动录屏留证据,每分钟 0.1 美元

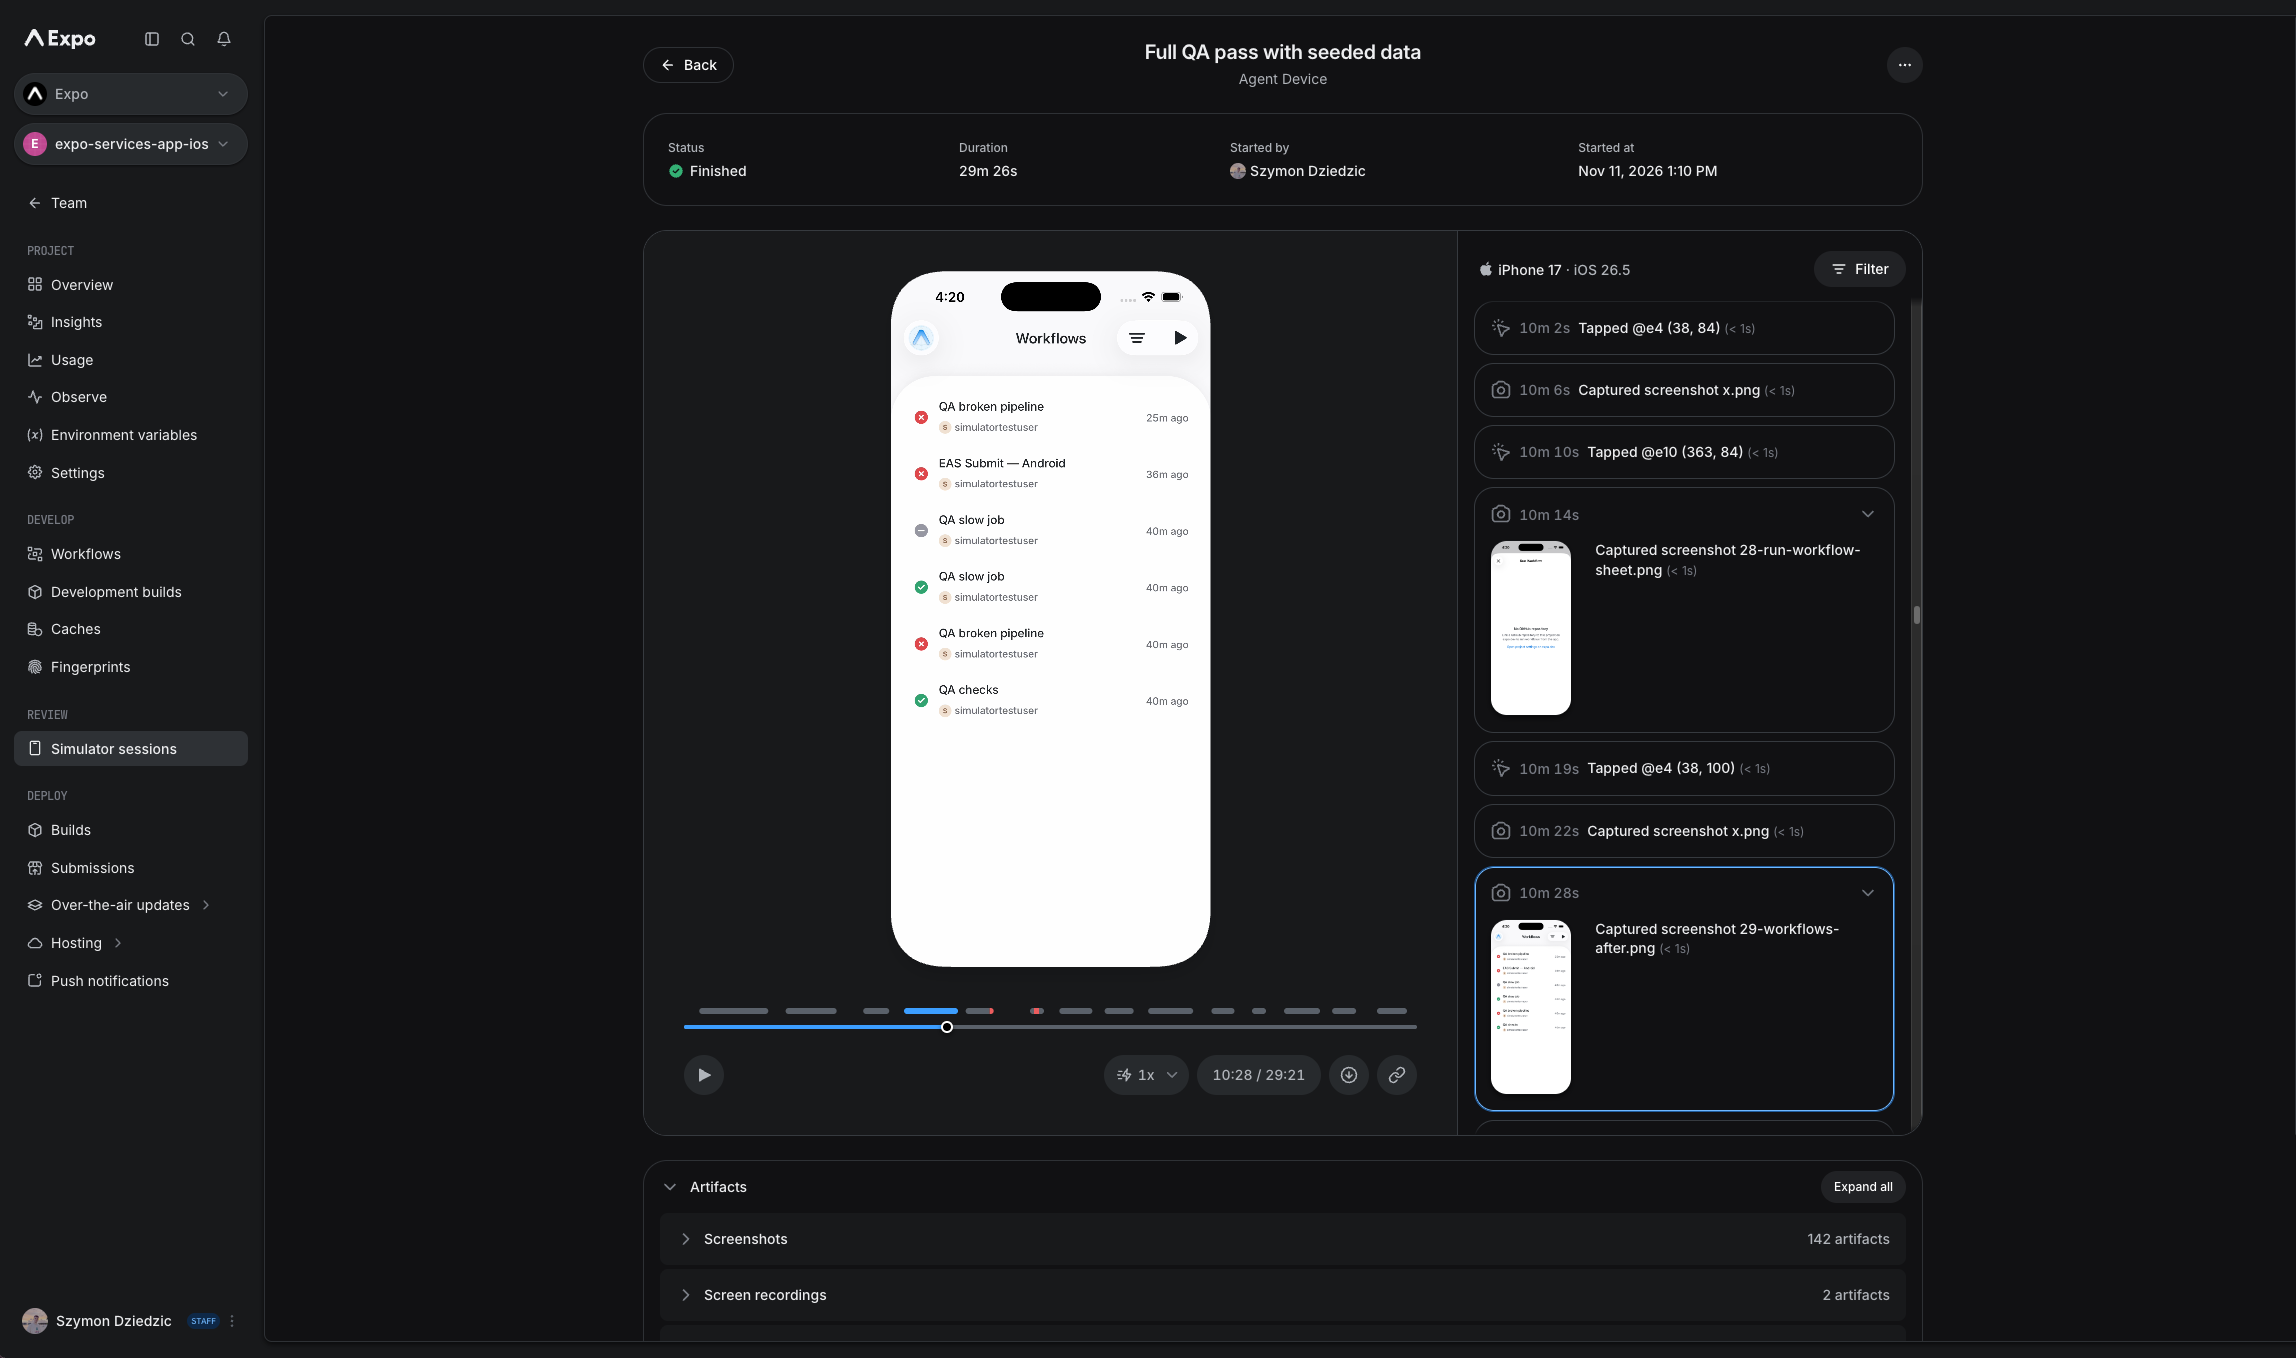
移动开发框架 Expo 于 11 月 12 日正式推出 Expo Simulators,所有付费套餐可用。编程智能体用一条命令就能开一台云端 iOS 模拟器或安卓模拟器,装上构建包自己点测,结束后留下完整录屏、截图、日志和网络记录,可附到 PR 上给人审。每个会话独占一台虚拟机,不用 Mac,Linux 和 Windows(WSL)都能跑 iOS 模拟器。按分钟计费,iOS 和安卓都是每分钟 0.1 美元,Starter 及以上套餐每月含 60 分钟。

Expo 推出 Expo Simulators:给 Claude Code、Codex、Cursor 等编程智能体按需开云端 iOS 模拟器和安卓模拟器,自动录屏留证据,每分钟 0.1 美元

核心要点速览

  • 一条命令开机:npx eas-cli@latest simulator --platform ios 即可启动云端会话,也可从 CI、REST API、Expo Workflows 或 GitHub Actions 启动
  • 兼容现有智能体:Claude Code、Codex、Cursor 等能跑命令行的智能体都能用,沿用 agent-device、Argent 或 Appium 命令;官方提供 eas-simulator 技能
  • 留证据:每个会话保留完整录屏、截图、日志、网络流量和 CPU 内存数据,可附到 PR,审阅者不用拉分支本地构建
  • 隔离与自动关机:每个会话独占一台虚拟机,最长 2 小时,可设更短上限和空闲超时,避免忘关计费
  • 价格:iOS 和安卓都按每分钟 0.1 美元计费,Starter、Production、Enterprise 套餐 2027 年前每月含 60 分钟;Expo 本身不提供 AI 模型
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Theo 称开源权重模型只占 T3 Code 不到 0.5% 的流量,近 7 天仅 6% 用户试过,「开源模型还香吗」再起争论

T3 Code 作者 Theo(@theo)11 月 12 日中午(新加坡时间)在 X 发帖:开源权重模型在 T3 Code 里的流量占比不到 0.5%。他在回复里补充:近 7 天只有 6% 的用户用过开源权重模型(一个月前是 15%),而且「大多数人试一次就放弃了」。主帖约 8.3 万浏览、1400 余赞、170 余条回复;他前一晚那条「还记得开源权重模型吗?那时候挺好玩」约 24 万浏览。反方指出 T3 Code 本来就是围绕 Claude Code、Codex 等订阅设计的,样本有偏。以下为当事人自报数据和社区讨论,非独立统计。

核心要点速览

  • Theo 口径:开源权重模型占 T3 Code 提示量 不到 0.5%(「总使用量」口径)
  • 近 7 天用过开源权重模型的用户 6%,一个月前约 15%;Theo 称多数人「试一次就放弃」
  • 热度:主帖约 8.3 万 浏览、1432 赞、173 回复;前一晚的引子帖约 24 万 浏览、1750 赞
  • T3 Code 当天刚突破 1000 名 GitHub 贡献者,仓库约 5.7 万 star,MIT 许可
  • 反方观点:T3 Code 主要调度 Claude Code、Codex 等订阅,不是为本地或开源模型设计,占比偏低有结构原因
阅读全文

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

亚马逊 11 月 11 日(北京时间 12 日凌晨)正式发布 AWS Emulator:一个在本机运行的 AWS API 模拟器,AWS CLI、各语言 SDK 和编码 Agent 只需改几个环境变量,就能把请求打到 127.0.0.1:9297,而不是真实云端,无需 AWS 账号、也不另收费。它用 Rust 编写,基于 AWS SDK 使用的同一套 API 模型生成,官方称覆盖 200 多个服务的 400 多个 API 模型。最特别的是,按高级首席工程师 Matthew Goldberg 的说法,全部代码由成千上万个自主 Agent 编写、测试和修复,团队没有手写或人工审查过一行。源码和保真度测试集都以 CC0 协议放在 GitHub 上。

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

核心要点速览

  • 覆盖 200+ 个 AWS 服务、400+ 个 API 模型(官方口径),本地 HTTPS 端点 127.0.0.1:9297,无需 AWS 账号、不另收费
  • 代码 100% 由自主 Agent 编写:三组 Agent 分别写测试、找差异、修 bug,每天修复 数千 个问题、数百 个 Agent 并发工作(官方口径)
  • 公开的保真度测试集 manifest 列出约 2.97 万条测试(本站统计),每条都先在真实 AWS 上验证;按服务公布「k / n」通过数,官方未给出总通过率
  • 限制:不评估 IAM 策略、单账号单 Region、只在 us-west-2 校验,数据只存在内存中,不可用于安全测试或生产
  • 安装:Linux 用 RPM/Debian 包,macOS/Windows 用 Docker;或运行 aws agent-toolkit add-skill --skill-name aws-emulator 让编码 Agent 自行配置(需 AWS CLI 2.35.0+)
阅读全文
关联模型 / 智能体 / 厂商:

Einsia 与清华发布多 Agent 编排基准 WorkflowArena:145 个长程任务、25 种 Claude Code / Codex 配置,最强的 Opus 5.5 也只完整解决 36.95%

Einsia AI 联合清华大学等 11 月 10 日发布 WorkflowArena,专门测模型能不能自己拆任务、派子 Agent、写工作流并整合结果。基准含 8 个专业领域 145 个长程任务,用隐藏验证器打分,并记录每一次委派。论文测了 9 个模型在 Claude Code 和 Codex 中的 25 种配置:最强的 Claude Opus 5.5(max)平均只完整解决 36.95% 的任务,SWE 最高 29.41%,法律不超过 9.09%。Claude 系倾向少而大的委派,GPT 系则多而小;Opus 写的工作流能让较弱执行模型平均多得 6.41 分。代码和论文已公开。

Einsia 与清华发布多 Agent 编排基准 WorkflowArena:145 个长程任务、25 种 Claude Code / Codex 配置,最强的 Opus 5.5 也只完整解决 36.95%

核心要点速览

  • 规模:145 个长程任务、8 个领域、17 种任务形式(软件工程、Lean 形式化证明、法律、金融、科学、运维、内容、3D 等),测 9 个模型的 25 种配置
  • 完整解决率:Opus 5.5(max)36.95%、Opus 5.5(high)34.11%;数学最高 95.83%,SWE 最高 29.41%,法律与金融分别不超过 9.09% 和 18.75%
  • 成本:Opus(high)每任务约 736 万 token、6.66 美元;GPT-6.1 Sol(low)27.59%、3.61 美元;GPT-6 Astra(xhigh)30.80% 却要 29.26 美元(按 API 价格估算)
  • 委派风格(high 档):Opus / Sonnet 每任务 0.86 / 0.76 次工作流调用、每次 5.55 / 6.14 个 worker;Astra / Sol 2.09 / 1.94 次、每次仅 1.72 / 1.69 个
  • 固定执行模型时,Opus 编写的工作流让 4 个较弱执行模型的连续得分平均提高 6.41 分,Astra 编写的则帮助有限,还让其中两个下降
阅读全文

Langfuse 推出开源 AI Gateway 公测:Rust 编写、22MB 镜像,改一个 base URL 就能按人、按 Key、按模型统计 Claude Code 和 Codex 的花费

开源 LLM 可观测平台 Langfuse(今年 1 月并入 ClickHouse)11 月 9 日宣布 AI Gateway 公测。应用和编码 Agent 把 OpenAI 或 Anthropic 请求发给 Langfuse,由网关用组织保存的厂商密钥转发,并把每次调用记为一条 trace。核心代码采用 MIT 许可,可单个 22MB Docker 镜像自托管;官方称开启追踪时中位延迟低于 3 毫秒。公测期只支持 OpenAI 和 Anthropic,Bedrock、Vertex 等随后跟进。

Langfuse 推出开源 AI Gateway 公测:Rust 编写、22MB 镜像,改一个 base URL 就能按人、按 Key、按模型统计 Claude Code 和 Codex 的花费

核心要点速览

  • 接入只改 2 处:base URL 和 API Key,原生支持 OpenAI Responses、Chat Completions 与 Anthropic Messages(含流式),不做格式互转(changelog)
  • 性能(官方口径):Rust 编写,开启追踪中位延迟 <3ms,单台 2 vCPU 节点可承载 1000+ 并发流,自托管镜像 22MB(官方博客)
  • Langfuse Cloud 在 4 个区域可用:EU、US、JP、HIPAA;自托管免费,Cloud 只对记录下来的请求计费,不记录的请求免费
  • 已有 5 类编码工具接入指南:Claude Code/Claude Desktop、Codex、GitHub Copilot CLI、OpenCode、pi
  • Langfuse 自报规模:GitHub 35k+ 星、每月 90B+ 条 observation、Fortune 50 中 21 家在用(官方口径)
阅读全文

Anthropic 发布 Claude 选型指南:多数编码任务先用 Opus 5.5(medium),换模型前先调 effort,子 Agent 交给 Haiku 5.5 省钱

Anthropic 开发者博客 claude.dev 11 月 9 日发布 Addy Osmani 撰写的选型指南《Which Claude model should you build with?》,ClaudeDevs 推文获约 9200 赞、1.2 万收藏。核心建议:大多数编码和知识工作先用 Opus 5.5、effort 设 medium(Claude Code 默认);范围明确的修 bug、按规格开发降到 Sonnet 5.5;分类、路由、抽取和读日志类子 Agent 用 Haiku 5.5;大型重构、迁移和深度研究再升到 Fable 5.2。换模型之前先调 effort,并先给模型加上自我验证手段。指南还列出四款模型价格、默认 effort 和迁移时会触发 400 错误的兼容性差异。

Anthropic 发布 Claude 选型指南:多数编码任务先用 Opus 5.5(medium),换模型前先调 effort,子 Agent 交给 Haiku 5.5 省钱

核心要点速览

  • 价格(官方口径,每百万 token 输入/输出):Haiku 5.5 $0.10/$0.50(100K 以上 $0.50/$2.50)、Sonnet 5.5 $2/$10、Opus 5.5 $4/$20、Fable 5.2 $8/$40,四款均为 1M 上下文、128K 最大输出
  • Anthropic 自测 FrontierCode 2.0:Fable 5.2(high)45.3% 与 Opus 5.5(max)45.5% 基本持平,单任务成本约为一半;Opus 拉到 high 以上前建议先试 Fable 5.2
  • SWE-bench Pro 子集:Opus 5.5 先用 low 跑、失败再用 high 重跑,通过率约 97%、每题约 $0.17,全部用 high 为 95.3%、$0.29
  • Opus 5.5 统领最多 25 个并行 Sonnet 5.5 子 Agent 搜索约 2200 万 token 代码,成本比 Opus 单跑低约三分之一,得分相近
  • 迁移坑:Fable 5.2 对所有 API 账号启用 preserved thinking,改动历史上下文会报 400;Sonnet/Opus 5.5 与 Fable 5.2 上 tool_choice 为 any/tool 也会报 400
阅读全文
AD赞助内容

Google Antigravity v2.30 推出「知识工作」界面:隐藏终端与 Git,面向调研和写作;可一键导入 Claude Code / Codex / Cursor 的 MCP、技能与子 Agent 配置

Google Antigravity 官方账号 11 月 9 日宣布推出「Knowledge Work」界面布局,面向调研、写作和产出物(artifacts),沿用同一套 Agent harness、插件和 MCP 工具,只是去掉终端和 Git 等开发元素。官方 changelog 显示这是 Antigravity App v2.30.0 的主打功能:首次登录会询问你的工作类型并自动配置布局;语音模式和远程 Agent 完成全量推送;还能让 Agent 把 Claude Code、Codex、Cursor 里的 MCP 服务器、技能、自定义命令、子 Agent 和指令文件导入成你自己的插件。本版共 27 项改进、25 项修复。

Google Antigravity v2.30 推出「知识工作」界面:隐藏终端与 Git,面向调研和写作;可一键导入 Claude Code / Codex / Cursor 的 MCP、技能与子 Agent 配置

核心要点速览

  • 新布局在 Settings > General > Interface Layout 切换,隐藏代码改动和开发工具,把 Agent 进度合并成一行,并用白话描述命令;商业版和企业版暂不可用
  • 首次登录会让你在软件工程、知识工作、数据分析、科研、设计 5 类中选择,自动配置布局,首页给出带插件的起步提示
  • 迁移成本降低:可让 Agent 把 Claude Code、Codex、Cursor 中的 MCP 服务器、技能、自定义命令、子 Agent 和指令文件导入为自有插件
  • 语音模式(个人账号)和远程 Agent(AI Ultra 与付费 AI Pro)在 v2.30.0 完成全量推送;Auto 权限预设去掉 Preview 标记
  • 官方推文发布后约 2 小时获得 1200+ 点赞、5.1 万次浏览;本版 27 项改进、25 项修复
阅读全文

谷歌发布第八代 TPU 新成员 TPU 8i Max 与 TPU 8tx:8i Max 双芯封装,算力、SRAM 和 HBM 带宽翻倍;8tx 主打机密推理,同步开源 TPU Sync

11 月 9 日,Google Cloud 官方账号和 Google AI 与基础设施 SVP Amin Vahdat 宣布第八代 TPU 新增两套系统。TPU 8i Max 把两颗 TPU 8i 芯片封装在一起,官方称算力、SRAM 和 HBM 带宽都是 TPU 8i 的 2 倍,面向超长上下文和最高机架算力密度。TPU 8tx 与 TPU 8t 同一颗芯片,搭配第 5 代 AMD EPYC 主机,在硬件层保护运行中的数据和模型权重,官方称延迟比 TPU 8t 低最多 2 倍、性能损失接近零。加上 4 月发布的 8t、8i,这是谷歌第一次在一年内推出 4 套 TPU 系统。软件方面,谷歌开源 TPU Sync(官方称 KV 传输延迟和首 token 时间降低 90% 以上),推出 Agent Compute Engine 和预览版 TPU Agent 套件(可接入 Claude Code、Cursor、Antigravity),Cloud Pathways 和 GKE 动态切片正式 GA。官方未公布上市时间和价格。

谷歌发布第八代 TPU 新成员 TPU 8i Max 与 TPU 8tx:8i Max 双芯封装,算力、SRAM 和 HBM 带宽翻倍;8tx 主打机密推理,同步开源 TPU Sync

核心要点速览

  • 产品线:第八代 TPU 现有 4 套系统:8t(训练)、8i(低延迟推理)、8tx(机密计算)、8i Max(超长上下文),谷歌称是首次一年内推出 4 套 TPU 系统
  • TPU 8i Max:两颗 8i 芯片合封,官方口径算力、SRAM、HBM 带宽均为 8i 的 2 倍,同样机架占地放下 2 倍硅片
  • TPU 8tx:与 8t 同芯片,配 第 5 代 AMD EPYC 主机,数据和权重在使用中也受硬件保护;官方称延迟比 8t 最多低 2 倍,性能损失接近零
  • 软件:开源 TPU Sync(官方称 KV 传输延迟与 TTFT 降 90% 以上);GKE 动态切片 GA,作业启动最多快 5 倍、故障恢复最多快 4.5 倍
  • 开发者:预览版开源 TPU Agent 套件可接入 Claude Code、Cursor、Antigravity;TPU 客户已近 100 家;上市时间与价格官方未公布
阅读全文

Omarchy 本地模型引擎 omarchy-local-ai 0.5.0 发布:64 GB 机器默认推荐 Nemotron 3.5 Bolt,DHH 称 Omarchy 4.6 将按硬件自动推荐最佳本地模型

11 月 9 日 08:30 UTC,Omarchy 作者 DHH 发布本地模型引擎 omarchy-local-ai v0.5.0,把本地模型支持扩展到 64 GB 的 NVIDIA GB10 / N1x 级机器,并把 Nemotron 3.5 Bolt 设为这一档的默认推荐(项目方实测:262K 完整上下文,短提示 91 tok/s、32K 提示 82 tok/s,峰值内存不到 40 GiB)。约 20 分钟后他在 X 上说,Omarchy 4.6 会为每台机器推荐能跑的最佳模型,并晒出 AMD 送他的 Ryzen AI Max+ 495 机器在 Agents 面板里同时挂着 Claude Code 订阅和本地 Qwen3.8 Flash Next(占用 94 GiB)。这套能力来自 11 月 1 日合并的 PR #17267:一条 omarchy agent local use best 命令按显卡家族和内存档位挑模型,在断网的 rootless Podman 容器里运行,供 OpenCode、pi 等编码 Agent 调用。4.6 的发布日期尚未公布。

Omarchy 本地模型引擎 omarchy-local-ai 0.5.0 发布:64 GB 机器默认推荐 Nemotron 3.5 Bolt,DHH 称 Omarchy 4.6 将按硬件自动推荐最佳本地模型

核心要点速览

  • 发布:omarchy-local-ai v0.5.0 于 11 月 9 日 08:30 UTC 由 DHH 发布;64 GB GB10 / N1x 默认 Nemotron 3.5 Bolt,备选 Qwen3.8 27B(131K 窗口)
  • 实测(项目方口径):Bolt 在 64 GB 上跑满 262K 上下文,短提示 91 tok/s、32K 提示 82 tok/s,峰值 <40 GiB
  • 推荐表 best.toml 目前覆盖 3 档:Strix Halo 128 GB(Flash Next → 27B)、GB10/N1x 128 GB(Flash Next → Bolt → 27B)、GB10/N1x 64 GB(Bolt → 27B)
  • Ryzen AI Max+ 395 / 128 GB 上 Flash Next 在 v0.3.0 达 47.5 tok/s(32K)、代码编辑 105 tok/s;27B 改 4-bit 后 20.7 tok/s、40 GiB
  • 安全边界:模型跑在无外网的 rootless Podman 容器,只读根文件系统、去掉全部 capabilities,API key 用 Podman secret;DHH 原帖约 20 分钟 163 赞、21 条回复
阅读全文

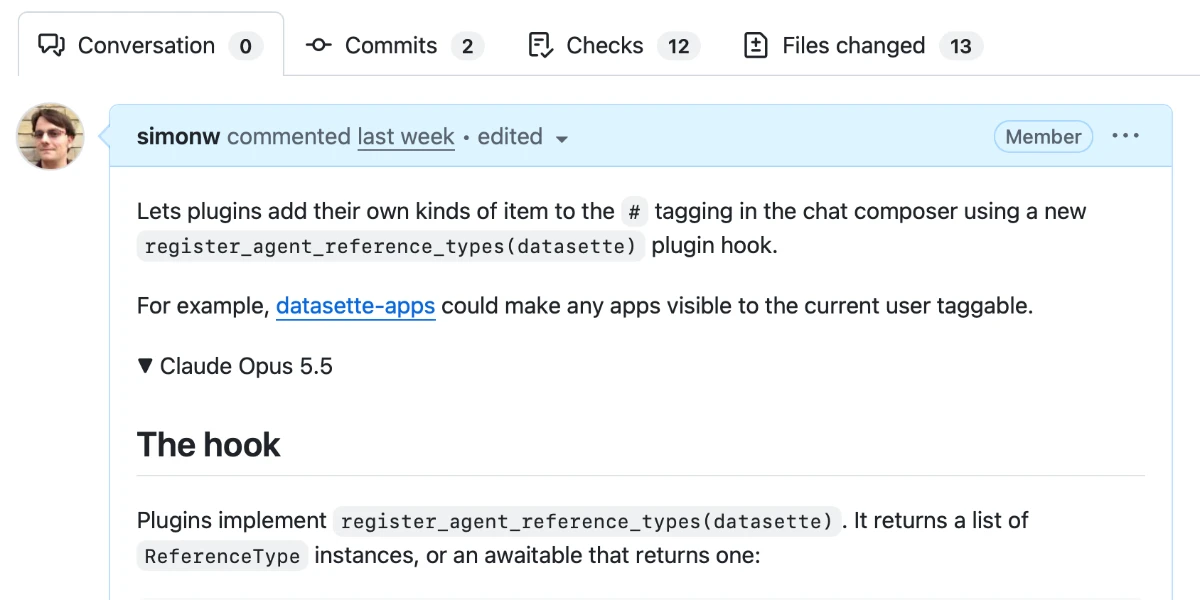
X 热议:Simon Willison 把 AI 写的 PR 描述折叠进 <details>,只留一段人工把关的开场白,称能让「PR 垃圾文」没那么累人

11 月 9 日,Datasette 作者、Django 联合创建者 Simon Willison 在 X 上说,他最近把 Claude Code、Codex 生成的 PR 描述大段折叠进 GitHub Markdown 支持的 <details><summary> 标签,认为这能让「PR 垃圾文」读起来没那么累。该帖约 4 小时内获得 650+ 赞、400+ 收藏、近 150 条回复。他在同日博客里解释:Agent 写的描述准确又全面,问题是太长,读着像垃圾文;他的做法是 PR 开头只放一段经人工判断的简短说明(必要时配截图),完整的 Agent 长文折叠起来,折叠标题写模型名和推理档位,比如「Claude Opus 5.5 Medium」。这是个人工作习惯分享,不是产品发布。

X 热议:Simon Willison 把 AI 写的 PR 描述折叠进 <details>,只留一段人工把关的开场白,称能让「PR 垃圾文」没那么累人

核心要点速览

  • 热度:@simonw 原帖发于 11 月 9 日 04:36 UTC,约 3.5 小时内 656 赞、409 收藏、149 条回复、3.8 万次浏览
  • 做法:PR 第一段是人工把关的最短说明,告诉读者这个 PR 做什么、值不值得细看,常配一张截图;Agent 写的完整描述放进 <details>
  • 标注:折叠标题直接写模型名 + 推理档位(如 Claude Opus 5.5 Medium),让读者一眼知道下面是 AI 写的
  • 实例:他列了 5 个近期 PR,涉及 datasette(#3052、#3043、#3042)、datasette-agent(#51)和 llm(#1838)
  • 回复区补充:</summary> 后要空一行,否则折叠块里的 Markdown 不渲染;也有人提醒,多轮修改后折叠的长描述可能和最终 diff 对不上
阅读全文

X 热议:YC 总裁 Garry Tan 开源 harness 评测,7 种「模型+harness」组合在 20 道任务上通过率都落在 71–79%,差距主要在成本:OpenClaw 每解一题约 $0.44,Claude Code $0.22,Codex $0.17

Y Combinator 总裁兼 CEO Garry Tan(@garrytan)于 2026-11-08 18:09 UTC 在 X 发帖,称出于好奇在做「frontier 模型 + harness」的开源评测,并贴出初步结论截图;随后公开了 GitHub 仓库 garrytan/g-harness-evals(MIT)。仓库做法是固定模型(Opus 5.5 或 GPT-6.1 Sol)和任务,只换 harness(系统提示、工具、记忆)。截图称 7 种组合在同样 20 道编码任务上通过率都在 71–79%,其中 14 道题在所有组合里结果相同,所以「测试太简单、分不出高下」,更难的 Terminal-Bench 复跑正在进行。成本差距明显:Opus 上 OpenClaw 约 $0.44/题、Claude Code $0.22、Hermes $0.24、QM $0.19;Sol 上 Codex 最便宜最快,$0.17。抓取时原帖约 312 赞、84 回复、117 收藏、约 4.2 万展示。仓库自带利益披露:QM 属于 YC 项目,YC 投资了 Hermes。

X 热议:YC 总裁 Garry Tan 开源 harness 评测,7 种「模型+harness」组合在 20 道任务上通过率都落在 71–79%,差距主要在成本:OpenClaw 每解一题约 $0.44,Claude Code $0.22,Codex $0.17

核心要点速览

  • 原帖:Garry Tan(简介「President & CEO @ycombinator」)2026-11-08 18:09 UTC 发帖,抓取时约 312 赞、16 转发、10 引用、84 回复、117 收藏、约 41,767 展示
  • 方法(仓库 README):固定模型 Opus 5.5 或 GPT-6.1 Sol 与 20 道公开任务,只换 harness;指标是通过率、每解一题成本、单次耗时
  • 通过率:7 种组合都在 71–79%,Opus 上 Claude Code 76.3%、Hermes 78.8%、OpenClaw 76.3%、QM 72.5%;95% 区间互相重叠,作者明确说「分不出高下」
  • 成本与速度:Opus 上 OpenClaw $0.44/题、99.4 秒/次,Claude Code $0.22、40.1 秒;Sol 上 Codex $0.17、30.1 秒(作者口径,描述性,未做显著性检验)
  • 定性:个人发起的开源评测引发的讨论,不是任何厂商的官方 Benchmark;作者自述 QM 是 YC 项目、YC 投资了 Hermes,gstack/gbrain 是他本人项目
阅读全文