AI 编程实时动态与要闻

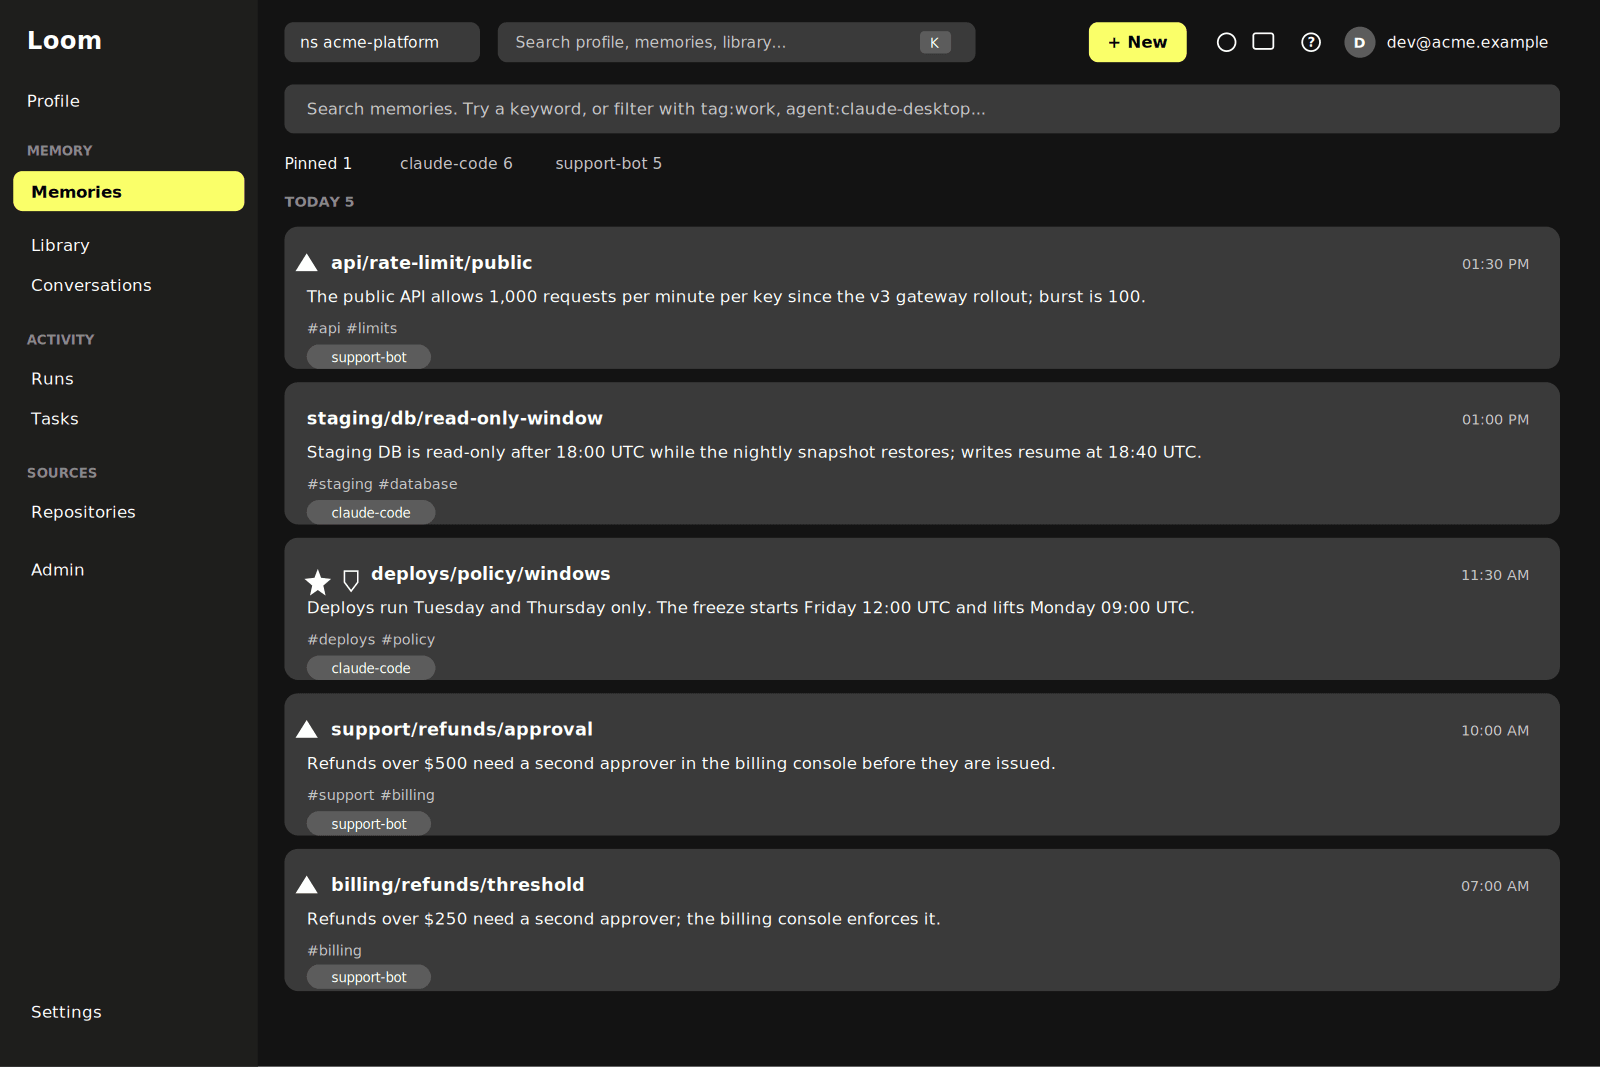
ClickHouse 开源 Loom:给编码智能体的共享记忆 + 实时代码索引,代码问答得分 0.78→0.84

ClickHouse 发布开源(Apache-2.0)的智能体记忆系统 Loom,把记忆、代码索引和运行日志放进同一个 ClickHouse 库,记忆与代码关联,代码变动时标记可能过时的记忆。支持 MCP、HTTP API、Python/TS SDK,提供 Claude Code 和 Codex 插件。官方测试中代码问答平均分从 0.78 升到 0.84。
ClickHouse 开源 Loom:给编码智能体的共享记忆 + 实时代码索引,代码问答得分 0.78→0.84

核心要点速览

  • 代码问答(24 题×3 次)平均分 0.78→0.84,单题平均成本 $0.212→$0.17(官方口径,博客)
  • 找文件任务(36 题×10 次)准确率 91.4%→96.4%
  • LongMemEval-S 100 题:检索记忆 94% 对比塞入完整历史 90%,读取 token 少约 90%;完整 500 题 memory.ask 96.6%(官方口径)
  • 记忆与代码索引同库:函数改名会跟随,被重写则标记待复核,不自动改写
  • Apache-2.0 开源,需 ClickHouse 26.5+(推荐 26.8+),一行脚本用 Docker 启动
阅读全文

Lightning Labs 开源 pi402:编码 Agent 用比特币闪电网络按 token 自付推理费,无需账号、API Key 和信用卡

Lightning Labs 11 月 12 日发布 pi402:一个给 Pi 编码 Agent 用的扩展,内置 Wavelength 闪电钱包,Agent 调用付费推理接口时自动按 L402 或 MPP 协议付款,付款凭证本身就是 API Key,不用注册账号,也不用信用卡。卖方在现有推理 API 前面挂上 Aperture v0.6.0,再用 meterd 或 lightmeter 按 token 计价即可开卖。整套代码开源(MIT)。官方举例:每个输入 token 1 毫聪、输出 2 毫聪,按约 8.05 万美元的比特币价格,约合每百万 token 0.80/1.61 美元。

Lightning Labs 开源 pi402:编码 Agent 用比特币闪电网络按 token 自付推理费,无需账号、API Key 和信用卡

核心要点速览

  • 开箱即用:买方执行 pi install npm:@lightninglabs/pi-402,用 /fund 生成闪电发票充值,或用 /deposit 走链上充值
  • 双协议:Aperture v0.6.0(11 月 5 日发布)同时支持 L402 和 Stripe 与 Tempo 推出的 MPP(IETF 草案 draft-httpauth-payment-00)
  • 按 token 计费:官方示例每输入 token 1 毫聪、每输出 token 2 毫聪,约合每百万 token 0.80/1.61 美元(按比特币约 8.05 万美元)
  • 预算可控:扩展可设单次请求上限和每日预算,界面底栏实时显示钱包余额和每笔付款
  • 全部开源:pi-402 扩展、Aperture、lightmeter 参考实现均开源,pi-402 为 MIT 许可;演示用它付费调用 Kimi K3.1 Pro
阅读全文

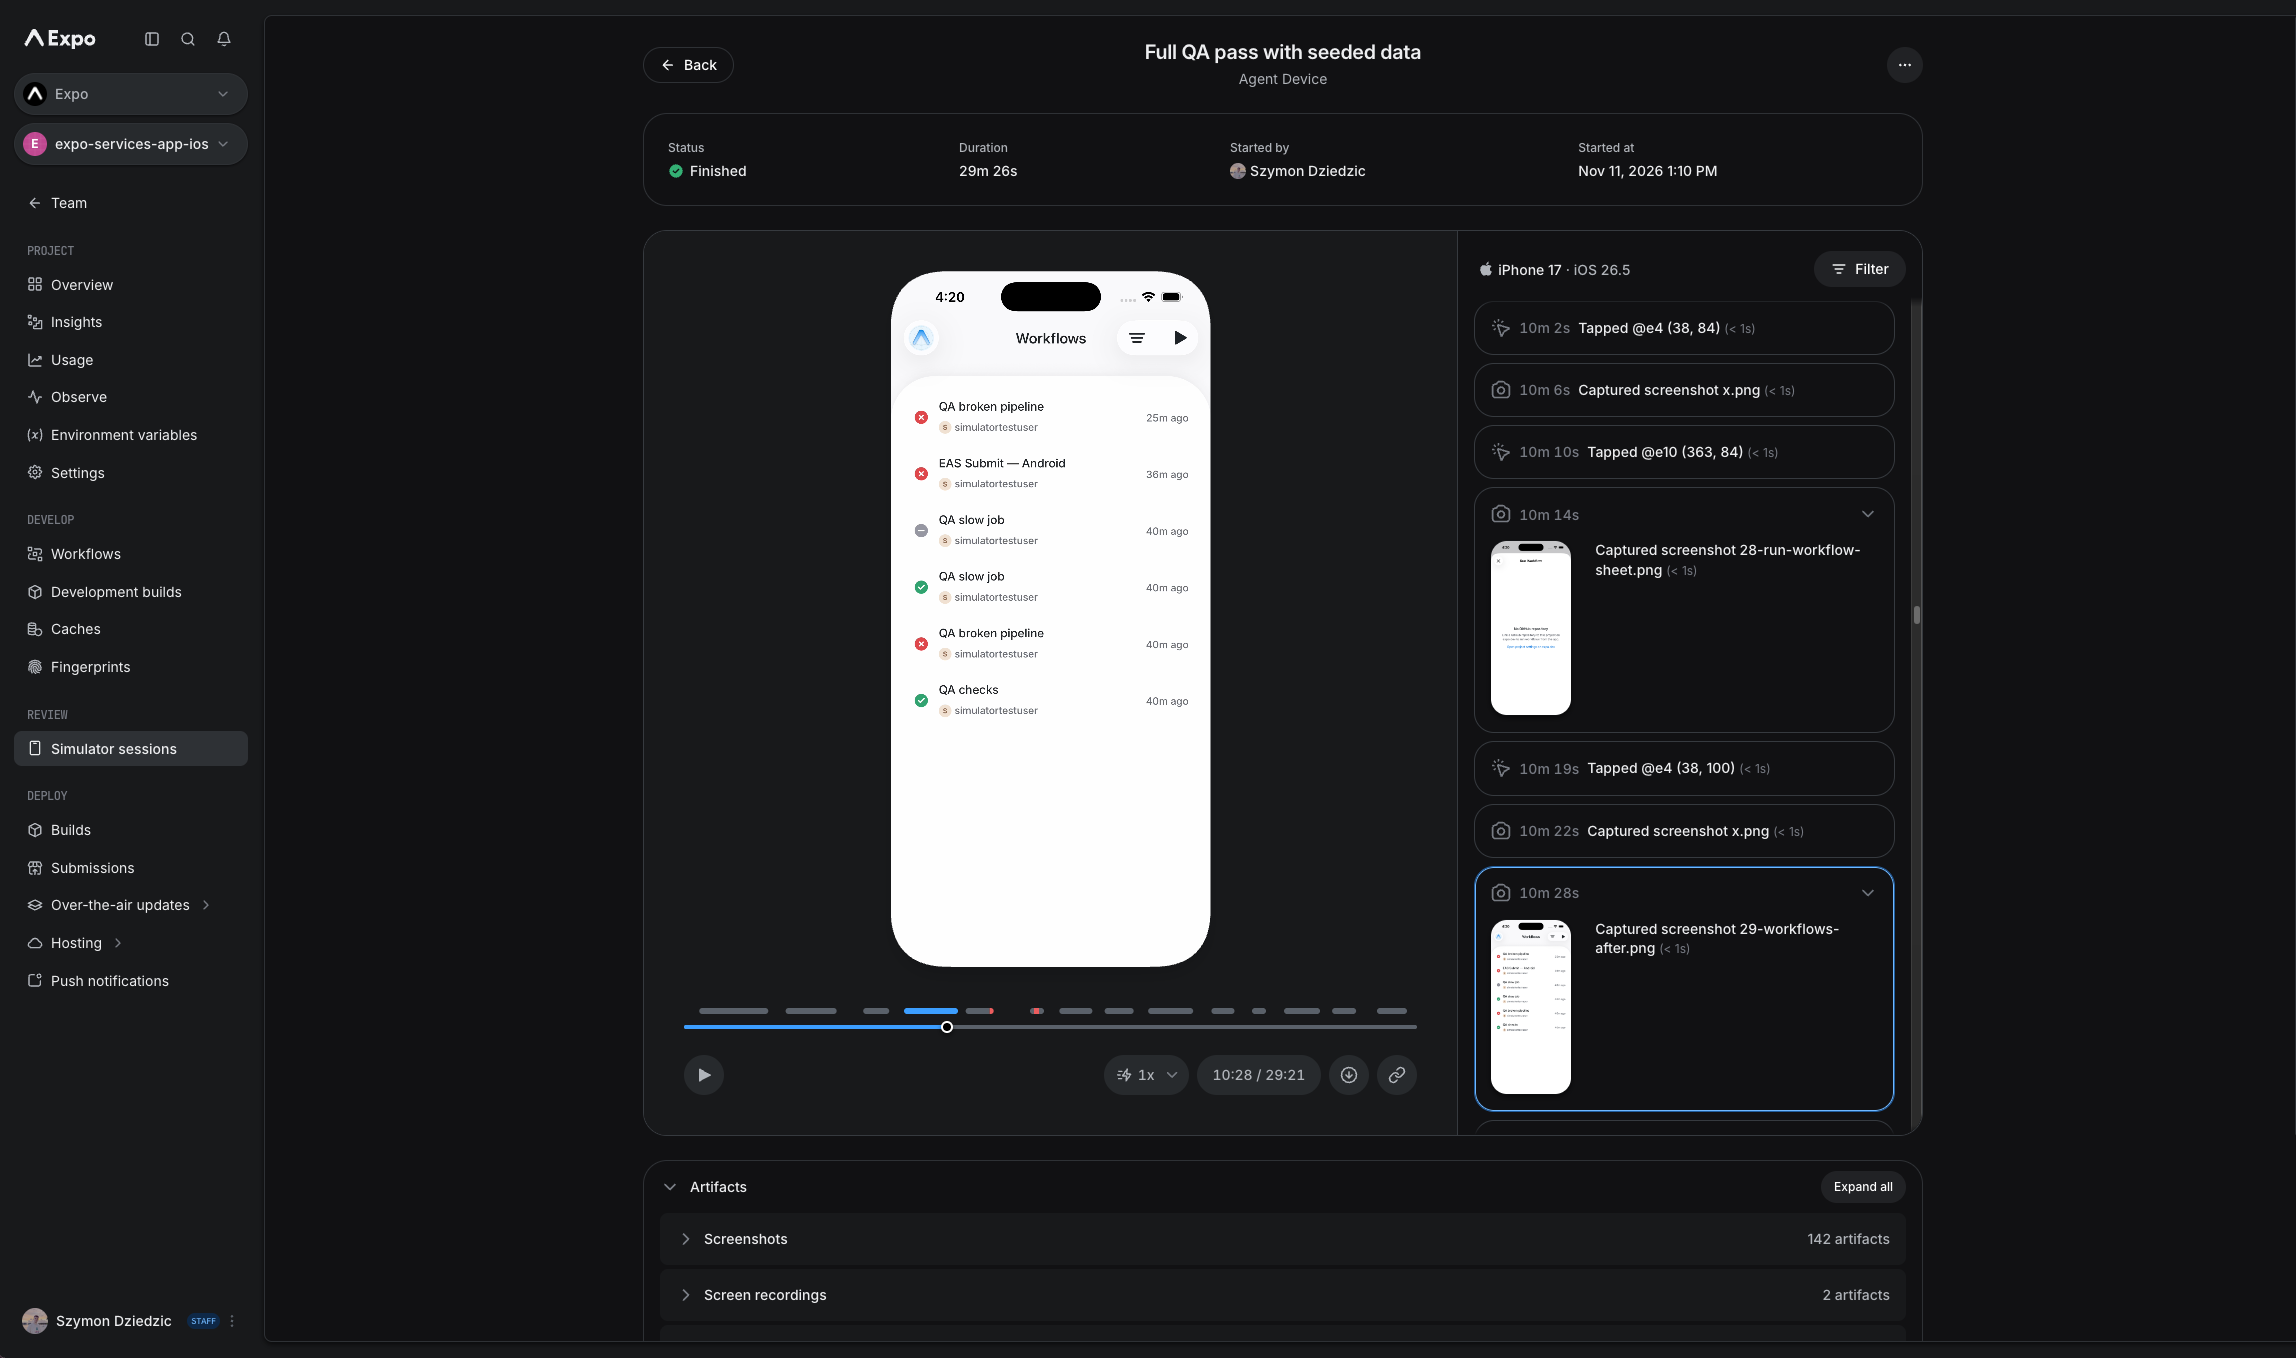
Expo 推出 Expo Simulators:给 Claude Code、Codex、Cursor 等编程智能体按需开云端 iOS 模拟器和安卓模拟器,自动录屏留证据,每分钟 0.1 美元

移动开发框架 Expo 于 11 月 12 日正式推出 Expo Simulators,所有付费套餐可用。编程智能体用一条命令就能开一台云端 iOS 模拟器或安卓模拟器,装上构建包自己点测,结束后留下完整录屏、截图、日志和网络记录,可附到 PR 上给人审。每个会话独占一台虚拟机,不用 Mac,Linux 和 Windows(WSL)都能跑 iOS 模拟器。按分钟计费,iOS 和安卓都是每分钟 0.1 美元,Starter 及以上套餐每月含 60 分钟。

Expo 推出 Expo Simulators:给 Claude Code、Codex、Cursor 等编程智能体按需开云端 iOS 模拟器和安卓模拟器,自动录屏留证据,每分钟 0.1 美元

核心要点速览

  • 一条命令开机:npx eas-cli@latest simulator --platform ios 即可启动云端会话,也可从 CI、REST API、Expo Workflows 或 GitHub Actions 启动
  • 兼容现有智能体:Claude Code、Codex、Cursor 等能跑命令行的智能体都能用,沿用 agent-device、Argent 或 Appium 命令;官方提供 eas-simulator 技能
  • 留证据:每个会话保留完整录屏、截图、日志、网络流量和 CPU 内存数据,可附到 PR,审阅者不用拉分支本地构建
  • 隔离与自动关机:每个会话独占一台虚拟机,最长 2 小时,可设更短上限和空闲超时,避免忘关计费
  • 价格:iOS 和安卓都按每分钟 0.1 美元计费,Starter、Production、Enterprise 套餐 2027 年前每月含 60 分钟;Expo 本身不提供 AI 模型
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

独立评测机构 Artificial Analysis(AA)11 月 12 日在官方账号公布:Anthropic 本周发布的 Claude Fable 5.2 在 AA-Robotics v0.1 上得分 75,成为新榜首,高于此前第一的 GPT-6 Astra(69)和 GPT-6.1 Sol(65)。这项评测让编码 Agent 通过 HTTP API 操控一台 6 轴机械臂完成 8 项桌面任务。AA 称 Fable 5.2 是第一个在「测量盒子尺寸」任务上得分的模型:它只靠摄像头视频,把场景里的卷尺当作比例尺来估算盒子尺寸。上一代 Fable 5.1 在 10 月首发榜单上只有 46.3 分。

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

核心要点速览

  • AA-Robotics v0.1 新榜首:Claude Fable 5.2 75 分,GPT-6 Astra 69、GPT-6.1 Sol 65(AA 口径)
  • 比上一代大跳:Fable 5.1 在 10 月首发榜单上为 46.3,Opus 5.5 为 48.8
  • 「量盒子」任务(长宽高误差需在约 2 毫米内)此前所有模型均未得分,Fable 5.2 是第一个
  • Fable 5.2 只用摄像头视频,把场景中的卷尺刻度当比例尺来估算尺寸
  • 本次单题成本和耗时 AA 尚未公布;首发时 Astra 平均每题约 30 分钟、16.36 美元
阅读全文
AD赞助内容

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

亚马逊 11 月 11 日(北京时间 12 日凌晨)正式发布 AWS Emulator:一个在本机运行的 AWS API 模拟器,AWS CLI、各语言 SDK 和编码 Agent 只需改几个环境变量,就能把请求打到 127.0.0.1:9297,而不是真实云端,无需 AWS 账号、也不另收费。它用 Rust 编写,基于 AWS SDK 使用的同一套 API 模型生成,官方称覆盖 200 多个服务的 400 多个 API 模型。最特别的是,按高级首席工程师 Matthew Goldberg 的说法,全部代码由成千上万个自主 Agent 编写、测试和修复,团队没有手写或人工审查过一行。源码和保真度测试集都以 CC0 协议放在 GitHub 上。

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

核心要点速览

  • 覆盖 200+ 个 AWS 服务、400+ 个 API 模型(官方口径),本地 HTTPS 端点 127.0.0.1:9297,无需 AWS 账号、不另收费
  • 代码 100% 由自主 Agent 编写:三组 Agent 分别写测试、找差异、修 bug,每天修复 数千 个问题、数百 个 Agent 并发工作(官方口径)
  • 公开的保真度测试集 manifest 列出约 2.97 万条测试(本站统计),每条都先在真实 AWS 上验证;按服务公布「k / n」通过数,官方未给出总通过率
  • 限制:不评估 IAM 策略、单账号单 Region、只在 us-west-2 校验,数据只存在内存中,不可用于安全测试或生产
  • 安装:Linux 用 RPM/Debian 包,macOS/Windows 用 Docker;或运行 aws agent-toolkit add-skill --skill-name aws-emulator 让编码 Agent 自行配置(需 AWS CLI 2.35.0+)
阅读全文
关联模型 / 智能体 / 厂商:

Hugging Face Harness Leaderboard 加入 DeepSeek Harness:DSH 在全部 5 组评测中与第一名统计持平,DeepSWE 排第 2,Terminal-Bench 因收尾时关掉后台服务仅排第 6

Hugging Face 研究员 Joël Niklaus 11 月 11 日宣布,DeepSeek 开源编码 Agent DeepSeek Harness(DSH,开发者预览版 0.2.2-rc.1)已加入他维护的 Harness Leaderboard。该榜单固定模型和推理力度、只换 harness,比较 10 款编码 Agent。作者口径:DSH 在 DeepSeek-V4.1-Flash、GLM-5.3-Flash(低/高推理力度)和 Flint 共 5 组评测中都与第一名统计持平;DeepSWE 三模型平均排第 2,仅比 Nous Research 的 Hermes Agent 低 0.5 分;Terminal-Bench 排第 6。主要原因是 DSH 结束任务时会关掉自己启动的后台程序,3 道要求留着服务器给评分器检查的任务 36 次只过 2 次,每组评测因此丢 1.5–1.7 分。平均每解出一题花费 0.53 美元。这是个人维护的研究榜单,并非 DeepSeek 或 Hugging Face 官方公告。

Hugging Face Harness Leaderboard 加入 DeepSeek Harness:DSH 在全部 5 组评测中与第一名统计持平,DeepSWE 排第 2,Terminal-Bench 因收尾时关掉后台服务仅排第 6

核心要点速览

  • 榜单固定模型只换 harness,比较 10 款编码 Agent;DSH 在 5/5 组评测中与第一名统计持平(作者口径)
  • DeepSWE 三模型平均排 第 2,比 Hermes Agent 低 0.5 分;Terminal-Bench 排 第 6
  • 3 道需保留服务器的 Terminal-Bench 任务:DSH 2/36 通过,OpenCode、Pi、Hermes Agent 均为 36/36
  • 这 3 题让 DSH 每组评测丢 1.5–1.7 分;在 DeepSeek-V4.1-Flash 高推理力度下超过它与第一名的 1.3 分差距
  • 平均每解出一题 0.53 美元;测试版本 0.2.2-rc.1,因需 DeepSeek 账号密钥关闭了网页搜索
阅读全文

Chrome 发布 Modern Web Guidance 1.0:给编码 Agent 的现代 Web 技能包转正,新增旧代码扫描,Firefox 与 Edge 加入共建

Chrome 团队 11 月 10 日发布 Modern Web Guidance(MWG)1.0 稳定版。这是一套装进编码 Agent 的技能包,内含约 200 篇经浏览器工程师和无障碍专家审核的指南,覆盖性能、无障碍、交互体验和安全,并内置 Baseline 兼容性数据,帮 Agent 少写过时的 JavaScript,多用原生 HTML/CSS 能力。1.0 新增「现代化工作流」,可静态扫描已有的 HTML、CSS、JS 和 package.json,找出可安全升级的旧写法;项目也从 Chrome 独家变为 Firefox、Edge 共同参与。支持 Antigravity、Cursor、GitHub Copilot、Codex、WebStorm 等,一行 npx modern-web-guidance@latest install 即可安装。

Chrome 发布 Modern Web Guidance 1.0:给编码 Agent 的现代 Web 技能包转正,新增旧代码扫描,Firefox 与 Edge 加入共建

核心要点速览

  • 规模:约 200 篇专家审核指南,其中约 20% 可被 legacy-scan 确定性扫描;1.0 起每篇指南都有评测,并公开评测看板(官方口径)
  • 扫描规则:在约 4.5 万个开源仓库上分半调参与留出测试,默认规则需达到静态匹配精度 ≥80%、复核后精度 ≥90%;本地 AST 解析,零 LLM 调用
  • 案例:腾讯 WeTV 在 CI/CD 里接入后,Agent 自动解决 90% 的性能检查失败,处理时间从 4 小时降到 30 分钟(降 87%,厂商口径)
  • 案例:note inc. 在生产代码库 180 次评测中,现代 Web 检查通过率从 61% 升到 94%,431 个合并 PR 里 LCP 图片优先级设置提升 28%
  • 上手:npx modern-web-guidance@latest install,旧版用 update 升级;在 Agent 中输入 /modern-web-guidance Modernize the code in this directory 触发现代化工作流
阅读全文

Langfuse 推出开源 AI Gateway 公测:Rust 编写、22MB 镜像,改一个 base URL 就能按人、按 Key、按模型统计 Claude Code 和 Codex 的花费

开源 LLM 可观测平台 Langfuse(今年 1 月并入 ClickHouse)11 月 9 日宣布 AI Gateway 公测。应用和编码 Agent 把 OpenAI 或 Anthropic 请求发给 Langfuse,由网关用组织保存的厂商密钥转发,并把每次调用记为一条 trace。核心代码采用 MIT 许可,可单个 22MB Docker 镜像自托管;官方称开启追踪时中位延迟低于 3 毫秒。公测期只支持 OpenAI 和 Anthropic,Bedrock、Vertex 等随后跟进。

Langfuse 推出开源 AI Gateway 公测:Rust 编写、22MB 镜像,改一个 base URL 就能按人、按 Key、按模型统计 Claude Code 和 Codex 的花费

核心要点速览

  • 接入只改 2 处:base URL 和 API Key,原生支持 OpenAI Responses、Chat Completions 与 Anthropic Messages(含流式),不做格式互转(changelog)
  • 性能(官方口径):Rust 编写,开启追踪中位延迟 <3ms,单台 2 vCPU 节点可承载 1000+ 并发流,自托管镜像 22MB(官方博客)
  • Langfuse Cloud 在 4 个区域可用:EU、US、JP、HIPAA;自托管免费,Cloud 只对记录下来的请求计费,不记录的请求免费
  • 已有 5 类编码工具接入指南:Claude Code/Claude Desktop、Codex、GitHub Copilot CLI、OpenCode、pi
  • Langfuse 自报规模:GitHub 35k+ 星、每月 90B+ 条 observation、Fortune 50 中 21 家在用(官方口径)
阅读全文

Omarchy 本地模型引擎 omarchy-local-ai 0.5.0 发布:64 GB 机器默认推荐 Nemotron 3.5 Bolt,DHH 称 Omarchy 4.6 将按硬件自动推荐最佳本地模型

11 月 9 日 08:30 UTC,Omarchy 作者 DHH 发布本地模型引擎 omarchy-local-ai v0.5.0,把本地模型支持扩展到 64 GB 的 NVIDIA GB10 / N1x 级机器,并把 Nemotron 3.5 Bolt 设为这一档的默认推荐(项目方实测:262K 完整上下文,短提示 91 tok/s、32K 提示 82 tok/s,峰值内存不到 40 GiB)。约 20 分钟后他在 X 上说,Omarchy 4.6 会为每台机器推荐能跑的最佳模型,并晒出 AMD 送他的 Ryzen AI Max+ 495 机器在 Agents 面板里同时挂着 Claude Code 订阅和本地 Qwen3.8 Flash Next(占用 94 GiB)。这套能力来自 11 月 1 日合并的 PR #17267:一条 omarchy agent local use best 命令按显卡家族和内存档位挑模型,在断网的 rootless Podman 容器里运行,供 OpenCode、pi 等编码 Agent 调用。4.6 的发布日期尚未公布。

Omarchy 本地模型引擎 omarchy-local-ai 0.5.0 发布:64 GB 机器默认推荐 Nemotron 3.5 Bolt,DHH 称 Omarchy 4.6 将按硬件自动推荐最佳本地模型

核心要点速览

  • 发布:omarchy-local-ai v0.5.0 于 11 月 9 日 08:30 UTC 由 DHH 发布;64 GB GB10 / N1x 默认 Nemotron 3.5 Bolt,备选 Qwen3.8 27B(131K 窗口)
  • 实测(项目方口径):Bolt 在 64 GB 上跑满 262K 上下文,短提示 91 tok/s、32K 提示 82 tok/s,峰值 <40 GiB
  • 推荐表 best.toml 目前覆盖 3 档:Strix Halo 128 GB(Flash Next → 27B)、GB10/N1x 128 GB(Flash Next → Bolt → 27B)、GB10/N1x 64 GB(Bolt → 27B)
  • Ryzen AI Max+ 395 / 128 GB 上 Flash Next 在 v0.3.0 达 47.5 tok/s(32K)、代码编辑 105 tok/s;27B 改 4-bit 后 20.7 tok/s、40 GiB
  • 安全边界:模型跑在无外网的 rootless Podman 容器,只读根文件系统、去掉全部 capabilities,API key 用 Podman secret;DHH 原帖约 20 分钟 163 赞、21 条回复
阅读全文

阿里等发布 Co-Design Bench:273 个真实用户改需求任务,最强的 GPT-6 Astra 平均满足 69.9% 验收项,但只有 26.4% 的任务全部做对

复旦与阿里巴巴(Alibaba Token Hub)等机构的研究者在 arXiv 发布 Co-Design Bench(2610.35138,2026-10-26 提交),11 月 8 日起在 X 上被广泛转述。它从 26,314 个真实用户编码会话、37,463 条去重请求中挑出 273 个「改了又改」的网页应用修改任务(多模态编辑 100 个、仓库编辑 173 个),配 2,331 条隐藏的专家验收标准。在统一的 Claude Code 外壳下测 10 个模型:最强的 GPT-6 Astra 平均满足 69.9% 的验收项,但全部验收项都通过的任务只有 26.4%;Claude Opus 5 为 18.3%,Grok 4.6 只有 6.6%。论文测的是 9 月版本模型,不含 Opus 5.5、GPT-6.1 等新版。

阿里等发布 Co-Design Bench:273 个真实用户改需求任务,最强的 GPT-6 Astra 平均满足 69.9% 验收项,但只有 26.4% 的任务全部做对

核心要点速览

  • 规模:273 个任务(多模态编辑 100 + 仓库编辑 173),来自 26,314 个真实编码会话,2,331 条隐藏验收标准
  • 头名 GPT-6 Astra:平均满足 69.9% 验收项(Strict 0.699),全部通过率仅 26.4%
  • 其余全部通过率(论文口径):Opus 5 18.3%、Qwen3.8-Max 16.5%、Kimi K3 15.8%、Qwen3.8-27B 15.0%、GPT-5.6 Sol 14.3%、Grok 4.6 6.6%
  • 对照:同组作者在旧基准 WebCompass-edit 上测得 Opus 4.8 智能体模式完成度 99.4%,说明旧基准已接近饱和
  • 仓库改动涉及 3–4 类变更时,10 个模型的完成度都低于只涉及 1–2 类的任务
阅读全文
AD赞助内容

Open WebUI 0.13.1:Claude Code、Codex、Pi 等编码 Agent 进入模型选择器,并推出桌面伴侣 Tether

自托管 AI 聊天平台 Open WebUI(GitHub 约 15.8 万星)于 2026-11-08 11:07 UTC 在 GitHub 发布 v0.13.1。最大变化是:在提供 Agent 的 Open Terminal 上,Claude Code、Codex、Pi 等编码 Agent 会直接出现在模型选择器里,可聊天、语音调用、调推理强度和服务档位,并在对话里批准工具请求。同时推出桌面伴侣应用 Tether(macOS / Windows / Linux),把本机接入 Open WebUI,让模型和 Agent 在你真实的文件和仓库里干活,手机浏览器也能远程调用。工具对话不再每轮改写系统提示,可命中提供商的提示缓存,官方称成本「大幅降低」。约 45 分钟后发布 v0.13.2 修复纯 HTTP 访问下的 UUID 报错。

Open WebUI 0.13.1:Claude Code、Codex、Pi 等编码 Agent 进入模型选择器,并推出桌面伴侣 Tether

核心要点速览

  • 发布:GitHub v0.13.1 于 2026-11-08 11:07 UTC 发布,v0.13.2 于 11:53 UTC 跟进修复;仓库约 15.8 万星
  • 编码 Agent 当模型用:Claude Code、Codex、Pi 出现在模型选择器,每个对话固定 1 个 Agent,不支持重新生成、续写或编辑重发
  • Tether:新的桌面伴侣应用,覆盖 macOS / Windows / Linux 3 个平台,主动外连无需开端口,会话默认 90 天不用即过期(SESSION_EXPIRES_IN)
  • 省钱与提速:工具对话保持提示前缀稳定以命中缓存;大对话打开约快 2 倍;粘贴 1.6 万行后每次按键从 8.6 秒降到 74 毫秒(约 117 倍)
  • 新增 Auto 工具权限(默认关闭):由审查模型判断工具调用是否需确认;50,000 字符以下的小文件默认全文注入而非检索
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Claude Code 团队的 Addy Osmani 发长文《你的 coding agent 把你变成了经理》,把管理团队的方法映射到管 agent

Anthropic Claude Code 团队的 Addy Osmani(@addyosmani)于 2026-11-08 07:32 UTC 在 X 发布长文《Your coding agents made you a manager》,核心观点是:整天用 coding agent 的工程师其实在做管理,最有效的习惯依次是给 agent 可运行的验证手段、交代仓库里看不到的上下文、把重复纠正写进 CLAUDE.md、只对不能违反的规则用 hook 强制、先定计划再动手,并且「委派任务,不委派判断」。抓取时约 964 赞、1,528 收藏、101 转发、39 引用、约 5.4 万展示。这是员工个人文章引发的讨论,不是 Anthropic 官方公告或新功能发布。

核心要点速览

  • 原帖:Addy Osmani(个人简介「Claude Code @anthropicai」)2026-11-08 07:32 UTC 发布 X 长文,抓取时约 964 赞、1,528 收藏、101 转发、39 引用、94 回复、约 53,672 展示,收藏数高于点赞数
  • 文章按影响排序列出 10 条习惯,第一条是给 agent 能给出明确通过/失败的验证手段(测试、构建退出码、lint、截图),并让它出示结果作为证据
  • 规则分层:prompt、CLAUDE.md、skills 是 agent 可以自行判断的「请求」,hooks、deny 规则和托管设置才是总会执行的「要求」;ALL CAPS、「think harder」这类旧习惯应停用
  • 「纠正两次就重开」:两次纠偏失败后清空会话、改写 prompt;他自己日常同时跑 4–5 个后台 agent 加几个本地会话,并称有时已经太多(作者自述)
  • 定性:员工个人文章引发的讨论,文中没有新的官方数据或产品发布;引用帖中流传的「Claude 写了约 90% Claude Code 代码」等说法不在原文中
阅读全文
关联模型 / 智能体 / 厂商:

OpenCode 发布 Browse:MCP + Chromium 扩展让编码 Agent 直接操控你已登录的真实浏览器

OpenCode 官方账号于 2026-11-07 宣布 Browse 上线:以 MCP 服务器加 Chromium 扩展组合,让 Agent 在你本机真实浏览器里用已有标签页、登录态与插件干活;登录、2FA、付款等敏感步骤可交还人工点 Continue 再继续。兼容 Chrome / Edge / Brave / Arc 等,并可接入 OpenCode、Claude Code、Cursor、Codex、Zed 等 MCP 客户端。源码 MIT 开源在 anomalyco/browse,npm 包 @opencode/browse。

OpenCode 发布 Browse:MCP + Chromium 扩展让编码 Agent 直接操控你已登录的真实浏览器

核心要点速览

  • 形态:MCP 服务器 + Chromium 扩展;Agent 用 Playwright 在后台折叠分组里开标签页,可截图、录屏、抓 HAR
  • 兼容:浏览器含 Chrome / Edge / Brave / Arc / Helium / Vivaldi / Opera / Chromium;客户端含 OpenCode、Claude Code、Cursor、Codex、Zed 等
  • 安全交互:登录、2FA、付款等可 handoff 给用户;会话可用站点 allowlist;官方未公布独立 Benchmark
  • 安装:优先装 Chrome Web Store 扩展,或 npx @opencode/browse install / curl -fsSL https://opencode.ai/browse/install | bash(需 Node.js 22.19+)
  • 信源:官方帖截至写入约 3,305 赞、190 转发、约 13.5 万曝光;GitHub anomalyco/browse 约 108 star(MIT)
阅读全文

Cursor 上线 Voice Chat:可与 Agent 实时双向语音通话,覆盖 Agents Window / IDE / Web / iOS,语音层用 Grok Voice

2026-11-06,Cursor Changelog 发布 Voice Chat with Agents:在 Agents Window、IDE、网页与 iOS 上与编码 Agent 实时双向语音通话;语音听写仍是另一功能。语音层由 Grok Voice 负责(可选 Ara/Eve/Leo/Rex/Sal 等),编码仍用你为该 Agent 选择的模型;开启 Privacy Mode 时语音零留存。需登录 Cursor 账号(仅 API Key 不可发起通话)。

Cursor 上线 Voice Chat:可与 Agent 实时双向语音通话,覆盖 Agents Window / IDE / Web / iOS,语音层用 Grok Voice

核心要点速览

  • 来源:Cursor Changelog「Voice Chat with Agents」(2026-11-06)+ 官方文档 cursor.com/docs/agent/voice-chat
  • 能力:Agent 空闲且输入框为空时点波形按钮开聊;通话中可委派编码、只读查 diff/进度/历史、切换 Project worker
  • 分工:Grok Voice 负责听与说;编码 Agent 仍用你选的模型,并口头播报短进度与完成摘要
  • 隐私与门槛:Privacy Mode 开=语音零留存;需账号登录;仅 API Key 会话无法开通话;默认约 10 分钟无操作挂断,另有每日通话上限
  • 与听写区分:Cmd+Shift+Space 仍是听写(Voice Mode);Voice Chat 是双向通话,无单独快捷键
阅读全文
关联模型 / 智能体 / 厂商:
C
CMU Infini-AI LabInfini-AI-Lab·
👀32
🔥87

CMU Infini-AI 连发 CompressionBench / ServerBench:编码 Agent 自主压模型与设计推理服务;Sonnet 5.5 达 vLLM 约 4.87×「美元/美元」

卡内基梅隆 Infini-AI Lab 于 arXiv(2026-11-04)发布孪生基准:CompressionBench 考编码 Agent 在存储限额内交付可验证压缩权重与推理代码(36 次提交 29 次通过,最优设计较 BF16 平均 PPL 仅高约 3.4%);ServerBench 考完整 LLM 服务系统设计,目标为延迟达标 token 价值 / GPU 美元。11 模型×3 部署中 Claude Sonnet 5.5 在 Gemma E4B 上达 2.97「美元/美元」,约为 vLLM 基线 4.87 倍;33 次运行 22 次通过验证。

核心要点速览

  • 官方:arXiv:2611.06858 CompressionBench + arXiv:2611.06841 ServerBench(CMU Infini-AI Lab)
  • CompressionBench:6 Agent × 6 设定,36 提交中 29 通过独立验证;最优设计平均 PPL 较 BF16 高约 3.4%
  • ServerBench:目标「美元/美元」= 延迟达标 token 价值 / GPU 成本;状态化回放真实编码会话
  • 厂商表口径:Claude Sonnet 5.5 在 Gemma E4B 达 2.97,约 vLLM 基线 4.87×;33 跑 22 验证通过
  • 代码:github.com/Infini-AI-Lab/Compression-Bench 与 Server-Bench
阅读全文
关联模型 / 智能体 / 厂商: