AI 编程实时动态与要闻

Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

Artificial Analysis 11 月 14 日发布编码智能体指数 v2.1:把 FrontierCode 从 1.1 换成 Cognition 的 FrontierCode 2.0(132 个真实任务,按维护者是否愿意合并评分),Terminal-Bench 从 4.0 升到 4.1,保留 SWE-Atlas-QnA-AA。Claude Code + Claude Fable 5.2(xhigh/high)和 Claude Opus 5.5(max)并列 58 分居首;因新版 FrontierCode 更难,各配置平均降 5 分,只有 Codex + GPT-6.1 Terra(max)基本没掉分。
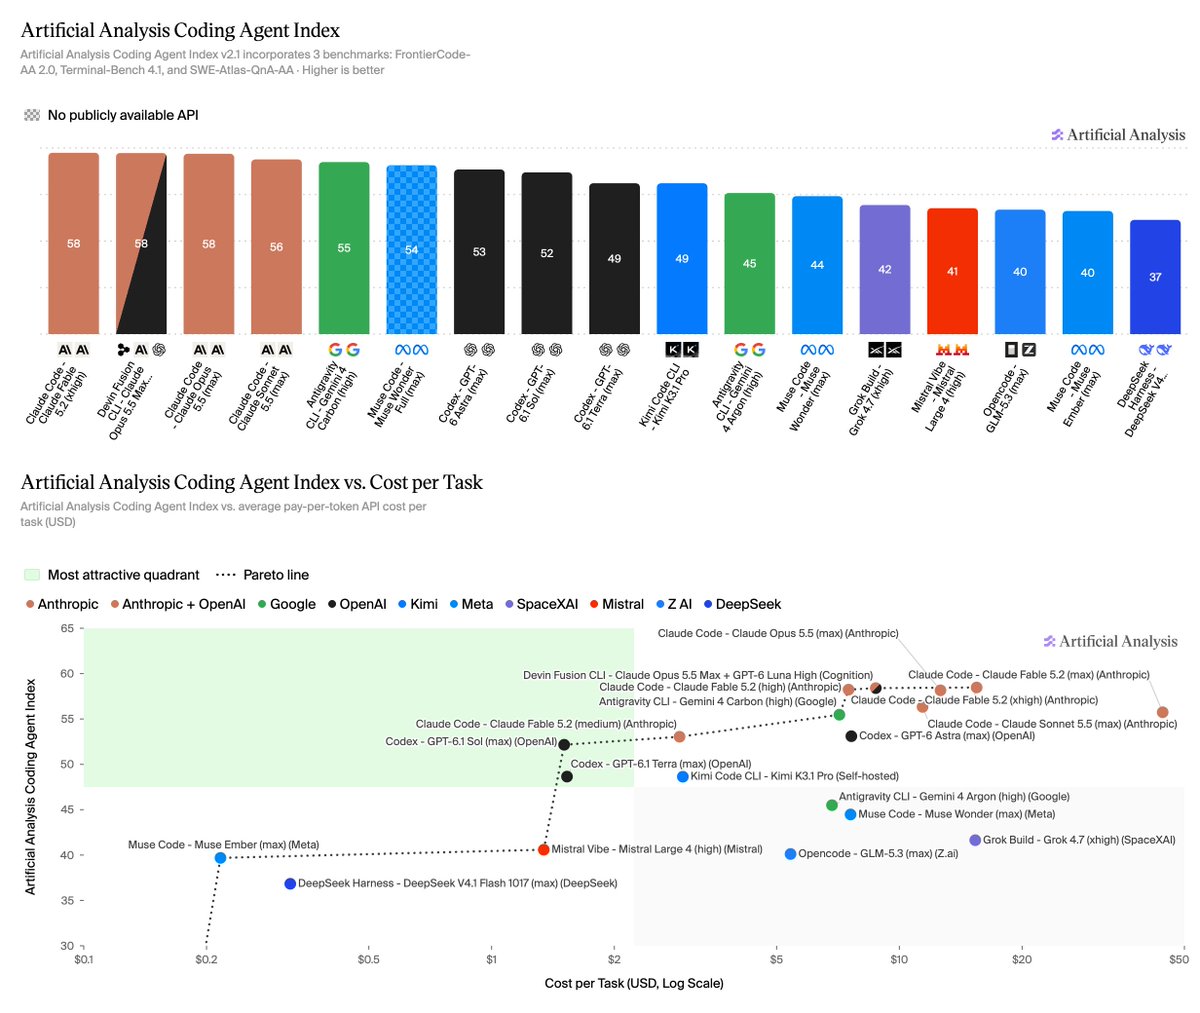
Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

核心要点速览

  • v2.1 构成:FrontierCode-AA 2.0(132 个真实编码任务,按仓库维护者是否会合并评分)、Terminal-Bench 4.1(同样 66 题,更新验证器以提高可靠性、防奖励投机)、SWE-Atlas-QnA-AA
  • 并列第一 58 分:Claude Code + Claude Fable 5.2(xhigh 与 high 均为 58)、Claude Code + Claude Opus 5.5(max),以及 Devin Fusion CLI(Opus 5.5 max + GPT-6 Luna High);其后为 Claude Sonnet 5.5(max)56、Antigravity CLI + Gemini 4 Carbon(high)55
  • 23 个两版都测过的配置在 FrontierCode-AA 2.0 上全部低于 v1.1,均值从 45% 降到 29%;Claude Code + Fable 5.2 以 49% 领先。Terminal-Bench 4.1 各配置变化都不到 3 分,Kimi Code CLI + Kimi K3.1 Pro 以 68% 居首
  • 成本差约 30 倍:48 分以上配置中,Codex + GPT-6.1 Sol(max,52 分)每题 1.51 美元,Claude Code + Fable 5.2(max,56 分)每题 44.22 美元;Fable 5.2 在 medium/high/xhigh 分别为 2.89/7.51/15.47 美元
  • Claude Code 与 Devin Fusion CLI 遇到安全拒答会切换到备用模型:Devin Fusion CLI 与 Opus 5.5(max)约 9% 的尝试由备用模型完成,Fable 5.2(xhigh)6%,Sonnet 5.5 5%
阅读全文

Cognition 推出 Devin Apps:让 Devin 直接在自己的云端机器上搭建并托管内部工具,私有可分享、地址固定,按机器唤醒时长计费

11 月 13 日,Cognition 发布 Devin Apps:用户描述需要的工具,Devin 在会话里把它做成网页应用,并直接从自己的云端机器上提供服务,不部署到第三方托管平台。每个 App 有固定地址(name--id.preview.devinapps.com),访问者必须登录 Devin,永不公开,可按个人、组织或企业分享。App 能用任何技术栈,复用已接入的 MCP、集成和代码库,数据(如 SQLite、Postgres)留在同一台机器上。机器无人访问 5 分钟后休眠,有人打开时唤醒,按唤醒时长计费,搭建和修改按普通会话计费。每次更新都是带 commit 的新版本,新版启动失败时旧版继续服务。功能正在逐步开放。

Cognition 推出 Devin Apps:让 Devin 直接在自己的云端机器上搭建并托管内部工具,私有可分享、地址固定,按机器唤醒时长计费

核心要点速览

  • 托管位置:App 运行在 Devin 自己的云端机器上,不部署到第三方平台,数据和上传文件都留在这台机器
  • 地址固定:形如 name--id.preview.devinapps.com,改名、更新都不变;访问者必须登录 Devin,永不公开
  • 计费:无人访问 5 分钟后休眠、按唤醒时长计费,休眠首次打开需几秒;搭建和修改按普通会话计费
  • 版本管理:每次部署前先 git commit,新版本启动失败时旧版本继续服务,可让会话回滚到任一旧版
  • 适用场景:内部工具、仪表盘、预发布环境、演示原型;功能逐步开放,官方未公布具体单价
阅读全文
关联模型 / 智能体 / 厂商:

Cognition 升级 Devin Teams 套餐:Devin Desktop 不再按席位收费,每人送 2 个并发 SWE-2 免费会话,新增 SSO、按人分档用量上限和标准 BAA,席位上限降到 100

11 月 12 日,Cognition 宣布升级 Devin Teams 套餐:团队所有人都能用新版 Devin Desktop,不再为席位额外付费;新增 Free 模式,每位用户有 2 个由自研模型 SWE-2 驱动的并发免费会话,Desktop 和 CLI 里的免费 SWE-2 也成为 Teams、Pro、Max 套餐的长期权益。管理员可接入 Okta、Entra ID 等 SAML/OIDC 单点登录,按人或按组设置最多 3 档用量上限,并可在设置里申请标准 BAA。同时,Teams 的配额席位 30 天后取消,席位上限从 200 降到 100。

Cognition 升级 Devin Teams 套餐:Devin Desktop 不再按席位收费,每人送 2 个并发 SWE-2 免费会话,新增 SSO、按人分档用量上限和标准 BAA,席位上限降到 100

核心要点速览

  • Desktop 免席位费:团队所有成员都能用新版 Devin Desktop,不再单独购买 Desktop 席位
  • 免费 SWE-2:Free 模式下每人 2 个并发免费会话,可付费加购;Desktop 与 CLI 的免费 SWE-2 成为 Teams、Pro、Max 的长期权益。官方称 SWE-2 接近前沿模型、成本只是零头(未给具体跑分)
  • 管理控制:SSO 支持 Okta、Microsoft Entra ID 及任意 SAML/OIDC,接入后可关闭邮箱登录;用量上限按人或按组设置,最多 3 档,超额申请可人工审批或在上限内自动批准
  • 合规:Teams 客户可在设置中申请标准 BAA(医疗数据所需),无需签企业合同
  • 变化:配额席位 30 天后取消,Teams 席位上限从 200 降到 100;初创计划最高提供 6.5 万美元额度
阅读全文
关联模型 / 智能体 / 厂商:

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

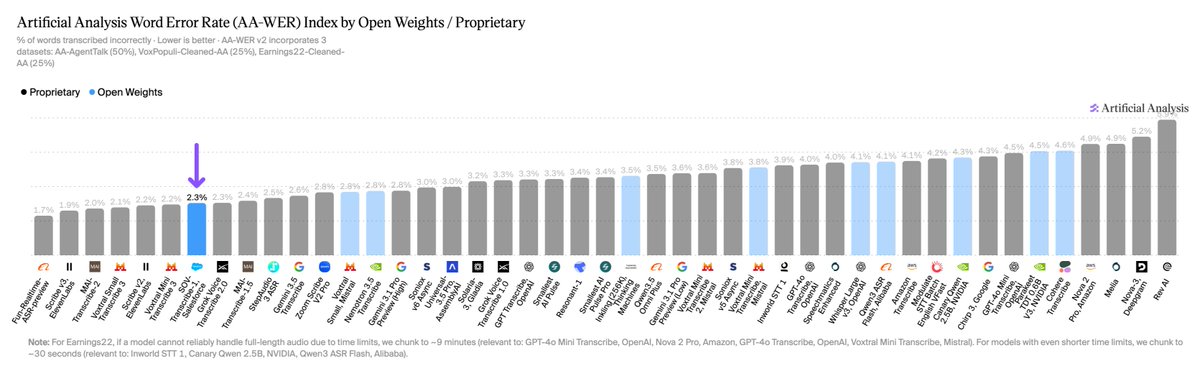
新加坡时间 11 月 13 日 00:30,Artificial Analysis(@ArtificialAnlys)发帖称,Salesforce 新发布的 SOV-Transcribe-1 成为开源权重语音转文字模型第一名:在 AA-WER 指数上词错误率 2.3%,在包括闭源模型在内的 44 个模型中排第 7。它比紧随其后的开源模型 Mistral Voxtral Small 和英伟达 Nemotron 3.5 Transcribe(均为 2.8%)低 0.5 个百分点。模型由 Salesforce 主权 AI(Missionforce Sovereign AI)团队开发,总参数 26.6B、激活参数 4.6B,结构是 Whisper large-v3 音频编码器加 Gemma 4 26B A4B MoE 解码器,权重以 Apache 2.0 许可发布在 Hugging Face。它是非流式模型,适合整段录音转写,不适合实时字幕。

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

核心要点速览

  • AA-WER 2.3%:开源权重第 1、44 个模型中总榜第 7;Voxtral Small 与 Nemotron 3.5 Transcribe 均为 2.8%
  • 分数据集:Earnings22 财报电话 4.1%(Voxtral Small 4.8%),VoxPopuli 1.5%(对手 1.8%),AA-AgentTalk 语音客服对话 1.8%,与 Nemotron 持平
  • 26.6B 总参数 / 4.6B 激活;Whisper large-v3 编码器 + 投影层 + Gemma 4 26B A4B MoE;BF16,单段音频实测最长 30 分钟,支持英法德西意葡荷 7 种语言
  • 官方称 VoiceCodeBench(电话号码、邮箱等实体)任务成功率 76.3%、实体召回 93.4%,23 个系统中排第 2;AppTek 14 种英语口音平均 WER 8.21%,其中 8 种口音最低(含新加坡英语)
  • Apache 2.0;可用 vLLM 插件(vLLM 0.32.0)或 Transformers 部署;官方实测单张 RTX PRO 6000 Blackwell 每秒可转写 1,039 秒音频(配合 DFlash 草稿模型)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SOV-Transcribe-1⚡ Voxtral Small⚡ Nemotron 3.5 Transcribe⚡ Gemma 4⚡ Whisper large-v3🌐 Salesforce🌐 Artificial Analysis🌐 Mistral AI🌐 NVIDIA🌐 Google
AD赞助内容

Cognition 发布 Devin Review 2.0:自 8 月起单次 PR 审查成本降约 82%(约 5×)、中位延迟约 94 秒,并强化自动审查与 Autofix

Cognition 于 11 月 5 日发布 Devin Review 2.0:自 8 月起单次 PR 审查成本下降约 82%,典型成本约 $0.25–$0.75,中位延迟约 94 秒(此前约 139 秒)。支持自动审查、增量复审、可配置花费上限;与 Devin 联用时可调查发现并决定修复、忽略或升级。新增 Devin Review Ultra 与 Custom Reviewers(beta)。

Cognition 发布 Devin Review 2.0:自 8 月起单次 PR 审查成本降约 82%(约 5×)、中位延迟约 94 秒,并强化自动审查与 Autofix

核心要点速览

  • 成本:自 8 月起单次 PR 审查成本降约 82%(约 5×);典型约 $0.25–$0.75;客户口径下修好一个 bug 约 $2.25(厂商)
  • 质量与速度:平均每 PR 发现 bug 数 1.22→1.32;中位延迟约 94 秒(约 1.5× 更快,此前约 139 秒)
  • 增量复审:默认只审变更部分;约 80% PR(含全部 push)审查总花费低于 $1;可设单 PR 花费上限
  • 闭环:与 Devin 联用时,Devin 可调查发现并选择修复、忽略或升级;Autofix 已在 Cloud/Desktop 可用
  • 控制:Devin Review Ultra 做更高成本更彻底审查;Custom Reviewers(beta)可用自定义指令跑专项检查
阅读全文
关联模型 / 智能体 / 厂商:

Cognition 发布 SWE-2 Flash:基于 Inkling-Small 的快速编码模型,200 tok/s、价格为 SWE-2 的五分之一

Cognition 于 11 月 4 日(UTC 19:55)发布 SWE-2 Flash。官方博客称它以 Thinking Machines 的 Inkling-Small(276B 总参、12B 激活)为底座,首次在强化学习前加入大规模中训练,把 FrontierCode 2.0 从 3.2% 提到 24.0%、Terminal-Bench 4.0 从 0.9% 提到 20.0%,自称超过所有美国开源权重模型。生成速度约 200 tok/s,价格为 SWE-2 的五分之一、速度为其 3 倍;本月底前对 Devin Desktop 和 CLI 的 Pro、Max、Teams 用户免费。权重暂不公开,将通过安全共享计划提供给合作方和研究者。

Cognition 发布 SWE-2 Flash:基于 Inkling-Small 的快速编码模型,200 tok/s、价格为 SWE-2 的五分之一

核心要点速览

  • SWE-2 Flash 底座为 Thinking Machines Inkling-Small,276B 总参、12B 激活,规模约为 SWE-2(2.8T-A104B)的十分之一。
  • 训练流程:先用数万亿 token 的科学文章、博客、代码等数据分三阶段中训练,再做大规模强化学习,重点提升 RL 任务质量和多样性。
  • 官方跑分:FrontierCode 2.0 24.0(SWE-2 为 23.8)、DeepSWE 1.1 60.1、Terminal-Bench 2.1 89.2、SWE-Bench Pro v2 Hard 89.9、Terminal-Bench 4.0 20.0。
  • 速度约 200 tok/s(SWE-2 约 60 tok/s),价格为 SWE-2 的五分之一;11 月底前 Devin Desktop/CLI 的 Pro、Max、Teams 用户免费。
  • 出于网络安全风险考虑,权重不直接开源,Cognition 将在未来几周公布安全权重访问计划的细节。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SWE-2 Flash⚡ SWE-2⚡ Inkling-Small🤖 Devin🌐 Cognition🌐 Thinking Machines

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

开源编码智能体 OpenCode 背后的 Anomaly 发布语音输入工具 Hex 3.0 稳定版:按住快捷键说话、松开即粘贴到光标处,语音识别在本机完成,内存占用从约 900MB 降到约 160MB,并新增词汇表、hex 命令行和可选的 OpenCode 改写。

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

核心要点速览

  • Hex v3.0.0 于 10 月 31 日 00:38 UTC 在 GitHub 发布,MIT 协议、Rust 编写,仓库约 1,557 星(发布说明)
  • 官方口径:本地模型内存占用从约 900MB 降到约 160MB;2.3.0 起边说边转写,2 分钟口述松键后约 0.1 秒出字(RTX 5070 Ti)
  • 支持 macOS 15+(Apple 芯片)、Windows x64/ARM64、Linux x64/ARM64,Linux 新增 .deb/.rpm 包
  • 3.0 不自动从 2.3.1 升级,设置、历史和模型需重新下载;语音动作和口令功能被移除
  • @opencode 的发布帖约 2,400 赞、1,600 收藏、10 万+浏览(原帖)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Parakeet⚡ Whisper🤖 OpenCode🤖 Hex🌐 Anomaly

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

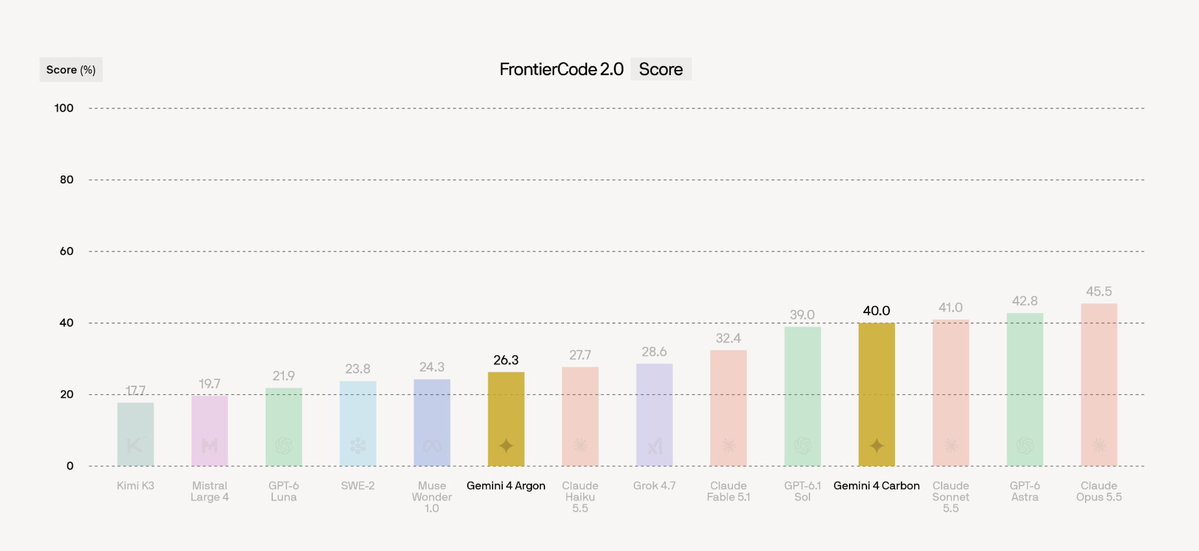
Devin 背后的 Cognition 于 10 月 30 日 01:45(UTC)在 X 上公布,Google 新模型 Gemini 4 Carbon 在其编程基准 FrontierCode 2.0 上得分 40%,每任务成本 4.04 美元,接近最高水平,仅次于 Claude Opus 5.5、GPT-6 Astra 和 Claude Sonnet 5.5。上一代 Gemini 4 Argon 得分 26.3%,每任务成本却更高,为 6.41 美元。成绩为 Cognition 自测口径,排行榜已在官网更新。

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

核心要点速览

  • Gemini 4 Carbon 在 FrontierCode 2.0 得分 40%,每任务 4.04 美元,排在 Claude Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Claude Sonnet 5.5 之后(原帖)
  • Gemini 4 Argon 得分 26.3%,每任务 6.41 美元,高于 Muse Wonder 1.0,但落后于 Claude Haiku 5.5 和 Grok 4.7
  • 从 Argon 到 Carbon,得分提高约 13.7 个百分点,每任务成本反而低约 2.4 美元
  • 官网更新日志显示 10 月 28 日已加入 Gemini 4 Carbon;FrontierCode 2.0 共 132 个任务,按维护者是否会合并打分(排行榜)
  • 所有数字均为 Cognition 自测口径,Google 未就此发布成绩
阅读全文

Cognition 收购 AI 原生安全公司 Corridor,团队并入 Devin Security

Devin 背后的 Cognition 于 10 月 29 日通过 @cognition 官方账号宣布收购 Corridor。Corridor 联合创始人 Jack Cable 和 Ashwin Ramaswami 在 Cognition 官方博客(日期 2026.10.28)中表示,团队将加入 Cognition,把 Devin Security 推向新阶段。Corridor 成立近两年,定位是 AI 原生团队的安全层。官方未披露交易金额。

Cognition 收购 AI 原生安全公司 Corridor,团队并入 Devin Security

核心要点速览

  • Cognition 收购 Corridor,团队并入 Devin Security 方向
  • Corridor 联合创始人 Jack Cable 与 Ashwin Ramaswami 将与 Cognition 总裁 Russell Kaplan、CSO Alex Stamos、CTO Steven Hao 共事
  • 官方观点:AI agent 已能执行端到端攻击链,未来 6 到 12 个月是网络安全最关键的时期
  • 交易金额官方未披露
阅读全文

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文
AD赞助内容

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

Devin 背后的 Cognition 于 10 月 27 日发布 FrontierCode 2.0。新版沿用由开源维护者亲自出题、按"能否合并"打分的方法,但任务来自更多仓库、覆盖安全补丁与性能优化,提示词刻意不写全,并加入大量"周全性"判定项。官方结果中 Claude Opus 5.5 以 45.5% 居首,GPT-6 Astra 42.8% 次之,Grok 4.7、Gemini 4 Argon 等降到 20% 多,基准远未饱和。

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

核心要点速览

  • 榜首 Claude Opus 5.5 为 45.5%(1.1 版 54.6%),GPT-6 Astra 42.8%(1.1 版 53.3%),均为官方/厂商口径
  • Grok 4.7 28.6%、Gemini 4 Argon 26.3%、Muse Wonder 1.0 24.3%、SWE-2 23.9%,DeepSeek V4.1 Flash 19.3%、Kimi K3 17.7%,开源模型差距明显
  • 相比 1.1 版,参考解平均多改 67% 的文件、89% 的代码行,代码库大 25%;任务来源仓库多 55%,阻断性判定项多 43%
  • "周全性"阻断项从 168 条增至 501 条,约 3 倍;80% 任务的参考解优于上游原 PR,审计 agent 还发现并上报了一个上游安全漏洞
  • 成本-得分帕累托前沿上,高端是 Opus 5.5,低成本端有 Luna、Haiku 和 Sol,官方点名 GPT-6.1 Sol 性价比突出(官方博客)
阅读全文

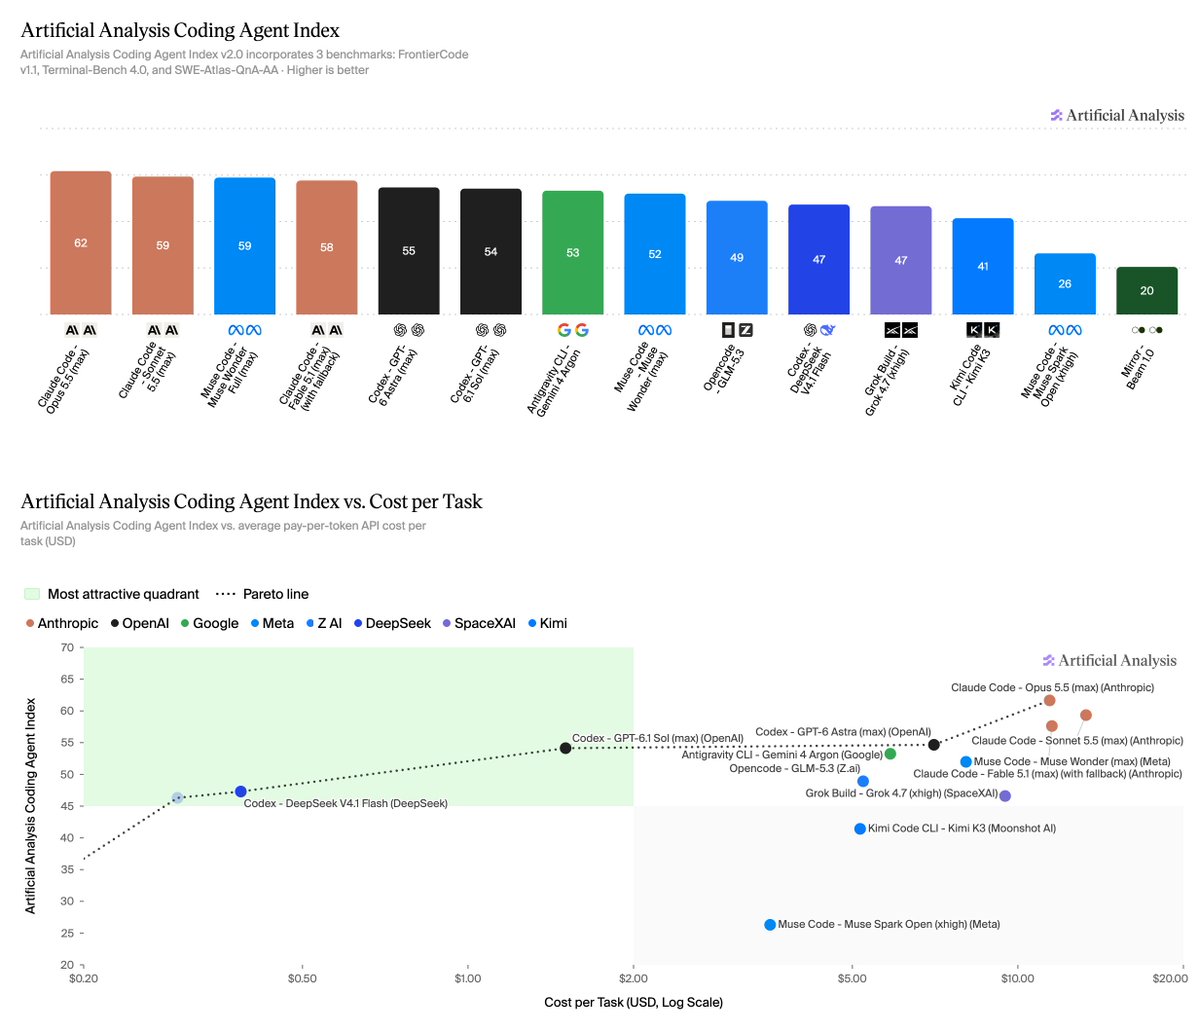
Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

Artificial Analysis 于 2026-10-23 发布 Coding Agent Index v2.0,评测对象是「模型 + Agent 外壳」的组合,覆盖 290 道任务,三项基准等权:Cognition 的 FrontierCode v1.1(100 道真实开源仓库任务,按维护者是否会合并打分)取代 DeepSWE v1.1,SWE-Atlas-QnA 改为评分更严格的 SWE-Atlas-QnA-AA,Terminal-Bench 4.0 不变。Claude Code + Claude Opus 5.5(max)以 61.7 分居首,Sonnet 5.5 59.3、Muse Wonder Full 58.9 紧随。新版整体分数下降:21 个两版都测过的配置平均分从 54.8 降到 47.4。

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

核心要点速览

  • 榜首:Claude Code + Claude Opus 5.5(max)61.7,Claude Sonnet 5.5(max)59.3,Muse Code + Muse Wonder Full(max)58.9,Claude Fable 5.1(max with fallback)57.6(Artificial Analysis 口径)
  • FrontierCode v1.1 上 Opus 5.5 拿到 56.0%,领先 Codex + DeepSeek V4.1 Flash 的 52.6%;24 个配置中有 15 个挤在 43%–49%
  • 新旧版对比:21 个配置平均分 54.8 → 47.4,其中 20 个下降;同一批配置 FrontierCode 平均 45.1%,DeepSWE 为 65.6%
  • 成本前沿四个点:DeepSeek V4.1 Flash 47.3 分 $0.39/任务、GPT-6.1 Sol 54.1 分 $1.50、GPT-6 Astra 54.7 分 $7.04、Opus 5.5 61.7 分 $11.42(按 API 按量计费,不是订阅价)
  • SWE-Atlas-QnA-AA 改写了 1,306 条评分细则中的 127 条,裁判换成 GPT-6 Luna(xhigh)每条 5 票,数据集和裁判配置已在 Hugging Face 公开
阅读全文

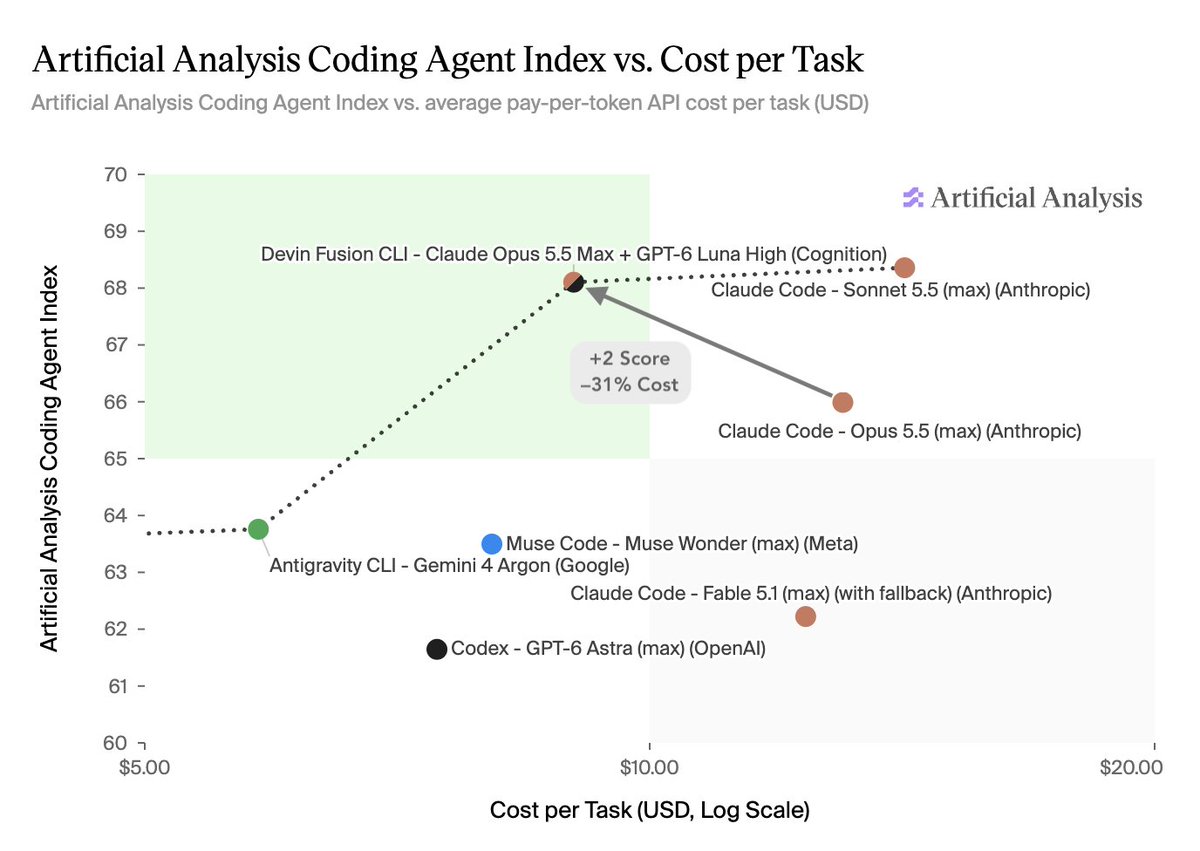
Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文

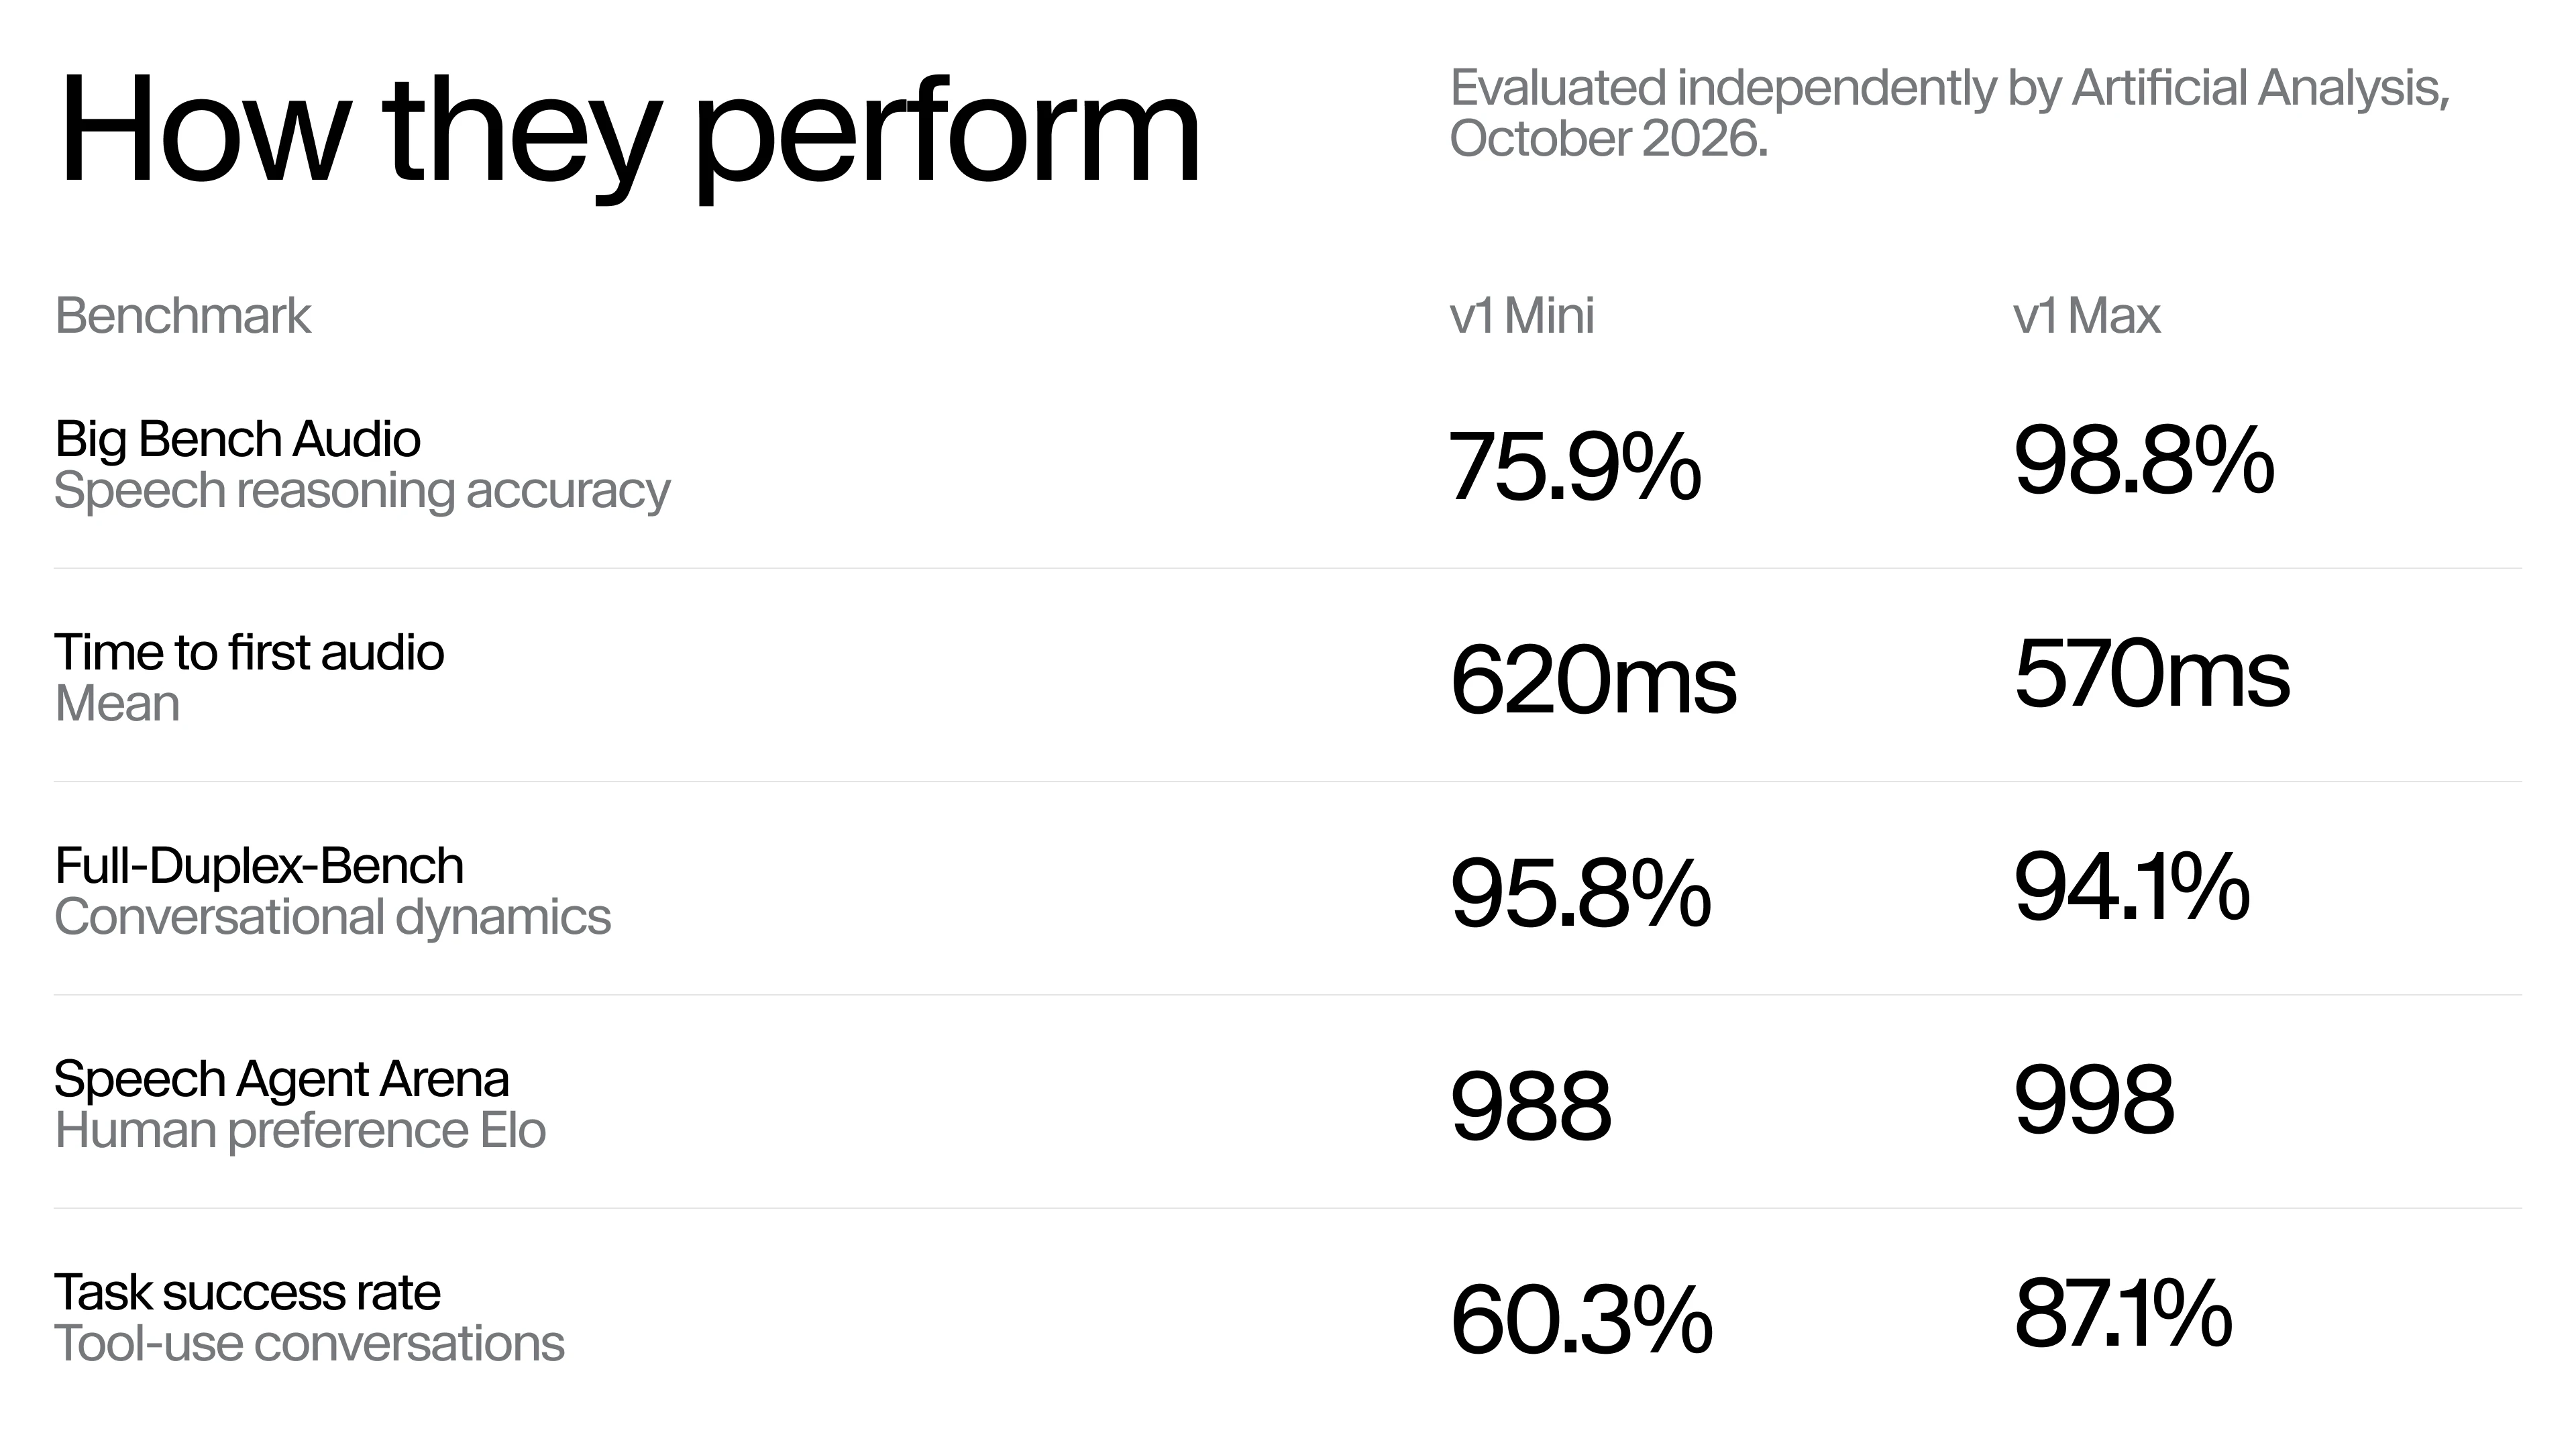
ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

核心要点速览

  • 语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
  • 速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
  • 对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
  • 工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
  • 覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Eleven Realtime v1 Mini⚡ Eleven Realtime v1 Max🤖 ElevenAgents🌐 ElevenLabs🌐 Artificial Analysis

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

Cognition 10 月 19 日宣布,Devin Fusion 用 Claude Opus 5.5 做主控(lead)、GPT-6 Luna 做执行助手(sidekick)的组合,在 Artificial Analysis Coding Agent Index v1.5 拿到 68.1 分。按 Artificial Analysis 网站当前数据,这一分数位列榜首,但只比第二名 Muse Code + Muse Wonder Full(68.0)高 0.1 分,基本并列;第三名 Antigravity CLI + Gemini 4 Argon 为 63.8。Cognition 称该组合每任务成本比 Claude Code 搭配 Opus 5.5 低 31%(厂商口径)。Fusion 已在 Devin CLI 和桌面版提供。

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

核心要点速览

  • 总分 68.1:DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1,三项等权(Artificial Analysis 数据)。
  • 与第二名 Muse Code + Muse Wonder Full(68.0)只差 0.1 分;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。
  • 成本:Cognition 称比 Claude Code + Opus 5.5 每任务低 31%(厂商口径)。
  • 此前 Fusion 搭配 Fable 5.1 + SWE-2 在 DeepSWE 1.1 上把单任务成本从 14.63 美元降到 7.88 美元(−46%),得分 64.3→63.1。
  • 官方推荐组合为 Opus 5.5 + GPT-6 Luna,安装 Devin CLI 即可使用。
阅读全文