AI 编程实时动态与要闻

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

11 月 12 日(UTC),获 Felicis 和英伟达投资的电脑操作智能体公司 Simular 发布 box:每个账号一台云端 Ubuntu 桌面,自带 Chrome 和常驻 shell,整体作为一个远程 MCP 服务器(mcp.box.simular.ai/mcp,Streamable HTTP,OAuth 登录)提供。claude.ai、ChatGPT、Gemini、Claude Code、Codex、Cursor、OpenCode、VS Code 等任何 MCP 客户端都能接入,不同助手可以在同一台机器上接力干活,共享登录状态和文件。用户可在网页或 iPhone 上实时观看,需要登录或付款确认时随时接管。桌面本身免费,模型调用消耗账号积分;空闲时休眠、约 1 秒唤醒,连续休眠 14 天会被删除。发布视频浏览量超过 81 万。官方称「生产环境最快的电脑操作」,但未公布跑分。
Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

核心要点速览

  • 接入方式:一个远程 MCP 地址 mcp.box.simular.ai/mcp,OAuth 登录;Claude Code 一行 claude mcp add --transport http box ... 即可,CI 场景可用 cb_ 开头的个人密钥
  • 安装器 npx @simular-ai/[email protected] connect 会自动发现本机的 Claude Code、Codex、Cursor、OpenCode、Hermes、OpenClaw、VS Code 并写入配置,doctor/remove 可检查和撤销
  • 计费:桌面免费,模型调用用账号积分;空闲约 1 秒唤醒,连续休眠 14 天删除整台机器和文件
  • Secrets 功能:API 密钥加密存储,AI 只看到替身值,box 仅在发往指定域名的请求里替换成真实密钥
  • 官方发布视频约 81.5 万浏览;「最快电脑操作」为厂商口径,官方未公布 OSWorld 等跑分
阅读全文

Cua 联合 Scale AI 发布 Cua Driver Bench:评测后台桌面 Agent 是否打扰用户,macOS 厂商口径 cua-driver 全通过率约 58%

2026-11-06,Cua(@trycua)与 Scale AI AgentEnv 联合发布 Cua Driver Bench(Bench v2):固定 Claude Sonnet 5.5 与任务,只换 computer-use driver,考核任务完成、仅 GUI、以及 8 项「用户未被打扰」。Scale 口径 macOS 后台全通过:cua-driver 约 58%(23/40)、agent-desktop 约 20%、browser-use 约 3%;Cua 自跑 Codex Computer Use 约 33%。任务与轨迹公开可复跑。

Cua 联合 Scale AI 发布 Cua Driver Bench:评测后台桌面 Agent 是否打扰用户,macOS 厂商口径 cua-driver 全通过率约 58%

核心要点速览

  • 来源:Cua 官方博客 + @trycua 线程 2026-11-06;Scale 独立跑 macOS/Linux,Cua 自跑 Windows 与部分对照
  • 方法:10 项 Bench v2;后台有模拟用户持续打字;全通过=任务完成+仅 GUI+用户 8 项不被打扰
  • macOS 后台全通过(Scale,厂商口径):cua-driver 58%、agent-desktop 20%、browser-use 3%;Codex CU(Cua 跑)33%
  • 前台对照(Scale):cua-driver 约 78%、agent-desktop 70%、browser-use 64%;差距主要来自打扰
  • 落地:GitHub blog 与 libs/cua-driver-bench;HF Space/数据集 earakely-scale/CuaDriverBench-AgentEnv
阅读全文

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

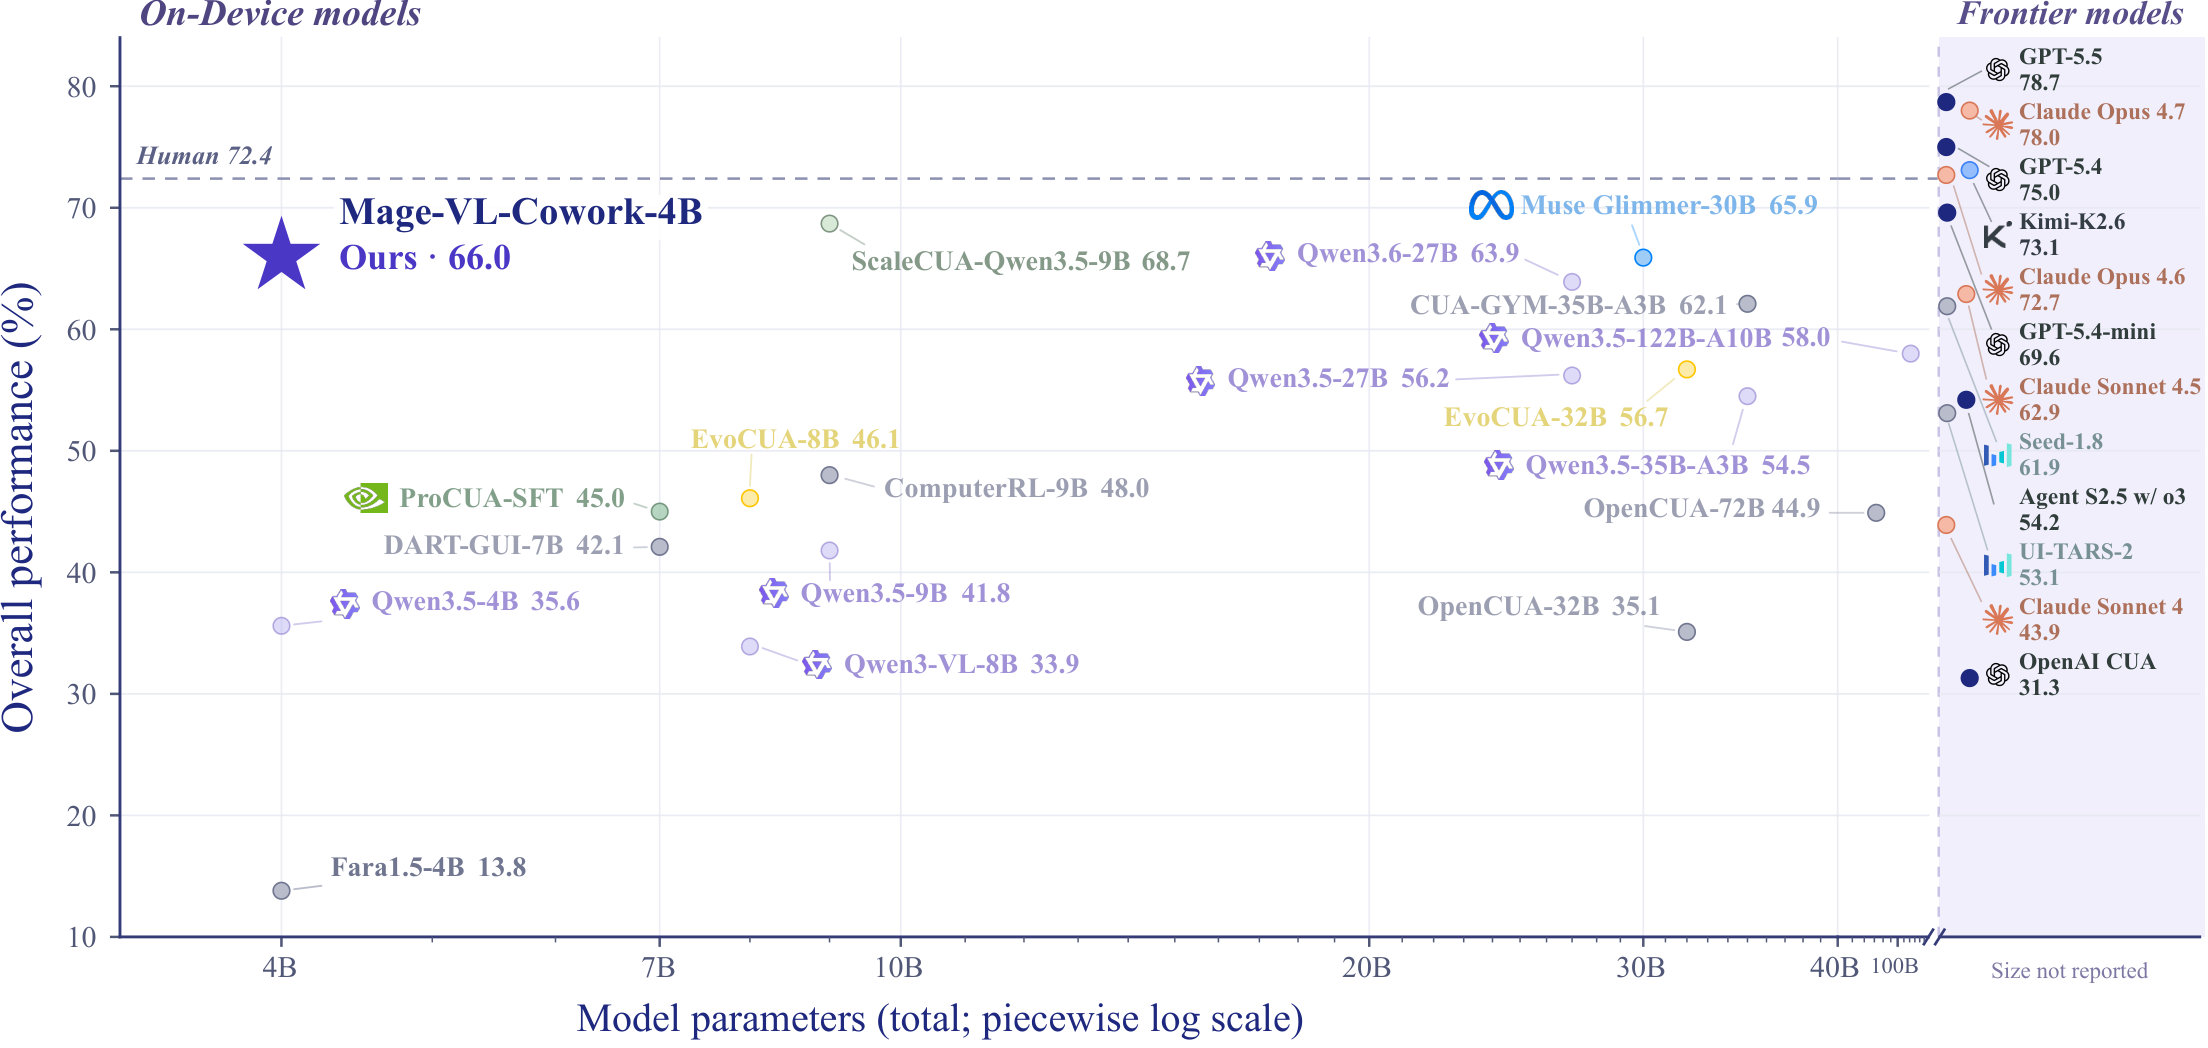
微软 Mage 团队 10 月 30 日在 Hugging Face 以 Apache-2.0 发布 Mage-VL-Cowork:4B 参数的多模态电脑操作智能体,同一个模型每一步自己选择用截图点界面(computer_use)还是在终端跑 bash/Python,不需要外部调度器。官方报告它在 OSWorld-Verified(361 题、50 步上限)两次平均 66.0%,高于 Qwen3.6-27B 的 63.9%,但仍低于 9B 的 SCALECUA-Qwen3.5-9B(68.7%)。

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

核心要点速览

  • 4B 参数,基于 Mage-VL(Mage-ViT 视觉编码器 + Qwen3-4B-Instruct-2507),bf16 权重约 9.48 GB,Apache-2.0 许可。
  • OSWorld-Verified 两次独立跑分 65.33% 和 66.75%,取平均 66.0%;操作系统类任务 87.5%,多应用工作流 62.7%。
  • 官方对比:同一个 LibreOffice Calc 建图表任务,它用终端里的 Python 改表格 39 秒完成(6 步),纯界面操作的 Qwen3.6-27B 用了 9 分 56 秒(39 步)。
  • 在线 RL 比混合 SFT 再提升 10.16 个百分点,同时平均模型调用次数减少 13.0%、输出 token 减少 25.4%。
  • 训练数据由 Mage-CUA-Forge 生成约 29.4 万个桌面和网页任务,覆盖 6,915 种技能,单任务生成成本从 0.906 美元降到 0.158 美元。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mage-VL-Cowork⚡ Mage-VL⚡ Qwen3-4B⚡ Qwen3.6-27B🌐 Microsoft

微软亚研院开源 WildAWM:野外环境通用智能体世界模型,重构 GUI 与网页端到端仿真底座

微软亚洲研究院(MSRA)研究团队在 arXiv:2610.26828 正式发布并开源通用智能体世界模型 WildAWM(MSR-Orchard/WildAWM)。针对当前跨平台 GUI 与网页浏览智能体(Computer-Use Agents)在训练和评测中高度依赖昂贵、慢速且不可撤销的真实物理沙盒环境的痛点,WildAWM 首创可适应野外复杂异构环境的多模态自回归世界模型架构。模型能够在接收任意智能体动作(点击、输入、滚动)后,极其逼真地预测网页与桌面操作系统下一帧的高保真视觉状态演化与 DOM 结构变化,成功替代物理沙盒,为大规模自主智能体的离线强化学习与安全预演树立了全新基座。

微软亚研院开源 WildAWM:野外环境通用智能体世界模型,重构 GUI 与网页端到端仿真底座

核心要点速览

  • 微软亚研院在 arXiv:2610.26828 开源 WildAWM,首创面向真实野外复杂环境(桌面/Web)的智能体世界模型
  • 彻底破解 GUI 智能体训练依赖真实物理服务器与网页环境造成的昂贵算力开销和状态破坏风险
  • 基于动作条件(Action-Conditioned)的多模态自回归架构,精准仿真点击、键盘输入与长页面滚动后的视觉响应
  • 在跨电商、CRM 与操作系统多项仿真一致性评测中大幅超越传统离散状态转移模型,全面开源代码与权重
阅读全文
AD赞助内容

阿里通义实验室开源 OpenGCUA:通用计算机控制智能体全开源技术栈,OSWorld 步数锐减 53%

阿里巴巴通义实验室(Tongyi-MAI)在 arXiv:2610.22200 正式发布并全面开源 OpenGCUA(Open Generalist Computer-Use Agent)通用计算机控制智能体技术栈。针对当前 GUI 智能体过度依赖逐帧截图与单点点击、无法执行高效批处理操作的行业痛点,OpenGCUA 首创“代码执行即行动(Code-Execution-as-Action)”范式,将视觉感知、可访问性树(Accessibility Tree)、Bash 脚本与 Playwright API 深度融合。在权威 OSWorld-v2 基准测试中,OpenGCUA 推动各大主流前沿模型平均得分大幅提升 19.6 分,同时将任务完成平均步数削减 53.0%,并配套开源了 macOS 实体机状态栏应用与跨设备 SDK。

阿里通义实验室开源 OpenGCUA:通用计算机控制智能体全开源技术栈,OSWorld 步数锐减 53%

核心要点速览

  • 阿里通义开源 OpenGCUA 全技术栈,收录于 arXiv:2610.22200,代码采用 Apache 2.0 协议全面开源
  • 提出“代码执行即行动”机制,将多轮循环点击转化为包含条件分支、循环与 API 调用的聚合 Python/Bash 脚本
  • 在权威 OSWorld-v2 基准测试中,推动跨 8 大前沿模型平均基准分提升 +19.6 分,平均执行步数削减 53.0%
  • 开源发布 macOS 物理设备状态栏调度 Harness 及连接 PC、浏览器与移动端的 Cross-Device SDK
阅读全文

智能体自主进化接口突破:Evolving Agent Interfaces 框架让 CUA 自行构建 API,任务成功率大幅提升

多所顶尖高校与科研团队在 arXiv:2610.28601 中提出突破性计算机使用智能体(CUA)自我演化架构 Evolving Agent Interfaces 与 Agent S4。传统 CUA 往往被严重限制在人类设计的低效图形界面中(如通过鼠标逐格点击电子表格),导致长程任务步骤冗长且极易因微小误触失败。该框架打破固定接口束缚,赋予元智能体(Meta-Agent)在任务执行中根据运行环境与需求,自主编写、测试并动态演化专属编程 API 与专用代码仓库的能力。在最具挑战的 OSWorld V2 与 ScienceBoard 权威基准上,该方法使 27B 开源模型成功率从 55.03% 跃升至 58.58%(净多解决 6 项核心任务),以极小开销逼近商业前沿旗舰模型。

智能体自主进化接口突破:Evolving Agent Interfaces 框架让 CUA 自行构建 API,任务成功率大幅提升

核心要点速览

  • 研究团队在 arXiv:2610.28601 中发布 Evolving Agent Interfaces 框架,终结 CUA 只能机械模拟人类鼠标键盘操作的旧时代
  • 元智能体(Meta-Agent)可在沙盒环境中实时探测运行软件,自主编写专属 Python 库、脚本与命令行 API 替代繁琐 GUI 交互
  • 在权威桌面智能体评测集 OSWorld V2 与 ScienceBoard 上,使 27B 开源模型任务成功率从 55.03% 飙升至 58.58%
  • 长程复杂任务的操作步骤与 Token 消耗大幅缩减,为通用操作系统级自主 Agent 奠定了自进化接口基础设施
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

Perplexity 官方正式宣布将 Perplexity Computer 功能原生集成至 macOS 客户端应用中。与此前高度依赖云端传输屏幕截图并接收键盘鼠标动作指令的传统 Computer-Use 方案不同,Perplexity Computer 实现了模型与智能体执行回路的全本地化运行(The model and the agent both run on your Mac)。通过深度调用 macOS 原生辅助功能(Accessibility API)与本地端侧轻量多模态模型,该功能消除了云端网络延迟,并在彻底保护用户屏幕隐私的前提下,赋能智能体在用户桌面上全自主操作本地应用、整理文件与执行跨软件复杂工作流。

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

核心要点速览

  • Perplexity 官方正式在 macOS 客户端推出 Perplexity Computer,实现模型推理与智能体循环全本地运行
  • 彻底打破传统云端 GUI Agent 的隐私隐患,屏幕画面与按键事件无需上传服务器,100% 杜绝敏感数据外泄
  • 零云端往返时延(Zero Cloud RTT),利用 Apple Silicon 统一内存与硬件神经引擎,实现极速桌面响应
  • 深度结合 macOS 原生无障碍体系与应用沙盒,支持跨终端、浏览器与本地开发套件的端到端自动化编排
阅读全文
关联模型 / 智能体 / 厂商:

让大模型从“逐步苦力”变“并行总审”!SpecAgent 轨迹级投机推理耗时砍半,LEASH 隐状态升级在 OSWorld 击败全程 Claude Opus 5

为终结智能体每一步都调用昂贵旗舰大模型的算力浪费,今日两项重磅研究分别从‘轨迹级投机验证’与‘隐状态不确定性升级’实现突破:LARK AI Lab 开源的 SpecAgent(arXiv:2610.21463)让轻量小模型连续起草并执行只读工具调用(遇到首个写操作时暂停),再由大模型通过单次并行 Prefill 批量做语义审查与局部修复,在 τ²-Bench 上逼近大模型原版成功率的同时将显存流量与端到端耗时直接砍半;而 LEASH(arXiv:2610.22280)零额外前向开销复用隐状态不确定性动态移交控制权,搭载 Qwen3.5-35B-A3B 在 OSWorld 上以 73.66% 成功率反超全程调用的 Claude Opus 5(72.90%),同时节省 19.2% 成本。

让大模型从“逐步苦力”变“并行总审”!SpecAgent 轨迹级投机推理耗时砍半,LEASH 隐状态升级在 OSWorld 击败全程 Claude Opus 5

核心要点速览

  • SpecAgent 首创轨迹级投机推理:小模型真实执行连续只读工具并在写操作前暂停,强模型仅用单次并行 Prefill 完成批量语义验证
  • 端到端耗时与显存流量双双砍半:在 τ²-Bench 上逼近强模型成功率(差距 <1 分)同时省去 50% 耗时,MCP-Atlas 强模型生成 Token 减半
  • LEASH 零额外开销隐状态升级:基于 Qwen3.5-35B-A3B 在 OSWorld 斩获 73.66% 成功率,反超全程调用的 Claude Opus 5(72.90%)并降本 19.2%
阅读全文

阿里通义 MAI 开源通用计算机操作全栈 OpenGCUA 与 MAI-Gym:OSWorld-v2 暴涨 19.6 分、步数锐减 53%

针对闭源通用计算机操作智能体(如 GPT-6 Astra Computer Use)难以系统研究与复现的痛点,阿里通义 MAI 团队重磅连发两项开源工程:全栈通用计算机使用框架 OpenGCUA(arXiv:2610.22200)与支持 2 万并发实例的在线强化学习平台 MAI-Gym(arXiv:2610.20939)。OpenGCUA 融合视觉 GUI 与程序化代码执行,在 OSWorld-v2 上使包括 GPT-6 Astra 与 Claude Opus 5 在内的全部 8 款模型平均提分 19.6 分、执行步数减少 53.0%;MAI-Gym 训练出的 9B 模型更在 MobileWorld(78.4%)与 OSWorld-Verified(76.2%)创下 10B 内开源 SOTA。

阿里通义 MAI 开源通用计算机操作全栈 OpenGCUA 与 MAI-Gym:OSWorld-v2 暴涨 19.6 分、步数锐减 53%

核心要点速览

  • 开源通用计算机操作全栈 OpenGCUA:融合 GUI 视觉交互与代码执行,在 OSWorld-v2 上使 GPT-6 Astra 与 Claude Opus 5 等 8 款模型平均提分 19.6 分、步数锐减 53.0%
  • 揭示真机 Token 效率代差:在真实 macOS 任务测试中,发现 Qwen3.8-Max 消耗的推理 Token 数高达 GPT-6 Astra 的 19.4 倍
  • MAI-Gym 支撑 2 万并发实例在线 RL:训练出 MAI-Gym-9B 斩获 MobileWorld 78.4% 与 OSWorld-Verified 76.2%,且仿真训练迁移至真机购票成功率从 28.8% 跃升至 48.1%
阅读全文

GUI-Decisions 开源:用「槽位读概率」替代坐标 JSON 解码,Computer-Use 单步提速约 3×(31B / 2B)

作者 Logesh Kumar Umapathi 于 2026-10-10 在 Hugging Face 博客发布 GUI-Decisions:把 computer-use 的 action/坐标写成固定槽位,从下一 token 分布一次性读出,而不是自回归解码 JSON。基于 Gemma 4 31B 的 LoRA/合并权重在 RTX PRO 6000 + vLLM 上,槽位读中位约 146–158 ms/步,相对原生生 JSON 约 472–546 ms 约 3.5×;相对带思考解码可快约 20–25×。ScreenSpot 点击命中约 0.87;开源 31B/2B 权重、GitHub 与 Spaces Demo。

GUI-Decisions 开源:用「槽位读概率」替代坐标 JSON 解码,Computer-Use 单步提速约 3×(31B / 2B)

核心要点速览

  • 官方:HF Blog(2026-10-10);代码 infinitylogesh/gui-decisions;Demo Spaces
  • 延迟(厂商口径,RTX PRO 6000,冷截图):槽位读 ~146 ms vs 原生 JSON 472–546 ms(约 3.5×);带 thinking 2.6–3.1 s(约 20–25×)
  • 精度:ScreenSpot 点击命中约 0.869(合并 31B);held-out AGUVIS computer-use 约 0.65;RefCOCO val 框 IoU 0.770
  • 机制:256 bin「字节」标签读坐标;动作决定后再读所需槽;type/answer 仍需基座解码——槽位只加速 grounding
  • 开箱:vllm serve infinitylogesh/GUI-Decisions-31B --max-logprobs 300 --api-server-count 8 + SlotModel.decide(img, instruction)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GUI-Decisions-31B⚡ GUI-Decisions-2B⚡ Gemma-4-31B🤖 computer-use🤖 GUI agent🌐 Hugging Face🌐 Google
AD赞助内容

Claude Python/TypeScript SDK 内置电脑操作与浏览器操作工具集:SDK 代跑 Agent 循环,开发者只需实现驱动

Anthropic 在 anthropic Python SDK 1.12.0 与 TypeScript SDK 0.132.0 中加入 computer_toolset_20260801 与 browser_toolset_20260801:一个 tools[] 条目即可声明整组桌面或浏览器动作,SDK 的 tool_runner 负责循环执行、按序停在首个失败动作,并在调用前跑 url_policy、file_policy 与 confirm 钩子。开发者不再手写“点击/键入映射命令”的循环,只需继承抽象类接入自己的 VNC、DevTools 或托管浏览器。

Claude Python/TypeScript SDK 内置电脑操作与浏览器操作工具集:SDK 代跑 Agent 循环,开发者只需实现驱动

核心要点速览

  • 版本:Python anthropic 1.12.0、TypeScript SDK 0.132.0(2026-10-07)同步上线 computer / browser 工具集类型化调用
  • 电脑工具集覆盖 17 个动作(screenshot、left_click、type、scroll、zoom 等),未实现的动作以 enabled: false 发给 API(文档)
  • 浏览器工具集含 navigate、多标签、read_page、read_network、form_input、file_upload 等成员,导航前强制经过 url_policy(文档)
  • 官方安全清单 7 条:URL 策略、请求拦截、容器出网白名单、文件策略、confirm 人工确认、单会话隔离、页面内容一律不可信
  • ClaudeDevs 公告获 3,500+ 赞、24.8 万次浏览;官方未公布新的跑分数据
阅读全文

OpenAI 联手 Ironclad 用强化学习训练 GPT-6 Astra 操作专业软件:合同工作流得分 55.0%(Sol 41.6%),单次耗时减半

OpenAI 公布首个“垂直 SaaS 共建”计算机操作研究:与合同平台 Ironclad 共同定义 11 个法务/采购/商务任务,在 Ironclad 托管环境里用 RL 训练 GPT-6 Astra。Astra 平均 rubric 得分 55.0%(GPT-5.6 Sol 41.6%),估算单次耗时 19.2 分钟 vs 37.0 分钟;内部模型已达 63.7%。OpenAI 同时开放软件公司申请合作。

OpenAI 联手 Ironclad 用强化学习训练 GPT-6 Astra 操作专业软件:合同工作流得分 55.0%(Sol 41.6%),单次耗时减半

核心要点速览

  • 11 个真实合同任务、每个 8–50 条评分标准;资深用户人工约需 30–40 分钟/任务(OpenAI 原文)
  • GPT-6 Astra(Max 推理)平均得分 55.0%,GPT-5.6 Sol(High 推理)41.6%,相对提升约 32%
  • 估算单次耗时 37.0 → 19.2 分钟(约 -48%);注意这是按模型速度模拟的时间,不是客户实测节省
  • 演示任务中 Astra 约 20 分钟满足 ~94% 标准,Sol 约 32 分钟满足 ~85%;内部研发模型已到 63.7%
  • 训练数据来自 SEC EDGAR 公开合同并去除个人信息,未用 OpenAI 或 Ironclad 客户数据
阅读全文

解决桌面多窗口视觉死穴!苏黎世联邦理工等开源 DeskForge:1.2M 密集多模态轨迹,Qwen3.5-4B 零样本定位大涨 11.5%

随着 Anthropic Computer Use 与各种操作系统智能体(OS Agents)进入桌面工作流,如何在多应用层叠、分辨率各异以及同质化按钮混淆的复杂真实桌面场景中精准定位可操作控件,成为制约智能体长程作业的核心瓶颈。现有 GUI 训练数据缺乏受控的环境状态演化与细粒度像素级密集标注。为此,苏黎世联邦理工学院(ETH Zurich)与 IBM Research 联合推出可控桌面数据生成系统 DeskForge(arXiv:2610.02320)。该系统通过在可控沙盒中动态编排真实桌面应用,实时融合系统截图、无障碍辅助树(Accessibility Tree)与窗口几何坐标,构建了涵盖 120 万密集桌面交互观测与 1.597 亿控件实例的超大规模数据集 DeskForge-1M。在仅使用其中 20 万样本微调后,Qwen3.5-4B 等视觉语言模型在 ScreenSpot-Pro 上的定位准确率暴涨 11.51 个百分点,在 OSWorld-G 上提升 10.11 个百分点;在长流程真实任务测试中,WebArena-Infinity 通关数由 31 跃升至 50,OpenApps 成功率翻了 5 倍。项目主页与数据集已全面开放(saidgurbuz.github.io/deskforge)。

核心要点速览

  • ETH Zurich 与 IBM 推出可控桌面数据生成系统 DeskForge,融合截图、辅助树与窗口几何生成 1.2M 观测与 1.597 亿控件实例
  • 仅用 20 万样本微调即让 Qwen3.5-4B 在 ScreenSpot-Pro 准确率暴涨 11.51%、OSWorld-G 攀升 10.11%,5 大基准全面超越基线
  • 长程任务完成能力翻倍突破:WebArena-Infinity 通关数由 31 升至 50,企业级 OpenApps 任务成功率暴涨 5 倍,权重与数据全开源
阅读全文
关联模型 / 智能体 / 厂商:

告别盲盒式终态测试!NVIDIA 推出 OSWorld-Pro:首创桌面智能体全流程评测,Claude Opus 5 仅获 75.7%

随着 Anthropic Computer Use 与各类桌面自动化智能体(Computer-Use Agents, CUAs)加速接管操作系统操作,如何科学评估多步骤 GUI 交互的真实能力成为业界最急迫的命题。现有的代表性基准(如 OSWorld)主要依赖最终结果判定(Outcome-based Verification),即在 Agent 执行了数百步鼠标键盘操作后,仅检测最终文件或系统状态是否发生改变。这种“黑盒终态评估”完全掩盖了智能体在中间步骤中“如何犯错”与“为何失败”——例如因键盘输入打字错误失败,与因视觉定位不准导致鼠标误点失败,所需要的工程修复路径完全风马牛不相及。NVIDIA 研究团队推出了首个基于全流程过程解构的桌面智能体评测系统 OSWorld-Pro(arXiv:2609.24890):包含 300 多个真实系统级生产任务,将其细粒度拆解为 2,800 多个连续依赖的子目标(Subgoals),并依托 67,000 多条高质量人类专家操作注释作为基准。通过人类对齐的 LLM-Judge 对各阶段子目标达成度展开逐层量化,评测揭示即便是业界最前沿模型如 Claude Opus 5 在 OSWorld-Pro 上的得分也仅为 75.7%(低于标准 OSWorld 的 83.4%),并精准捕获了无效漫游动作与点击像素级偏移两大核心故障模式。

告别盲盒式终态测试!NVIDIA 推出 OSWorld-Pro:首创桌面智能体全流程评测,Claude Opus 5 仅获 75.7%

核心要点速览

  • NVIDIA 推出首个基于全流程解构的桌面智能体评测系统 OSWorld-Pro,拆解 300+ 任务为 2,800+ 细粒度子目标
  • 依托 67,000+ 人类专家密集注释,揭露顶尖模型 Claude Opus 5 得分仅 75.7%(低于标准 OSWorld 的 83.4%)
  • 精确定位无效漫游与鼠标像素级点击偏移两大核心死穴,彻底终结桌面智能体盲盒式终态测试
阅读全文
A
AICoder Editorial@aicoder·
👀81
🔥90

一周内 AI 编程「A vs B」选型热度飙升:Sonnet 5.5、Sol、Argon、Air、Copilot Computer Use 同窗对决

过去约 7 天,Claude Sonnet 5.5、GPT-6.1 Sol、Gemini 4 Argon、JetBrains Air in IDEs EAP、GitHub Copilot Computer Use 同窗落地;开发者检索与 HN 讨论从「单点追新」转向价格带、终端 Agent、IDE 编排与 Computer Use 的成对选型。本稿为元/行业综述,不含 X 推文依赖。

核心要点速览

  • 同窗发布:Sonnet 5.5 入 Copilot(09-28)→ Sol 入 Copilot(09-29)→ Argon Fairwind 预览(09-30)→ Air EAP + Copilot Computer Use(10-01)
  • 高频成对意图:Sonnet↔Opus、Sonnet↔Sol、Argon↔Opus/Astra、Air↔Cursor、Copilot CU↔Claude CU、Codex↔Claude Code、Sol↔Astra(同族升级经济学)
  • 选型轴:价格带(Sol≈Astra 智能力、约 1/5 token 价;Sonnet 日常 vs Opus 复杂判断)× 终端 harness(Codex vs Claude Code)× IDE 编排(Air ACP BYO)× Computer Use(GUI 遗留补位)
  • 合规坑:HN Air 帖讨论 Anthropic 订阅鉴权 ToS;Air 官方称 Claude 订阅可走终端全屏 Tab,聊天面 Claude Agent 仍需 JetBrains AI / API Key
  • Argon 仍非 GA:仅 Fairwind 可信网络防御方 + Google 内部;开发者/企业开放时间表未公布——对比页请标注预览门控
阅读全文