AI 编程实时动态与要闻

Cognition 推出 Devin Apps:让 Devin 直接在自己的云端机器上搭建并托管内部工具,私有可分享、地址固定,按机器唤醒时长计费

11 月 13 日,Cognition 发布 Devin Apps:用户描述需要的工具,Devin 在会话里把它做成网页应用,并直接从自己的云端机器上提供服务,不部署到第三方托管平台。每个 App 有固定地址(name--id.preview.devinapps.com),访问者必须登录 Devin,永不公开,可按个人、组织或企业分享。App 能用任何技术栈,复用已接入的 MCP、集成和代码库,数据(如 SQLite、Postgres)留在同一台机器上。机器无人访问 5 分钟后休眠,有人打开时唤醒,按唤醒时长计费,搭建和修改按普通会话计费。每次更新都是带 commit 的新版本,新版启动失败时旧版继续服务。功能正在逐步开放。
Cognition 推出 Devin Apps:让 Devin 直接在自己的云端机器上搭建并托管内部工具,私有可分享、地址固定,按机器唤醒时长计费

核心要点速览

  • 托管位置:App 运行在 Devin 自己的云端机器上,不部署到第三方平台,数据和上传文件都留在这台机器
  • 地址固定:形如 name--id.preview.devinapps.com,改名、更新都不变;访问者必须登录 Devin,永不公开
  • 计费:无人访问 5 分钟后休眠、按唤醒时长计费,休眠首次打开需几秒;搭建和修改按普通会话计费
  • 版本管理:每次部署前先 git commit,新版本启动失败时旧版本继续服务,可让会话回滚到任一旧版
  • 适用场景:内部工具、仪表盘、预发布环境、演示原型;功能逐步开放,官方未公布具体单价
阅读全文
关联模型 / 智能体 / 厂商:

Cognition 升级 Devin Teams 套餐:Devin Desktop 不再按席位收费,每人送 2 个并发 SWE-2 免费会话,新增 SSO、按人分档用量上限和标准 BAA,席位上限降到 100

11 月 12 日,Cognition 宣布升级 Devin Teams 套餐:团队所有人都能用新版 Devin Desktop,不再为席位额外付费;新增 Free 模式,每位用户有 2 个由自研模型 SWE-2 驱动的并发免费会话,Desktop 和 CLI 里的免费 SWE-2 也成为 Teams、Pro、Max 套餐的长期权益。管理员可接入 Okta、Entra ID 等 SAML/OIDC 单点登录,按人或按组设置最多 3 档用量上限,并可在设置里申请标准 BAA。同时,Teams 的配额席位 30 天后取消,席位上限从 200 降到 100。

Cognition 升级 Devin Teams 套餐:Devin Desktop 不再按席位收费,每人送 2 个并发 SWE-2 免费会话,新增 SSO、按人分档用量上限和标准 BAA,席位上限降到 100

核心要点速览

  • Desktop 免席位费:团队所有成员都能用新版 Devin Desktop,不再单独购买 Desktop 席位
  • 免费 SWE-2:Free 模式下每人 2 个并发免费会话,可付费加购;Desktop 与 CLI 的免费 SWE-2 成为 Teams、Pro、Max 的长期权益。官方称 SWE-2 接近前沿模型、成本只是零头(未给具体跑分)
  • 管理控制:SSO 支持 Okta、Microsoft Entra ID 及任意 SAML/OIDC,接入后可关闭邮箱登录;用量上限按人或按组设置,最多 3 档,超额申请可人工审批或在上限内自动批准
  • 合规:Teams 客户可在设置中申请标准 BAA(医疗数据所需),无需签企业合同
  • 变化:配额席位 30 天后取消,Teams 席位上限从 200 降到 100;初创计划最高提供 6.5 万美元额度
阅读全文
关联模型 / 智能体 / 厂商:

Cognition 发布 Devin Review 2.0:自 8 月起单次 PR 审查成本降约 82%(约 5×)、中位延迟约 94 秒,并强化自动审查与 Autofix

Cognition 于 11 月 5 日发布 Devin Review 2.0:自 8 月起单次 PR 审查成本下降约 82%,典型成本约 $0.25–$0.75,中位延迟约 94 秒(此前约 139 秒)。支持自动审查、增量复审、可配置花费上限;与 Devin 联用时可调查发现并决定修复、忽略或升级。新增 Devin Review Ultra 与 Custom Reviewers(beta)。

Cognition 发布 Devin Review 2.0:自 8 月起单次 PR 审查成本降约 82%(约 5×)、中位延迟约 94 秒,并强化自动审查与 Autofix

核心要点速览

  • 成本:自 8 月起单次 PR 审查成本降约 82%(约 5×);典型约 $0.25–$0.75;客户口径下修好一个 bug 约 $2.25(厂商)
  • 质量与速度:平均每 PR 发现 bug 数 1.22→1.32;中位延迟约 94 秒(约 1.5× 更快,此前约 139 秒)
  • 增量复审:默认只审变更部分;约 80% PR(含全部 push)审查总花费低于 $1;可设单 PR 花费上限
  • 闭环:与 Devin 联用时,Devin 可调查发现并选择修复、忽略或升级;Autofix 已在 Cloud/Desktop 可用
  • 控制:Devin Review Ultra 做更高成本更彻底审查;Custom Reviewers(beta)可用自定义指令跑专项检查
阅读全文
关联模型 / 智能体 / 厂商:

Cognition 发布 SWE-2 Flash:基于 Inkling-Small 的快速编码模型,200 tok/s、价格为 SWE-2 的五分之一

Cognition 于 11 月 4 日(UTC 19:55)发布 SWE-2 Flash。官方博客称它以 Thinking Machines 的 Inkling-Small(276B 总参、12B 激活)为底座,首次在强化学习前加入大规模中训练,把 FrontierCode 2.0 从 3.2% 提到 24.0%、Terminal-Bench 4.0 从 0.9% 提到 20.0%,自称超过所有美国开源权重模型。生成速度约 200 tok/s,价格为 SWE-2 的五分之一、速度为其 3 倍;本月底前对 Devin Desktop 和 CLI 的 Pro、Max、Teams 用户免费。权重暂不公开,将通过安全共享计划提供给合作方和研究者。

Cognition 发布 SWE-2 Flash:基于 Inkling-Small 的快速编码模型,200 tok/s、价格为 SWE-2 的五分之一

核心要点速览

  • SWE-2 Flash 底座为 Thinking Machines Inkling-Small,276B 总参、12B 激活,规模约为 SWE-2(2.8T-A104B)的十分之一。
  • 训练流程:先用数万亿 token 的科学文章、博客、代码等数据分三阶段中训练,再做大规模强化学习,重点提升 RL 任务质量和多样性。
  • 官方跑分:FrontierCode 2.0 24.0(SWE-2 为 23.8)、DeepSWE 1.1 60.1、Terminal-Bench 2.1 89.2、SWE-Bench Pro v2 Hard 89.9、Terminal-Bench 4.0 20.0。
  • 速度约 200 tok/s(SWE-2 约 60 tok/s),价格为 SWE-2 的五分之一;11 月底前 Devin Desktop/CLI 的 Pro、Max、Teams 用户免费。
  • 出于网络安全风险考虑,权重不直接开源,Cognition 将在未来几周公布安全权重访问计划的细节。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SWE-2 Flash⚡ SWE-2⚡ Inkling-Small🤖 Devin🌐 Cognition🌐 Thinking Machines
AD赞助内容

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

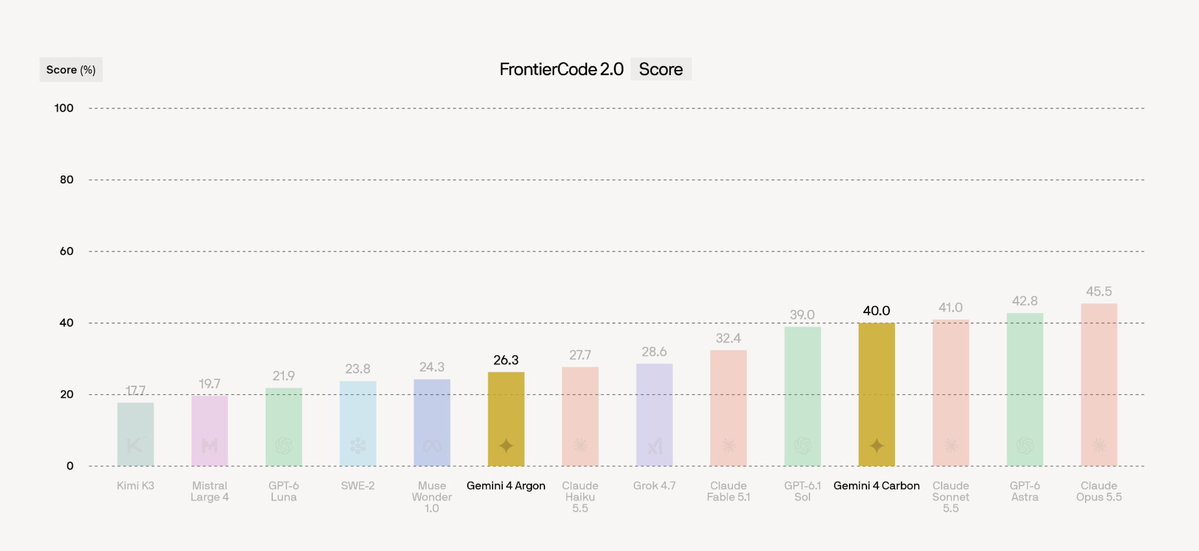
Devin 背后的 Cognition 于 10 月 30 日 01:45(UTC)在 X 上公布,Google 新模型 Gemini 4 Carbon 在其编程基准 FrontierCode 2.0 上得分 40%,每任务成本 4.04 美元,接近最高水平,仅次于 Claude Opus 5.5、GPT-6 Astra 和 Claude Sonnet 5.5。上一代 Gemini 4 Argon 得分 26.3%,每任务成本却更高,为 6.41 美元。成绩为 Cognition 自测口径,排行榜已在官网更新。

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

核心要点速览

  • Gemini 4 Carbon 在 FrontierCode 2.0 得分 40%,每任务 4.04 美元,排在 Claude Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Claude Sonnet 5.5 之后(原帖)
  • Gemini 4 Argon 得分 26.3%,每任务 6.41 美元,高于 Muse Wonder 1.0,但落后于 Claude Haiku 5.5 和 Grok 4.7
  • 从 Argon 到 Carbon,得分提高约 13.7 个百分点,每任务成本反而低约 2.4 美元
  • 官网更新日志显示 10 月 28 日已加入 Gemini 4 Carbon;FrontierCode 2.0 共 132 个任务,按维护者是否会合并打分(排行榜)
  • 所有数字均为 Cognition 自测口径,Google 未就此发布成绩
阅读全文

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

AI 编程 Agent 公司 Factory 10 月 29 日 22:31(UTC)在 X 和官方博客发布 Droid 1.0,称这是其 agent harness 迄今最大的一次更新。核心变化是把程序化工具调用(PTC)设为默认:模型写一段 JavaScript 脚本,在沙箱里一次跑完多达上百次工具调用。官方自测 Terminal-Bench 4 中,用 GPT-6.1 Sol 通过率 57.6%(每个通过任务 $0.79),用 Claude Opus 5.5 通过率 65.2%($4.73),均高于同模型下的 Codex、Claude Code、Cursor、OpenCode 和 Devin。

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

核心要点速览

  • 程序化工具调用成默认:模型写 JavaScript 脚本,在无文件/网络/系统权限的沙箱里运行,一次请求可跑上百次工具调用,互不依赖的调用并发执行
  • 官方示例:移动并核对 151 个 Linear issue 需 312 次工具调用,直接调用约 36 次请求、310 万输入 token,用 Script 只需 2 次请求、6.1 万 token
  • Terminal-Bench 4(Factory 自测,10 月 23–28 日,每任务 3 次):GPT-6.1 Sol 下 Droid 57.6% 对 Codex 54.0%、OpenCode 51.0%、Devin 45.0%;Opus 5.5 下 Droid 65.2% 对 Cursor/OpenCode 62.1%、Devin 59.6%、Claude Code 57.6%
  • 首轮请求从 20,887 降到 13,055 token(-37%),开局工具定义从 11 个减到 2 个;新加载的 MCP 工具追加到请求末尾,不破坏 prompt cache,生产中典型请求 98% 输入命中缓存
  • 已上线:macOS/Windows 桌面版、终端 TUI,以及 Droid SDK(@factory/droid-sdk);跑分为厂商自测,尚无第三方复现
阅读全文

Cognition 收购 AI 原生安全公司 Corridor,团队并入 Devin Security

Devin 背后的 Cognition 于 10 月 29 日通过 @cognition 官方账号宣布收购 Corridor。Corridor 联合创始人 Jack Cable 和 Ashwin Ramaswami 在 Cognition 官方博客(日期 2026.10.28)中表示,团队将加入 Cognition,把 Devin Security 推向新阶段。Corridor 成立近两年,定位是 AI 原生团队的安全层。官方未披露交易金额。

Cognition 收购 AI 原生安全公司 Corridor,团队并入 Devin Security

核心要点速览

  • Cognition 收购 Corridor,团队并入 Devin Security 方向
  • Corridor 联合创始人 Jack Cable 与 Ashwin Ramaswami 将与 Cognition 总裁 Russell Kaplan、CSO Alex Stamos、CTO Steven Hao 共事
  • 官方观点:AI agent 已能执行端到端攻击链,未来 6 到 12 个月是网络安全最关键的时期
  • 交易金额官方未披露
阅读全文

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

Devin 背后的 Cognition 于 10 月 27 日发布 FrontierCode 2.0。新版沿用由开源维护者亲自出题、按"能否合并"打分的方法,但任务来自更多仓库、覆盖安全补丁与性能优化,提示词刻意不写全,并加入大量"周全性"判定项。官方结果中 Claude Opus 5.5 以 45.5% 居首,GPT-6 Astra 42.8% 次之,Grok 4.7、Gemini 4 Argon 等降到 20% 多,基准远未饱和。

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

核心要点速览

  • 榜首 Claude Opus 5.5 为 45.5%(1.1 版 54.6%),GPT-6 Astra 42.8%(1.1 版 53.3%),均为官方/厂商口径
  • Grok 4.7 28.6%、Gemini 4 Argon 26.3%、Muse Wonder 1.0 24.3%、SWE-2 23.9%,DeepSeek V4.1 Flash 19.3%、Kimi K3 17.7%,开源模型差距明显
  • 相比 1.1 版,参考解平均多改 67% 的文件、89% 的代码行,代码库大 25%;任务来源仓库多 55%,阻断性判定项多 43%
  • "周全性"阻断项从 168 条增至 501 条,约 3 倍;80% 任务的参考解优于上游原 PR,审计 agent 还发现并上报了一个上游安全漏洞
  • 成本-得分帕累托前沿上,高端是 Opus 5.5,低成本端有 Luna、Haiku 和 Sol,官方点名 GPT-6.1 Sol 性价比突出(官方博客)
阅读全文

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

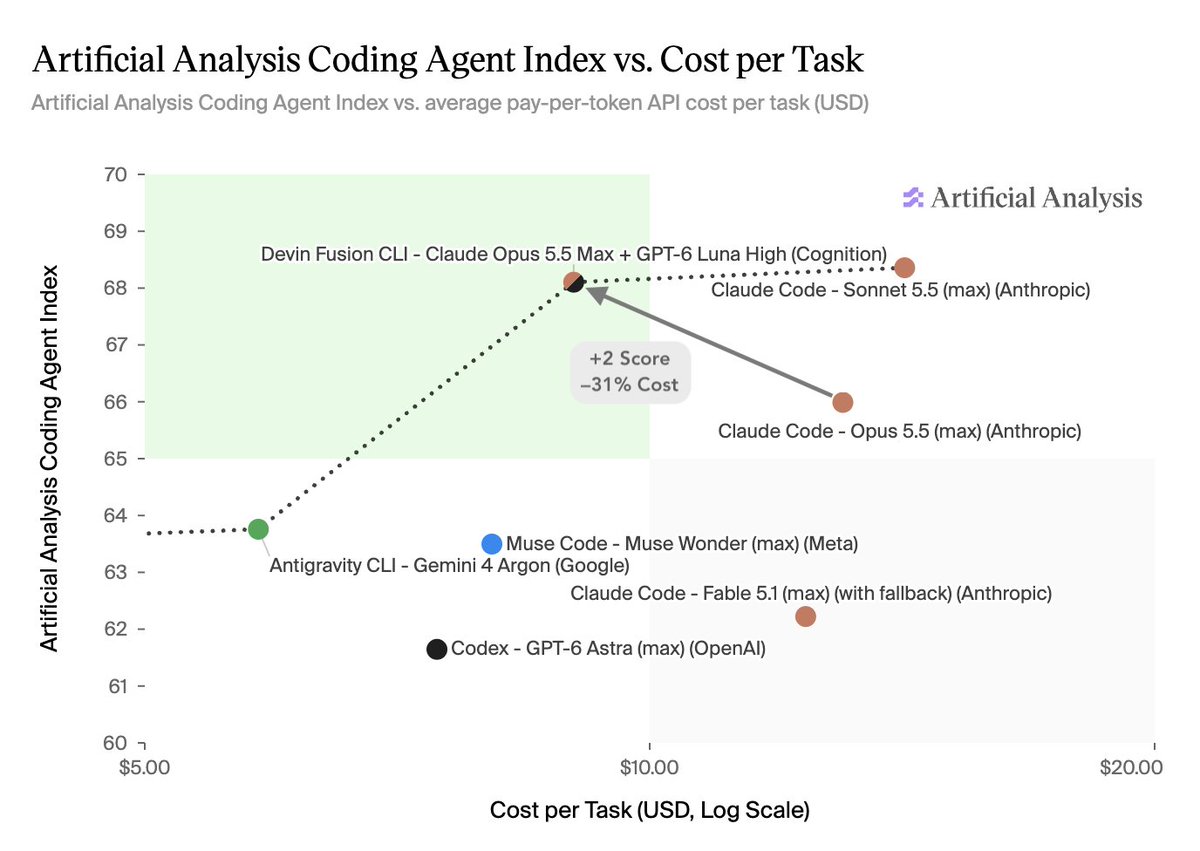
权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

Cognition 10 月 19 日宣布,Devin Fusion 用 Claude Opus 5.5 做主控(lead)、GPT-6 Luna 做执行助手(sidekick)的组合,在 Artificial Analysis Coding Agent Index v1.5 拿到 68.1 分。按 Artificial Analysis 网站当前数据,这一分数位列榜首,但只比第二名 Muse Code + Muse Wonder Full(68.0)高 0.1 分,基本并列;第三名 Antigravity CLI + Gemini 4 Argon 为 63.8。Cognition 称该组合每任务成本比 Claude Code 搭配 Opus 5.5 低 31%(厂商口径)。Fusion 已在 Devin CLI 和桌面版提供。

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

核心要点速览

  • 总分 68.1:DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1,三项等权(Artificial Analysis 数据)。
  • 与第二名 Muse Code + Muse Wonder Full(68.0)只差 0.1 分;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。
  • 成本:Cognition 称比 Claude Code + Opus 5.5 每任务低 31%(厂商口径)。
  • 此前 Fusion 搭配 Fable 5.1 + SWE-2 在 DeepSWE 1.1 上把单任务成本从 14.63 美元降到 7.88 美元(−46%),得分 64.3→63.1。
  • 官方推荐组合为 Opus 5.5 + GPT-6 Luna,安装 Devin CLI 即可使用。
阅读全文
AD赞助内容

Devin 支持接入任意个人 ChatGPT 套餐:Go/Plus/Pro 订阅直接抵扣 GPT 模型用量,不再占用 Devin 配额

Cognition 10 月 9 日宣布,Devin 现可连接任意个人 ChatGPT 套餐(Go、Plus、Pro):会话中调用 OpenAI 模型的部分改由 ChatGPT 订阅额度承担,不再消耗 Devin 配额或按量积分,覆盖 Devin Cloud、Desktop 与 CLI。该能力仅对 Devin 自助 Pro、Max、Teams 套餐开放,Free 与 Enterprise 不可用;ChatGPT 额度用尽时自动回落到 Devin 配额,会话不中断。

Devin 支持接入任意个人 ChatGPT 套餐:Go/Plus/Pro 订阅直接抵扣 GPT 模型用量,不再占用 Devin 配额

核心要点速览

  • 可接入的 ChatGPT 套餐从 9 月 29 日首发时的 Plus/Pro 扩展到 Go/Plus/Pro,Free 账号不可共享(官方文档)
  • 仅 Devin 自助 Pro($20/月)、Max($200/月)、Teams(最低 $80/月)可用,Free 与 Enterprise 不支持(套餐说明)
  • GPT 部分只记 ChatGPT 额度、不重复扣 Devin 配额;fast/priority 变体除外
  • Cognition 引用 Artificial Analysis Coding Agent Index v1.5:Fusion(GPT-6 Astra 主导 + SWE-2 辅助)58.9 分、单任务成本 $4.54,对比 Codex + Astra (max) 61.6 分、$7.47,成本低 39%(厂商口径,官方博客)
阅读全文

LiteLLM 开源自托管云端编程 Agent Moyai:替代 Devin 后 31 天账单从 10.19 万美元降到约 2.17 万美元(-79%)

LiteLLM 团队 10 月 7 日开源内部每天在用的云端编程 Agent Moyai(BerriAI/moyai):从 Slack 或浏览器派任务,Agent 在隔离云工作区里改代码、跑测试、开 PR;可按会话切换 Claude Agent SDK / Codex / Hermes / OpenCode / Deep Agents 等 harness,经 LiteLLM 接入 100+ 模型供应商。官方披露替换 Devin 后同期 31 天成本从 $101,872 降至约 $21,700。

LiteLLM 开源自托管云端编程 Agent Moyai:替代 Devin 后 31 天账单从 10.19 万美元降到约 2.17 万美元(-79%)

核心要点速览

  • 成本:同 31 天 Devin 账单 $101,872 vs Moyai 约 $21,700(约 $700/天),官方称省 79%、约 $80,172(发布博客)
  • Harness 可插拔:默认 Claude Agent SDK(开启 prompt caching),可切 Hermes / Codex / OpenCode / Deep Agents / Tool Loop(harness 文档)
  • 模型层走 LiteLLM,支持 100+ 供应商,会话中可在 GPT-6 Astra / Claude Opus 5.5 / GLM-5.3 间切换,花费按成员归属
  • 安全边界:供应商密钥只留在服务端,沙箱看不到;每个会话独立终端 + 文件系统 + 浏览器
  • 注意:截至发稿仓库约 58 star,GitHub 未检测到 LICENSE 文件,商用前需确认授权
阅读全文

GitHub 开源 ReviewBench:219 个真实 PR 评测 AI 代码审查,Copilot / Devin / Qodo 领跑,Cursor 召回仅 9.6%

GitHub 官方博客 ReviewBench: An open benchmark for AI code review(2026-10-05)发布 AI 代码审查离线基准(research preview)。它从 1.039 亿 个 GitHub PR 的分布中抽样,选出 187 个开源仓库、19 种语言的 219 个 PR,golden set 汇集人类评审、多家前沿 LLM 和静态分析三类来源,由 Claude Sonnet 5 担任评审裁判,资深工程师复核一致率 96.6%。排行榜上 Copilot Code Review Balanced 的 grounded recall 为 26.0%,Devin 23.8%,Qodo 22.1%,Cursor 9.6%。数据集、裁判 prompt 和 runner 以 MIT 协议开源在 GitHub。

GitHub 开源 ReviewBench:219 个真实 PR 评测 AI 代码审查,Copilot / Devin / Qodo 领跑,Cursor 召回仅 9.6%

核心要点速览

  • 规模:219 个 PR,来自 187 个开源仓库、19 种语言,按 1.039 亿个 GitHub PR 的分布抽样,见 官方博客
  • 可信度:资深工程师独立复标所有 golden 真阳性,与基准标签一致率 96.6%;裁判模型为 Claude Sonnet 5
  • 排行榜 grounded recall:Copilot Balanced 26.0%(precision 87.8%)> Devin 23.8% > Qodo 22.1% > Codex GPT-5.6 Sol Ultra 19.9% > Cursor 9.6%
  • 离线与线上一致:多模型集成审查实验中,线上 A/B 结果为 precision +8.0%、recall +13.6%、单次成本 −8.0%;关键评论数离线预测 +227%,线上实测 +262%
  • 提交流程:自带容器镜像和模型 key,先跑 25 PR 测试集,再跑全量 219 PR(3 轮);仓库 review-bench/ReviewBench 为 MIT 协议
阅读全文

Codex 开启「28 天每日改进或全员重置额度」:Day 1 把 GPT-6 Astra 与 GPT-6.1 Sol 默认速度提升约 50%,OpenCode / Amp / Devin 同步受益

OpenAI Codex 负责人 Tibo(Thibault Sottiaux)10 月 5 日承诺:接下来 28 天,每天要么上线一项对多数 Codex / ChatGPT Work 用户有明显价值的改进,要么给所有人「全量重置额度」。Day 1 即推理加速:订阅用户使用 GPT-6 Astra 与 GPT-6.1 Sol 的默认生成速度约提升 50%(约 30→50 tokens/s),覆盖所有支持 Sign in with ChatGPT 的伙伴工具,用户无需改设置。API 速度未宣布变化。

核心要点速览

  • 承诺周期 28 天:每天「一项明确改进」或「全员额度重置」二选一(OpenAI 开发者社区公告帖)
  • Day 1:GPT-6 Astra / GPT-6.1 Sol 默认速度 约 +50%,Tibo 给出的吞吐约 30 → 50 tokens/s(按数字算接近 +67%,官方称均为约数)
  • 覆盖范围:OpenAI 自家产品 + 所有 Sign in with ChatGPT 伙伴(OpenCode、Pi、Amp、Devin 等),零配置,约 2 小时内生效
  • 仅限订阅通道;OpenAI 未宣布 API 速度变化,按 API 计费的评测无需重跑
  • 社区个例:有用户在自建基准上称 6.1 Sol 加速后耗时反而更长,属未复核的单点数据
阅读全文

首份 AI 编程 Agent 合并后质量实证研究:代码修复率为人工作者 1.62 倍,近七成由 Agent 自身闭环修复

澳大利亚莫纳什大学与墨尔本大学研究团队联合发布首份针对 AI 编程 Agent(Devin、Cursor、Claude Code、GitHub Copilot 与 OpenAI Codex)在 GitHub 真实开源项目合并后(Post-Merge)生命周期的实证研究(arXiv:2609.26847)。基于 AIDev-pop 数据集中 500+ 星开源仓库的 6,774 个已合并 Agent PR 与 5,044 个同期人类 PR 的追踪对照发现:Agent 提交的代码合并后需要二次修复(Follow-Up Fixes)的几率是人类 PR 的 1.62 倍;但在修复归属权上,69.6% 的修复 PR 依然由原 Agent 自身发起,且修复 PR 中 76.4% 的 Commit 完全由 Agent 自动生成,颠覆了业内关于“人类工程师必须全权为 Agent 擦屁股”的传统认知。

首份 AI 编程 Agent 合并后质量实证研究:代码修复率为人工作者 1.62 倍,近七成由 Agent 自身闭环修复

核心要点速览

  • 真实样本规模:追踪 500+ 星开源仓库中 6,774 个已合并 Agent PR 与 5,044 个同期人类 PR,覆盖 Devin、Cursor、Claude Code、Copilot 与 Codex
  • 合并后返工率:Agent 合并代码吸引经人工和 LLM 校验的二次修复几率达到人类 PR 的 1.62 倍(Odds Ratio = 1.62),隐性技术债务显著
  • Agent 负责制闭环:69.6% 的跟进修复 PR 仍由同一个 Agent 自身完成,修复 PR 中 76.4% 的 Commit 无人类手动编写介入
  • 高一致性评测基准:采用专家双盲与 LLM Judge(Cohen's Kappa = 0.78,匹配人类一致性 0.77),Direct-fix 判定精度达 90%
  • 工程启示:提倡建立针对 Agent PR 的延迟合并观察期与自动化跟进回归管线,充分利用 Agent 自修复能力释放人类代码评审算力
阅读全文