AI 编程实时动态与要闻

微软 MAI-Transcribe-2 语音识别模型在 Foundry 正式 GA:单模型覆盖 60 种语言、内置说话人分离,1 小时音频约 10 秒转完,年底前每小时 0.10 美元

Microsoft AI 官方账号 11 月 12 日宣布,自研语音转文字模型 MAI-Transcribe-2 在 Microsoft Foundry 正式商用(GA),可用于生产环境,价格为每小时音频 0.10 美元(限时到 2026 年底)。该模型 9 月 3 日以公开预览上线,单模型支持 60 种语言,自带说话人分离、词级时间戳和关键词偏置;微软称 1 小时音频约 10 秒推理完成,FLEURS 前 25 种语言平均词错误率 3.4%。

微软 MAI-Transcribe-2 语音识别模型在 Foundry 正式 GA:单模型覆盖 60 种语言、内置说话人分离,1 小时音频约 10 秒转完,年底前每小时 0.10 美元

核心要点速览

  • 从预览转正式:9 月 3 日公开预览,11 月 12 日在 Microsoft Foundry GA,可用于生产负载(Microsoft Learn 文档)
  • 价格:每小时音频 0.10 美元,官方写明是到 2026 年 12 月 31 日的限时价,之后价格以官方定价页为准
  • 一个模型 60 种语言:自动识别语种,支持印英混说(Hinglish)、西英混说(Spanglish)等语码切换,噪声环境下保持准确率
  • 功能内置:说话人分离、词级时间戳、关键词偏置(phraseList)、clean / verbatim 两种转写风格,无需另接服务
  • 速度与精度为微软自测:1 小时音频约 10 秒推理,比 GPT-Transcribe 快 10 倍、比 Scribe v2 快 7 倍、比 Gemini 3.5 Transcribe 快 5 倍;FLEURS 60 语言平均词错误率 5.2%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Transcribe-2⚡ MAI-Transcribe-1.5⚡ GPT-Transcribe⚡ Scribe v2⚡ Gemini 3.5 Transcribe🌐 Microsoft🌐 Microsoft AI
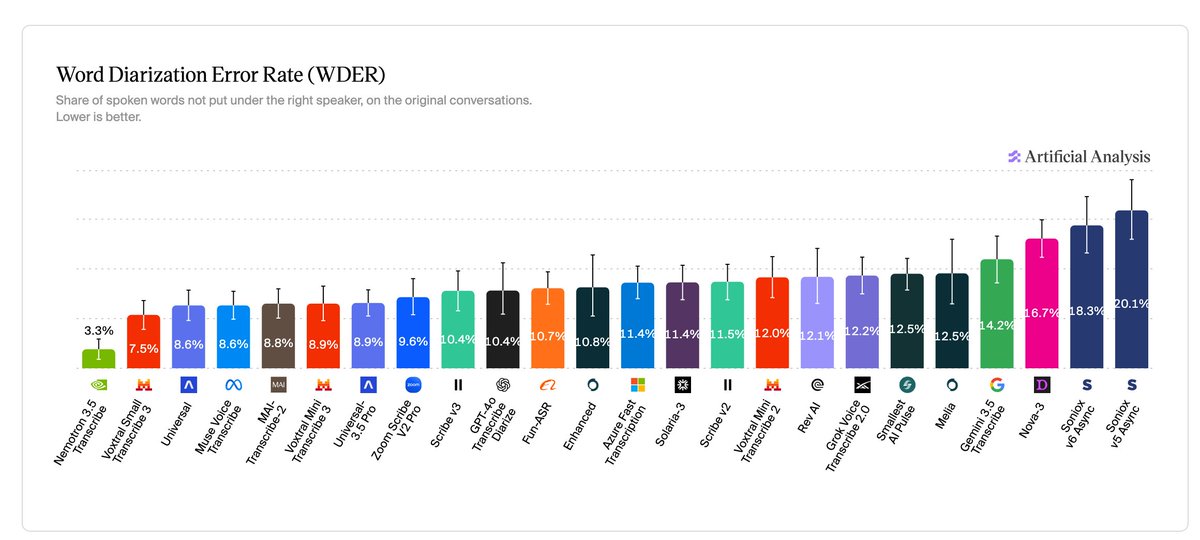
Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

Artificial Analysis 11 月 13 日发布 Diarization Index,专门衡量语音转文字 API 能否把每个词归到真正说话的人:指标是 WDER(被分给错误说话人或无人说话的词占比),测试集为 97 段 2–8 人英文对话,按 2 人、3–4 人、5–8 人三档等权平均。NVIDIA 开源权重的 Nemotron 3.5 Transcribe 以 3.3% 居首,Voxtral Small Transcribe 3 以 7.5% 排第二,也是有标价 API 里最准的;MAI-Transcribe-2 为 8.8%,速度最快之一。

Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

核心要点速览

  • 新指标 WDER =(分错说话人的词 + 无人说话时段的词)÷ 参与评分的参考词数,越低越好;AA 称不用 DER,因为对 API 而言 DER 主要在考词时间戳而不是谁在说话
  • 测试集 97 段对话、每段约 2–9 分钟、总时长约 6.8 小时,真实与合成语音混合,大部分音频为私有留出集,另含约 126 分钟公开的 NOTSOFAR-1 会议录音
  • 评测时直接调用各 API 并开启说话人分离,不告诉模型有几个人在说话,整段音频一次送入;价格包含单独收费的分离功能
  • Nemotron 3.5 Transcribe 2 人对话 WDER 1.7%,5–8 人时也只有 5.6%;在人数最多的一档,其他所有 API 的 WDER 都超过 10%
  • Voxtral Small Transcribe 3 为 7.5%、每千分钟 4 美元;MAI-Transcribe-2 为 8.8%、每千分钟 1.67 美元,每等 1 秒可转写 93.7 秒音频;Nemotron 3.5 Transcribe 是开源权重模型,AA 未列价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe⚡ Voxtral Small Transcribe 3⚡ MAI-Transcribe-2🌐 Artificial Analysis🌐 NVIDIA🌐 Mistral AI🌐 Microsoft

ElevenLabs 发布 Scribe v3 与 Scribe v3 Live 语音转文字模型:102 种语言词错误率比 v2 降 27%,实时版首次支持说话人分离,API 每小时 0.20/0.22 美元

ElevenLabs 11 月 10 日(新加坡时间 11 日凌晨 02:10)发布两款语音转文字模型:面向录音文件的 Scribe v3 和面向实时流的 Scribe v3 Live。官方口径:Scribe v3 在 FLEURS 102 种语言上词错误率(WER)比 Scribe v2 低 27%,且每种语言都有提升;Scribe v3 Live 的语义 WER 比 Scribe v2 Realtime 低 43%,并首次在实时转写中提供说话人分离和基于上下文的断句检测。两款模型已上线 ElevenAPI,从 v2 切换只需改 model ID;API 定价页列出每音频小时 0.20 美元(v3)和 0.22 美元(v3 Live)。第三方评测方 Voice Arena 用 70+ 小时真实电话录音测试,称 v3 Live 在罗马尼亚语和印度英语里排第一。

ElevenLabs 发布 Scribe v3 与 Scribe v3 Live 语音转文字模型:102 种语言词错误率比 v2 降 27%,实时版首次支持说话人分离,API 每小时 0.20/0.22 美元

核心要点速览

  • 准确率(官方口径):Scribe v3 在 102 种语言上 WER 比 v2 低 27%,德语 -42%、西班牙语 -35%、英语 -23%、泰语 -28%
  • 实时版:Scribe v3 Live 语义 WER 比 v2 Realtime 低 43%、WER 低 31%,希腊语提升 77%,官方称延迟约 150ms
  • 说话人分离:v3 比 v2 少 12% 错误,3 人以上录音少 17%;v3 Live 比次优实时模型少 39%,英语分离错误率 3.1%
  • 价格:API 每音频小时 $0.20(v3)/ $0.22(v3 Live),关键词提示另加 $0.05/小时,转写编辑另加 $0.07/小时
  • 上手:model ID 为 scribe_v3 / scribe_v3_live,关键词提示最多 1000 个术语;企业版提供欧盟、印度、新加坡数据驻留
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Scribe v3⚡ Scribe v3 Live🤖 ElevenAgents🌐 ElevenLabs

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

Mistral AI 正式推出 Voxtral 3 语音多模态大模型家族与配套的实时 Voice-Agent API。该套件包含 40 亿参数的 Mini 转录模型、超越 Whisper 与 Gemini 3.5 的 Small 转录模型,以及基于 LiveKit 的端到端语音智能体 SDK。系统支持 50 种语言高精听写与说话人分离、跨 35+ 语言带情感标签的情感语音合成(TTS)以及 30 分钟音频专业级声音克隆。在 Artificial Analysis 独立基准评测中,Small Transcribe 3 以 2.1% 极低字错率登顶全球语音识别榜单季军,Realtime 转录单步延迟低至 500ms 以内,每分钟语音智能体调度成本低至 0.04 美元。

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

核心要点速览

  • Mistral 官方正式发布 Voxtral 3 全栈语音多模态模型家族,包含转录、情感 TTS、专业声音克隆与实时 Voice-Agent SDK
  • 在 Artificial Analysis 独立实测中,Small Transcribe 3 斩获 2.1% 极低错词率,击败 ElevenLabs Scribe v2(2.2%)与 Grok Voice 2.0(2.3%)
  • Realtime Transcribe 3 响应时间压缩至 500ms 以内,端到端完整语音 Agent 回合交互延迟突破 1 秒大关
  • 极致价格革命:Mini 转录每分钟仅需 0.0035 美元,搭配 Mistral Small 4 调度的全托管语音智能体每分钟仅 0.04 美元
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

10 月 20 日,Mistral 发布 Voxtral 3:语音转文字模型 Voxtral Small/Mini Transcribe 3、实时转写 Voxtral Mini Transcribe Realtime 3、语音合成 Voxtral Mini TTS 3(Voxtral Speech 3),以及基于 LiveKit 的语音 Agent SDK,把“听—思考调工具—说”串成一条流式管线,官方称每轮响应不到 1 秒。转写覆盖 50+ 语言并支持说话人分离和上下文偏置,TTS 覆盖 35+ 语言、50+ 方言,另有 30 分钟录音即可复刻音色的 Pro Voice。模型已通过 Mistral API(欧盟、美国、全球端点)上线,也可自部署。

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

核心要点速览

  • 多语种转写(官方口径):FLEURS 45 种语言宏平均 WER,Voxtral Small Transcribe 3 为 4.1%(指定语言)/4.0%(自动识别),与 Microsoft AI Transcribe 2 持平,优于 Scribe v2 的 4.9% 和 Whisper large-v3 的 16.0%/14.9%
  • 说话人分离(官方口径):cpWER 方面 Small 为 18.4%、Mini 为 18.6%,上一代 Voxtral Mini Transcribe 2 为 30.9%,Gemini 3.5 Transcribe 为 38.4%
  • 价格:Voxtral Mini Transcribe 3 为 4B 参数,每分钟 0.0035 美元(文档标注 Public Preview、32k 上下文);Voxtral Speech 3 每百万字符 13 美元
  • 实时转写:Voxtral Mini Transcribe Realtime 3 延迟可低于 500 毫秒;官方 FLEURS 35 语言图中 480ms 档 WER 为 6.4%,仍高于 Gemini 3.5 Realtime Transcribe 的 4.2%
  • 语音 Agent SDK 基于 LiveKit,支持 SIP 电话与 WebRTC,每个环节可单独替换 LLM、音色或语言,Pro Voice 用 30 分钟录音即可复刻音色
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Voxtral Small Transcribe 3⚡ Voxtral Mini Transcribe 3⚡ Voxtral Mini Transcribe Realtime 3⚡ Voxtral Mini TTS 3🤖 Voxtral voice agent SDK🌐 Mistral AI🌐 LiveKit

Hugging Face Transformers 5.18.0:Nemotron 3 流式说话人分离;NemotronH Omni;HyperCLOVAX Vision V2;GTE

Hugging Face 于 2026-09-30 发布 transformers v5.18.0(PyPI 5.18.0)。新增 NVIDIA Nemotron 3 Diarization(流式/离线、最多 8 说话人、80 ms–30.4 s 可配缓冲)、NemotronH Omni(文本/图/视频/音频联合推理)、NAVER HyperCLOVAX Vision V2(含 <think> 思维链)以及 GTE 双向编码器(RoPE + gated MLP,覆盖 gte/snowflake-arctic-embed 系)。文档已上线对应 model_doc 页。

Hugging Face Transformers 5.18.0:Nemotron 3 流式说话人分离;NemotronH Omni;HyperCLOVAX Vision V2;GTE

核心要点速览

  • 发版:v5.18.0(2026-09-30T16:46:27Z);PyPI 上传约 2026-09-30T16:45:57Z
  • Nemotron 3 Diarization:流式+离线、「谁在何时说话」、最多 8 说话人;缓冲 80 ms–30.4 s;帧分辨率 10 ms 倍数(#49056)
  • NemotronH Omni:NemotronH + RADIO 视觉 + 可选 Parakeet 音频,单自回归模型联合 text/image/video/audio(#46509)
  • HyperCLOVAX Vision V2(NAVER)+ GTE 编码器(RoPE/gated MLP,兼容 gte-*-v1.5 与 snowflake-arctic-embed-m-v2.0)
  • 落地:pip install -U transformers==5.18.0;文档 nemotron3_diarization / nemotron_h_omni / gte
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3 Diarization⚡ Nemotron H Omni⚡ Hyperclovax Vision V2⚡ gte🌐 Huggingface🌐 Nvidia (NIM)🌐 Naver

xAI 发布 Grok Voice Transcribe 2.0:短指令 WER 降至 6.8%,批处理约 $0.10/小时

SpaceXAI(xAI)正式上线 Grok Voice Transcribe 2.0,宣称在客服通话、口述凭证与短语音指令等真实场景上准确率约为上一代两倍,且价格不变。官方称其在 Artificial Analysis 32 个流式转写模型中准确率排名第一;短指令词错误率从约 20.6% 降至约 6.8%。支持流式/批处理、自动语种检测与中途换语、词级时间戳与置信度、免费说话人分离,批处理约 $0.10/小时、实时流式约 $0.20/小时,既有 Speech-to-Text API 集成可无感升级。

核心要点速览

  • 宣称客服通话/口述凭证/短指令等场景准确率约为 Transcribe 1.0 的两倍,价格不变。
  • Artificial Analysis 流式转写榜准确率第 1;短指令 WER 约 20.6%→6.8%。
  • 批处理约 $0.10/小时、实时流式约 $0.20/小时;含说话人分离、语种切换与词级时间戳,API 可无感升级。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Grok Voice Transcribe 2🌐 xAI

阿里通义发布 Qwen3.8-LiveTranslate:60 语实时同传,延迟降至约 2.3 秒

通义官方发布下一代实时同传模型 Qwen3.8-LiveTranslate,采用 Interleave 架构提升忠实度、流畅度与简洁性,并将跨 60 种语言的平均滞后(LAAL)从 2.8 秒降至 2.3 秒。新能力包括实时说话人分离与声克隆、双语同步显示,以及基于长上下文消歧专有名词与术语。

核心要点速览

  • Interleave 架构将 60 语平均滞后(LAAL)从约 2.8 秒降至约 2.3 秒。
  • 支持实时说话人分离,并在多说话人场景中更稳定地保留各说话人音色。
  • 提供双语同步显示与长上下文术语消歧;可在 QwenCloud 试用。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen3 8 Livetranslate🌐 Alibaba🌐 Qwen (通义千问)

Meta 发布 Muse Voice Transcribe:实时多语 ASR,支持 20+ 说话人分离,API 约 0.18 美元/小时

Meta Superintelligence Labs 于 9 月 1 日推出首个实时音频感知模型 Muse Voice Transcribe:流式 ASR、20+ 说话人 diarization、endpointing,原生支持句内/句间语码转换,训练覆盖 70+ 语言(首发验证 25 种),可处理超一小时音频。官方称在 Artificial Analysis 流式语音转写榜单排名第一(截至 9 月 1 日)。已接入 Meta AI for Mac(按住 Fn 全局听写)、Muse Code,并向 Meta Model API 开放,定价为每 1000 音频分钟 3 美元(约合每小时 0.18 美元)。

核心要点速览

  • 流式 ASR + 说话人分离 + 端点检测一体,无需后处理拼流水线
  • Mac 全局听写与 Muse Code 已切换到该模型;开发者可走 Meta Model API
  • API 价约 0.18 美元/小时;自适应 delay 在速度与准确率之间动态权衡
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Voice Transcribe⚡ Muse Spark🤖 muse-code🌐 Meta AI