AI 编程实时动态与要闻

GitHub Copilot 全面上线 Gemini 4 Hydrogen(VS Code、CLI、编码 Agent 等全平台,按厂商标价计费);同日宣布 12 月 14 日下线 Claude Fable 5、Gemini 3.8 Flash、Grok 4.6、Kimi K3 等 6 个模型

GitHub 于 11 月 13 日在官方 Changelog 宣布:Google 最新的 Flash 级模型 Gemini 4 Hydrogen 已在 GitHub Copilot 正式可用(GA),面向 Copilot Pro、Pro+、Max、Business 和 Enterprise 用户,可在 VS Code、Visual Studio、Copilot CLI、Copilot 编码 Agent、Copilot app、github.com、移动端、JetBrains、Xcode、Eclipse 和 Copilot SDK 的模型选择器中使用,逐步放量,按用量计费、价格为厂商标价。GitHub 称它面向快速高效的 Agent 编码、工具调用和多步工作流,指令遵循比 Gemini 3.8 Flash 更好。同一天 GitHub 还发布弃用通知:2026 年 12 月 14 日起,Copilot 全部体验将下线 Claude Fable 5、Claude Haiku 4.5、Gemini 3.8 Flash、Gemini 4 Argon、Grok 4.6 和 Kimi K3,并给出替代模型。
GitHub Copilot 全面上线 Gemini 4 Hydrogen(VS Code、CLI、编码 Agent 等全平台,按厂商标价计费);同日宣布 12 月 14 日下线 Claude Fable 5、Gemini 3.8 Flash、Grok 4.6、Kimi K3 等 6 个模型

核心要点速览

  • Gemini 4 Hydrogen 在 GitHub Copilot 正式可用,面向 Pro、Pro+、Max、Business、Enterprise 用户,逐步放量(GitHub Changelog)
  • 覆盖面很广:VS Code、Visual Studio、Copilot CLI、Copilot 编码 Agent、Copilot app、github.com、iOS/Android、JetBrains、Xcode、Eclipse 和 Copilot SDK 都能在模型选择器里选到
  • 计费:按用量计费、价格为厂商标价;企业和商业版默认自动启用新模型,管理员可在 Copilot 设置的模型策略里关闭
  • 12 月 14 日下线 6 个模型及官方建议替代:Claude Fable 5→Fable 5.2,Claude Haiku 4.5→Haiku 5.5,Gemini 3.8 Flash→Gemini 4 Hydrogen,Gemini 4 Argon→Gemini 4 Carbon,Grok 4.6→Grok 4.7,Kimi K3→待公布(弃用通知)
  • 例外:年付的 Copilot 个人订阅用户仍可继续使用 Claude Haiku 4.5
阅读全文

Google Research 公布 Antigravity /teamwork 多智能体成果:与学界合作完整证明 2013 年 Courtade–Kumar 猜想(5000 万行 Lean 4),自主形式化 Weil 猜想;工具已对外开放,1 万名学者可申请 6 个月免费

11 月 13 日,Google Fellow、Google Research 副总裁 Vahab Mirrokni 在 Google Research 博客和 X 上公布 Antigravity /teamwork 多智能体系统的新成果。Google 与 CUHK、USC、CMU 研究者用 Gemini 4 Argon 等模型完整证明了信息论中 2013 年提出的 Courtade–Kumar 猜想,并在 Lean 4 中形式化,共 5000 万行代码。/teamwork-LEAP 还全自主形式化了 Weil 猜想(约 180 万行 Lean,28,800 次子智能体调用)。工程方面,Zircon 微内核剩余部分被改写为约 80 万行安全 Rust,17 个 JAXBench TPU 内核几何平均提速 4.09 倍。/teamwork 和 /boost 已在 Antigravity 对外可用,1 万名学术研究者可申请 6 个月最高档免费额度。

Google Research 公布 Antigravity /teamwork 多智能体成果:与学界合作完整证明 2013 年 Courtade–Kumar 猜想(5000 万行 Lean 4),自主形式化 Weil 猜想;工具已对外开放,1 万名学者可申请 6 个月免费

核心要点速览

  • Courtade–Kumar 猜想(2013)被完整证明并在 Lean 4 中形式化,共 5000 万行代码;Gemini 负责大部分新解析界和区间算术证书,人类研究者提出关键候选函数
  • /teamwork-LEAP 全自主形式化 Weil 猜想,约 180 万行 Lean、28,800 次子智能体调用;还首次形式化了 1927 年的 Birkhoff 猜想和 3D Bochner–Riesz 猜想
  • 工程成果:Zircon 剩余部分改写为约 80 万行安全 Rust 并通过全部内核单测;libgav1 改写为约 17 万行 Rust,比原 C++/汇编快 20–30%;17 个 JAXBench TPU 内核几何平均提速 4.09 倍
  • /teamwork 与 /boost 已在 Antigravity 对外可用,Hydrogen 对所有人开放,Carbon/Argon 面向 Enterprise 与 Ultra/付费用户;1 万名学者可申请 6 个月免费;Deep Review 每周免费 2 次
  • 这些结果由 Google 自行发布,博客称预印本和 Lean 4 仓库已公开,外部复核仍需时间
阅读全文

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

11 月 12 日(UTC),获 Felicis 和英伟达投资的电脑操作智能体公司 Simular 发布 box:每个账号一台云端 Ubuntu 桌面,自带 Chrome 和常驻 shell,整体作为一个远程 MCP 服务器(mcp.box.simular.ai/mcp,Streamable HTTP,OAuth 登录)提供。claude.ai、ChatGPT、Gemini、Claude Code、Codex、Cursor、OpenCode、VS Code 等任何 MCP 客户端都能接入,不同助手可以在同一台机器上接力干活,共享登录状态和文件。用户可在网页或 iPhone 上实时观看,需要登录或付款确认时随时接管。桌面本身免费,模型调用消耗账号积分;空闲时休眠、约 1 秒唤醒,连续休眠 14 天会被删除。发布视频浏览量超过 81 万。官方称「生产环境最快的电脑操作」,但未公布跑分。

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

核心要点速览

  • 接入方式:一个远程 MCP 地址 mcp.box.simular.ai/mcp,OAuth 登录;Claude Code 一行 claude mcp add --transport http box ... 即可,CI 场景可用 cb_ 开头的个人密钥
  • 安装器 npx @simular-ai/[email protected] connect 会自动发现本机的 Claude Code、Codex、Cursor、OpenCode、Hermes、OpenClaw、VS Code 并写入配置,doctor/remove 可检查和撤销
  • 计费:桌面免费,模型调用用账号积分;空闲约 1 秒唤醒,连续休眠 14 天删除整台机器和文件
  • Secrets 功能:API 密钥加密存储,AI 只看到替身值,box 仅在发往指定域名的请求里替换成真实密钥
  • 官方发布视频约 81.5 万浏览;「最快电脑操作」为厂商口径,官方未公布 OSWorld 等跑分
阅读全文

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

新加坡时间 11 月 13 日 02:02,Google DeepMind、Google AI 和 Gemini 官方账号同时宣布 Gemini 4 Hydrogen 正式上线,Gemini API 更新日志标注为 GA,模型 ID 是 gemini-4-hydrogen。按官方口径,它在默认 high 思考档位下的 Artificial Analysis 智能指数为 51,高于 Gemini 4 Argon 的 50,新增的 xhigh 档位可到 54;完成任务的速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 得分从 18.2% 提高到 57%。价格在 100 万 token 上下文内统一为输入 1.5 美元、输出 7.5 美元(每百万 token),免费层也能用。它同时成为 Gemini 应用、Google 搜索和 Antigravity 托管智能体的默认模型。昨天站内报道过的 SKU 价目表泄露,今天由官方证实。Cursor 官方随后宣布 Hydrogen 已上线编辑器,默认努力档(high)在 CursorBench 4.0 上为 54.3%,高于 Gemini 3.8 Flash 的 39.6%。

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

核心要点速览

  • 官方口径:AA 智能指数 51(默认 high 档),高于 Gemini 4 Argon 的 50;新增 xhigh 档可达 54
  • 速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 从 18.2% 升到 57%,捏造陈述减少 5 倍以上
  • 定价:每百万 token 输入 1.5 美元、输出 7.5 美元,100 万 token 上下文内不分段加价,免费层可用
  • Antigravity 新功能 Orchestrator 在 Carbon 和 Hydrogen 之间自动切换:Terminal-Bench 4.0 成功率接近纯 Carbon,额度少用 24%,速度快 19%
  • 合作方实测:复杂图、SQL 和数据类企业任务比 3.8 Flash 快 2–2.8 倍,token 用量少 12%–23%
  • Cursor:官方宣布 Hydrogen 已上线编辑器;CursorBench 4.0 默认 High 54.3%(每任务约 5.59 美元),高于 Gemini 3.8 Flash 的 39.6%;Medium 46.7%(约 1.76 美元),Low 27.9%(约 0.28 美元);属第三方模型,不计入套餐包含用量(Cursor 文档、CursorBench)
阅读全文
AD赞助内容

X 热议:Google 尚未官宣的 Gemini 4 Hydrogen 先出现在官方 SKU 价目表,输入每百万 token 1.5 美元、输出 7.5 美元,比 Gemini 4 Carbon 12 月新价便宜 62.5%,社区称已能在 Vertex AI 调通

11 月 12 日下午(新加坡时间),模型追踪账号 AI Tracker Bot(@aitrackerbot)发帖称,在 Vertex AI 全球端点调用 gemini-4-hydrogen 返回了 HTTP 200,模型自称「Gemini 4 Hydrogen,由 Google 构建的大型语言模型」。该帖约 5.8 万浏览、361 赞。稍早 Google AI Studio 负责人 Logan Kilpatrick 只发了一个词「Gemini」,约 47.5 万浏览、846 条回复。随后有人发现 Google Cloud 公开 SKU 页面已列出 Gemini 4 Hydrogen 的计费条目:文本输入每百万 token 1.50 美元、输出 7.50 美元,缓存输入 0.075 美元。我们打开 Google 官方 SKU 页核对,价格一致;但 Gemini API 模型页和定价页仍没有 Hydrogen,Google 也未发布任何公告。讨论焦点是:这是不是 Gemini 4 的 Flash 档,以及价格是否有竞争力。

核心要点速览

  • Google Cloud 官方 SKU 页(Gemini API 服务)已列出 Gemini 4 Hydrogen:文本/图像/音频输入 1.50 美元、文本输出 7.50 美元、缓存输入 0.075 美元(每百万 token,global 区域)
  • 分档价格:Batch 与 Flex 输入 0.75 美元,Batch 输出 3.75 美元,Priority 输入 2.70 美元(约为标准价 1.8 倍)
  • 对比官方定价页:Gemini 4 Carbon 当前 2/10 美元,12 月 1 日起 4/20 美元;Hydrogen 比 12 月新价便宜 62.5%,与 Gemini 3.8 Flash 2027 年 1 月 1 日起的 1.50/7.50 美元相同
  • 「Vertex AI 返回 200、模型自报家门」来自 @aitrackerbot 的说法(约 5.8 万浏览),我们无法独立复现;Google 未公布上下文长度、发布日期或任何跑分
  • Logan Kilpatrick 的一字帖「Gemini」约 47.5 万浏览、5,114 赞,但帖子本身没有提到任何模型名
阅读全文

X 热议:Epoch 能力指数 ECI 最新排名,OpenAI 一年来首次跌到第三:Claude Fable 5.2 以 173 居首,Gemini 4 Carbon 170,GPT-6 Astra 169,可信区间大幅重叠引发争论

AI 观察账号 leo(@synthwavedd,约 4.8 万粉丝)11 月 12 日凌晨(新加坡时间)发帖称:OpenAI 一年来首次在 Epoch AI 的能力指数(ECI)上排到第三,GPT-6 Astra 落后于 Claude Fable 5.2 和 Gemini 4 Carbon。帖子附 Epoch 榜单截图:Fable 5.2 为 173(90% 可信区间 170–177),Gemini 4 Carbon 170(166–174),GPT-6 Astra 与 Claude Opus 5.5 同为 169(166–172)。该帖约 3.8 万浏览、830 赞、45 条回复,中日文圈 12 日继续转述。Epoch 官网目前显示的最高分为 Fable 5.2 的 173,并注明该分数基于发布前测试、仍可能变化。争论焦点在于:前几名的区间互相重叠,「第三」到底有多大意义。

X 热议:Epoch 能力指数 ECI 最新排名,OpenAI 一年来首次跌到第三:Claude Fable 5.2 以 173 居首,Gemini 4 Carbon 170,GPT-6 Astra 169,可信区间大幅重叠引发争论

核心要点速览

  • Epoch ECI 截图口径:Claude Fable 5.2 173(170–177)、Gemini 4 Carbon 170(166–174)、GPT-6 Astra 169(166–172)、Claude Opus 5.5 169(166–172)
  • 原帖约 3.8 万浏览、830 赞、45 回复;「一年来首次第三」是发帖人的说法,Epoch 未单独发文确认
  • Epoch 官网:Fable 5.2 的分数基于发布前测试、只用 Epoch 自有基准,后续可能调整;11 月 9-10 日有帖子引用的是 174
  • BenchLeader 汇总的小数值:Fable 5.2 173.4、Gemini 4 Carbon 169.8、GPT-6 Astra 169.0,第二到第五名差距不到 1.5 分
  • ECI 已改用贝叶斯模型并给出 90% 可信区间,前四名区间全部重叠,统计上难分高下
阅读全文

X 热议:Artificial Analysis 称 Gemini 4 Carbon 在机械臂评测 AA-Robotics 里连跑 7 小时 33 分,把夹爪撞坏了,重试是否该算分引发讨论

独立评测机构 Artificial Analysis(AA)11 月 12 日中午(新加坡时间)在官方账号发帖:Google 的 Gemini 4 Carbon 在 AA-Robotics v0.1 实验室里一共跑了 7 小时 33 分钟,过程中把机械臂「撞来撞去」,弄坏了一个夹爪,AA 给了它一次重试。帖子附 11 秒现场视频,约 2 万浏览、300 余赞、40 余条回复。讨论集中在三点:重试成绩是否该单列、通用模型连续操控真实硬件 7 个多小时意味着什么、以及物理评测里的设备损耗和安全看护成本。AA 尚未公布 Carbon 在该榜的得分。以下为评测方分享与社区讨论,不代表最终榜单。

X 热议:Artificial Analysis 称 Gemini 4 Carbon 在机械臂评测 AA-Robotics 里连跑 7 小时 33 分,把夹爪撞坏了,重试是否该算分引发讨论

核心要点速览

  • AA 口径:Gemini 4 Carbon 在 AA-Robotics v0.1 实验室累计 7 小时 33 分,撞坏 1 个夹爪,AA 给了 1 次重试
  • AA 尚未公布 Carbon 的得分,也没说明重试成绩如何计入;当前榜首仍是 Claude Fable 5.2(75 分)
  • 按 8 项任务粗算约合每题近 1 小时;首发榜单上 GPT-6 Astra 平均每题约 30 分钟,人类约 20 秒
  • 热度:约 2 万 浏览、300+ 赞、40+ 回复、16 条引用
  • Carbon API 介绍期价格每百万输入 / 输出 token 2 / 10 美元,11 月 30 日后为 4 / 20 美元(Google 官方口径)
阅读全文

Arena:Claude Fable 5.2 (Max) 以 +30.4% 净提升登顶 Agent Arena,约为第 2 名 Opus 5.5 的 1.6 倍,代码、工作、对话三榜均第一

Arena 于 11 月 11 日宣布,Anthropic 的 Claude Fable 5.2 (Max) 在 Agent Arena 总榜排名第一:基于 4,731 次真实智能体会话,净提升 +30.35%,约为第 2 名 Claude Opus 5.5 (Max)(+19.52%)的 1.6 倍,第 3 名为 Gemini 4 Carbon (High)(+16.98%,初步排名)。相比上一代 Fable 5.1,Fable 5.2 从第 5 升至第 1,净提升约翻倍,每任务中位成本从 7.60 美元降至 7.28 美元。它在「好评 vs 抱怨」「可控性」「确认成功」三项信号均居首,Bash 可靠性第 3,但每任务成本仍是 Gemini 4 Carbon 的约 5 倍。

Arena:Claude Fable 5.2 (Max) 以 +30.4% 净提升登顶 Agent Arena,约为第 2 名 Opus 5.5 的 1.6 倍,代码、工作、对话三榜均第一

核心要点速览

  • 总榜第 1:净提升 +30.35%(±3.93%),样本 4,731 次会话;第 2 名 Opus 5.5 为 +19.52%,第 3 名 Gemini 4 Carbon 为 +16.98%(Arena 榜单)
  • 相比 Fable 5.1:排名 #5 → #1,净提升 +14.82% → +30.35%,每任务中位成本 $7.60 → $7.28,API 价格 $10/$50 → $8/$40 每百万 token
  • 分项信号:好评 vs 抱怨 +73.44%(第 1,下一名约 +41%)、可控性 +32.96%(第 1)、确认成功 +21.99%(第 1)、Bash 可靠性 +14.42%(第 3)
  • 分类榜:Code +34%、Work +31%、Chat +27%,三类均第 1(Arena 官方口径)
  • 性价比:每任务 $7.28,约为 Opus 5.5($5.37)的 1.36 倍、Gemini 4 Carbon($1.46)的 5 倍;Pareto 前沿上仍有 Carbon、GPT-6.1 Sol/Terra 等低价选项
阅读全文

Gemini API Managed Agents 支持自托管环境:Agent 的 shell 和文件工具可跑在你自己的沙箱里,只需出站 HTTPS,官方给出 Cloud Run、Cloudflare、Daytona、E2B、Modal、Vercel 等 8 种接入示例

Google AI Studio 11 月 11 日(北京时间 12 日凌晨)宣布,Gemini API 的 Managed Agents 现在可以“自带沙箱”。以前 Antigravity 等托管 Agent 的工具只能在 Google 托管的 Linux 沙箱里执行;现在 Agent 循环和模型调用仍在 Google 一侧,执行 shell 命令、读写文件这些工具调用则可以交给你自己的容器、VM 或 microVM。接入方式是先调用 POST /v1beta/environments 并传 {"mode":"self_hosted"},拿到环境 id 和只返回一次的 environment_key,再在沙箱里运行开源 gemini-api CLI 的 environments connect。全程只走出站 HTTPS,不需要开放入站端口。

Gemini API Managed Agents 支持自托管环境:Agent 的 shell 和文件工具可跑在你自己的沙箱里,只需出站 HTTPS,官方给出 Cloud Run、Cloudflare、Daytona、E2B、Modal、Vercel 等 8 种接入示例

核心要点速览

  • 分工:Agent 循环、模型和交互流留在 Google,7 个内置工具(execute_bash、读写/编辑文件、list_dir、grep_search、find_by_name)在你的环境执行
  • 网络:100% 出站 HTTPS,无需开放入站端口;worker 只持有环境级 environment_key,项目级 GEMINI_API_KEY 不用放进沙箱
  • 两种模式:environments connect 单 worker 长驻;environments poll + serve 为每次交互起一个新沙箱,沙箱里只有短期 lease token、零 API key
  • 官方示例覆盖 8 家:Cloud Run、Agent Substrate、Cloudflare Sandbox、Daytona、E2B、Fly.io、Modal、Vercel Sandbox,另有 Docker / rootless Podman 配方
  • 限制:sources、network、env 和 /files 快照只适用于 Google 托管环境,自托管环境传这些会返回 400 INVALID_ARGUMENT;单独定价官方未公布
阅读全文

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

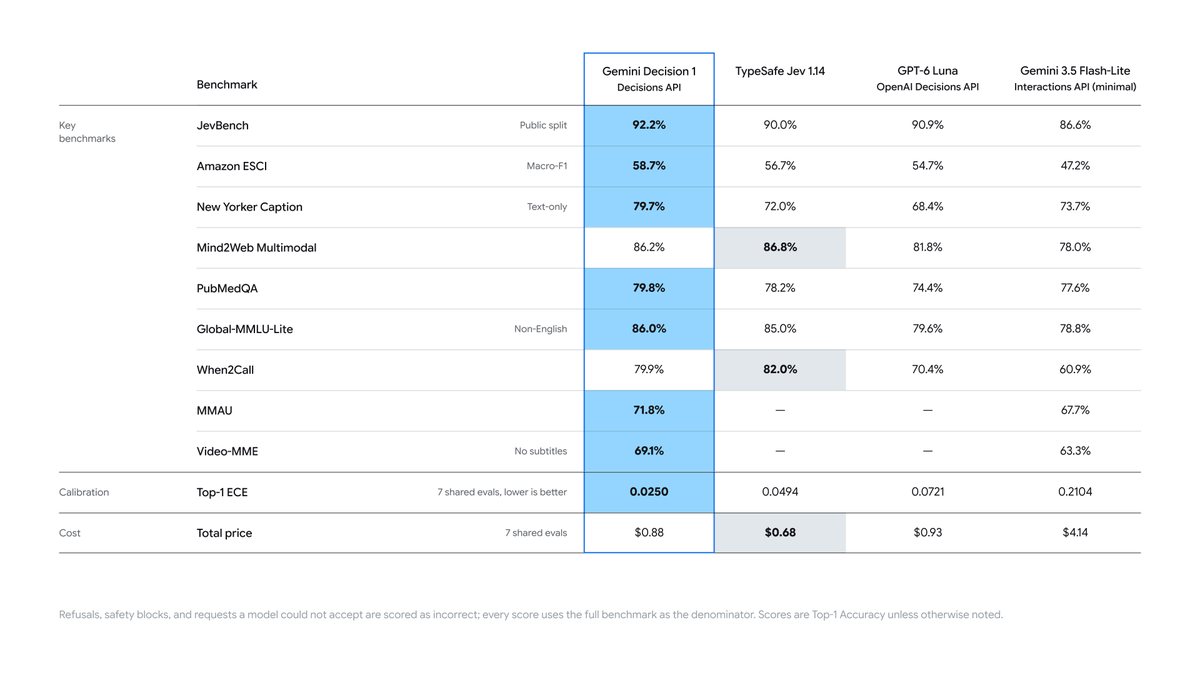
Google 11 月 11 日(北京时间 12 日凌晨)由 Sundar Pichai、@Google、@GoogleAIStudio 和 Logan Kilpatrick 正式宣布 Gemini Decisions API 与专用判定模型 Gemini Decision 1(gemini-decision-1)。它不逐 token 生成文字,而是一次前向计算给最多 1,000 个是否、单选(2–255 个选项)、打分题给出概率和置信度,支持文本、图片、音频、视频和 PDF,上下文 256K。官方称端到端延迟 150–250 毫秒,1 到 100 题延迟几乎不变;输入每百万 token 0.10 美元,输出不计费,在共享评测集上总成本约为 Gemini 3.5 Flash-Lite 的五分之一。官方跑分表中,它在 9 项评测里 7 项第一,7 项共享评测的 Top-1 校准误差 0.0250,低于 TypeSafe Jev 1.14 和 OpenAI 的 GPT-6 Luna。此前本站依据 API 更新日志报道时官方尚未公告,现已正式发布,此前「模型被撤下」的说法不成立。第三方 Artificial Analysis 测得其 Decision Index 为 66 分,尚未登顶。

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

核心要点速览

  • 官方正式发布:Sundar Pichai、@Google、@GoogleAIStudio、Logan Kilpatrick 同步宣布,模型 ID gemini-decision-1
  • 单次最多 1,000 个问题、上下文 256K;模型计算中位数 50–100 毫秒,端到端 150–250 毫秒(官方口径)
  • 官方跑分:9 项评测 7 项第一,如 JevBench 92.2%、Amazon ESCI 58.7%;Mind2Web 多模态 86.2% 和 When2Call 79.9% 落后 TypeSafe Jev 1.14
  • Top-1 校准误差 0.0250,TypeSafe Jev 1.14 为 0.0494、GPT-6 Luna 为 0.0721、Gemini 3.5 Flash-Lite 为 0.2104;第三方 Artificial Analysis:Decision Index v2.1 66 分,落后榜首 Drex Max v1.1 / GLiDE v1.2(73)7 分,Brier 0.18
  • 价格:输入 0.10 美元/百万 token、输出 0;7 项共享评测总花费 0.88 美元,Flash-Lite 为 4.14 美元,TypeSafe Jev 1.14 为 0.68 美元更便宜
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini Decision 1⚡ Gemini Decision 1🌐 Google
AD赞助内容

Google DeepMind 发布 AlphaProof Code:Gemini 4 Carbon 驱动智能体 4 周生成逾 600 万行 Lean 证明,首次把 Signal 协议形式化验证到 ARM 机器码

Google DeepMind 于 11 月 10 日发布 AlphaProof Code,这是一个多 LLM 智能体形式化验证框架:人类专家与模型一起把安全目标写成形式化规约,再由 Gemini 4 Carbon 驱动的智能体自动完成证明。团队用它证明了 Signal 协议核心实现的关键安全性质(如前向保密、设备被临时攻破后的恢复安全),一直验证到设备上实际运行的 AArch64 机器码。官方称这是首次对大规模部署的协议实现做到这种深度的形式化验证(无论是否借助 AI):4 周内生成超过 600 万行由 Lean 机器检查的证明,仅约 1% 需要人工复核;规约与证明已在 GitHub 开源。Signal CTO Ehren Kret 公开背书。

Google DeepMind 发布 AlphaProof Code:Gemini 4 Carbon 驱动智能体 4 周生成逾 600 万行 Lean 证明,首次把 Signal 协议形式化验证到 ARM 机器码

核心要点速览

  • 规模:智能体在 2026 年 10 月的 4 周内生成 600 万+ 行 Lean 证明,全部由 Lean 机器检查(官方口径)
  • 人工占比:智能体自审后只标出约 1% 的证明需要人类复核;规约则由人类专家逐条审过
  • 深度:证明直达 AArch64 机器码,覆盖 PQXDH 握手与 Triple Ratchet 等协议核心,不必信任 Rust 编译器
  • 反证测试:团队把 2 个历史上已修复的真实漏洞重新植入隔离版本,系统都给出了「该版本不安全」的机器检查证明
  • 开源:论文、Lean 规约与证明发布在 google-deepmind/code-verification,Signal CTO 公开背书
阅读全文

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

Google DeepMind 11 月 10 日与 Artificial Analysis 联合推出 MKA(Multimodal Knowledge Agent)基准,测 Agent 能否读懂建筑图纸、工程原理图、临床影像等视觉密集文件,并交付幻灯片、表格、报告和标注图。200 个私有任务覆盖 10 个行业、83 种职业,每题约 70 条专家评分项。Artificial Analysis 首批测了 21 个模型:Claude Fable 5.2(max)Climb WSR 57% 居首,Gemini 4 Carbon(high)54%,Claude Opus 5.5(max)53%;Fable 平均每题 31.97 美元,Carbon 为 6.29 美元。另有 10 道公开题已上 Hugging Face。

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

核心要点速览

  • 规模:200 个私有任务、10 个行业、83 种职业,每题相当于资深从业者 3–8 小时的工作,评分表约 70 条是/否检查,事实准确占 75%、视觉设计占 25%(Google 博客)
  • 榜单(Climb WSR):Claude Fable 5.2(max)57%、Gemini 4 Carbon(high)54%、Claude Opus 5.5(max)53%,共测 21 个模型(AA 榜单)
  • 成本:Fable 5.2 平均每题 $31.97,是 Carbon($6.29)的 5 倍多、GPT-6.1 Sol($1.11)的约 29 倍;最便宜的是 GPT-6 Luna(Max)$0.18
  • 没有全能冠军:Fable 5.2 领先 5 个行业,Opus 5.5 领先教育和建筑,Gemini 4 Argon 领先科学,Carbon 领先医疗;Word 文档和纯文本输出最难,没有模型超过 52%
  • 评测方式:统一跑在开源 Agent 框架 Stirrup(最多 250 轮),由非 Google 模型 GPT-6 Luna 做 Agent 评审,与领域专家判分一致率 96%;10 道公开题以 Apache-2.0 发布在 Hugging Face
阅读全文

Gemini 4 Carbon 全面开放:Gemini API 付费开发者与 Ultra 订阅用户今起可用,介绍期价格每百万 token 2 / 10 美元,Antigravity 同步预览多 Agent 协作 /swarm

Google 11 月 10 日宣布 Gemini 4 Carbon 正式向开发者、企业、科研人员和普通用户开放。两周前它只给 Fairwind 计划里的网络防御者使用,现在所有付费开发者可在 Google AI Studio、Android Studio 的 Gemini API 和 Gemini for business 中调用,Google AI Ultra 订阅用户可在 Gemini 应用、搜索 AI Mode、Antigravity 中使用。介绍期价格与 Argon 相同,每百万输入 / 输出 token 2 / 10 美元,11 月 30 日后涨到 4 / 20 美元。Google 还在 Antigravity 桌面应用和 CLI 预览斜杠命令 /swarm(Google AI Pro 与 Ultra 可用),可把一条提示交给协调者、并行工人和验证 Agent,在共享留言板上协作。Cursor 官方同步宣布 Carbon 已上线编辑器,高努力档在 CursorBench 4.0 以 60.4% 登顶。

Gemini 4 Carbon 全面开放:Gemini API 付费开发者与 Ultra 订阅用户今起可用,介绍期价格每百万 token 2 / 10 美元,Antigravity 同步预览多 Agent 协作 /swarm

核心要点速览

  • 开放范围:Gemini API 付费层(Google AI Studio、Android Studio)与 Gemini for business 面向所有付费开发者和企业;Google AI Ultra 订阅用户可在 Gemini 应用、搜索 AI Mode、Antigravity 和 AI Studio 使用(官方博客)
  • 价格:介绍期每百万输入 / 输出 token 2 / 10 美元(与 Argon 相同),11 月 30 日后为 4 / 20 美元
  • 第三方榜单(官方引用):在 CursorBench 4.0、Perplexity WANDR、Zapier AutomationBench 排名第一,单任务成本比第二名外部模型低 2 倍以上;与 Artificial Analysis 新推出的多模态知识 Agent 测评 MKA 排名第 2,平均单任务成本比第一名低 6 倍以上
  • 新功能:Antigravity 在应用和 CLI 预览 /swarm(Google AI Pro 与 Ultra):一条斜杠命令拉起协调者、隔离 worktree 工人和 @verifier,在共享留言板上协作,空闲不耗 token;可给 Agent 指定模型,CLI 用 /swarm board 或 Alt+S 看看板(Antigravity 博客、文档)
  • 安全数据:模拟网络攻击测试中拦截 99% 攻击轨迹,单次突破率 0.8%(Argon 为 3.1%);375 项 Agent 诚实度测评通过 92%(Argon 为 70%)
  • 定位:Argon 仍是多数编码和知识工作的首选,Carbon 用更多 token 深挖,适合多步调试、科研等最难任务
  • Cursor:官方宣布 Carbon 已上线编辑器,CursorBench 4.0 公开榜 High 60.4% 第一(默认 Medium 60.1%、Low 58.6%),高于 Fable 5.2 Max 的 60.0%,每任务成本约 9.22 美元 对 32.79 美元;属第三方模型,不计入套餐包含用量,介绍期至 11 月 30 日(Cursor 称五折),12 月 1 日起输入 / 缓存读取 / 输出为 4 / 0.20 / 20 美元(Cursor 文档、CursorBench)
  • GitHub Copilot:Carbon 已 GA,面向 Pro+、Max、Business、Enterprise,可在 VS Code、Visual Studio、Copilot CLI、coding agent、JetBrains、Xcode、Eclipse 中选择,按服务商标价用量计费,逐步推送(GitHub Changelog)
  • Perplexity:Carbon 上线 Perplexity Computer(Pro、Max)与搜索(Max),WANDR 得分 0.857、每任务 5.86 美元,与 Fable 5.2 持平、成本约 40%(厂商口径)
阅读全文

Google DeepMind 发布 Gemini Robotics 2.5:200 项任务成功率提升 30%–100%,Apptronik Apollo 2 在奔驰产线分拣零件成功率 96%,并开源机器人越狱测评 ASIMOV-Jailbreak

Google DeepMind 11 月 10 日发布 Gemini Robotics 2.5,称其为迄今最强的视觉-语言-动作(VLA)模型。官方在 200 多项任务上评测,相比此前基线成功率按任务类型提高 30% 到 100%,完成速度快 20% 到 30%。在与 Apptronik、奔驰合作的概念验证中,Apollo 2 人形机器人在匈牙利和德国的汽车产线上自主分拣零件,成功率 96%。模型目前只向机器人合作伙伴推送,开发者暂时无法直接调用。

Google DeepMind 发布 Gemini Robotics 2.5:200 项任务成功率提升 30%–100%,Apptronik Apollo 2 在奔驰产线分拣零件成功率 96%,并开源机器人越狱测评 ASIMOV-Jailbreak

核心要点速览

  • 任务广度:在 200+ 项任务上评测(系蝴蝶结、用夹子上菜、移液等),成功率比此前基线高 30%–100%,速度快 20%–30%(官方口径,官方博客)
  • 产线实测:Apptronik Apollo 2 在奔驰匈牙利 Kecskemét 和德国 Sindelfingen 工厂做零件配套分拣,成功率 96%(概念验证,非量产部署)
  • 安全:推理时安全引导让绕开障碍物的安全完成率提升 33%、在人附近提升 43%;新开源 ASIMOV-Jailbreak 测评,Gemini 4 Argon 抗越狱率 99.5%,上一代基线 Gemini Robotics ER 2 为 82%
  • 训练加速:Gemini 4 Argon 可从单个摄像头画面生成数字孪生和上千次模拟练习,并分析失败录像,DeepMind 称这把数月的训练工作提前完成
  • 可用性:目前只向机器人合作伙伴推送,未开放公共 API;支持 Apollo 2(22 自由度五指 SharpaWave 手)和 Franka Duo 双臂平台
阅读全文
关联模型 / 智能体 / 厂商:
⚡ gemini-robotics-2.5⚡ Gemini 4 Argon⚡ Gemini Robotics Er 2🌐 Google DeepMind🌐 Apptronik🌐 Mercedes benz

谷歌云推出 Gemini for healthcare 预览版:把 Gemini agent 接进医院与医保,27 个连接器覆盖 Epic、Oracle Health 等病历系统(只读),支持 HIPAA 合规

谷歌云 CEO Thomas Kurian 11 月 10 日宣布 Gemini for healthcare,即日起在美国以预览版提供。它把 10 月 Gemini at Work 上发布的通用 Gemini agent 扩展到医疗机构和医保方,由医疗技能、系统连接器、合作伙伴生态和统一治理平台四部分组成:可汇总跨院病历、诊前备好病历摘要、按保险政策整理预授权材料并起草申诉,也能帮医保方按医疗政策审核请求、解释自付费用。官方称平台支持 HIPAA 合规,临床数据不会用于训练谷歌的基础模型。

谷歌云推出 Gemini for healthcare 预览版:把 Gemini agent 接进医院与医保,27 个连接器覆盖 Epic、Oracle Health 等病历系统(只读),支持 HIPAA 合规

核心要点速览

  • 上线状态:美国预览版,即日起可用;与已有的法律、金融服务、政府服务行业方案并列(官方博客)
  • 连接器:官方列出 27 个,覆盖病历、资格与理赔、术语编码、医保政策、临床指南、办公协作和安全;Epic、Oracle Health 病历均为只读,不回写病历
  • 痛点数据:官方称临床人员每周约 28 小时花在手工核对分散的信息上(官方口径)
  • MCP 接入:InterSystems 提供 FHIR MCP Server,Keragon 用单个 MCP 集成连接 400+ 款医疗应用
  • 生态:16 家系统集成商(埃森哲、德勤、毕马威、普华永道、TCS 等)参与落地;支持多模型路由,简单行政步骤可交给低成本模型
阅读全文