AI 编程实时动态与要闻

llama.cpp 与 ggml 正式发布 v1.0.0:3.5 年来首个大版本,C API 改用语义化版本、破坏性变更必升主版本;同时移除 35 个废弃函数,新增 FP8 KV 缓存、MoE 专家缓存与 /v1/audio/speech

11 月 13 日,ggml-org 在 GitHub 发布 llama.cpp v1.0.0,并在 Hugging Face 博客宣布 llama.cpp 与 ggml 两个库同时进入 v1.0.0。今后 ./include 下公共 C API 出现破坏性变更时升主版本,向后兼容的新功能、后端和模型支持升次版本,纯修复升补丁版本。本次 release 移除 35 个废弃函数,把 NextN/投机解码 API 提升进 llama.h,新增 OCP FP8 KV 缓存、可设 CPU 分担比例的 MoE 专家缓存,加入 Kimi-K3.1-Pro 等新架构,llama-server 加固 SSRF/CORS/DNS rebinding 防护并新增 OpenAI 兼容的 /v1/audio/speech。作者 Georgi Gerganov 的发布帖约 4,180 赞。

llama.cpp 与 ggml 正式发布 v1.0.0:3.5 年来首个大版本,C API 改用语义化版本、破坏性变更必升主版本;同时移除 35 个废弃函数,新增 FP8 KV 缓存、MoE 专家缓存与 /v1/audio/speech

核心要点速览

  • 版本规则:MAJOR = ./include 公共 C API 破坏性变更;MINOR = 向后兼容的功能、后端、模型支持或 API 新增;PATCH = 不改 API 的修复
  • 破坏性变更:移除 llama_set_warmup、35 个废弃函数和 --defrag-thold;llama_set_embd_state_src 改名为 llama_set_ctx_state_src,嵌入 libllama 的项目升级前要改代码
  • 新能力:FP8 KV 缓存(-ctk/-ctv f8_e4m3)、MoE 专家缓存(moe_cache_size、moe_cache_cpu_share)、通过 --shard/--ple 加载外部 PLE 分片
  • llama-server 加固 SSRF、CORS、DNS rebinding 与 MCP 工具取消,新增 OpenAI 兼容 /v1/audio/speech,Web UI 重做(GitHub release)
  • 分发渠道包括 Docker、Debian、Homebrew、conda-forge、MacPorts、Winget 和 XCFramework;项目目前支持 150+ 种架构变体
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 网络安全指数:腾讯 Hy4 得 58 分排第 3,在 CWE-Bench-AA 漏洞修复测试中以 76% 登顶,每题成本 0.92 美元

独立评测机构 Artificial Analysis 11 月 13 日公布腾讯混元 Hy4 在其网络安全指数(Cyber Index)上的结果:综合 58 分,排第 3,比 DeepSeek V4.1 Flash 1017(max)高 1 分,落后于 Kimi K3.1 Pro(64)和仅限受信任访问的 GPT-6 Sol(Daybreak Blue,max,69)。在三项子测之一的 CWE-Bench-AA 上,Hy4 以 76% 的单次通过率排第 1,领先第 2 名 DeepSeek 6 到 7 个百分点。每道题平均成本 0.92 美元,平均输出 6.4 万 token,处在能力与成本的帕累托前沿上。

Artificial Analysis 网络安全指数:腾讯 Hy4 得 58 分排第 3,在 CWE-Bench-AA 漏洞修复测试中以 76% 登顶,每题成本 0.92 美元

核心要点速览

  • 综合排名:Cyber Index 58 分排第 3,前两名为 GPT-6 Sol(Daybreak Blue,max,仅受信任访问)69 分、Kimi K3.1 Pro 64 分;DeepSeek V4.1 Flash 1017(max)57 分紧随其后
  • 单项第一:CWE-Bench-AA 单次通过率 76%,DeepSeek V4.1 Flash 1017(max)69%、Grok 4.7(xhigh)68%
  • 性价比:每题 0.92 美元,比 Grok 4.7(xhigh)高 2 分而成本约为其 1/11;比 DeepSeek 高 1 分,成本约为其 2 倍
  • 输出更省:每题约 6.4 万输出 token,比 DeepSeek 少 43%、比 Grok 4.7 少 37%,但比 Kimi K3.1 Pro 多 49%
  • 评测口径:AA 按 0.834/2.501 美元每百万输入/输出 token 计价;OpenRouter 目前把 tencent/hy4 标为 0.417/1.25 美元,实际成本可能更低
阅读全文

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

11 月 12 日 SGLang Summit 期间,SGLang 团队与 AWS Annapurna Labs 宣布 SGLang-Neuron v0.1.0 开源并进入公开预览。它是 SGLang 的树外插件,设置 SGLANG_PLATFORM=neuron 即可在 Trainium 上用同样的服务器和 API 推理、生成 RL rollout,底层走 TorchNeuron 原生 PyTorch。AWS 同步上架 Deep Learning Container 镜像。大模型目前跑在 Trn3,扩散模型跑在 trn2.48xlarge。

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

核心要点速览

  • 开源与许可:GitHub sgl-project/sglang-neuron,Apache 2.0,v0.1.0 为公开预览,功能、API 和支持模型后续可能变化
  • 零改动接入:SGLang 本体不改,插件通过 entry points 注册 neuron 平台,固定在上游 commit 43881a7;镜像 tag 为 v0.1.0-neuron-py314-sdk-2.33.0
  • 大模型清单:GPT-OSS-120B、Qwen3 系列、Qwen3.5-397B-A17B、GLM-5.2(1M 上下文)、Kimi-K3(1 个 prefill 节点 + 2 个 decode 节点)等 8 种架构
  • 关键机制:全异步运行时、单次 NKI 内核调用跑完整个解码步的 giga-kernel、基于 NIXL + EFA 的 PD 分离、HiCache 主机内存前缀缓存
  • 扩散模型:FLUX.1-dev、FLUX.3-Action、MiniMax-H3、Wan2.2 A14B、LingBot-World-V2 跑在 Trainium2 上
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kimi K3⚡ GLM-5.2⚡ GPT-OSS-120B⚡ Qwen3.5-397B-A17B🌐 SGLang🌐 AWS🌐 RadixArk

X 热议:前 OpenAI 研究员 Will DePue 发布「检查点取证」报告,称在 DeepSeek、Kimi、MiniMax、蚂蚁 Ling 的 6 款开源模型权重里找到英伟达 Blackwell 初始化指纹;报告自称不能证明违反出口管制

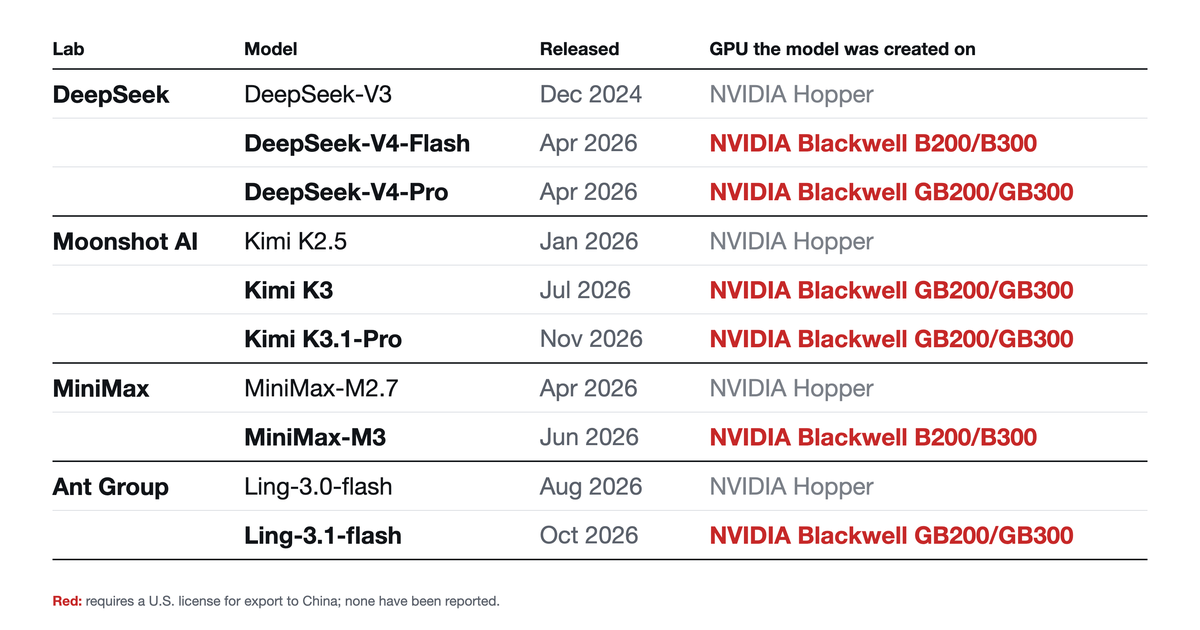
11 月 12 日,前 OpenAI 研究员 Will DePue 在 X 发帖并发布报告,称通过分析公开权重里残留的随机初始化模式,发现 DeepSeek-V4-Flash/Pro、Kimi K3/K3.1-Pro、MiniMax-M3、Ling-3.1-flash 六款模型是在英伟达 Blackwell 上初始化的,而这些公司更早的模型对应 Hopper。帖子约 205 万浏览、2 万赞。这是个人研究结论,不是官方认定;报告本身也写明,它不能确定芯片在哪里、如何获得,也不能确定是否违反出口管制。

X 热议:前 OpenAI 研究员 Will DePue 发布「检查点取证」报告,称在 DeepSeek、Kimi、MiniMax、蚂蚁 Ling 的 6 款开源模型权重里找到英伟达 Blackwell 初始化指纹;报告自称不能证明违反出口管制

核心要点速览

  • 6 款模型被判为 Blackwell 初始化(作者口径):DeepSeek-V4-Flash、MiniMax-M3 对应 B200/B300(148 个 SM);DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro、Ling-3.1-flash 对应 GB200/GB300(152 个 SM)
  • 方法:PyTorch 用 Philox 随机数按线程数填充初始权重,线程数由 GPU 的 SM 数决定;作者搜索约 6 万亿种「种子 + 布局」组合去匹配公开权重
  • 统计强度(作者口径):随机巧合最多约 8 sigma,六款模型的最强证据在 49–1,385 sigma 之间;在 24 个开发者公开过训练硬件的模型上,方法结论全部一致
  • 并非所有中国实验室:报告称 Qwen、GLM、腾讯、小米、阶跃的最新模型仍读作 Hopper,美团 LongCat-2.0 未发现英伟达指纹
  • 规模估算不确定:作者估计五次训练合计约 1.2 万张 Blackwell(区间 7,000–20,000),并明确说对估算「没有信心」;文中「OpenAI、Anthropic 资深研究员已独立验证」为其本人说法
阅读全文
AD赞助内容

豆包工作开放第三方模型:新增 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等,模型页标注额度倍率,豆包 2.1 Lite 与 DeepSeek V4.1 Flash 限时 0.01 倍

字节跳动旗下 AI Agent 办公产品「豆包工作」11 月 12 日宣布更新:在自研的豆包 2.1 Lite、豆包 2.1 Pro 之外,新增 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等第三方模型,用户可按任务自行切换。模型选择页直接标注额度消耗倍率,倍率越低越省:豆包 2.1 Pro 0.65 倍、GLM 5.3 0.80 倍、Kimi K3.1 Pro 0.95 倍,豆包 2.1 Lite 与 DeepSeek V4.1 Flash 限时降到 0.01 倍;简单小额任务仍免费,另有分时段额度优惠。此前 10 月 29 日该能力仅对团队和企业订阅开放。

豆包工作开放第三方模型:新增 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等,模型页标注额度倍率,豆包 2.1 Lite 与 DeepSeek V4.1 Flash 限时 0.01 倍

核心要点速览

  • 首批第三方模型:Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash;选择器里还可见 Kimi K3、GLM 5.3 Flash、DeepSeek V4 Pro
  • 额度倍率(界面截图口径):豆包 2.1 Pro 0.65x、GLM 5.3 0.80x、Kimi K3.1 Pro 0.95x、Kimi K3.1 Pro 高速 1.44x、Kimi K3 1.48x
  • 低倍率档:GLM 5.3 Flash 0.08x、DeepSeek V4 Pro 0.46x,豆包 2.1 Lite 与 DeepSeek V4.1 Flash 限时 0.01x
  • 「自动」模式下简单小额任务免费;工作日与节假日指定时段使用活动模型另有额度折扣
  • 10 月 29 日先向团队/企业订阅开放,11 月 12 日扩展到更广泛用户;新用户登录电脑版可领 30 天会员
阅读全文

Kimi K3.1 Pro 高速版上架 Amazon Bedrock:Global 定价 $4/$20 与月之暗面官方持平,Flex 档再打 5 折

AWS 于 2026-11-06 宣布 Moonshot AI 的 Kimi K3.1 Pro(Highspeed 高速版)上架 Amazon Bedrock,通过跨区域推理覆盖所有 Bedrock 区域,主打编码与文档处理类 Agent。官方模型卡显示 Global CRIS 每百万 Token 输入 $4、输出 $20、缓存读 $0.20,与 Kimi 官方高速版同价;US/印度区 +10%,Priority 档 1.75 倍、Flex 档 0.5 倍。

核心要点速览

  • 定价(AWS 官方模型卡):Global CRIS 输入 $4 / 输出 $20 / 缓存读 $0.20 / 缓存写 $5(每百万 Token)
  • US 与印度地理路由为 $4.40 / $22,比 Global 贵 10%
  • Priority 档按 1.75 倍计费,Flex 档 0.5 倍,即 Flex 约 $2 / $10,与 Kimi 官方标准版同价
  • 模型 ID moonshotai.kimi-k3.1,1M 上下文,支持显式 Prompt 缓存、工具调用、结构化输出与 Guardrails
  • 这是 Kimi K3 九月上架 Bedrock 之后,月之暗面旗舰第二次进入 AWS 托管目录
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 上线 VIALS-AA:Handshake 生命科学视觉推理榜,厂商口径 Gemini 4 Carbon 约 64% 居首

2026-11-06,Artificial Analysis(@ArtificialAnlys)发布 VIALS-AA:独立复跑 Handshake AI 的 VIALS(161 题、8 个科学图像域),用开源 harness Stirrup 配代码执行与看图工具,每题 3 次,主指标为三连全对(pass^3)。厂商口径:Gemini 4 Carbon (high) 约 64%,GPT-6 Astra (max) 约 63%,Claude Opus 5.5 (max+fallback) 约 61%;开源权重侧 Kimi K3.1 Pro 约 45%。

Artificial Analysis 上线 VIALS-AA:Handshake 生命科学视觉推理榜,厂商口径 Gemini 4 Carbon 约 64% 居首

核心要点速览

  • 来源:Artificial Analysis 官方文章/榜单 2026-11-06;基准任务来自 Handshake AI VIALS
  • 方法:161 题 × 3 次;Stirrup + 代码执行/看图;GPT-6 Luna (medium) 判分;主指标 pass^3
  • 前列(厂商口径):Gemini 4 Carbon (high) 64%、GPT-6 Astra (max) 63%、Claude Opus 5.5 (max+fallback) 61%
  • 成本与一致性:Sol 约 59% / ~$0.056 每题;Kimi K3.1 Pro pass@3 接近 Astra,但 pass^3 仅约 45%
  • 落地:artificialanalysis.ai/articles/vials-aa 与 /evaluations/vials-aa
阅读全文

月之暗面正式发布 Kimi Hosted Agents:Harness as a Service,云沙箱约 ¥0.072/小时,附 140+ Skills 与 kha CLI

2026-11-05,月之暗面官方宣布 Kimi Hosted Agents(托管智能体)正式发布,把 Agent 运行所需的 Harness 做成云服务:独立沙箱、会话持久化、失败恢复、审计导出,按「沙箱时长 + 模型 token + 插件次数」计费。官方称提供 140+ Skills、30+ 插件,可用 kha CLI / 控制台 / REST API(kimi-api-version: 2026-09-01-beta)接入,自托管沙箱仅对企业认证用户开放。

月之暗面正式发布 Kimi Hosted Agents:Harness as a Service,云沙箱约 ¥0.072/小时,附 140+ Skills 与 kha CLI

核心要点速览

  • 官方口径:2026-11-05 正式发布「Harness as a Service」,企业无需自建沙箱/会话/重试底座
  • 计费(官方定价页):总费用 = 沙箱时长×¥0.072/小时 + 模型推理 + Σ(插件次数×单价)
  • 能力包:官方称 140+ Skills、30+ 插件;产品概览列 12 个官方模板(金融/游戏/SRE/出海等)
  • 上手:platform.kimi.com;推荐 kha CLI install 后 kha login,亦可 REST/SSE
  • 边界:自托管环境与 Inference Hook 仅企业认证开放;API 仍标注 2026-09-01-beta
阅读全文

Artificial Analysis:腾讯 Hy4 在 Intelligence Index v5 获 35 分,中国实验室模型第 2,FrontierCode 2.0 达 31%

独立评测机构 Artificial Analysis 11 月 5 日(UTC 08:28)公布腾讯混元 Hy4 的 Intelligence Index v5 成绩:综合 35 分,与 Grok 4.7(xhigh)持平,落后 Claude Haiku 5.5(max)1 分;在中国实验室模型中仅次于 Kimi K3.1 Pro(46)。Agent 编码方面 FrontierCode 2.0 为 31%、Terminal-Bench 4.0 为 37%;单任务成本约 0.78 美元,约为同分 Grok 4.7 的十分之一。

Artificial Analysis:腾讯 Hy4 在 Intelligence Index v5 获 35 分,中国实验室模型第 2,FrontierCode 2.0 达 31%

核心要点速览

  • Intelligence Index v5 综合 35:与 Grok 4.7(xhigh)并列,落后 Haiku 5.5(max,36)1 分;中国实验室仅次于 Kimi K3.1 Pro(46)
  • FrontierCode 2.0 31%(中国实验室领先;DeepSeek V4.1 Flash 1017 max 28%,Kimi K3.1 Pro 25%),Terminal-Bench 4.0 37%
  • AA-Omniscience v1.1 准确率 50%,但幻觉率 89%(Kimi K3.1 Pro 幻觉率 37%);HLE-Diamond 33%
  • 单任务成本约 $0.78:约为同分 Grok 4.7 的 1/10、Qwen3.8 Max(34)的 1/13,约为 Haiku 5.5 的两倍
  • 定价约 $0.834/$2.501 每百万输入/输出 token,缓存读 $0.042;1M 上下文,支持图文输入
阅读全文

Together AI 发布 Together Compiler:智能体持续优化线上推理,最高提速 2.6 倍

Together AI 11 月 4 日发布 Together Compiler(TKCC),用一群 AI 智能体配合常驻推理引擎,按真实流量、模型和硬件持续重写推理内核,并提出「多态推理」(Polymorphic Inference)思路。官方称 24 小时内在 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等模型上最高提升 2.6 倍 TPS,客户负载最高快 50%,目前已在生产中服务每天数万亿 token。

核心要点速览

  • Together Compiler 把推理优化从传统编译问题改成「智能体搜索」问题:智能体提出内核改动,常驻引擎验证速度和正确性,只有通过的改动才上线
  • 官方称 24 小时内在 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 上最高 2.6 倍 TPS,客户负载最高快 50%
  • InferenceX 低延迟 batch size 1 设置下:MiniMax M3.1-Flash 1111 TPS、DeepSeek v4.1-Flash 1205 TPS(公司自报),SemiAnalysis 称已复核其中一项结果
  • 常驻引擎热加载候选前向计算,上线时间 9 秒(对比重启引擎 467 秒),实验吞吐比基线智能体优化系统高 252 倍
  • 已在 Together 生产环境服务每天数万亿 token,Together 已有 40 多个模型由智能体优化
阅读全文
AD赞助内容

月之暗面正式开放 Kimi K3.1 Pro 权重:2.8T 总参 / 104B 激活 MoE 上架 Hugging Face,MXFP4 量化约 1.56TB,自定义许可证限制大型 MaaS 商用

Kimi 官方账号 @Kimi_Moonshot 于 11 月 4 日 16:00(UTC)宣布开放 Kimi K3.1 Pro 模型权重,仓库 moonshotai/Kimi-K3.1-Pro 已公开、无需申请。模型卡显示它是 2.8T 总参、104B 激活的原生多模态 MoE,1M 上下文,权重以 MXFP4(量化感知训练)发布,仓库约 1.56TB;官方推荐 vLLM、SGLang 和 TokenSpeed 部署。许可证允许自由使用和修改,但年收入超 2000 万美元的 MaaS 业务需另签协议。

月之暗面正式开放 Kimi K3.1 Pro 权重:2.8T 总参 / 104B 激活 MoE 上架 Hugging Face,MXFP4 量化约 1.56TB,自定义许可证限制大型 MaaS 商用

核心要点速览

  • 架构:93 层(1 层稠密),69 层 KDA + 24 层 Gated DSA 注意力,896 个专家每 token 选 16 个外加 2 个共享专家,视觉编码器 MoonViT-V2(401M)。
  • 相比 K3,把全注意力的 Gated MLA 层换成了 Gated DeepSeek Sparse Attention,用于更高效的长上下文。
  • 模型卡厂商口径:Terminal-Bench 4.0 65.7(Opus 5.5 66.4)、SWE Marathon v1.1 51.7(Opus 5.5 46.3)、HLE-Full 带工具 70.0、BrowseComp 92.1;ProgramBench 31.5 明显落后 Opus 5.5 的 65.0。
  • 许可证:对外提供 MaaS 且连续 12 个月收入超 2000 万美元需与月之暗面另签协议;月活超 1 亿或月收入超 2000 万美元的产品须醒目标注「Kimi K3.1-Pro」,内部使用不受这两条限制。
阅读全文

Artificial Analysis 把六大职业能力指数升级到 v2.0:加重“不幻觉”和 Agent 工具调用权重,Claude Opus 5.5 六项全部第一

独立评测机构 Artificial Analysis 11 月 4 日在 X 上宣布,把金融会计、战略运营、法律、医疗、工程、经济六个 Capability Indexes 升级到 v2.0,与 Intelligence Index v5.0 的评测对齐,并更重视 Non-Hallucination(不编造)和 Agentic Tool Use。各指数统一把 HLE 换成 HLE-Diamond、AA-Omniscience 升到 v1.1,并移除 GDPval-AA;工程指数新增 Science 能力项。官方结果:Claude Opus 5.5 (max) 六项全部领先,GPT-6 Astra (max) 在金融会计、法律、工程排第二;开放权重阵营中 Kimi K3.1 Pro(权重尚未发布)六项都领先,排在第 5 到第 8 名。

Artificial Analysis 把六大职业能力指数升级到 v2.0:加重“不幻觉”和 Agent 工具调用权重,Claude Opus 5.5 六项全部第一

核心要点速览

  • 六个指数把 O*NET 职业任务映射到对应 benchmark,按能力在该职业中出现的频率加权(方法论页)
  • 通用改动:HLE 升为 HLE-Diamond,AA-Omniscience 升为 v1.1,各指数的 Agentic Knowledge Work 都去掉 GDPval-AA(改由 AA-Briefcase v1.1 承担)
  • 金融会计与法律指数中 Non-Hallucination 权重升到 15%;战略运营指数 Agentic Tool Use(AutomationBench-AA)升到 35%,为单项最高
  • 工程指数新增 Science(20%,CritPt v2 Hard Subset + Terminal-Bench-Science 0.1),Agentic Coding 加入 FrontierCode 2.0;经济指数用 GDP.pdf 取代 AA-LCR
  • 官方结果:Claude Opus 5.5 (max) 六项第一;开放权重中 Kimi K3.1 Pro 六项领先,MiniMax-M3.1-Flash 在战略运营(#10)、DeepSeek V4.1 Flash 1017 (max) 在医疗(#12)领先
阅读全文

Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

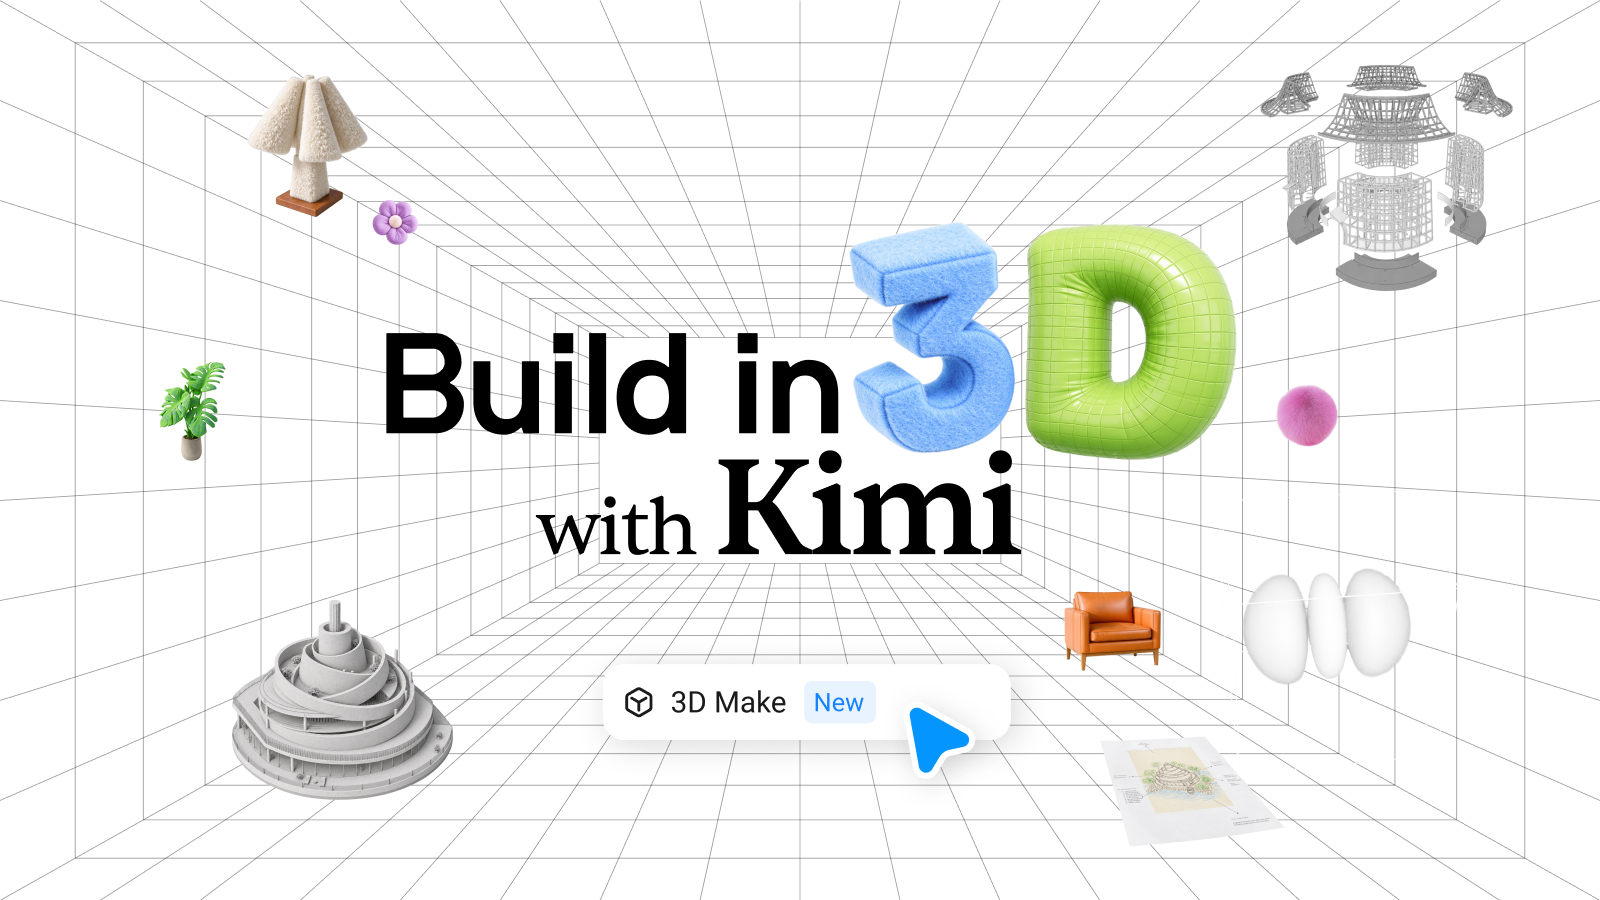
月之暗面 Kimi 官方账号 10 月 30 日 03:14(UTC)发布 3D Make,称 Kimi 可连接 Blender 和 CAD 等工具来建模、组装场景和开发游戏,已在 kimi.ai 和 Kimi Work 上线。官方同步发布的 3D 教程说明,K3.1 Pro 经过专门训练,通过 Python 脚本操作 3D 软件,即使没有 MCP 支持的专业软件也能纳入工作流;人物、动物等网格模型则自动调用 Tripo 等扩散模型生成。需要本地软件的插件仅在 Kimi Work 中可用。

Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

核心要点速览

  • 上线范围:3D Make 已在 kimi.ai 和 Kimi Work 提供,依赖本地软件的插件仅限 Kimi Work
  • 两种建模路线:参数化建模由 K3.1 Pro 写 Python 脚本完成(家具、机械件、建筑),网格建模自动调用 Tripo、Meshy、Hyper3D 等服务
  • 引擎适配:官方称已适配 Unreal Engine、Unity 和 Godot,可导入模型、搭场景、逐步实现玩法
  • 官方案例:K3.1 Pro 发布视频里的天宫场景用 Unreal Engine 5.8 制作,源模型合计 3600 万个三角形,用 Nanite 和 Lumen 渲染
  • 跑分:官方未公布 3D 相关基准,教程也承认部分任务需要多轮修改,骨骼绑定和复杂材质仍是短板
阅读全文

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文

Kimi 官方就 K3.1 Pro 订阅限流与额度误耗致歉:全体订阅用户一次性返还 25% 月度额度,并下调子 Agent 调用与输出长度

月之暗面官方账号 @Kimi_Moonshot 在 UTC 2026-10-25 20:14 发帖(原帖),承认 K3.1 Pro 订阅计划出现限流和不必要的额度消耗,称「这是我们的问题,本应更早修复」。补偿方案:所有计划的每位订阅用户获得一次性用量重置,返还 25% 月度额度(已用不足 25% 的直接清零),约等于一周用量,用量条将在太平洋时间当天结束前更新。官方同时调整了计划参数,减少不必要的子 Agent 调用和输出长度,让额度更耐用。

核心要点速览

  • 补偿力度:一次性返还 25% 月度额度,约等于 1 周用量(官方原帖)
  • 已用不足 25% 的用户用量直接清零,覆盖所有订阅计划
  • 生效时间:用量条在太平洋时间 10-25 当天结束前更新(约新加坡时间 10-26 15:00)
  • 根因方向:官方称将减少不必要的子 Agent 调用和输出长度,并调整计划参数
  • 背景:K3.1 Pro 于 10-23 发布,API 价格 $2/$10 每百万 token(官方口径)
阅读全文
关联模型 / 智能体 / 厂商: