AI 编程实时动态与要闻

RadixArk 用英伟达 Vera CPU 跑智能体强化学习沙箱:同样负载下每轮比 AMD Turin 快约 12%,满载时单路可扛 x86 的 1.3–2.1 倍

LMSYS 博客 11 月 13 日发布 RadixArk Miles 团队文章:开源 RL 后训练框架 Miles 首次把智能体强化学习的全部沙箱放到英伟达 Vera CPU 上端到端训练 GLM-4.7-Flash。在机器已被其他任务占满的条件下,沙箱放在 AMD EPYC Turin 上时每轮平均多花 12%;满载时 Vera 单路可承载的负载是 Xeon 6 的 1.3–1.5 倍、Turin 的 1.4–2.1 倍。

RadixArk 用英伟达 Vera CPU 跑智能体强化学习沙箱:同样负载下每轮比 AMD Turin 快约 12%,满载时单路可扛 x86 的 1.3–2.1 倍

核心要点速览

  • Miles 在 Vera 上跑了 68 个训练步、2,400 多轮,同步和全异步两种模式都无需改训练代码;为此把 Terminal-Bench 和 SWE-bench 中 530 个任务的环境重建为 arm64
  • 对照实验(同模型、同任务、同 GPU,每边 5 步 160 轮):沙箱放在 Turin 上每轮平均多 53 秒,其中智能体命令多 26 秒(慢 60%),验证器多 11 秒
  • 满载时 Vera 每核在 Python 和编译类工作上只慢 5%–22%,Turin 每核慢 40%–70%;176 个并发轮次的 Vera 仍快于只跑 24 轮的 Turin
  • 团队推算:推理再快 8 倍时,Turin 上每轮会比 Vera 长 33%,快 32 倍时长 41%(为推算值,非实测)
  • 以上均为 RadixArk 与英伟达合作的自测结果,x86 机器用 AWS 默认设置,Vera 用英伟达调优的启动参数
阅读全文
关联模型 / 智能体 / 厂商:

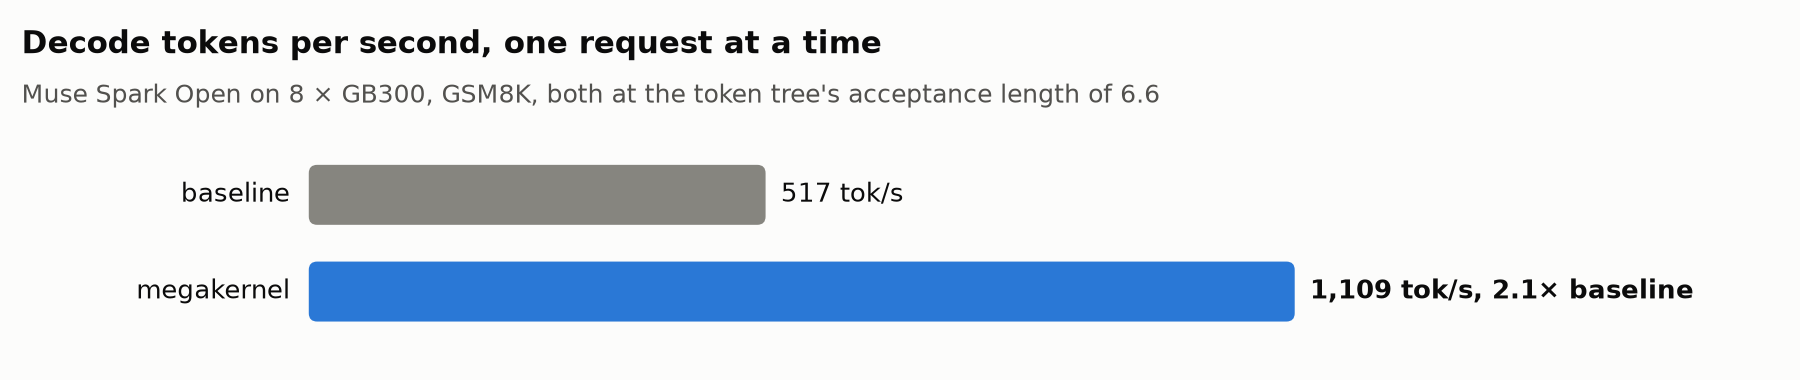
LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次

LMSYS 发布技术长文,介绍为 Meta 开源模型 Muse Spark Open 从零手写的 megakernel(CUDA C++ 与 PTX,约 8000 行):每个解码层只启动一次内核,把计算、显存加载和跨卡通信重叠起来。在 8 张 GB300 上,单请求解码速度从 SGLang 基线的 517 tok/s 提到 1,109 tok/s,约 2.1 倍;每个解码步从 12.9 毫秒降到 5.9 毫秒。代码以 SGLang 插件形式开源在 facebookresearch/sgl-muse-mega(MIT)。目前只支持 batch 1,属于实验功能,换来的是低延迟,不是更便宜的 token。

LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次

核心要点速览

  • 速度翻倍:8×GB300、TP8、GSM8K 单请求,解码 517 → 1,109 tok/s,约 2.1 倍(同一草稿模型、同一接受长度)
  • 内核启动大减:每个解码步从约 1,450 次内核启动降到 97 次,每层只启动一次
  • 单步耗时:12.9 毫秒 → 5.9 毫秒;其中验证 10.9 → 5.3 毫秒,草稿 1.16 毫秒 → 0.44 毫秒(草稿从 175 次启动降到 8 次)
  • 投机解码:DFlash V2 草稿每步猜 15 个 token,验证 16 个、平均接受 6.6 个;小米 MiMo-V2.5-Pro 为验证 8 个、接受 6.3 个
  • 适用范围:仅 batch 1,其他请求回退到普通 SGLang;8 张顶级 GPU 只服务一个用户,卖的是延迟而不是成本
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark Open⚡ MiMo-V2.5-Pro🌐 LMSYS🌐 SGLang🌐 Meta🌐 NVIDIA

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

11 月 12 日,开源推理引擎 SGLang 背后的非营利组织 LMSYS Org 在旧金山首届 SGLang 峰会开幕主题演讲上宣布成立 SGLang 联盟。创始成员包括NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal 和 RadixArk,它们将与 SGLang 维护者一起参与路线图制定,重点方向是前沿模型支持、推理与多模态负载、分布式推理和跨硬件优化。每家成员指派一名技术代表,每年参加两次路线图会议;技术决策和代码合入权仍归 SGLang 维护者,项目继续对整个社区开放。

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

核心要点速览

  • 创始成员 8 家:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk(SGLang 核心作者创办的公司),覆盖 GPU/CPU 芯片、云和推理服务商
  • 治理方式:每家指派一名技术代表,每年两次路线图会议,期间可组建工作组并公开进展;技术决策与代码合入仍由 SGLang 维护者负责
  • 四个重点方向:前沿模型支持、推理与多模态负载、分布式推理、跨硬件平台优化
  • 规模(官方口径):SGLang 跑在数十万张 GPU 上,用户包括 Meta、微软、Google、亚马逊、Thinking Machines Lab、Cloudflare、Reflection、Modal
  • 背景:LMSYS 引用德勤数据称,2026 年推理约占全部 AI 算力的三分之二,2025 年约为一半;首届峰会 11 月 12–13 日在旧金山 Fort Mason 举行,100 多位演讲者
阅读全文

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

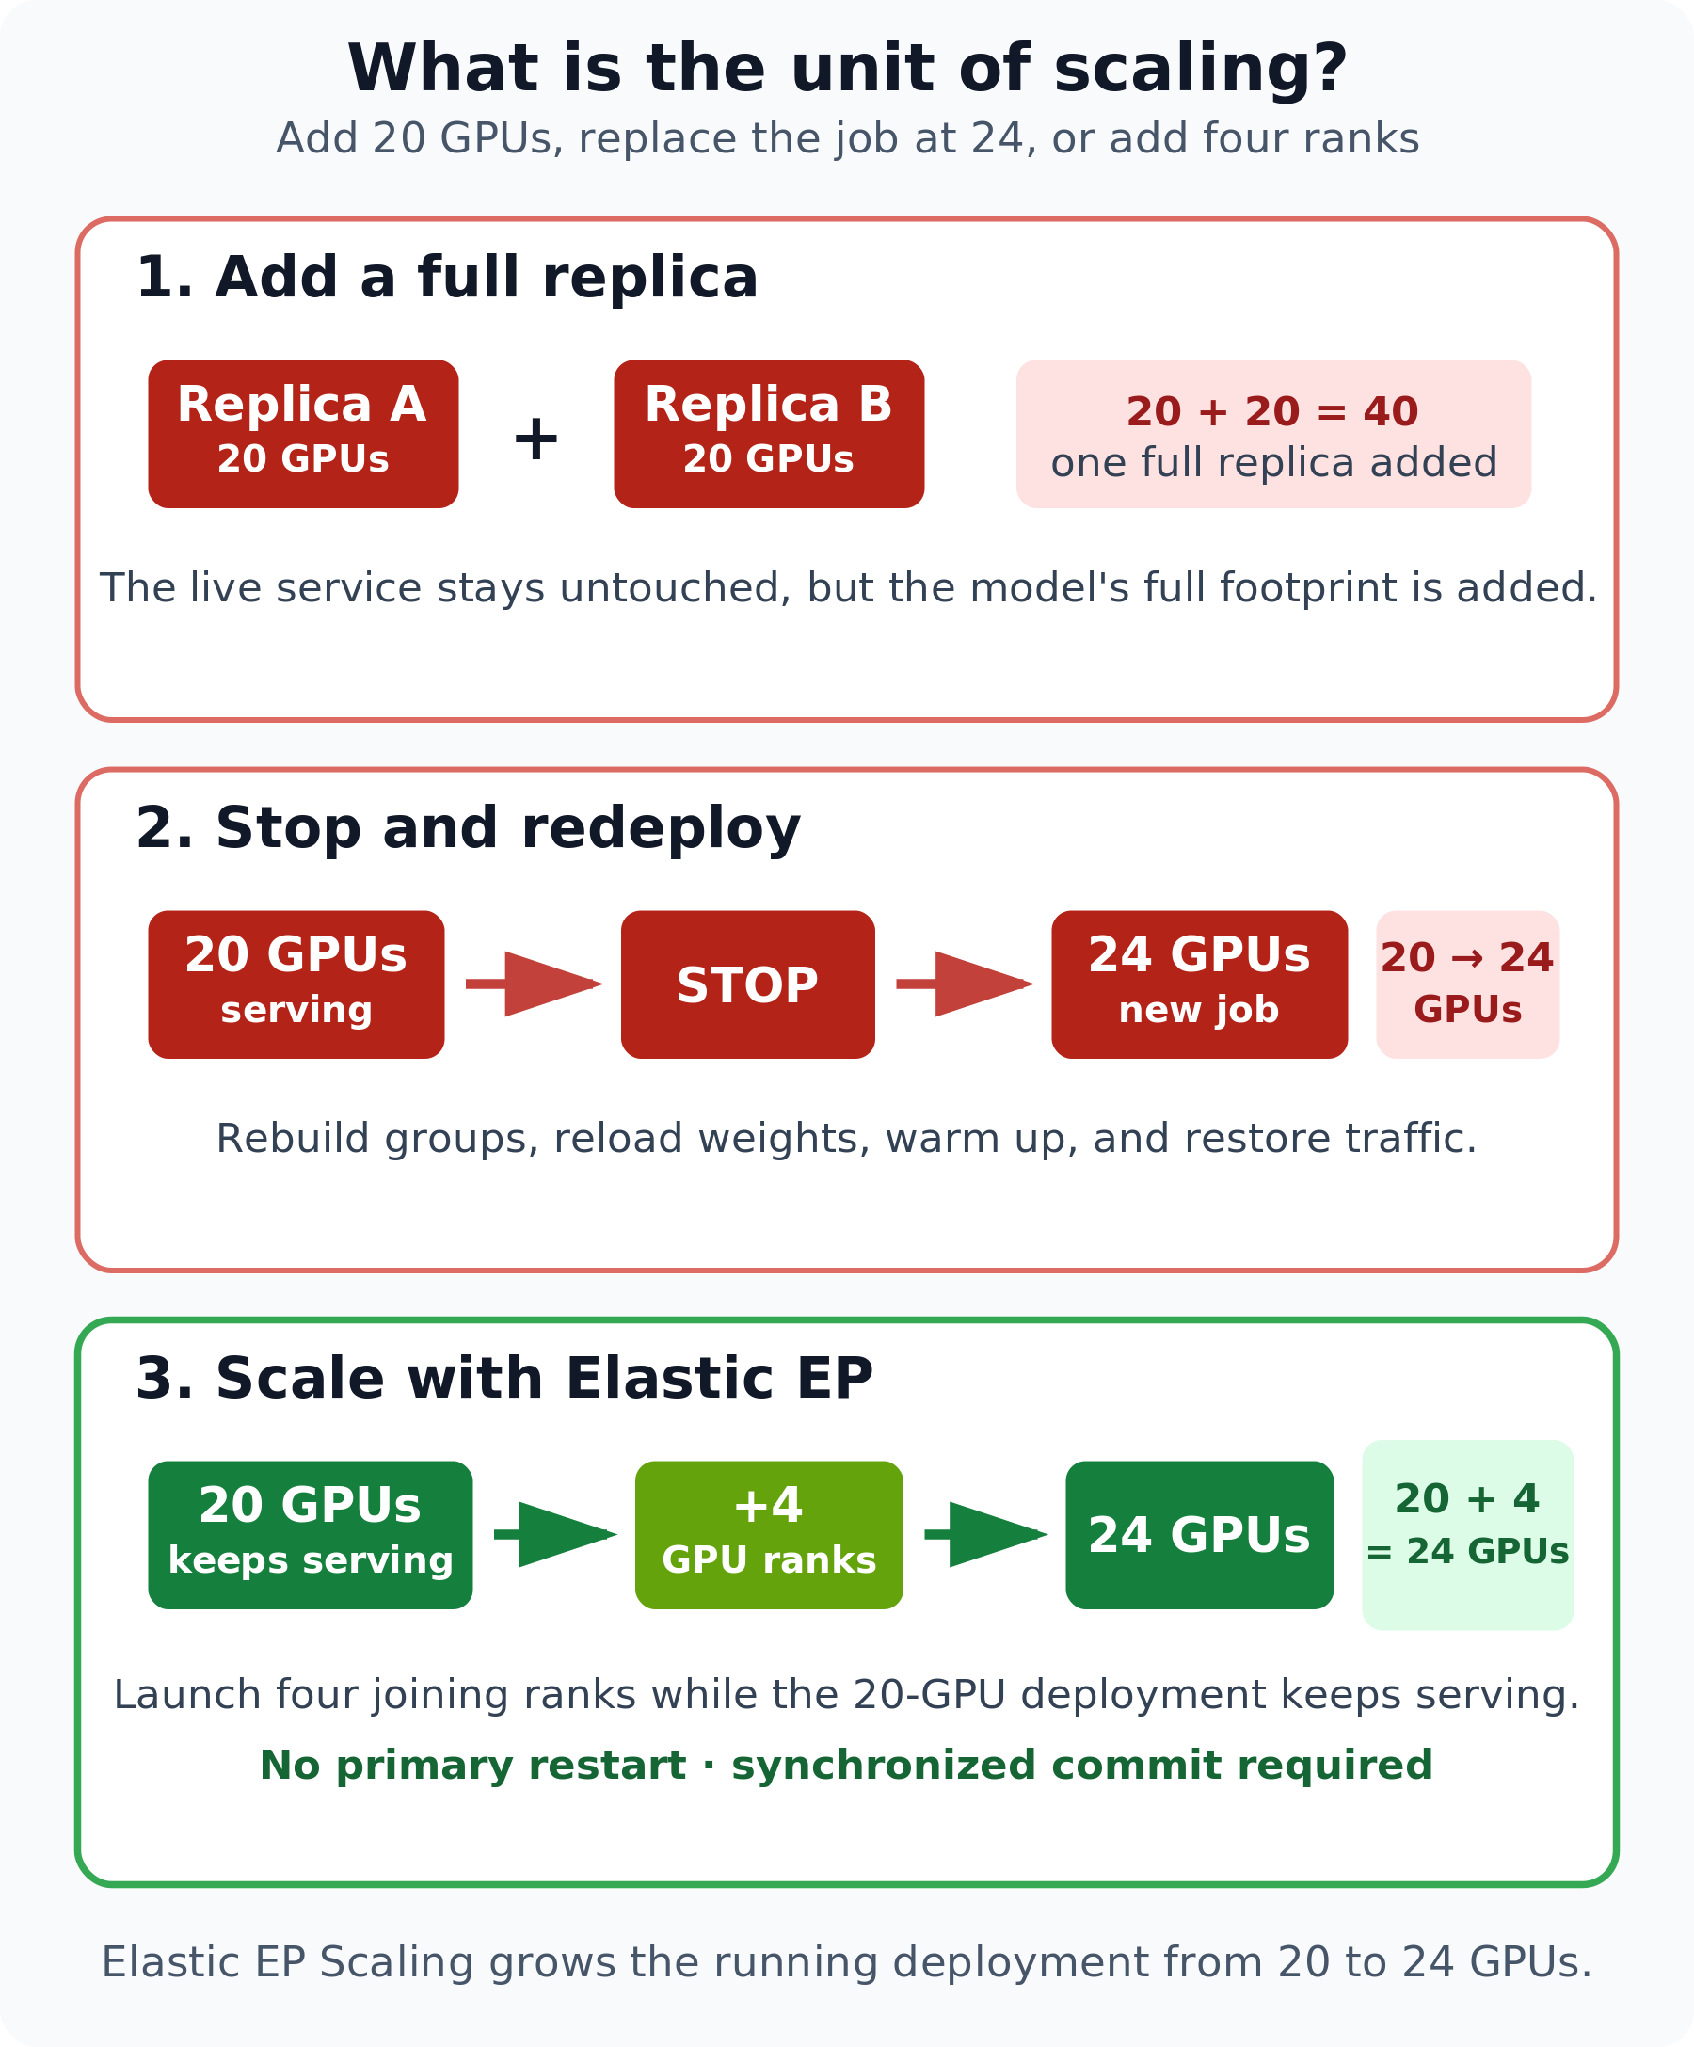
LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

核心要点速览

  • LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
  • 彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
  • 集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
  • 实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
阅读全文
AD赞助内容

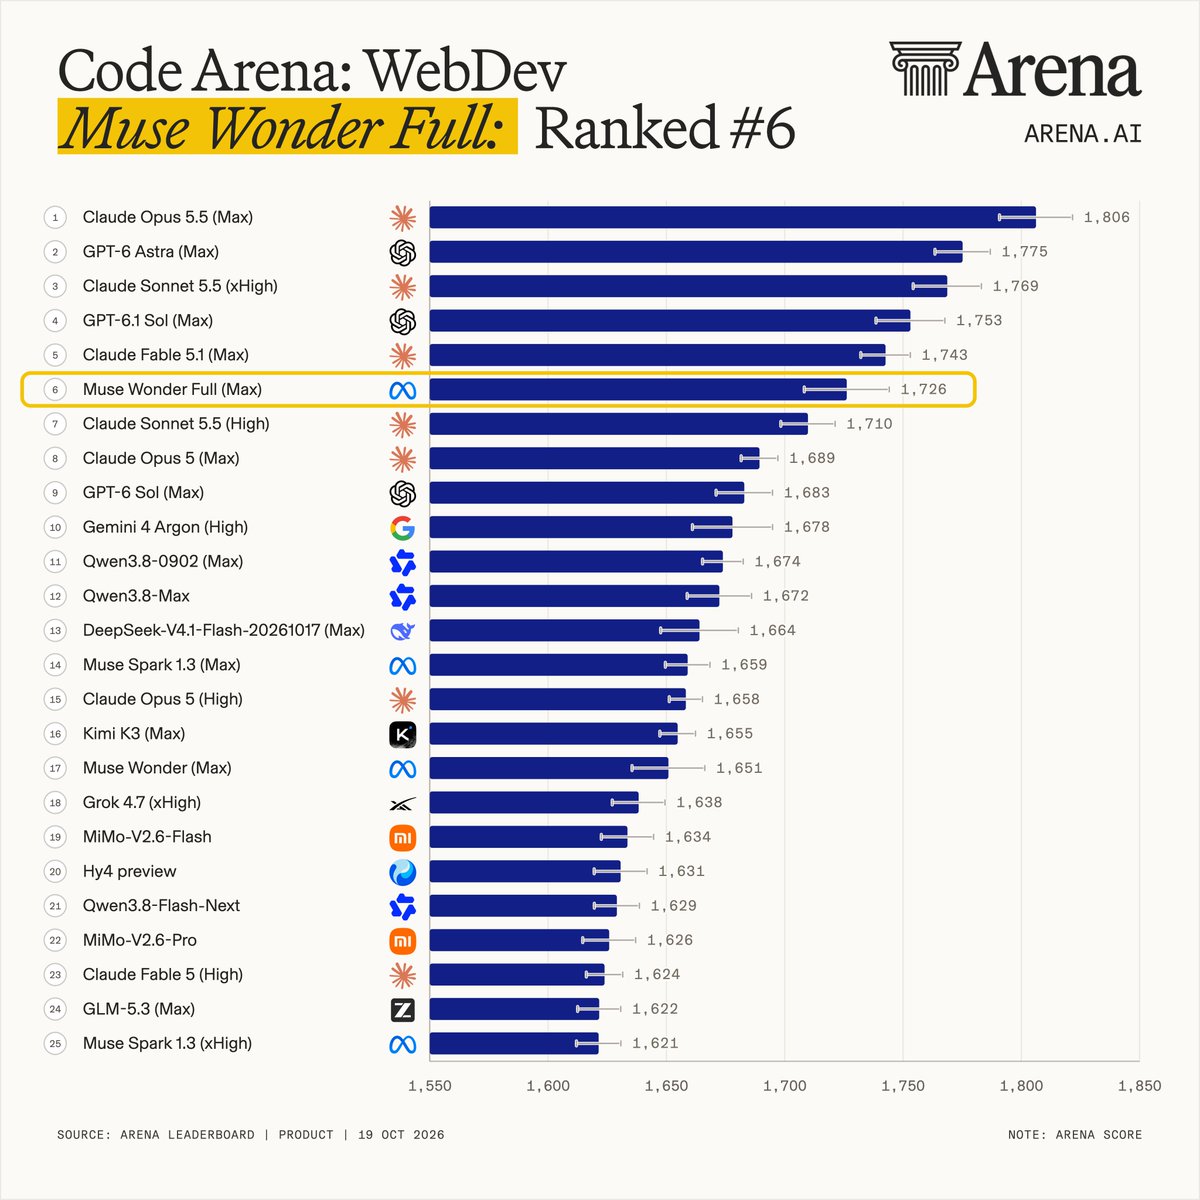
Meta 披露 Prometheus 吉瓦级超算集群:Muse Wonder 跃居 WebDev 竞技场第 6,助力 Meta 升至全球第三

Meta 官方正式披露其位于俄亥俄州新奥尔巴尼的吉瓦级(Gigawatt-Scale)AI 超算中心 Prometheus,拥有数十万张顶尖 GPU,在预训练中实现超 85% 的有效算力率(Goodput),在强化学习(RL)中达到 90% 以上。在此超级算力加持下,Meta 新一代代码与视觉旗舰模型 Muse Wonder Full 在 LMSYS Code Arena: WebDev 中斩获 1726 分跃居全球第 6 名(超越 Claude Sonnet 5.5 与 Gemini 4 Argon),推动 Meta 晋升全球前三大模型实验室。

Meta 披露 Prometheus 吉瓦级超算集群:Muse Wonder 跃居 WebDev 竞技场第 6,助力 Meta 升至全球第三

核心要点速览

  • Meta 披露位于俄亥俄州新奥尔巴尼的 Prometheus 吉瓦级超算集群,拥有数十万张 GPU 并实现 85%+ 预训练有效算力率
  • 强化学习有效算力率达 90%+,在 Muse Wonder 训练期间达成约 47,000 GPU·小时连续无故障运行
  • Muse Wonder Full 在 LMSYS Code Arena: WebDev 斩获 1726 分位列全球第 6,超越 Claude Sonnet 5.5(+16 分)与 Gemini 4 Argon(+48 分)
  • 推动 Meta 跃居全球第 3 大 AI 实验室,并同步推出可在单张消费级 GPU 上 4-bit 本地运行的 Muse Glimmer 30B
阅读全文
关联模型 / 智能体 / 厂商:

LMSYS Arena 开启 OpenAI GPT-Image-2.5 Sunburst 限时直接测评:图像生成与多轮编辑三榜登顶

LMSYS 官方宣布在竞技场(Arena)中开放 OpenAI 旗舰图像模型 GPT-Image-2.5 Sunburst 的专属“直接测试模式”(Direct Mode),限时测试 14 天(至 11 月 2 日)。该模型当前在 LMSYS 文生图(Text-to-Image)、单图编辑(Image Edit)及多图编辑(Multi-Image Edit)三大竞技场全部霸榜第一。测试期结束后将继续保留在匿名双盲对战与 Agent 模式中,用于持续校准真实世界 Elo 积分。

LMSYS Arena 开启 OpenAI GPT-Image-2.5 Sunburst 限时直接测评:图像生成与多轮编辑三榜登顶

核心要点速览

  • LMSYS 宣布在竞技场中开放 OpenAI GPT-Image-2.5 Sunburst 的直接测试模式(Direct Mode),限时测试 14 天至 11 月 2 日
  • 该模型当前横扫 LMSYS 文生图(Text-to-Image)、单图编辑(Image Edit)与多图编辑(Multi-Image Edit)三大竞技场全部斩获第一
  • 在复杂空间构图、长文本排版与多轮编辑的主体光影一致性上保持极高保真度,有效遏制了生成式编辑常见的风格漂移
  • 测试期结束后模型将继续保留在双盲对战与 Agent 模式中,用于持续校准全球大模型真实世界 Elo 积分
阅读全文
关联模型 / 智能体 / 厂商:

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

MiniMax 正式推出新一代旗舰轻量大模型 M3.1 Flash(此前以 Space Bunny 代号霸榜全球竞技场 200T+ Token)。模型支持 100 万 Token 原生上下文,百万输入/输出 Token 定价低至 0.15 / 0.60 美元(缓存读取仅 0.015 美元),推理速度较 M3 提升 3 倍且成本降低三分之二。在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,定于 10 月 23 日正式开源权重。

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

核心要点速览

  • MiniMax 正式发布新一代旗舰轻便大模型 M3.1 Flash,揭秘其正是此前霸榜竞技场超 200T Token 的神秘代号 Space Bunny
  • 支持 100 万原生超长上下文,百万输入/输出仅需 0.15 / 0.60 美元(缓存读取 0.015 美元),推理速度提升 3 倍且成本降低三分之二
  • 在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,游戏开发(+179 分)与参考设计(+155 分)大幅飞跃
  • Artificial Analysis 独立测评显示 Intelligence Index 达 42 分且 HLE 达 48%,完成基准测试消耗 Token 较竞品减少近半,权重将于 10 月 23 日全面开源
阅读全文
关联模型 / 智能体 / 厂商:

推理吞吐再迎质跃!SGLang v0.5.21 重磅发布:PD 分离免重启毫秒级热切换,Rust 内核前缀缓存全面领跑

作为全球开源大模型高并发高吞吐推理引擎的标杆,SGLang 正式推出里程碑版本 v0.5.21,凝聚了 227 位贡献者的 779 项重要提交。该版本在分布式推理架构与长文本处理上带来突破性飞跃:首创 PD(Prefill-Decode)分离实例动态在线角色切换机制,无需停机重启即可在毫秒级自适应调节预填充与解码算力配比;底层前缀缓存(Prefix Cache)默认升级至高性能 Rust 核心,大幅降低内存管理损耗与锁争用;同时针对 DeepSeek-V4.1 长文本场景实现首 Token 延迟降低 22%,全面适配 MiMo-V2.6 与 AMD MI355X 硬件生态。

推理吞吐再迎质跃!SGLang v0.5.21 重磅发布:PD 分离免重启毫秒级热切换,Rust 内核前缀缓存全面领跑

核心要点速览

  • 首创 PD 分离实例免重启毫秒级动态热切换,自适应长短文本并发负载彻底根除算力闲置
  • 前缀缓存默认升级至原生 Rust 高性能内核,DeepSeek-V4.1 长文本首 Token 延迟锐降 22%
  • Kimi K3 预填充吞吐跃升 20.6%,全面适配 AMD MI355X 硬件生态与 GLM-5.3-Flash
阅读全文

Code Arena WebDev:GPT-6 Astra (Max) 1800 分登顶,Claude Fable 5.1 居次 1758

LMSYS Arena 更新 Code Arena: WebDev 排行:OpenAI GPT-6 Astra (Max) 以 1800 分位列第一,Anthropic Claude Fable 5.1 (Max) 以 1758 分居次。匿名对战胜率显示 Astra 相对多数模型占优,对 GPT-5.6 Sol (xHigh) 胜率约 72.5%。

核心要点速览

  • WebDev 榜:GPT-6 Astra (Max) 1800 分第一,Claude Fable 5.1 (Max) 1758 分第二
  • 匿名对战胜率显示 Astra 对多数对手占优
  • 对 GPT-5.6 Sol (xHigh) 胜率约 72.5%
阅读全文

Arena:编码智能体「原生 harness」影响远小于预期,21 组模型-工具链对比

LMSYS Arena 发布编码智能体 harness 研究:对比 Claude Code、Codex CLI 与 Pi 等原生工具链对模型表现的影响。基于 21 组模型-harness 配对的严格评测,结论是 harness「税」远小于社区常见假设,模型本身仍占主导;详情见 Arena 博客。

核心要点速览

  • 对比 Claude Code、Codex CLI、Pi 等原生编码 harness 对智能体表现的影响
  • 21 组模型-harness 配对评测显示 harness 影响小于常见假设
  • 结论:模型能力仍是主因,更多 Arena 相关结果将陆续公布
阅读全文
AD赞助内容

LMArena:GPT-6 Astra (Max) 登顶 Code Arena WebDev(1797),领先 Fable 5.1 Max 35 分

LMArena 公布实战结果:OpenAI GPT-6 Astra (Max) 以 1797 分登顶 Code Arena WebDev,领先第二名 Claude Fable 5.1 (Max) 1762 分约 35 分,并高于 Claude Opus 5 (Max) 与 GPT-5.6 Sol (xHigh)。同时在约 $40/Mtoken(与最新 Claude 定价对齐)处重塑质量-价格帕累托前沿,覆盖含多步推理与工具调用的 agentic WebDev 任务。

核心要点速览

  • Astra (Max) WebDev 1797 分,领先 Fable 5.1 Max(1762)约 35 分。
  • 在约 $40/Mtoken 处成为最佳性价比前沿,对齐最新 Claude 定价。
  • 评测覆盖多步推理与工具调用的 agentic WebDev 工作流。
阅读全文