AI 编程实时动态与要闻

Artificial Analysis Controlled Voice Arena:Speechify Simba 3.5 以 1192 Elo 登顶,与 HeyGen Voice 统计持平,每百万字符 6.58 美元仅为后者约五分之一

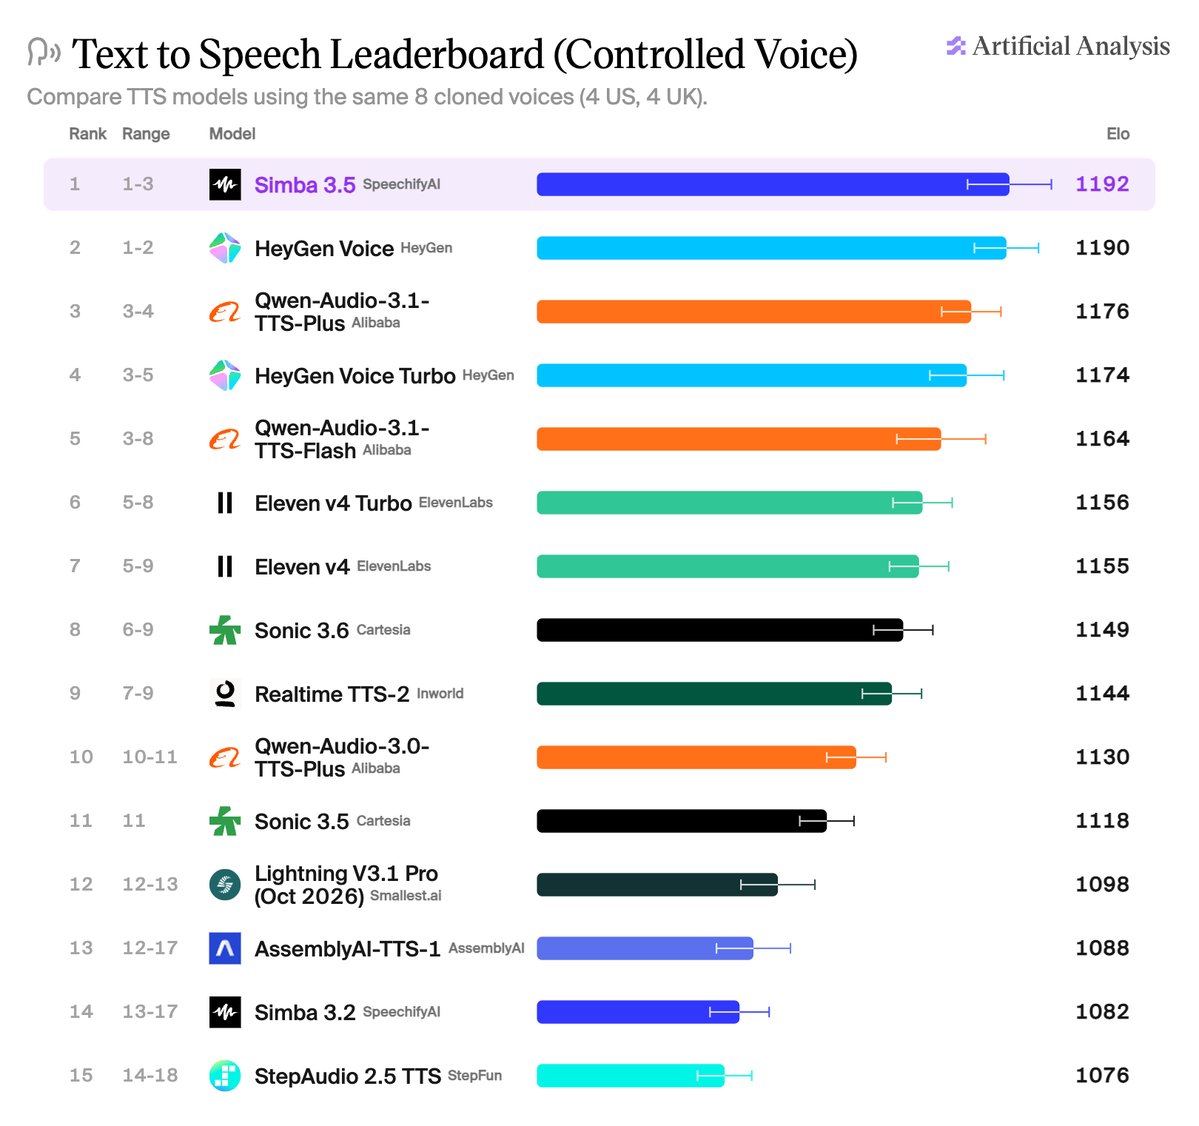
Artificial Analysis 11 月 13 日公布,Speechify 的语音合成模型 Simba 3.5 在 Controlled Voice Arena 排名第一,与 HeyGen Voice 统计持平。该榜所有模型都用同一组 8 个克隆声音(4 个美音、4 个英音)朗读,用户盲听投票,比的是模型本身而非演示音色。榜单显示 Simba 3.5 为 1192±17 Elo(1,783 个样本),HeyGen Voice 1190±13,Qwen-Audio-3.1-TTS-Plus 1176 居第三;Simba 3.5 API 价每百万字符 6.58 美元,HeyGen Voice 为 30 美元。
Artificial Analysis Controlled Voice Arena:Speechify Simba 3.5 以 1192 Elo 登顶,与 HeyGen Voice 统计持平,每百万字符 6.58 美元仅为后者约五分之一

核心要点速览

  • Controlled Voice Arena 让所有模型使用同一组 8 个克隆声音(4 美音、4 英音),用户盲听投票,排除「挑一个好听的演示音色」带来的偏差
  • Simba 3.5 为 1192±17 Elo(95% 区间 1175–1209,1,783 个样本),名次区间 1–3;HeyGen Voice 1190±13,名次区间 1–2,两者统计上持平
  • 第三至第五:Qwen-Audio-3.1-TTS-Plus 1176、HeyGen Voice Turbo 1174、Qwen-Audio-3.1-TTS-Flash 1164;Eleven v4 Turbo 1156、Eleven v4 1155 分列第六、第七
  • 价格(按各家 API 生成 100 万字符计):Simba 3.5 6.58 美元,HeyGen Voice 30 美元,HeyGen Voice Turbo 4 美元,Eleven v4 80 美元
  • 同一榜单上 Speechify 的上一代 Simba 3.2 为 1082 Elo,排第 14;AA 帖子还称 Simba 3.5 在 Provider Voice(厂商自带音色)榜排第 5
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Simba 3.5⚡ HeyGen Voice⚡ Qwen-Audio-3.1-TTS-Plus⚡ Eleven v4🌐 Artificial Analysis🌐 Speechify🌐 HeyGen🌐 Alibaba🌐 ElevenLabs

X 热议:Artificial Analysis 称 Gemini 4 Carbon 在机械臂评测 AA-Robotics 里连跑 7 小时 33 分,把夹爪撞坏了,重试是否该算分引发讨论

独立评测机构 Artificial Analysis(AA)11 月 12 日中午(新加坡时间)在官方账号发帖:Google 的 Gemini 4 Carbon 在 AA-Robotics v0.1 实验室里一共跑了 7 小时 33 分钟,过程中把机械臂「撞来撞去」,弄坏了一个夹爪,AA 给了它一次重试。帖子附 11 秒现场视频,约 2 万浏览、300 余赞、40 余条回复。讨论集中在三点:重试成绩是否该单列、通用模型连续操控真实硬件 7 个多小时意味着什么、以及物理评测里的设备损耗和安全看护成本。AA 尚未公布 Carbon 在该榜的得分。以下为评测方分享与社区讨论,不代表最终榜单。

X 热议:Artificial Analysis 称 Gemini 4 Carbon 在机械臂评测 AA-Robotics 里连跑 7 小时 33 分,把夹爪撞坏了,重试是否该算分引发讨论

核心要点速览

  • AA 口径:Gemini 4 Carbon 在 AA-Robotics v0.1 实验室累计 7 小时 33 分,撞坏 1 个夹爪,AA 给了 1 次重试
  • AA 尚未公布 Carbon 的得分,也没说明重试成绩如何计入;当前榜首仍是 Claude Fable 5.2(75 分)
  • 按 8 项任务粗算约合每题近 1 小时;首发榜单上 GPT-6 Astra 平均每题约 30 分钟,人类约 20 秒
  • 热度:约 2 万 浏览、300+ 赞、40+ 回复、16 条引用
  • Carbon API 介绍期价格每百万输入 / 输出 token 2 / 10 美元,11 月 30 日后为 4 / 20 美元(Google 官方口径)
阅读全文

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

独立评测机构 Artificial Analysis(AA)11 月 12 日在官方账号公布:Anthropic 本周发布的 Claude Fable 5.2 在 AA-Robotics v0.1 上得分 75,成为新榜首,高于此前第一的 GPT-6 Astra(69)和 GPT-6.1 Sol(65)。这项评测让编码 Agent 通过 HTTP API 操控一台 6 轴机械臂完成 8 项桌面任务。AA 称 Fable 5.2 是第一个在「测量盒子尺寸」任务上得分的模型:它只靠摄像头视频,把场景里的卷尺当作比例尺来估算盒子尺寸。上一代 Fable 5.1 在 10 月首发榜单上只有 46.3 分。

Artificial Analysis:Claude Fable 5.2 以 75 分登顶机械臂评测 AA-Robotics v0.1,超过 GPT-6 Astra 的 69 分,并成为首个在「量盒子」任务上拿到分数的模型

核心要点速览

  • AA-Robotics v0.1 新榜首:Claude Fable 5.2 75 分,GPT-6 Astra 69、GPT-6.1 Sol 65(AA 口径)
  • 比上一代大跳:Fable 5.1 在 10 月首发榜单上为 46.3,Opus 5.5 为 48.8
  • 「量盒子」任务(长宽高误差需在约 2 毫米内)此前所有模型均未得分,Fable 5.2 是第一个
  • Fable 5.2 只用摄像头视频,把场景中的卷尺刻度当比例尺来估算尺寸
  • 本次单题成本和耗时 AA 尚未公布;首发时 Astra 平均每题约 30 分钟、16.36 美元
阅读全文

Hugging Face Harness Leaderboard 加入 DeepSeek Harness:DSH 在全部 5 组评测中与第一名统计持平,DeepSWE 排第 2,Terminal-Bench 因收尾时关掉后台服务仅排第 6

Hugging Face 研究员 Joël Niklaus 11 月 11 日宣布,DeepSeek 开源编码 Agent DeepSeek Harness(DSH,开发者预览版 0.2.2-rc.1)已加入他维护的 Harness Leaderboard。该榜单固定模型和推理力度、只换 harness,比较 10 款编码 Agent。作者口径:DSH 在 DeepSeek-V4.1-Flash、GLM-5.3-Flash(低/高推理力度)和 Flint 共 5 组评测中都与第一名统计持平;DeepSWE 三模型平均排第 2,仅比 Nous Research 的 Hermes Agent 低 0.5 分;Terminal-Bench 排第 6。主要原因是 DSH 结束任务时会关掉自己启动的后台程序,3 道要求留着服务器给评分器检查的任务 36 次只过 2 次,每组评测因此丢 1.5–1.7 分。平均每解出一题花费 0.53 美元。这是个人维护的研究榜单,并非 DeepSeek 或 Hugging Face 官方公告。

Hugging Face Harness Leaderboard 加入 DeepSeek Harness:DSH 在全部 5 组评测中与第一名统计持平,DeepSWE 排第 2,Terminal-Bench 因收尾时关掉后台服务仅排第 6

核心要点速览

  • 榜单固定模型只换 harness,比较 10 款编码 Agent;DSH 在 5/5 组评测中与第一名统计持平(作者口径)
  • DeepSWE 三模型平均排 第 2,比 Hermes Agent 低 0.5 分;Terminal-Bench 排 第 6
  • 3 道需保留服务器的 Terminal-Bench 任务:DSH 2/36 通过,OpenCode、Pi、Hermes Agent 均为 36/36
  • 这 3 题让 DSH 每组评测丢 1.5–1.7 分;在 DeepSeek-V4.1-Flash 高推理力度下超过它与第一名的 1.3 分差距
  • 平均每解出一题 0.53 美元;测试版本 0.2.2-rc.1,因需 DeepSeek 账号密钥关闭了网页搜索
阅读全文
AD赞助内容

ACE Studio 新音乐模型 ACE Music v1 登顶 Artificial Analysis 人声音乐榜:Elo 1160,领先 Suno v6 的 1144,暂无 API

第三方评测机构 Artificial Analysis 11 月 11 日公布,ACE Studio 的新音乐生成模型 ACE Music v1 以 Elo 1160 首次上榜即排在 AA-Music-Vocal v1.1 第 1,领先 Suno v6(1144)和 Suno v6-mini(1132)。排名来自 AA 认证私有评审员的盲测投票。ACE Music v1 能根据文字描述或用户自己的歌词生成带人声或纯器乐的完整歌曲,AA 实测它在雷鬼/舞厅和古典/管弦乐提示上表现最好。该模型目前没有 API,只能在 ACE Music 应用里用,免费档每天 20 积分,付费档按年付最低每月 7.90 美元。

ACE Studio 新音乐模型 ACE Music v1 登顶 Artificial Analysis 人声音乐榜:Elo 1160,领先 Suno v6 的 1144,暂无 API

核心要点速览

  • 榜单:AA-Music-Vocal v1.1 前 5 为 ACE Music v1(Elo 1160)、Suno v6(1144)、Suno v6-mini(1132)、Mureka V9.5(1101)、Mureka V9(1063),领先第 2 名 16 分
  • 评测方式:AA 认证私有评审员盲测投票,AA 称 ACE Music v1 在雷鬼/舞厅、古典/管弦乐两类提示上最强
  • 可用性:没有 API,只在 ACE Music 应用内使用;免费档每天 20 积分(约 10 首),不能下载、不可商用
  • 定价(官网口径,按年付):Creator 每月 7.90 美元,1000 积分(约 500 首)并含商用授权;Artist 每月 16.58 美元,约 1250 首
  • 背景:ACE Studio 成立于 2018 年,以 AI 歌声合成起家,并与阶跃星辰(StepFun)合作开发开源权重音乐模型系列 ACE-Step
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ace Music V1⚡ Suno V6⚡ Suno V6 mini⚡ mureka-v9.5⚡ ace-step-1.5🌐 ACE Studio🌐 Artificial Analysis🌐 Suno🌐 StepFun

字节 Seed 发布图像模型 Seedream 5.5:百轮连续编辑保持未改区域像素级不变,原生输出 RGBA 透明素材,官方口径严重文字崩坏率降至 0.4%

11 月 9 日,字节跳动 Seed 团队发布新一代图像创作模型 Seedream 5.5。三项主要升级:多轮编辑时非编辑区域像素级保持、消除色偏,支持围绕同一张图连续编辑 100 轮;原生输出带 Alpha 通道的透明/半透明 RGBA 素材,省去抠图;光照、材质、皮肤纹理更接近实拍,密集小字渲染更准。官方在 MagicArena 平台做专家评测:相比 Seedream 5.0 Pro,六类生产场景可用率和评分全部提升,影视与办公场景可用率翻倍以上;严重文字崩坏率 0.4%、轻微 1.7%,并称文字结构与文生图真实感领先 GPT Image 2.5 Sunburst 和 Nano Banana 2.1。以上均为厂商口径,没有第三方公开榜单。中文版博客称正陆续上线即梦、豆包、豆包工作和火山方舟;英文版称即将登陆 Dreamina、CapCut 和 BytePlus。后续还会推出 Pro 版本。

字节 Seed 发布图像模型 Seedream 5.5:百轮连续编辑保持未改区域像素级不变,原生输出 RGBA 透明素材,官方口径严重文字崩坏率降至 0.4%

核心要点速览

  • 编辑:同一张图支持 最多 100 轮 连续编辑,非编辑区域 像素级保持、消除色偏
  • 素材:原生输出 RGBA 透明/半透明图像,可直接进入排版和合成流程,无需抠图
  • 文字:官方口径 严重文字崩坏率 0.4%、轻微 1.7%,覆盖中英文和密集小字
  • 对比前代:六类场景可用率全部提升,影视、办公场景可用率超过 Seedream 5.0 Pro 的 2 倍;真实感图生图 GSB +55.62%
  • 上线:即梦、豆包、豆包工作、火山方舟(中文版);Dreamina、CapCut、BytePlus(英文版);API 价格官方博客未公布,Pro 版后续推出
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Seedream 5.5⚡ Seedream 5.0 Pro⚡ GPT Image 2.5 Sunburst⚡ Nano Banana 2.1🌐 ByteDance (字节跳动)🌐 OpenAI🌐 Google DeepMind

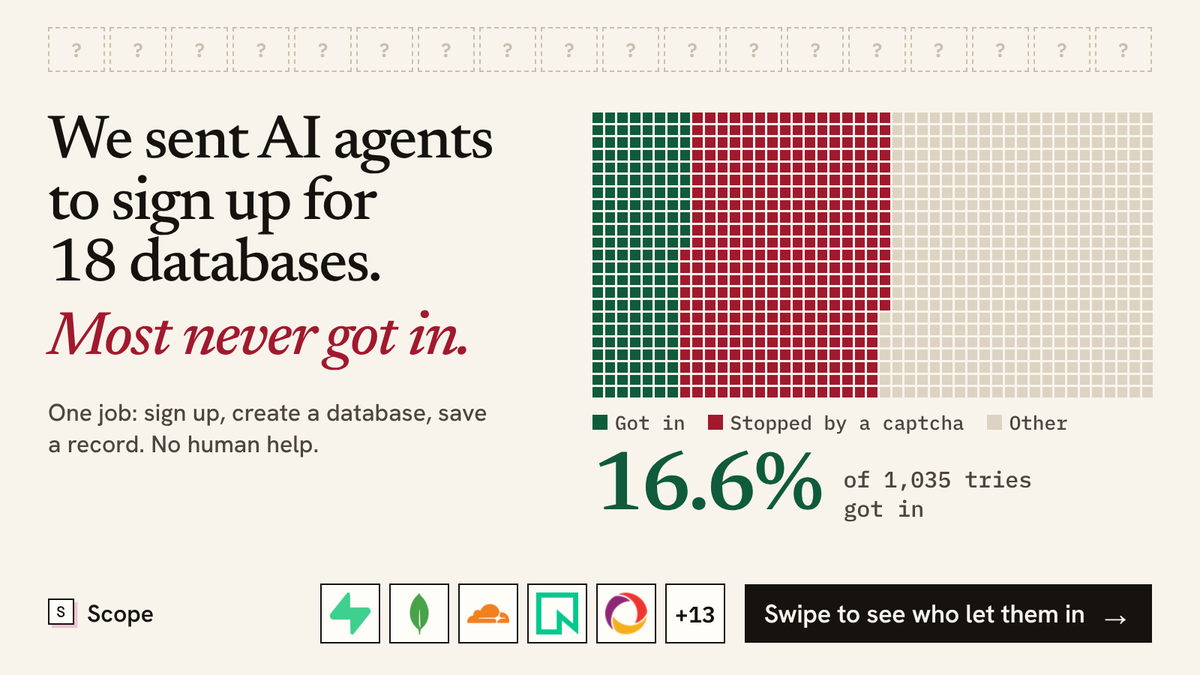
Scope 发布托管数据库 Agent 注册榜:18 家产品、1035 场次,Prisma Postgres 成功率约 88.3%,7 家为零

2026-11-06,Scope(YC P26)创始人 Anand Paj(@anandPa94)发布首个托管数据库 Agent 注册榜。任务:无账号起步、建库、写入记录并交回凭证;覆盖 Claude Code / Codex / Cursor 等 20 种配置、1035 场次。官方榜显示 Prisma Postgres 成功率约 88.3%,Upstash 约 63.3%,Neon/Nile 约 43.3%;CAPTCHA 阻断 373 场,7/18 产品全程零成功。

Scope 发布托管数据库 Agent 注册榜:18 家产品、1035 场次,Prisma Postgres 成功率约 88.3%,7 家为零

核心要点速览

  • 来源:Scope 创始人 Anand Paj(@anandPa94)2026-11-06 X 原帖 + 官方榜 tryscope.com/leaderboard/databases(厂商/评测方口径)
  • 规模:18 家托管库 × 20 种 agent 配置,共 1035 场;总体仅约 16.6% 达到「首次可工作结果」
  • 头部:Prisma Postgres 约 88.3%(58 场中 53 成),Upstash 约 63.3%,Neon/Nile 约 43.3%,ClickHouse Cloud 约 38.3%
  • 摩擦:CAPTCHA 阻断 373 场、Bot block 105 场;7/18 产品零成功;172 次成功里 50 次免注册即得可用库
  • 含义:对面向 Agent 的开发者工具,「注册→写库→交凭证」已成为转化漏斗,而非纯人工 DX
阅读全文

Hugging Face 的 Joël Niklaus 发布 Harness Leaderboard:28,849 次试验比较 9 款编码 Agent Harness,厂商口径 mini-swe-agent 均值约 51.4%

2026-11-05,Hugging Face Harness Optimization 研究员 Joël Niklaus(@joelniklaus)发布 Harness Leaderboard:在固定模型/供应商/推理力度下只换 harness,跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash 与 Flint,基准 Terminal-Bench 2.1 与 DeepSWE,共 28,849 次试验、推理花费约 $4,746。作者口径:三模型平均 mini-swe-agent 解决率约 51.4%,Pi 约 49.4% 且每解一题约 $0.29。本条为个人研究排行榜,非 Hugging Face 公司官方产品公告。

Hugging Face 的 Joël Niklaus 发布 Harness Leaderboard:28,849 次试验比较 9 款编码 Agent Harness,厂商口径 mini-swe-agent 均值约 51.4%

核心要点速览

  • 来源:HF 的 Joël Niklaus(Harness Optimization)个人帖 2026-11-05T16:04:08Z,非公司官宣
  • 规模(作者口径):9 款 harness × 开源模型,28,849 次试验,推理花费约 $4,746
  • 方法:固定模型/供应商/推理力度,每任务 3 次尝试;基准 Terminal-Bench 2.1 与 DeepSWE
  • 结果(作者口径):三模型平均 mini-swe-agent ~51.4%,openclaw ~27.3%;Pi ~49.4% / 约 $0.29 每解一题
  • 落地:排行榜与轨迹公开在 HF Space;对照 Harness Lens 看各 harness 提示词与工具差异
阅读全文

Julius Research 发布 DeepFinance:21 道 PE/投行长流程题,Claude Opus 5.5 均值约 54.8%

Julius Research CEO rahul(@0interestrates,产品 Julius AI)于 11 月 5 日发布 DeepFinance:用真实交易脱敏资料室构建的 21 道 PE/投行超长程任务,人类单题约 20–30 小时(均值约 27.1 小时)、每题约 84 条 rubric。官方榜:Opus 5.5 (max) 约 54.8%,Sonnet 5.5 约 54.6%,GPT-6 Astra 约 54.2%。强调可审计轨迹,而非只对最终数字。

Julius Research 发布 DeepFinance:21 道 PE/投行长流程题,Claude Opus 5.5 均值约 54.8%

核心要点速览

  • 一手来源:Julius Research CEO @0interestrates 发布帖 + 官方榜单/博客(非公司官号公告口径,属实验室产品负责人一手发布)
  • 规模:21 题;均值约 27.1 人时;约 84 rubric/题;资料室均值约 19 文件
  • 榜首(实验室口径):Opus 5.5 max ~54.8%;Sonnet 5.5 ~54.6%;GPT-6 Astra xhigh ~54.2%
  • 成本(官方表):Opus ~$8.63/题;Astra ~$4.55;GPT-6.1 Sol ~$0.81 且约 52.9%
  • 定位:补文档 QA / 纯数值正确评测缺口,强调假设与证据冲突下的可审计流程
阅读全文

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文
AD赞助内容

Kaggle 与 IBM Research 上线 ScarfBench 企业 Java 迁移榜:Gemini 4 Argon + Antigravity 以 75.2% 居首,七成失败发生在运行阶段

Kaggle 官方账号宣布与 IBM Research 合作上线 ScarfBench,用 204 个任务测试编码智能体能否把企业 Java 应用在 Jakarta EE、Quarkus 和 Spring 之间迁移且行为不变。IBM 10 月 27 日的技术说明显示,Gemini 4 Argon + Antigravity 以 75.2% 冒烟分居首,Claude Opus 5.5 + Claude Code 全通过率最高(72.1%),GPT-6.1 Sol + Codex 每解决一个任务成本最低(1.25 美元)。

Kaggle 与 IBM Research 上线 ScarfBench 企业 Java 迁移榜:Gemini 4 Argon + Antigravity 以 75.2% 居首,七成失败发生在运行阶段

核心要点速览

  • 204 个迁移任务、10 组「模型 + 智能体框架」组合;前三名冒烟分:Gemini 4 Argon + Antigravity 75.2%、Claude Opus 5.5 + Claude Code 70.5%、Claude Opus 5 + Claude Code 69.8%(IBM 口径)
  • 全部测试通过率 Claude Opus 5.5 + Claude Code 最高,为 72.1%,略高于 Gemini 4 Argon 的 71.1%
  • 编译几乎不是问题:10 组里 8 组编译成功率 ≥97%,但冒烟分差距超过 50 个百分点
  • 745 次失败中 535 次(约 72%)是运行时行为失败,其中 210 次是路由丢失 / 404
  • 每解决一个任务的成本:GPT-6.1 Sol + Codex 1.25 美元、Gemini 3.8 Flash + mini-swe 1.59 美元、Claude Opus 5.5 + Claude Code 10.10 美元;公开提交暂未开放
阅读全文

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

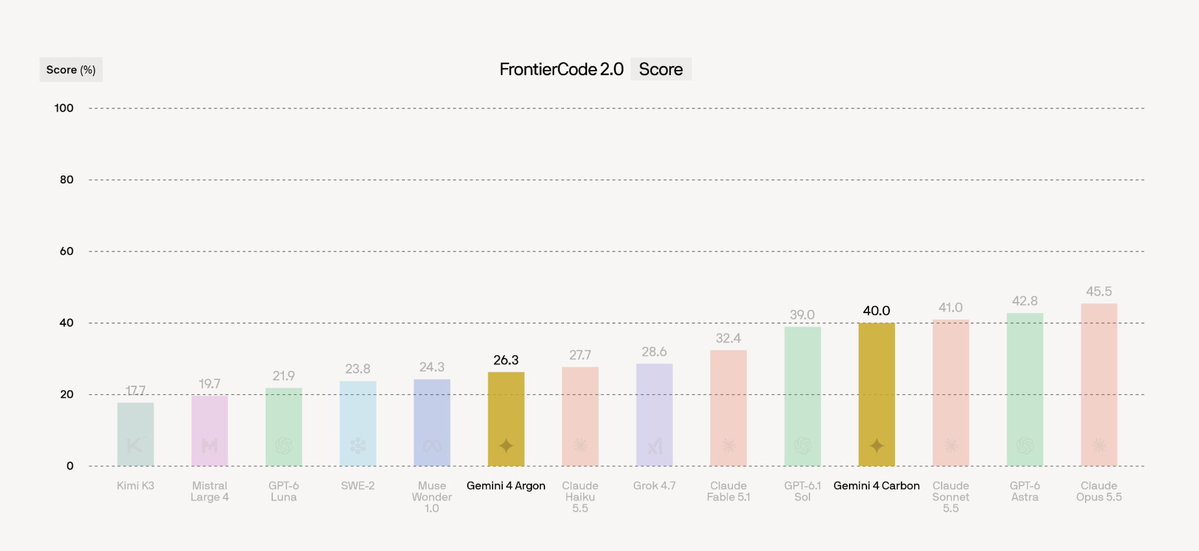
Devin 背后的 Cognition 于 10 月 30 日 01:45(UTC)在 X 上公布,Google 新模型 Gemini 4 Carbon 在其编程基准 FrontierCode 2.0 上得分 40%,每任务成本 4.04 美元,接近最高水平,仅次于 Claude Opus 5.5、GPT-6 Astra 和 Claude Sonnet 5.5。上一代 Gemini 4 Argon 得分 26.3%,每任务成本却更高,为 6.41 美元。成绩为 Cognition 自测口径,排行榜已在官网更新。

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

核心要点速览

  • Gemini 4 Carbon 在 FrontierCode 2.0 得分 40%,每任务 4.04 美元,排在 Claude Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Claude Sonnet 5.5 之后(原帖)
  • Gemini 4 Argon 得分 26.3%,每任务 6.41 美元,高于 Muse Wonder 1.0,但落后于 Claude Haiku 5.5 和 Grok 4.7
  • 从 Argon 到 Carbon,得分提高约 13.7 个百分点,每任务成本反而低约 2.4 美元
  • 官网更新日志显示 10 月 28 日已加入 Gemini 4 Carbon;FrontierCode 2.0 共 132 个任务,按维护者是否会合并打分(排行榜)
  • 所有数字均为 Cognition 自测口径,Google 未就此发布成绩
阅读全文

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

NVIDIA AI 官方账号 10 月 28 日发布 Nemotron 3.5 Transcribe,权重已上架 Hugging Face 和 ModelScope。它是可用自然语言指令驱动的离线语音模型,一个检查点同时做 40 种语言转写、31 种语言与英语互译、13 种语言的说话人标注和音频问答,可处理最长 1 小时录音、最多标注 8 位说话人。官方称它在 Hugging Face Open ASR 英文榜以 5.33% 平均 WER 居开源模型第一;Artificial Analysis 测得 AA-WER 2.8%,与 24B 激活参数的 Voxtral Small 并列开源第一。权重、Granary v2 训练数据和微调配方一并开放。

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

核心要点速览

  • 架构:语音编码器加 Mamba-2/Transformer 混合 MoE 语言模型,总参数约 30B(模型卡含音频编码器计为 34B),每 token 激活约 4B(模型卡为 4.3B),提供 BF16、FP8、NVFP4 版本
  • 能力:40 语种转写、31 语种与英语互译、13 语种说话人标注、音频问答(问答仅英语训练)、词级时间戳,单段最长 1 小时、最多 8 位说话人
  • 官方/第三方口径:Open ASR 英文榜开源第一(平均 WER 5.33%),多语种 7 语言平均 4.62%,长音频 10.98%;Artificial Analysis AA-WER 2.8%,语音智能体对话集 AA-AgentTalk 1.8%(次优开源 2.3%)
  • Artificial Analysis 在 DeepInfra 托管端点实测:速度因子 75 倍,1 分钟音频不到 1 秒转完,价格每 1000 分钟 2 美元
  • 许可为 OpenMDW-1.1,可商用;配套开放 Granary v2 数据和 NeMo Speech 微调工具,官方医疗案例中微调比最佳提示词再降 45.8% 相对 WER
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe 30B-A4B⚡ Voxtral Small🌐 NVIDIA🌐 Hugging Face🌐 Artificial Analysis

微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

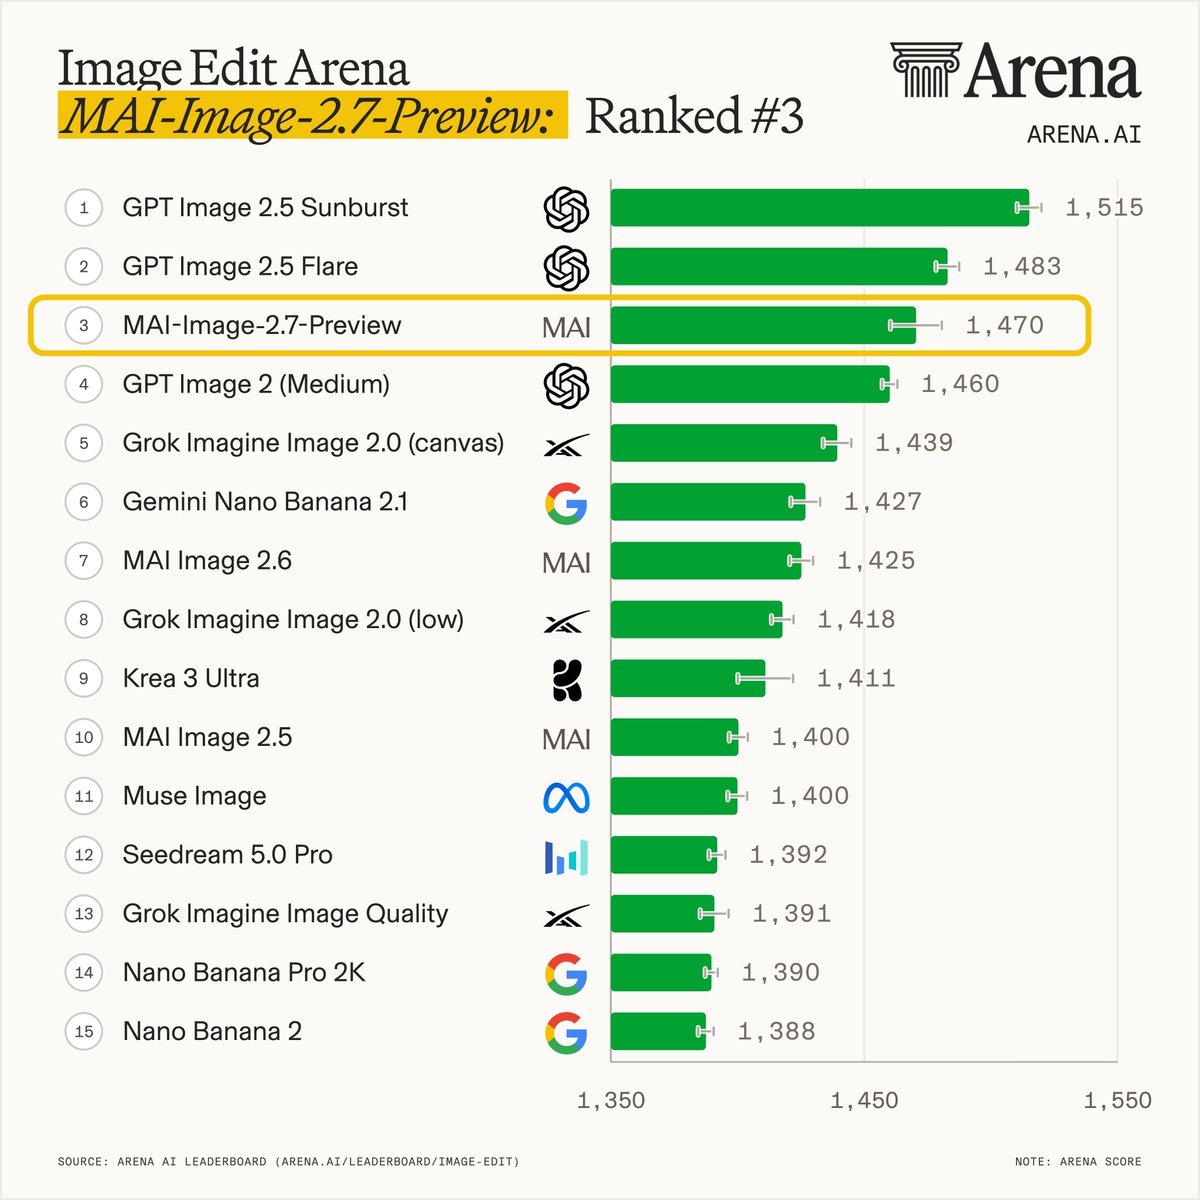
微软 AI 10 月 27 日宣布 MAI-Image-2.6 和 MAI-Image-2.6-Flash 在 Microsoft Foundry 正式商用(GA),支持最多 5 张参考图的多图编辑、Bing 联网 grounding 和最高 1.5K 输出,并公布按 token 计价。同一天,新一代图像编辑模型 MAI-Image-2.7-Preview 以 1470 分登上 Arena 图像编辑榜总榜第 3(比 2.6 高 45 分),目前只能在 MAI Playground 做图像编辑。

微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

核心要点速览

  • MAI-Image-2.6 和 2.6-Flash 在 Microsoft Foundry 正式 GA,Adobe Firefly 也将「很快」接入 2.6(官方口径)
  • 官方定价:2.6 为文本输入 $5、图像输入 $8、图像输出 $38 / 百万 token;Flash 为 $1.75 / $2.50 / $19
  • 2.6 支持最多 5 张参考图的多图编辑、Bing 联网 grounding、动态宽高比和最高 1.5K 输出
  • Arena 数据:MAI-Image-2.7-Preview 以 1470 分列 Image Edit Arena 总榜第 3,比 2.6(第 7)高 45 分,微软在实验室排名中列第 2
  • Artificial Analysis 数据:2.7-Preview 在 AA-Image-Editing v2.1 排第 2,7 项编辑动作全部超过 2.6,其中 4 项排第 1
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Image-2.6⚡ MAI-Image-2.6-Flash⚡ MAI-Image-2.7-Preview🌐 Microsoft🌐 Microsoft AI

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

Cursor 官方 10 月 27 日(SGT)宣布 DeepSeek V4.1 Flash 已在 Cursor 中可用,在 Cursor Settings > Models 打开即可。Cursor 称该模型每一档推理强度都落在 CursorBench 成本前沿上:每任务 $0.60 到 $0.98,在这个价位没有模型得分更高。官方 CursorBench 4.0 榜单显示,DeepSeek V4.1 Flash 1017 Max 档 47.7%($0.98/任务),Medium 46.3%($0.80),High 45.6%($0.77),Low 44.9%($0.60);同榜最高分 Opus 5.5 Max 为 57.8%,但每任务 $13.43。

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

核心要点速览

  • 四档跑分(CursorBench 4.0 官方榜):Max 47.7%/$0.98、Medium 46.3%/$0.80、High 45.6%/$0.77、Low 44.9%/$0.60,Max 档在全榜排第 17
  • 性价比对比:Max 档 47.7% 与 Sonnet 5.5 High(47.8%,$1.20)几乎持平但便宜约 18%;Opus 5.5 Max 高约 10 个百分点,但每任务 $13.43,约是它的 13.7 倍
  • 同价位对手:Haiku 5.5 Max 48.4%/$1.12、Haiku 5.5 Extra High 44.3%/$0.56,DeepSeek 正好卡在两者之间的价格段
  • 代价是 token 和步数:Max 档平均每任务约 53.7 万 token、187 步,Sonnet 5.5 High 只用约 3.7 万 token、41 步,长任务时延要有心理预期
  • 开启方式:Cursor Settings > Models 里打开;有个反直觉细节,Medium 档(46.3%)比 High 档(45.6%)分数略高、价格只贵 $0.03
阅读全文