AI 编程实时动态与要闻

Sierra 发布 Personal Agent Protocol(Poppy)v1.0:Meta 的 Muse 全量启用,Shopify 为全部商家自动开通,设计伙伴超过 100 家

11 月 13 日,Sierra 联合创始人 Bret Taylor 与 Clay Bavor 在官方博客宣布 Personal Agent Protocol(简称 Poppy)v1.0 发布。协议现已对所有使用 Meta 个人智能体 Muse 的用户启用,Muse 访问网站时会优先查找 Poppy;Shopify 为其平台上全部商家自动发布 Poppy 文件,商户无需额外开发。官方称再新增 60 家设计伙伴,总数超过 100 家,Mercury、Turkish Airlines 等已上线。规范文本见 personalagentprotocol.org。
Sierra 发布 Personal Agent Protocol(Poppy)v1.0:Meta 的 Muse 全量启用,Shopify 为全部商家自动开通,设计伙伴超过 100 家

核心要点速览

  • v1.0 已发布:规范见 Personal Agent Protocol 1.0;企业在 /.well-known/poppy.json 公布能力,认证走 OAuth
  • Muse 全量启用:官方称 Poppy 已对所有使用 Meta 个人智能体 Muse 的用户打开,Muse 访问网站时会优先查找 Poppy
  • Shopify 全量开通:全部店铺自动发布 Poppy 文件,商户无需额外实现;Shopify 合写 commerce 扩展,与默认开通的 Universal Commerce Protocol(UCP)互补,官方称 Shopify 业务覆盖 175 个以上国家
  • 设计伙伴超过 100 家:官方称再新增 60 家,完整名单见博客;Mercury、Turkish Airlines 等已上线,Synchrony 仍在探索把分期和积分纳入智能体购物
  • 分阶段接入:官方提供实施工具包和校验器,任何公司都可按文档自行实现,对接后即可改善 Muse 用户的体验;官方未公布价格
阅读全文
关联模型 / 智能体 / 厂商:

LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次

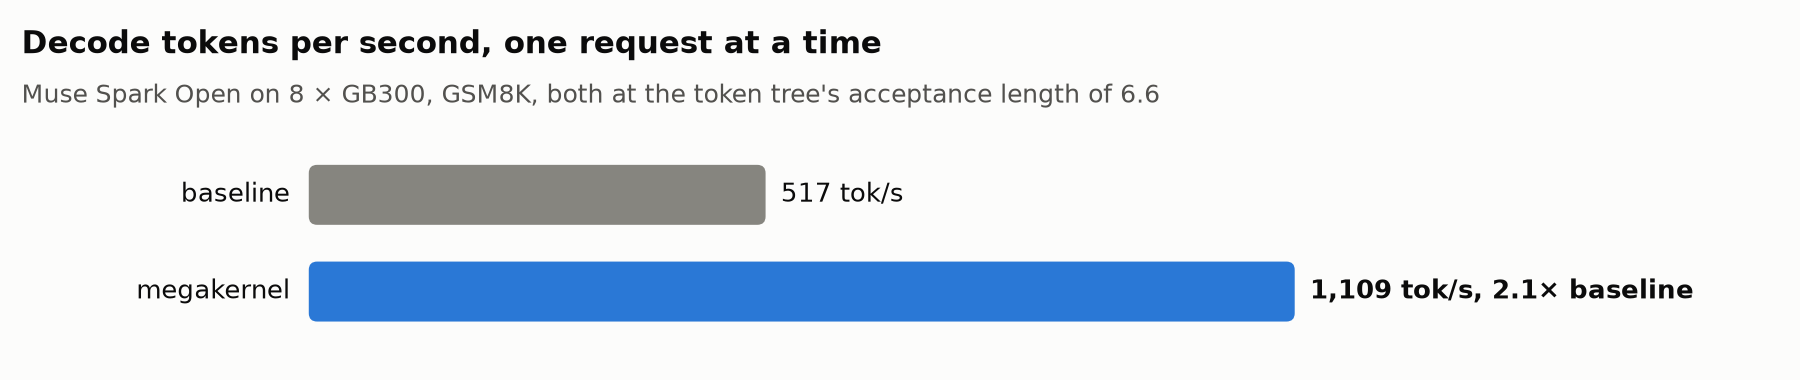
LMSYS 发布技术长文,介绍为 Meta 开源模型 Muse Spark Open 从零手写的 megakernel(CUDA C++ 与 PTX,约 8000 行):每个解码层只启动一次内核,把计算、显存加载和跨卡通信重叠起来。在 8 张 GB300 上,单请求解码速度从 SGLang 基线的 517 tok/s 提到 1,109 tok/s,约 2.1 倍;每个解码步从 12.9 毫秒降到 5.9 毫秒。代码以 SGLang 插件形式开源在 facebookresearch/sgl-muse-mega(MIT)。目前只支持 batch 1,属于实验功能,换来的是低延迟,不是更便宜的 token。

LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次

核心要点速览

  • 速度翻倍:8×GB300、TP8、GSM8K 单请求,解码 517 → 1,109 tok/s,约 2.1 倍(同一草稿模型、同一接受长度)
  • 内核启动大减:每个解码步从约 1,450 次内核启动降到 97 次,每层只启动一次
  • 单步耗时:12.9 毫秒 → 5.9 毫秒;其中验证 10.9 → 5.3 毫秒,草稿 1.16 毫秒 → 0.44 毫秒(草稿从 175 次启动降到 8 次)
  • 投机解码:DFlash V2 草稿每步猜 15 个 token,验证 16 个、平均接受 6.6 个;小米 MiMo-V2.5-Pro 为验证 8 个、接受 6.3 个
  • 适用范围:仅 batch 1,其他请求回退到普通 SGLang;8 张顶级 GPU 只服务一个用户,卖的是延迟而不是成本
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark Open⚡ MiMo-V2.5-Pro🌐 LMSYS🌐 SGLang🌐 Meta🌐 NVIDIA

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

11 月 12 日,开源推理引擎 SGLang 背后的非营利组织 LMSYS Org 在旧金山首届 SGLang 峰会开幕主题演讲上宣布成立 SGLang 联盟。创始成员包括NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal 和 RadixArk,它们将与 SGLang 维护者一起参与路线图制定,重点方向是前沿模型支持、推理与多模态负载、分布式推理和跨硬件优化。每家成员指派一名技术代表,每年参加两次路线图会议;技术决策和代码合入权仍归 SGLang 维护者,项目继续对整个社区开放。

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

核心要点速览

  • 创始成员 8 家:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk(SGLang 核心作者创办的公司),覆盖 GPU/CPU 芯片、云和推理服务商
  • 治理方式:每家指派一名技术代表,每年两次路线图会议,期间可组建工作组并公开进展;技术决策与代码合入仍由 SGLang 维护者负责
  • 四个重点方向:前沿模型支持、推理与多模态负载、分布式推理、跨硬件平台优化
  • 规模(官方口径):SGLang 跑在数十万张 GPU 上,用户包括 Meta、微软、Google、亚马逊、Thinking Machines Lab、Cloudflare、Reflection、Modal
  • 背景:LMSYS 引用德勤数据称,2026 年推理约占全部 AI 算力的三分之二,2025 年约为一半;首届峰会 11 月 12–13 日在旧金山 Fort Mason 举行,100 多位演讲者
阅读全文

Meta FAIR 开源 e-means:k-means 的直接替代,约 1/10 轮数达到更低误差,GPU 端比 Flash-KMeans 快 10–45 倍,已并入 FAISS 1.16.0

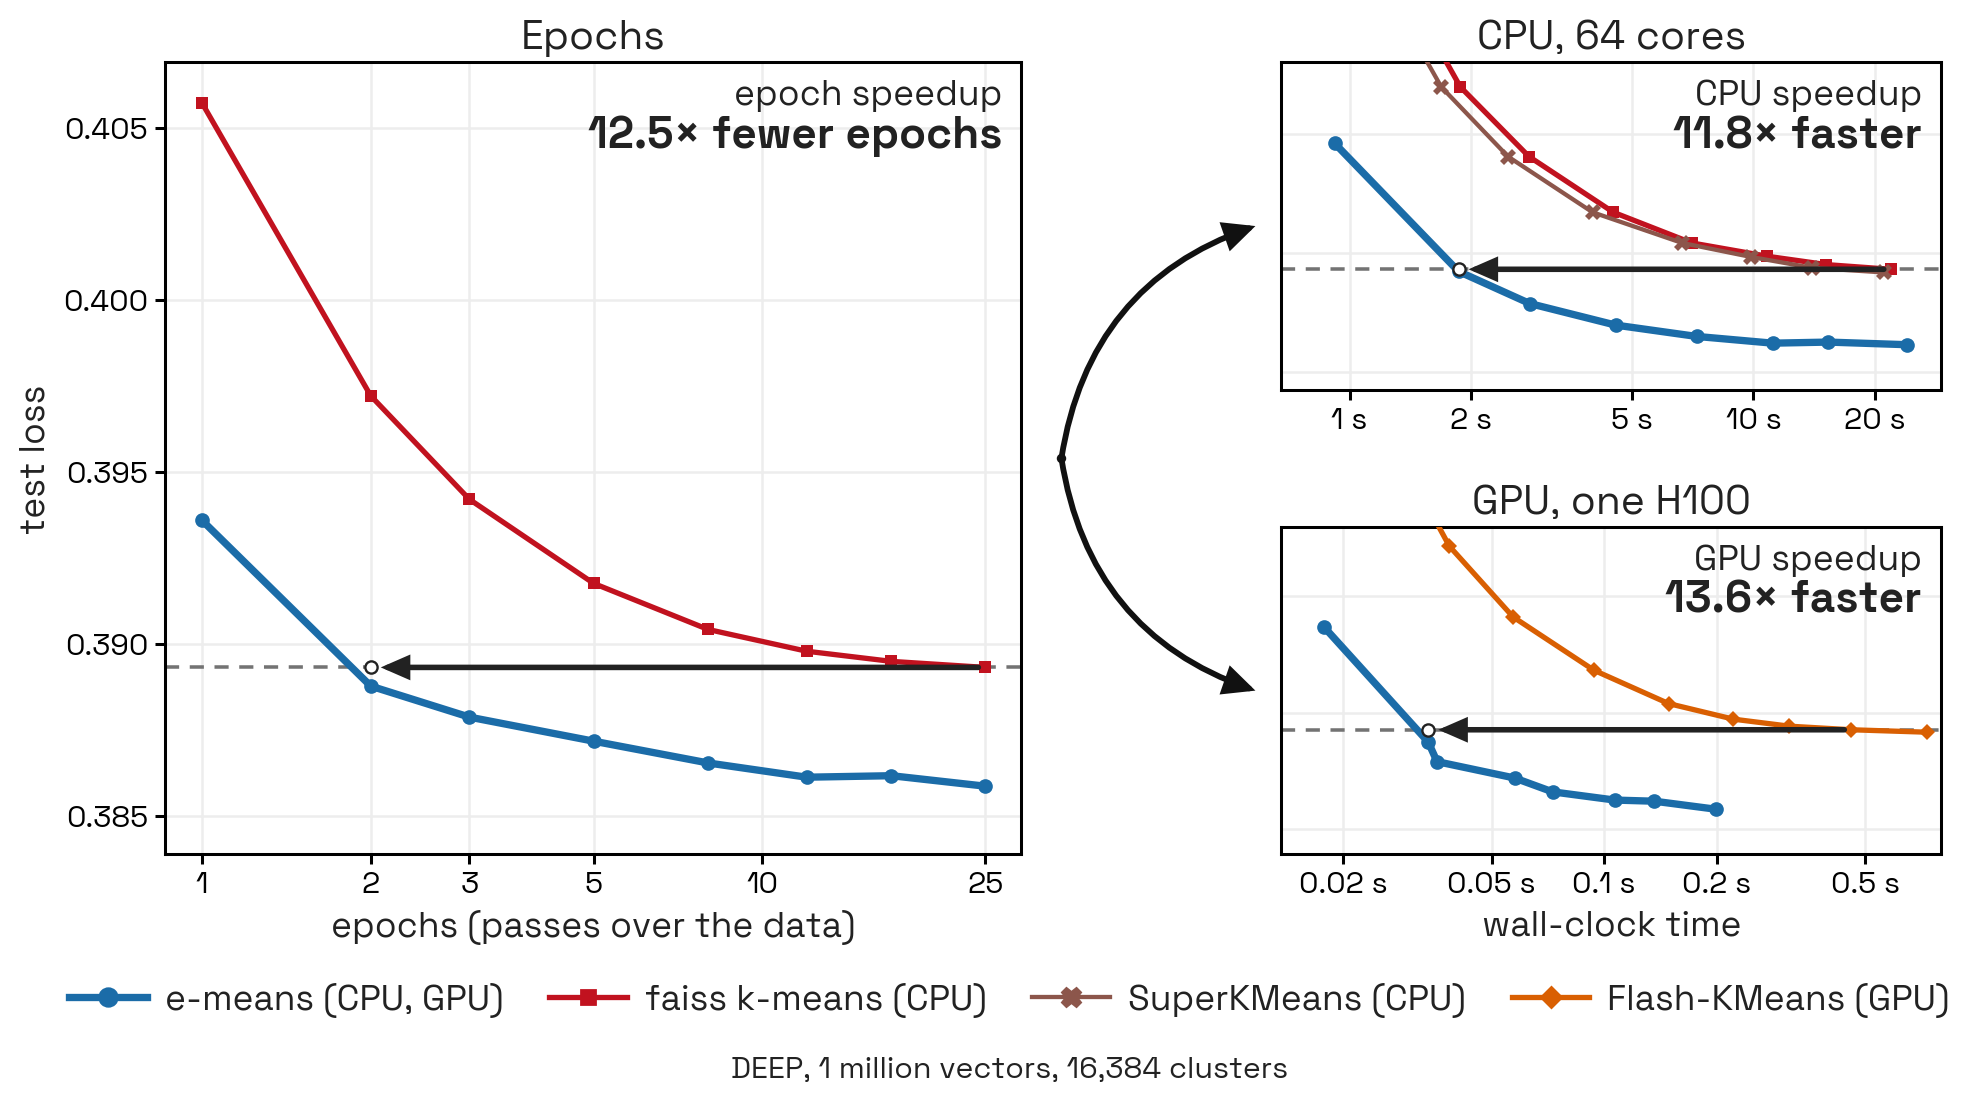
Meta FAIR 研究员 Swann Bessa 11 月 10 日在 X 上发布 e-means,这是一种替代经典 Lloyd k-means 的聚类算法,已随 FAISS 1.16.0 开源。它用小批量更新加指数移动平均取代全量迭代,批大小和步长由拟合出的缩放定律自动设定,除簇数 k 外无需调参。论文称,在多个嵌入数据集上,e-means 只需 1.4–2.6 轮就低于 Lloyd 跑 25 轮的误差,GPU 端比 Flash-KMeans 快 10–45 倍,CPU 端比 FAISS 自带 k-means 快 8–15 倍(作者口径)。对建向量索引、做 RAG 和数据去重的团队,这一步可以直接提速。

Meta FAIR 开源 e-means:k-means 的直接替代,约 1/10 轮数达到更低误差,GPU 端比 Flash-KMeans 快 10–45 倍,已并入 FAISS 1.16.0

核心要点速览

  • 轮数:在多个嵌入数据集上 1.4–2.6 轮即低于 Lloyd 25 轮的测试误差;VIBE 基准 11 个数据集每个只需 1.6–2.4 轮(论文/作者口径)
  • 速度:GPU 端比 Flash-KMeans 快 10–45 倍,CPU 端比 FAISS k-means 快 8–15 倍;单张 H100 上 1000 万向量、65,536 簇,Flash-KMeans 25 轮需 14–22 秒
  • 规模:把 100 亿条 DINO 嵌入分成 1600 万簇,只用 2.5 轮就低于 Lloyd 25 轮的误差
  • 死簇:100 万向量、k=16,384 时,按比例拆分大簇的复活策略让死簇降到 0.1%–0.3%,EnCodec 式重采样为 4.6%–14.3%
  • 上手:from faiss.contrib.e_means import Emeans,默认 5 轮,支持 PyTorch 与 NumPy,论文 arXiv:2611.09501
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Meta 三款 Muse 模型上架谷歌云:Muse Wonder、Muse Spark 1.3 与新发布的 Muse Ember 以 Preview 形式进入 Model Garden,走全局 OpenAI 兼容 Responses 接口

Meta CEO 扎克伯格 11 月 10 日(新加坡时间 05:49)宣布 Muse Ember、Muse Spark 1.3 和 Muse Wonder 已上架 Google Cloud,Sundar Pichai 回复「欢迎加入 Model Garden」。谷歌官方文档显示,三款模型以 Preview 合作伙伴模型形式提供,只支持 global 端点和无状态的 OpenAI 兼容 Responses API。谷歌页面未列出单价,Meta 自家价目表仍是参考。

核心要点速览

  • 上架范围:3 款模型,Muse Wonder 1.0、Muse Spark 1.3、Muse Ember 1.0,在谷歌合作伙伴模型列表中均标为 Preview(Google Cloud 文档)
  • 调用方式:只有 global 一个端点,走无状态的 OpenAI 兼容 Responses API,store: true 不支持;model 字段直接填 muse-wonder-1.0 / muse-ember-1.0 / muse-spark-1.3
  • 定价参考(Meta 官方价目,谷歌页面未列单价):Wonder $4 / $20,Spark 1.3 $1.25 / $4.25,Ember $0.10 / $0.50(每百万输入/输出 token)
  • 官方定位:Wonder 做长程编程与 Agent 规划,Ember 负责高频工具调用、路由和抽取,谷歌文档建议 Ember 与 Wonder 或 Spark 1.3 搭配;Spark 1.3 支持 MCP 与 1M 上下文
  • 扎克伯格原帖获 5300+ 赞、约 25 万次浏览;Sundar Pichai 回复「欢迎加入 Model Garden」获 2100+ 赞;LiteLLM 已有 PR #50768 接入
阅读全文
关联模型 / 智能体 / 厂商:

Meta 个人 AI Agent Muse 上手表:iOS 版 15.0 新增 Apple Watch 伴侣应用,可打字、听写或直接通话,Wear OS 同步支持

Meta 官方账号 @Muse 于 11 月 9 日宣布 Muse 登陆 Apple Watch 与 Wear OS。Apple Watch 版随 iOS 应用 15.0 推出,是伴侣应用,需 watchOS 9.0 以上,支持打字、语音听写和通话三种方式,并提供表盘复杂功能;Wear OS 的支持机型与版本要求官方暂未公布。

Meta 个人 AI Agent Muse 上手表:iOS 版 15.0 新增 Apple Watch 伴侣应用,可打字、听写或直接通话,Wear OS 同步支持

核心要点速览

  • Muse iOS 应用 15.0(11 月 9 日更新)新增 Apple Watch 伴侣应用,需 iOS 18.0 与 watchOS 9.0 以上(App Store)
  • 手表端提供 3 种交互:打字、语音听写、直接通话,另有表盘复杂功能一键唤起(MacRumors)
  • 官方 @Muse 发布帖获得约 3500 赞、480+ 转发;Meta 首席 AI 官 Alexandr Wang 同步转发宣传
  • Wear OS 同步支持,但支持机型和最低系统版本官方暂未公布
  • App Store 美区页面显示 Muse 评分 4.8(约 50.4 万条评分),位列效率榜第 1(页面口径)
阅读全文
关联模型 / 智能体 / 厂商:

Meta 发布最小最省的 Muse Ember:每百万 token 输入 0.10 美元、输出 0.50 美元,1M 上下文,AA 智能指数 36 分追平 Claude Haiku 5.5,单任务成本约为其三分之一

北京时间 11 月 10 日凌晨,AI at Meta 官方账号发布 Muse Ember,称其是 Meta 目前最小、最高效的模型,面向 Agent 每天反复执行的工作:工具调用、编码子任务、路由、信息抽取和长文档解析。Muse Ember 支持 1M token 上下文、最多 512K 输出,原生理解文本、图像、音频和视频。定价为每百万 token 输入 0.10 美元、缓存输入 0.004 美元、输出 0.50 美元,已在 Meta Model API(模型名 muse-ember-1.0)和 Muse Code 上线。Artificial Analysis 测得其智能指数 36 分,与 Claude Haiku 5.5(max)持平,但单任务成本约 0.14 美元,只有后者的约三分之一。它是第一个用 Muse Wonder Full 训练出来的模型,权重不开放。

Meta 发布最小最省的 Muse Ember:每百万 token 输入 0.10 美元、输出 0.50 美元,1M 上下文,AA 智能指数 36 分追平 Claude Haiku 5.5,单任务成本约为其三分之一

核心要点速览

  • 定位:Meta 最小、最高效的模型,专做 Agent 的高频小任务(工具调用、编码子任务、路由、抽取、长文档解析);官方建议「Muse Wonder 负责规划,Muse Ember 负责跑量」
  • 规格:1M 上下文、最多 512K 输出,原生支持 文本/图像/音频/视频 输入,支持 Responses API
  • 定价:输入 $0.10、缓存输入 $0.004、输出 $0.50 / 百万 token;输入价约为 Muse Spark 1.3($1.25)的 1/12
  • 跑分(Artificial Analysis):智能指数 36,与 Claude Haiku 5.5(max)持平,单任务成本 $0.14 vs $0.41;Coding Agent Index 46(Haiku 5.5 在 Claude Code 中为 37,GPT-6 Luna 在 Codex 中为 31),但 FrontierCode 2.0 27.2% 落后 Haiku 的 34.9%
  • 短板:AA-Omniscience 知识准确率仅 21.1%,主要因为它拒答 64% 的问题,幻觉率因此只有 17.4%;不开放权重,只能通过 Meta Model API 和 Muse Code 使用
阅读全文

阿里淘宝 MNN 团队开源 3 亿参数端侧模型 MNN-Pocket-0.3B:INT4 版仅 173MB,iPad Pro M5 解码最高 466 token/s,Apache 2.0

阿里巴巴淘宝 MNN 推理引擎团队于 2026-11-04 在 GitHub alibaba/MNN 与 Hugging Face(taobao-mnn)发布 MNN-Pocket-0.3B,这是一个与 MNN 推理栈协同设计、面向手机 App 的约 3 亿参数中英双语指令模型,Apache 2.0 许可。官方模型卡称:INT4(W4A16)QAT 构建仅 173MB,支持 32K 上下文,在 iPad Pro M5(Metal)上解码最高 466 token/s,iPhone 18 Pro 实测约 350 token/s;在 11 项中英评测上平均 50.00,高于 Qwen3-0.6B(44.28)等更大的约 5 亿参数基线(均为官方口径)。同系列还放出 Base、SFT、GGUF、MNN 端侧包和一次前向即作答的 Dec 决策模型。11-08 起已有第三方 iOS 应用 Local LLM 接入、社区转出 LiteRT 版本。官方明确不建议用于高阶数学和长代码生成。

阿里淘宝 MNN 团队开源 3 亿参数端侧模型 MNN-Pocket-0.3B:INT4 版仅 173MB,iPad Pro M5 解码最高 466 token/s,Apache 2.0

核心要点速览

  • 规格(官方模型卡):约 3 亿参数、28 层、隐藏维度 896、GQA 14 头/2 KV 头、词表 65,536,部署支持 32K 上下文,中英双语
  • 体积与速度(官方口径):INT4(W4A16)QAT 构建 173MB;512 token 上下文下 iPad Pro M5 Metal 预填充 8,721 token/s、解码 466 token/s,骁龙 8 Gen 5 CPU 解码 251 token/s;GitHub README 称 iPhone 18 Pro 解码约 350 token/s
  • 跑分(官方口径):11 项中英评测平均 50.00,INT4 版 49.59,仅掉 0.41 分;IFEval 73.20、GSM8K 54.36、HumanEval 53.66,平均分高于 Qwen3-0.6B(44.28)和 MiniCPM4-0.5B(46.81)
  • 全家桶:Base、SFT、指令版、GGUF(llama.cpp)、MNN 端侧包,以及一次前向作答的 Dec 决策模型;Apache 2.0 可商用
  • 定位:官方建议用于端侧助手、信息抽取和轻量 Agent 流水线,不建议做高阶数学或长代码生成
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MNN-Pocket-0.3B⚡ Qwen3-0.6B⚡ MiniCPM4-0.5B🌐 Alibaba🌐 Taobao mnn

Voyager 开源 vork:面向 Agent 的无界面 3D/VFX 引擎,核心 API 约 2500 tokens,研究预览可免费使用

2026-11-06,Voyager / vork 作者 Ravi Parikh(@ravisparikh,GitHub swag)在 X 发帖宣布 vork:面向 AI Agent 的无界面 3D/VFX 引擎(Rust + Slang,Vulkan/Metal)。官方称入门帮助约 2500 tokens;百万只独立轨迹鸟群在单卡 NVIDIA L4 上渲染约 97 秒。GitHub voyager-so/vork 研究预览源码可用,预览期免费。此为作者第一人称发布,非大厂官方产品线。

Voyager 开源 vork:面向 Agent 的无界面 3D/VFX 引擎,核心 API 约 2500 tokens,研究预览可免费使用

核心要点速览

  • 来源:Ravi Parikh(@ravisparikh)2026-11-06 X 原帖 + voyager.so/vork 与 GitHub voyager-so/vork(研究预览)
  • 定位:无 GUI,Agent 用代码写场景/着色器/相机/物理并渲染迭代;入门 help 约 2500 tokens(厂商口径)
  • 性能(官方站点口径):百万鸟群单卡 L4 约 97 秒;相对把成品 flock 交给 Blender EEVEE 的投影对比约 8–11×(不含约 3 分钟 warmup)
  • 作者 X 帖另称最高约 24×、EEVEE 约 31 分钟——以官网更谨慎对比为准,并标注为作者口径
  • 限制:雾/体积未上线;重室内 Mac 可能中止;路径追踪尚慢于 Cycles;预览期源码可用且免费
阅读全文
关联模型 / 智能体 / 厂商:

Meta Muse 上线 Spaces:对话描述即可生成可钉选的持久小工具界面,支持排程显示与后台同步

2026-11-06,Meta 宣布 Muse 推出 Spaces:用自然语言描述想法即可生成礼物追踪、计划板等自定义体验,可钉到侧栏/主 Tab 并按日程显示;连接 App 后可后台自更新。即日起在 Muse 已上线地区可用,多人协作仍在探索。

Meta Muse 上线 Spaces:对话描述即可生成可钉选的持久小工具界面,支持排程显示与后台同步

核心要点速览

  • 来源:Meta Newsroom《Design the Muse App, Just for You》(2026-11-06)+ @Muse 公告
  • 能力:对话描述即可生成持久可编辑 space,可钉侧栏/主 Tab,并可按日程显示或隐藏
  • 同步:连接 App 后,厂商称可在后台自更新(演出、价格、储蓄进度等)
  • 范围:即日起在 Muse 已上线地区可用;多人协作分享仍在探索
  • 并列:专用 Muse Wonder 模型另见既有报道,本稿专写 Spaces 产品面
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Meta 向 Muse / Meta AI 推送 Wonder 训练的专用模型:Active Memory / Focus 上线,厂商口径 PSI 约 38%→47%

2026-11-06,AI at Meta(@AIatMeta)宣布:用 Muse Wonder 训练的专用模型进入 Muse 与 Meta AI,带上 Active Memory 与 Active Focus。厂商口径 Personal Superintelligence Index 约 38%→47%,Active Memory Eval 约 76%→90%;Muse 遗忘关键信息约降 2.4×。

Meta 向 Muse / Meta AI 推送 Wonder 训练的专用模型:Active Memory / Focus 上线,厂商口径 PSI 约 38%→47%

核心要点速览

  • 来源:@AIatMeta 2026-11-06 帖 + Meta AI Research 博客 Bringing Specialized Models to Muse and Meta AI
  • 产品:用 Muse Wonder 训练的专用模型滚动进入 Muse 与 Meta AI;Wonder 本体仍服务更难任务
  • 厂商口径:Personal Superintelligence Index 约 38%→47%;Active Memory Eval 约 76%→90%
  • 厂商口径:Muse 遗忘关键信息约降 2.4×;意外约束下完成日常任务约 +67%
  • 落地:多数用户无需改设置;外部对照榜与评测集开源情况官方未详述
阅读全文
关联模型 / 智能体 / 厂商:

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

Meta AI(@AIatMeta)于 11 月 5 日宣布,Connect 上预览的 Muse Realtime Avatar 开始在美国 Muse App 灰度:把 Muse Realtime Voice 变成可互动的实时形象。研究博客称系统为音频驱动的 Diffusion Transformer,与语音共享 speech token 流以同步口型与表情;单会话在 GB200 上可流式输出 448×768@25fps,用户话轮结束到音视频首字节约 870ms,并用 Meta Video Seal 做不可见水印。面向 18+ 用户;官方未公布全球时间表与开发者 API。

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

核心要点速览

  • 美国 Muse App 开始灰度 Realtime Avatar;Connect 时预览,现进入消费端(@AIatMeta)
  • 架构:语音 VQ token 同时驱动音频解码与 Avatar 视频;因果分块 + 自强制蒸馏,教师约 120 次评估压到学生 2 次(约 60×)
  • 性能口径:448×768@25fps,约 870ms 首包;单 GB200 相对 BF16 基线服务容量约 8×,可达 12 路并发(研究博客)
  • 主观评测:相对 Runway Characters、HeyGen LiveAvatar,评分者在整体与多数维度更偏好 Muse(厂商评测)
  • 安全:生成视频嵌入 Video Seal 不可见水印;示例不代表 App 内全部形象;无公开开发者 API
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark⚡ Muse Presence🤖 Muse🌐 Meta

Conductor 宣布加入 Meta:多编码智能体协作工具团队并入 MSL,Conductor Cloud 11 月 20 日关停

Conductor 的 Charlie Holtz 于 11 月 4 日(UTC 18:18)在 X 上宣布 Conductor 加入 Meta,将与 Nat Friedman、Alexandr Wang 在 Meta Superintelligence Labs(MSL)打造“下一代界面”。官方公告给出时间表:11 月 4 日起停止新用户注册、Pro 功能对现有用户免费;11 月 13 日 Cloud 只读并给活跃订阅者退款;11 月 20 日 Cloud 关停并开始删除云端数据;本地版持续更新新模型和关键修复到 2027 年初。交易金额未披露。

Conductor 宣布加入 Meta:多编码智能体协作工具团队并入 MSL,Conductor Cloud 11 月 20 日关停

核心要点速览

  • Conductor 是 2025 年 7 月上线的工具,用来同时调度多个编码智能体(底层跑 Claude Code、Codex、Cursor、OpenCode 等第一方智能体),官网称有 10 万+ 开发者使用。
  • 团队将进入 Meta Superintelligence Labs,与 Nat Friedman、Alexandr Wang 合作;新产品官方只说“明年初”推出,细节未公布。
  • 关键日期:11/4 停止注册与下载、11/13 Cloud 只读并退款、11/20 Cloud 关停并开始删除数据,本地版维护到 2027 年初。
  • 迁移方式:在云端工作区上右键选择 Transfer to local,或在 Settings → Account → Export data 导出全部数据。
  • 交易金额未披露;同一天 HumanLayer 也宣布加入 Factory,编码智能体工具赛道正在快速整合。
阅读全文

AMD 三季度数据中心营收 85 亿美元同比增 97%:Helios 机架已为 Anthropic、OpenAI 等运行模型,四季度指引约 170 亿美元

AMD 11 月 3 日公布 2026 年第三季度财报:总营收 133.77 亿美元,同比增长 45%;数据中心业务营收创纪录的 85.46 亿美元,同比增长 97%、环比增长 27%,主要来自 EPYC 服务器 CPU 和刚上市的 Instinct MI450 系列 GPU。公司称 Anthropic、Meta、微软、OpenAI 和 Oracle 云已在首批 Helios 机架级系统上运行模型和工作负载。AMD 给出四季度营收指引约 170 亿美元(上下浮动 3%),中值同比约增长 66%。

核心要点速览

  • 数据中心营收 85.46 亿美元,同比 +97%、环比 +27%,占总营收约 64%(一年前约 47%);部门经营利润 28.82 亿美元,利润率 34%
  • 首批 Helios 机架(Instinct MI450 系列 GPU + 第六代 EPYC)已为 Anthropic、Meta、微软、OpenAI 和 Oracle 云运行模型,MI455X 本季度开始量产出货
  • 总营收 133.77 亿美元(+45%),非 GAAP 毛利率 56%、每股收益 2.09 美元;GAAP 净利润 24.28 亿美元,含 10.97 亿美元客户认股权证公允价值变动
  • 四季度营收指引约 170 亿美元 ±3%,中值同比约 +66%、环比约 +27%,非 GAAP 毛利率约 55%
  • 同期还发布 ROCm 10(含 ROCm.AI)、Helion 机架级 Agent 系统参考架构,并宣布拟收购 World Labs 与 Taalas
阅读全文

X 热议:Grok Bot 工程师 poteto 称让 Agent 做对抗式代码审查「大多是浪费 token」,主张把 token 花在实证加形式化验证上

11 月 3 日,自我介绍为 SpaceXSI 旗下 Grok Bot 工程师、React Compiler 核心团队成员(曾在 Cursor、Meta、Netflix)的 @poteto(lauren)发帖,自称「也许是暴论」:她现在认为对抗式审查大多是在浪费 token,不如把这些 token 用在实证验证结合形式化验证上;她已调整自己的 Agent 技能包 pstack,减少调用 interrogate(多模型对抗审查)技能,以后可能直接移除。她还说抽象层面的代码审查价值很小,Agent 往往陷在吹毛求疵和 YAGNI 式意见里。帖子约 90.6 万浏览、9227 赞、5538 收藏,属个人观点,引发对 AI 代码审查价值的讨论。

核心要点速览

  • 观点(个人看法,非官方结论):对抗式审查「大多是浪费 token」,更值得投入的是实证验证 + 形式化验证
  • 行动:作者称已让 pstack 少用 interrogate 技能,未来可能移除;抓取时 GitHub 上 cursor/plugins 的 pstack 公开目录自 10 月 27 日后尚无新提交,具体改动未见公开
  • interrogate 是什么:按公开 SKILL.md,它为每个配置模型各开一个只读审查者(默认 Claude Opus 5.5 xhigh 与 Grok 4.7 xhigh fast)对 diff 做对抗审查,再分为 Act on / Consider / Noted / Dismissed 四档,不自动改代码
  • 作者身份(据其 X 与 GitHub 简介):Grok Bot @ SpaceXSI 工程师、React Compiler 核心团队,曾在 Cursor、Meta、Netflix
  • 热度:约 90.6 万浏览、9227 赞、5538 收藏、668 回复、356 转发、210 引用
阅读全文