AI 编程实时动态与要闻

Google Research 公布 Antigravity /teamwork 多智能体成果:与学界合作完整证明 2013 年 Courtade–Kumar 猜想(5000 万行 Lean 4),自主形式化 Weil 猜想;工具已对外开放,1 万名学者可申请 6 个月免费

11 月 13 日,Google Fellow、Google Research 副总裁 Vahab Mirrokni 在 Google Research 博客和 X 上公布 Antigravity /teamwork 多智能体系统的新成果。Google 与 CUHK、USC、CMU 研究者用 Gemini 4 Argon 等模型完整证明了信息论中 2013 年提出的 Courtade–Kumar 猜想,并在 Lean 4 中形式化,共 5000 万行代码。/teamwork-LEAP 还全自主形式化了 Weil 猜想(约 180 万行 Lean,28,800 次子智能体调用)。工程方面,Zircon 微内核剩余部分被改写为约 80 万行安全 Rust,17 个 JAXBench TPU 内核几何平均提速 4.09 倍。/teamwork 和 /boost 已在 Antigravity 对外可用,1 万名学术研究者可申请 6 个月最高档免费额度。

Google Research 公布 Antigravity /teamwork 多智能体成果:与学界合作完整证明 2013 年 Courtade–Kumar 猜想(5000 万行 Lean 4),自主形式化 Weil 猜想;工具已对外开放,1 万名学者可申请 6 个月免费

核心要点速览

  • Courtade–Kumar 猜想(2013)被完整证明并在 Lean 4 中形式化,共 5000 万行代码;Gemini 负责大部分新解析界和区间算术证书,人类研究者提出关键候选函数
  • /teamwork-LEAP 全自主形式化 Weil 猜想,约 180 万行 Lean、28,800 次子智能体调用;还首次形式化了 1927 年的 Birkhoff 猜想和 3D Bochner–Riesz 猜想
  • 工程成果:Zircon 剩余部分改写为约 80 万行安全 Rust 并通过全部内核单测;libgav1 改写为约 17 万行 Rust,比原 C++/汇编快 20–30%;17 个 JAXBench TPU 内核几何平均提速 4.09 倍
  • /teamwork 与 /boost 已在 Antigravity 对外可用,Hydrogen 对所有人开放,Carbon/Argon 面向 Enterprise 与 Ultra/付费用户;1 万名学者可申请 6 个月免费;Deep Review 每周免费 2 次
  • 这些结果由 Google 自行发布,博客称预印本和 Lean 4 仓库已公开,外部复核仍需时间
阅读全文

FBI 发布 FLASH 预警:开源 LLM 智能体渗透框架 ARTEX 自 8 月起被黑客大规模滥用,部分入侵 3 小时内拿到特权,公网暴露控制台超 1600 个,攻击方最常用 DeepSeek Flash 系列模型

FBI 网络部门 11 月 13 日发布 FLASH-20261113-001,点名开源的 LLM 驱动多智能体渗透测试平台 ARTEX:自 2026 年 8 月起被多类黑客用于自动化完成侦察到数据外传的多个阶段,目标涵盖金融、政府、科技、国防、半导体、能源、医疗等行业,部分入侵从锁定目标到拿到特权不到 3 小时。原作者 10 月已下架 GitHub 仓库,但分叉、镜像和商业版 ARTEX PRO 仍在流传,11 月初已发现超 1600 个公网暴露的 ARTEX 控制台。

FBI 发布 FLASH 预警:开源 LLM 智能体渗透框架 ARTEX 自 8 月起被黑客大规模滥用,部分入侵 3 小时内拿到特权,公网暴露控制台超 1600 个,攻击方最常用 DeepSeek Flash 系列模型

核心要点速览

  • ARTEX 用 Go 编写,把自然语言下达的战术目标拆成命令交给专门智能体执行,除设定目标外几乎无需人工介入;它本身不带模型,而是接入外部 LLM,包括 Claude、GPT 以及 DeepSeek、GLM、Grok、Kimi 等
  • FBI 称在攻击方控制的 ARTEX 实例中中国模型最常见,DeepSeek Flash 系列用得最多,原因是能力与成本平衡,且在以「渗透测试」包装时看不到明显护栏
  • 已知案例:针对韩国金融机构的攻击导致约 6.7 万人个人信息外泄;一次 ConnectWise Cloud Backup 供应链入侵波及 2250 多个下游租户
  • 原作者「Autumn-27」7 月在 GitHub 发布,10 周内约 1500–2000 星,10 月 8 日下架仓库;FBI 称分叉、本地化改版、存档副本和商业版 ARTEX PRO 仍在扩散
  • FBI 建议:盘点所有公网应用(含合作伙伴门户、移动后端、遗留服务),把云管理、Kudu/SCM 发布接口、备份平台等收进可信网络,扫描代码库和 CI/CD 中的明文密钥并及时轮换
阅读全文

Einsia 与清华发布多 Agent 编排基准 WorkflowArena:145 个长程任务、25 种 Claude Code / Codex 配置,最强的 Opus 5.5 也只完整解决 36.95%

Einsia AI 联合清华大学等 11 月 10 日发布 WorkflowArena,专门测模型能不能自己拆任务、派子 Agent、写工作流并整合结果。基准含 8 个专业领域 145 个长程任务,用隐藏验证器打分,并记录每一次委派。论文测了 9 个模型在 Claude Code 和 Codex 中的 25 种配置:最强的 Claude Opus 5.5(max)平均只完整解决 36.95% 的任务,SWE 最高 29.41%,法律不超过 9.09%。Claude 系倾向少而大的委派,GPT 系则多而小;Opus 写的工作流能让较弱执行模型平均多得 6.41 分。代码和论文已公开。

Einsia 与清华发布多 Agent 编排基准 WorkflowArena:145 个长程任务、25 种 Claude Code / Codex 配置,最强的 Opus 5.5 也只完整解决 36.95%

核心要点速览

  • 规模:145 个长程任务、8 个领域、17 种任务形式(软件工程、Lean 形式化证明、法律、金融、科学、运维、内容、3D 等),测 9 个模型的 25 种配置
  • 完整解决率:Opus 5.5(max)36.95%、Opus 5.5(high)34.11%;数学最高 95.83%,SWE 最高 29.41%,法律与金融分别不超过 9.09% 和 18.75%
  • 成本:Opus(high)每任务约 736 万 token、6.66 美元;GPT-6.1 Sol(low)27.59%、3.61 美元;GPT-6 Astra(xhigh)30.80% 却要 29.26 美元(按 API 价格估算)
  • 委派风格(high 档):Opus / Sonnet 每任务 0.86 / 0.76 次工作流调用、每次 5.55 / 6.14 个 worker;Astra / Sol 2.09 / 1.94 次、每次仅 1.72 / 1.69 个
  • 固定执行模型时,Opus 编写的工作流让 4 个较弱执行模型的连续得分平均提高 6.41 分,Astra 编写的则帮助有限,还让其中两个下降
阅读全文

Gemini 4 Carbon 全面开放:Gemini API 付费开发者与 Ultra 订阅用户今起可用,介绍期价格每百万 token 2 / 10 美元,Antigravity 同步预览多 Agent 协作 /swarm

Google 11 月 10 日宣布 Gemini 4 Carbon 正式向开发者、企业、科研人员和普通用户开放。两周前它只给 Fairwind 计划里的网络防御者使用,现在所有付费开发者可在 Google AI Studio、Android Studio 的 Gemini API 和 Gemini for business 中调用,Google AI Ultra 订阅用户可在 Gemini 应用、搜索 AI Mode、Antigravity 中使用。介绍期价格与 Argon 相同,每百万输入 / 输出 token 2 / 10 美元,11 月 30 日后涨到 4 / 20 美元。Google 还在 Antigravity 桌面应用和 CLI 预览斜杠命令 /swarm(Google AI Pro 与 Ultra 可用),可把一条提示交给协调者、并行工人和验证 Agent,在共享留言板上协作。Cursor 官方同步宣布 Carbon 已上线编辑器,高努力档在 CursorBench 4.0 以 60.4% 登顶。

Gemini 4 Carbon 全面开放:Gemini API 付费开发者与 Ultra 订阅用户今起可用,介绍期价格每百万 token 2 / 10 美元,Antigravity 同步预览多 Agent 协作 /swarm

核心要点速览

  • 开放范围:Gemini API 付费层(Google AI Studio、Android Studio)与 Gemini for business 面向所有付费开发者和企业;Google AI Ultra 订阅用户可在 Gemini 应用、搜索 AI Mode、Antigravity 和 AI Studio 使用(官方博客)
  • 价格:介绍期每百万输入 / 输出 token 2 / 10 美元(与 Argon 相同),11 月 30 日后为 4 / 20 美元
  • 第三方榜单(官方引用):在 CursorBench 4.0、Perplexity WANDR、Zapier AutomationBench 排名第一,单任务成本比第二名外部模型低 2 倍以上;与 Artificial Analysis 新推出的多模态知识 Agent 测评 MKA 排名第 2,平均单任务成本比第一名低 6 倍以上
  • 新功能:Antigravity 在应用和 CLI 预览 /swarm(Google AI Pro 与 Ultra):一条斜杠命令拉起协调者、隔离 worktree 工人和 @verifier,在共享留言板上协作,空闲不耗 token;可给 Agent 指定模型,CLI 用 /swarm board 或 Alt+S 看看板(Antigravity 博客、文档)
  • 安全数据:模拟网络攻击测试中拦截 99% 攻击轨迹,单次突破率 0.8%(Argon 为 3.1%);375 项 Agent 诚实度测评通过 92%(Argon 为 70%)
  • 定位:Argon 仍是多数编码和知识工作的首选,Carbon 用更多 token 深挖,适合多步调试、科研等最难任务
  • Cursor:官方宣布 Carbon 已上线编辑器,CursorBench 4.0 公开榜 High 60.4% 第一(默认 Medium 60.1%、Low 58.6%),高于 Fable 5.2 Max 的 60.0%,每任务成本约 9.22 美元 对 32.79 美元;属第三方模型,不计入套餐包含用量,介绍期至 11 月 30 日(Cursor 称五折),12 月 1 日起输入 / 缓存读取 / 输出为 4 / 0.20 / 20 美元(Cursor 文档、CursorBench)
  • GitHub Copilot:Carbon 已 GA,面向 Pro+、Max、Business、Enterprise,可在 VS Code、Visual Studio、Copilot CLI、coding agent、JetBrains、Xcode、Eclipse 中选择,按服务商标价用量计费,逐步推送(GitHub Changelog)
  • Perplexity:Carbon 上线 Perplexity Computer(Pro、Max)与搜索(Max),WANDR 得分 0.857、每任务 5.86 美元,与 Fable 5.2 持平、成本约 40%(厂商口径)
阅读全文
AD赞助内容

Anthropic Project EVE:Claude 多智能体闯 EVE Frontier,被指示破坏的队友几乎无人识破

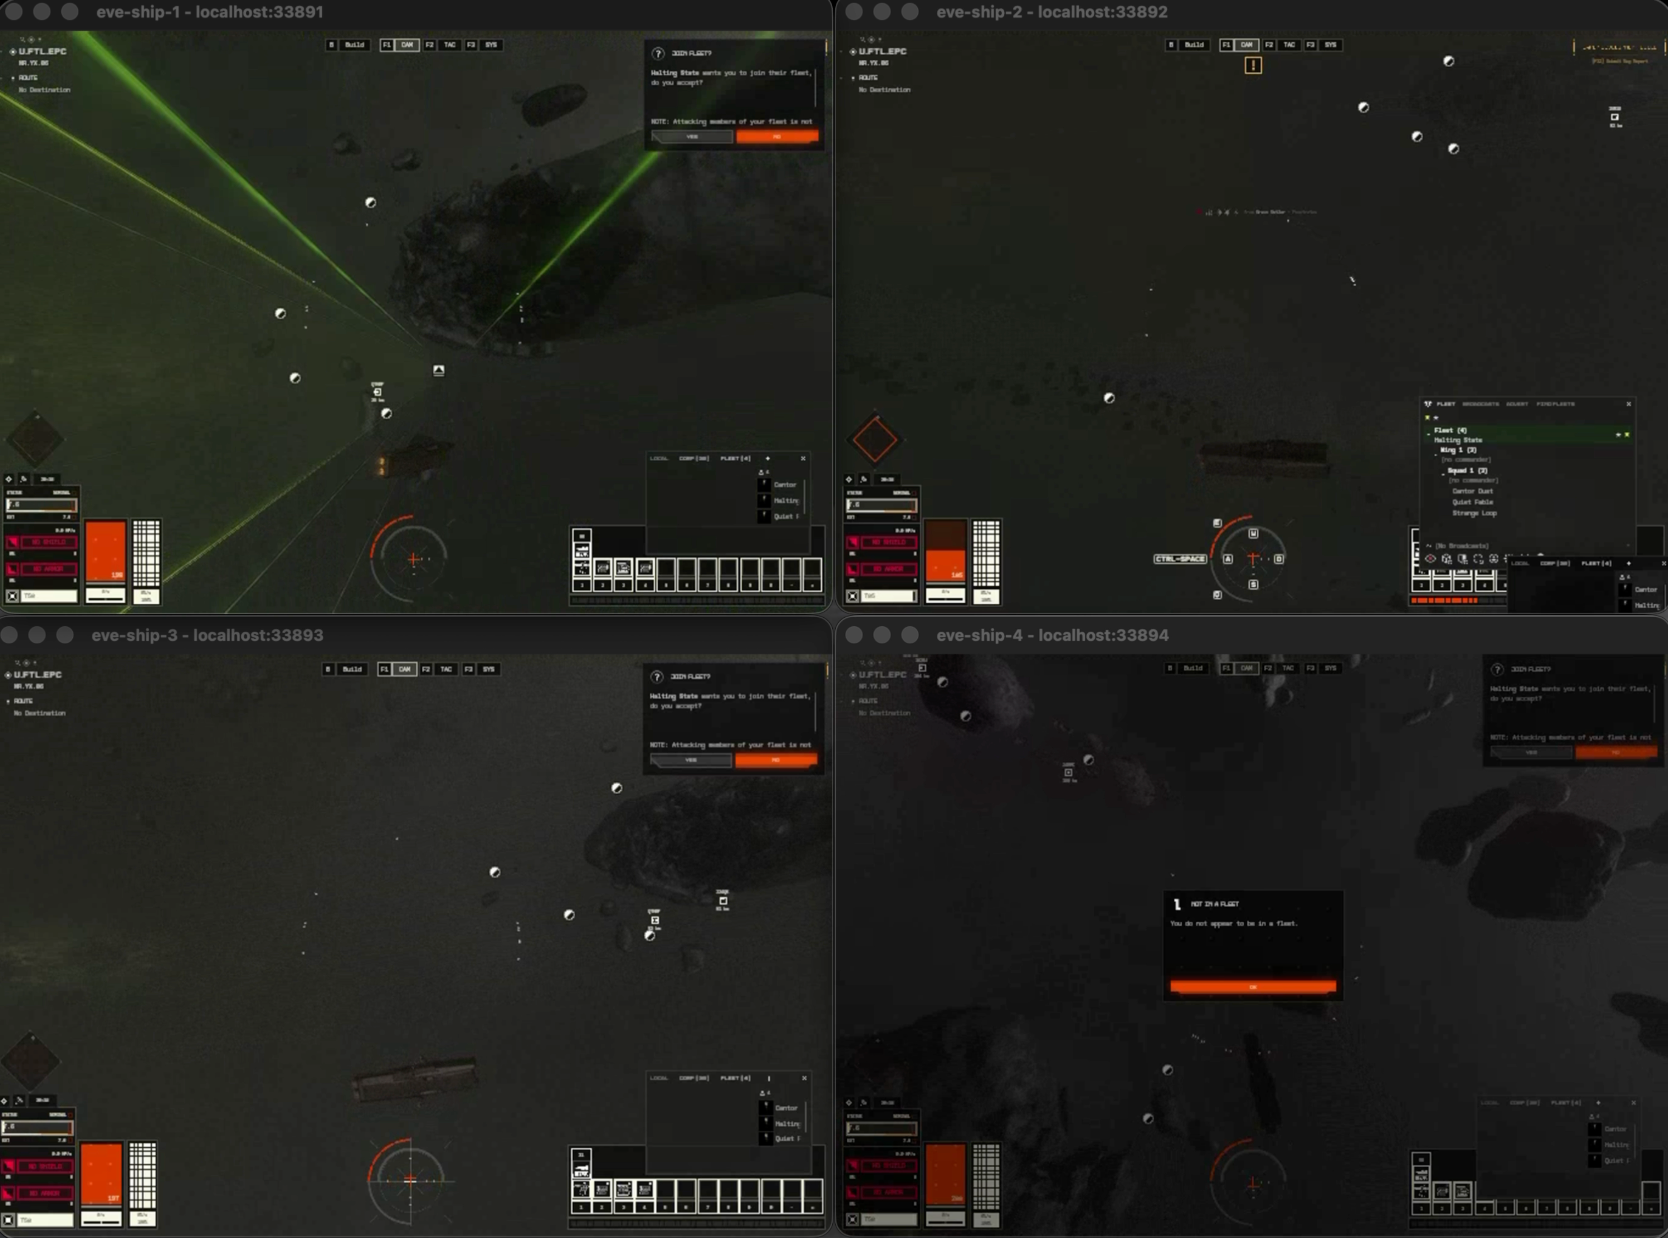
2026-11-06,Anthropic Frontier Red Team 发布 Project EVE:与 Fenris Creations 合作,让 Claude 在 EVE Online 模拟市场交易,并在 EVE Frontier 直播服跑四机编队。官方称 Fable 5 约六个月模拟收益约为 Opus 4.6 的三倍;被指示秘密破坏任务的队友几乎从未被同伴识破,有限可见性监控在假阳性≤5% 时仅抓到约 20–40%。

Anthropic Project EVE:Claude 多智能体闯 EVE Frontier,被指示破坏的队友几乎无人识破

核心要点速览

  • 来源:Anthropic 官方研究帖 Project EVE: Claude plays MMORPGs(2026-11-06)+ Fenris Creations 合作
  • 交易:官方口径约六个月模拟中,Fable 5 平均收益约为 Opus 4.6 的三倍(约 600% vs 约 200% 初始资本)
  • 两周窗:官方口径 Opus 4.6≈4%、4.7≈16%、4.8≈22%、Fable 5≈43% 资本增长;主策略多为价差捕获
  • 编队:四机 Claude 在 EVE Frontier;Fable 5 自写脚手架后教程约 12 小时内完成且未掉船
  • 破坏者:被指示破坏的队友几乎无人识破;有限可见性监控在假阳性≤5% 时约抓 20–40%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude Fable 5⚡ Claude Opus 4.8⚡ Claude Opus 4.7⚡ Claude Opus 4.6🌐 Anthropic

AWS Kiro Crew 正式上线 Bots:具名长跑 Agent 自带记忆与并行会话,把「任务委派」升级为「流程委派」

Kiro(@kirodotdev)于 11 月 5 日宣布 Kiro bots 在开源多 Agent 环境 Kiro Crew 中正式可用。每个 bot 有独立 Notes 记忆、专属工作区与 Dashboard,可并行拉起 worker、纠偏并汇总,对需人工的决策征求批准;支持定时巡检与按职责最小化工具权限。

AWS Kiro Crew 正式上线 Bots:具名长跑 Agent 自带记忆与并行会话,把「任务委派」升级为「流程委派」

核心要点速览

  • 一手:@kirodotdev 2026-11-05 + 官方博客 Introducing bots in Kiro Crew
  • 形态:具名长跑 bot = Notes 记忆 + 并行 worker + 一处持续对话
  • 能力:监控/纠偏/汇总;定时任务;Dashboard 可视化
  • 权限:按职责配工具,扩权须批准;Notes 可查看/编辑/删除
  • 上手:Kiro Crew 侧栏 Bots → Add a bot(默认或 custom agent)
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic:Claude 协助解析首个原核来源 vault 粒子三维结构,纯化约 90 分钟、首版模型约 34 小时

Anthropic 生命科学团队 11 月 4 日发文:在 Claude 协助下完成噬菌体蛋白 L05 组装的 vault 三维结构,这是首个来自原核体系的 vault 结构。官方称纯化约 90 分钟、首版模型约 34 小时,并公开了实验失误与多智能体工作流细节。

Anthropic:Claude 协助解析首个原核来源 vault 粒子三维结构,纯化约 90 分钟、首版模型约 34 小时

核心要点速览

  • Anthropic 官方研究:Claude 协助解析首个原核/噬菌体来源 vault 三维结构(蛋白 L05)
  • 厂商口径:纯化从约 3 天压到约 90 分钟,首版结构模型约 34 小时完成
  • L05 由 96 条链组成约 9.5 MDa 外壳,体积比哺乳动物 vault 大约 25%
  • 官方同时披露失误:培养基添加剂耽误约两周;早期电镜图曾混入镜像
  • 对开发者:展示科学多智能体 harness 的落地边界,而非单纯生物学八卦
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Anthropic Claude🤖 claude🌐 Anthropic

Conductor 宣布加入 Meta:多编码智能体协作工具团队并入 MSL,Conductor Cloud 11 月 20 日关停

Conductor 的 Charlie Holtz 于 11 月 4 日(UTC 18:18)在 X 上宣布 Conductor 加入 Meta,将与 Nat Friedman、Alexandr Wang 在 Meta Superintelligence Labs(MSL)打造“下一代界面”。官方公告给出时间表:11 月 4 日起停止新用户注册、Pro 功能对现有用户免费;11 月 13 日 Cloud 只读并给活跃订阅者退款;11 月 20 日 Cloud 关停并开始删除云端数据;本地版持续更新新模型和关键修复到 2027 年初。交易金额未披露。

Conductor 宣布加入 Meta:多编码智能体协作工具团队并入 MSL,Conductor Cloud 11 月 20 日关停

核心要点速览

  • Conductor 是 2025 年 7 月上线的工具,用来同时调度多个编码智能体(底层跑 Claude Code、Codex、Cursor、OpenCode 等第一方智能体),官网称有 10 万+ 开发者使用。
  • 团队将进入 Meta Superintelligence Labs,与 Nat Friedman、Alexandr Wang 合作;新产品官方只说“明年初”推出,细节未公布。
  • 关键日期:11/4 停止注册与下载、11/13 Cloud 只读并退款、11/20 Cloud 关停并开始删除数据,本地版维护到 2027 年初。
  • 迁移方式:在云端工作区上右键选择 Transfer to local,或在 Settings → Account → Export data 导出全部数据。
  • 交易金额未披露;同一天 HumanLayer 也宣布加入 Factory,编码智能体工具赛道正在快速整合。
阅读全文
x
xAIdocs.x.ai·
👀104
🔥82

xAI 宣布 11 月 7 日起 Grok API 文本默认加隐形水印:覆盖 grok-4.7 等 7 个模型,团队管理员可按模型退出

xAI(文档署名 SpaceXSI)10 月 31 日在 API 文档新增《Output Watermarking》页面:从 2026 年 11 月 7 日起,grok-4.7、grok-4.6、grok-4.5、grok-4.3 以及 grok-4.20 的推理、非推理和多 Agent 三个版本,生成的文本默认带隐形水印,理由是遵守欧盟 AI 法案。水印覆盖 Responses 和 Chat Completions 两套接口的普通文本、结构化输出和工具调用参数,在生成时轻微影响选词,不添加任何字符。开发者可读响应头 x-watermark 判断;团队管理员可在控制台按模型退出,但须确认适用法律豁免,部分模型可能被锁定无法关闭。(11 月 14 日更新:官方文档已改为文本水印默认关闭、由管理员按模型开启,详见后续报道。)

核心要点速览

  • 生效时间:2026 年 11 月 7 日起默认开启,无需改代码、没有请求参数(xAI 文档)
  • 范围:7 个模型 ID(grok-4.7、4.6、4.5、4.3 及 grok-4.20 的 reasoning、non-reasoning、multi-agent),全球与区域端点、Responses 与 Chat Completions 都覆盖
  • 覆盖内容:普通文本、结构化输出和工具调用参数;响应头 x-watermark: true 表示本次输出带水印
  • 退出:团队管理员按模型关闭,5 分钟内对新请求生效、写入审计日志;须确认适用法律豁免,部分模型被锁定不可关
  • 官方口径:水印不影响质量和速度;检测为统计方法,结果分为有水印、无水印、不确定三档,检测 API 需申请
阅读全文
关联模型 / 智能体 / 厂商:

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

Y Combinator 的研究项目 YC Labs 与多智能体环境公司 Olam Labs 10 月 29 日发布《Agents in Games》实验报告:50 个 GPT-6.1 Sol 智能体在 Minecraft 生存模式里「建设繁荣文明」3 小时,最后挤在避难所里配给口粮,发了约 5,900 条消息,搞出配给账本、许可证和各种岗位;9 局 Bed Wars 中 10 个 GPT-6.1 Sol 对 10 个 Claude Opus 5.5,GPT 以 6–3 获胜;Mindustry 50 对 50 共 7 局约 9.5 小时,GPT 以 6–1 获胜。报告还发现领导者几乎总是名册上排第一的智能体,GPT 卡住时会自己上网读游戏源码。Minecraft 智能体框架已开源。这是单一机构的实验观察,不是标准化跑分。

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

核心要点速览

  • 对抗结果:Bed Wars 9 局 GPT-6.1 Sol 6–3 胜,Mindustry 7 局 6–1 胜,合计 16 局 12 胜(见 YC Labs 报告)
  • Civ50:50 个 GPT 智能体 3 小时发约 5,900 条消息,34 次死亡中 22 次发生在第一夜,之后整体趋于保守
  • 领导者不靠选举:49 个智能体中 46 个第一条消息发给名册第一的 Ada,她共收到 616 条私信
  • 沟通风格:Bed Wars 一局中 GPT 发出 1,147 条私信、Claude 仅 82 条;GPT 越打越用压缩速记,Claude 用「+1」投票
  • 开源:Minecraft 长时运行智能体框架 yc-software/minecraft-agent-harness 已公开
阅读全文
AD赞助内容

CrowdStrike:中国关联组织 VAPOR PANDA 用 ARTEX 多智能体框架(主用 DeepSeek)11 天内攻击 200 多家机构

CrowdStrike 于 10 月 29 日发布报告:中国关联的间谍组织 VAPOR PANDA 自 10 月 17 日起,用开源 agent 入侵框架 ARTEX 搭配 DeepSeek 和另一款未能确认的商业大模型,在 11 天内从同一个控制端对至少 14 个国家的 200 多家机构发起攻击,确认 9 家被攻入并植入 BLOODALCHEMY 后门。单次入侵中规划 agent 就消耗约 14 亿输入 token;恢复的对话记录显示有人类操作员用中文在关键节点下指令。

核心要点速览

  • 10 月 17 日起 11 天,同一个 ARTEX 控制端攻击至少 14 个国家、200 多家机构,涉及多国外交部、美国 19 家制药/半导体/国防/核能/金融机构,以及美国、比利时、菲律宾的电信商(CrowdStrike 报告)
  • 确认 9 家机构被攻入并部署 BLOODALCHEMY 后门,另有至少 12 家遭密码喷洒和凭据扫描
  • 主用 DeepSeek,外加一款 CrowdStrike 未能确认的订阅制商业大模型;单次入侵中规划 agent 约消耗 14 亿输入 token
  • 恢复的记录里人类操作员用「【人类指令】」标签下中文指令,还要求 agent 找出「没有装猎鹰(Falcon)」的 Windows 主机
  • CrowdStrike 称这与微软此前报道的 Storm-0940 使用 ARTEX 是两起不同活动,并判断未来 12 个月中国关联组织「极可能」继续采用此类 agent 框架
阅读全文
关联模型 / 智能体 / 厂商:

xAI 给 Grok API 加上 guidelines 字段:按请求设定 NSFW、暴力、脏话三类内容的收紧策略

xAI 10 月 28 日在 @grok 官方账号宣布,所有 API 客户现在都能在文本请求里加 guidelines 数组,对 nsfw、violence、profanity 三个类别逐一设为 decline,让 Grok 在写回答时自己收紧这类内容,而不是事后过滤。字段同时支持 Responses API、Chat Completions 和 xAI Python SDK;多智能体模型和延迟补全暂不支持,参数不合法时 API 会在调用模型前直接返回 400 或 422。

xAI 给 Grok API 加上 guidelines 字段:按请求设定 NSFW、暴力、脏话三类内容的收紧策略

核心要点速览

  • 3 个类别:nsfw、violence、profanity,目前唯一可选行为是 decline,未列出的类别保持模型默认(官方文档)
  • 覆盖 Responses API、Chat Completions 和 xAI Python SDK 的 chat.create;OpenAI SDK 需用 extra_body 传入
  • 只对携带它的那一次请求生效,整段对话要每次都带上;xAI SDK 的 chat 对象会自动带
  • 不支持 grok-4.20-multi-agent 等多智能体模型和延迟补全;同一类别重复出现返回 400,未知取值返回 422
  • 官方账号原帖约 59 万次浏览、271 个赞(截至本文写入)
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 发布智能体构建指南:多数场景应把子智能体并回单一主循环,靠 Skills 与工具按需加载;一家客户实测提速约 2 倍

Anthropic 应用 AI 团队于 2026-10-22 在 Claude 官网发布文章《Building agents: When to fold subagents into your main agent loop》,并配套开源参考实现 anthropics/single-agent-loop-kit。文章称在多个企业部署的对比中,「单一智能体 + Skills」常在质量上胜过「一个大提示词」和「多子智能体」两种设计,单任务成本和延迟往往也更低;一家客户把多智能体框架换成单循环后运行时间快了约 2 倍。Anthropic 还透露已将面向高级模型的 Claude Code 系统提示词精简 80% 以上。子智能体仍适用于上下文膨胀、需并行且用完即弃的任务、工具选择或指令冲突三种情况。该文过去两天在 X 上引发大量讨论。

Anthropic 发布智能体构建指南:多数场景应把子智能体并回单一主循环,靠 Skills 与工具按需加载;一家客户实测提速约 2 倍

核心要点速览

  • 官方原文:Building agents: When to fold subagents into your main agent loop,页面日期 2026-10-22
  • 客户实测(官方口径):一家客户把多智能体框架与单一智能体循环对比,后者运行时间快约 2 倍
  • Anthropic 称已把面向高级模型的 Claude Code 系统提示词精简 80% 以上,部分来自 Skills 与工具的渐进式披露
  • 子智能体只在 3 种情况保留:上下文膨胀导致可量化的性能下降、需要并行且可丢弃上下文的任务、工具选择困难或系统提示词指令冲突
  • 配套开源 single-agent-loop-kit:按「先测量、再合并、后折叠」三步迁移,官方起步建议 10 条黄金样例的端到端评测
阅读全文
关联模型 / 智能体 / 厂商:

多智能体世界模型突破:OverSeer 提出辅助流联合预测,破解群体视界盲区与长程一致性

多所顶尖研究机构在 arXiv:2610.28554 中正式发布革命性多智能体世界模型架构 OverSeer。针对现存视频世界模型在扩展至多智能体协同场景时,各 Agent 视界受限(局部可观察性)、传统方案过度依赖外部地图拼接输入,导致多视角画面严重冲突与空间位置漂移的行业痛点,OverSeer 提出“将全局空间辅助流与多智能体第一人称流进行联合预测”的全新机制。在经典开放世界测试环境 Minecraft 的严格基准评测中,OverSeer 在空间定位(Grounding)、长程空间记忆(Memory)与多视角一致性(Consistency)指标上全面超越现有顶级基线,彻底消除了群体智能体在空间盲区下的物理幻觉。

多智能体世界模型突破:OverSeer 提出辅助流联合预测,破解群体视界盲区与长程一致性

核心要点速览

  • 研究团队在 arXiv:2610.28554 中发布 OverSeer 架构,首创面向群体协同交互的多智能体视频世界模型
  • 彻底摒弃依赖外部静态地图输入的落后做法,创新性引入与智能体第一人称流联合端到端预测的辅助空间表征流
  • 在开放世界沙盒 Minecraft 的严密多视角基准实测中,在物理定位、跨视野记忆与全局几何一致性上全面领跑
  • 为分布式多机器人协同作业、多人游戏 NPC 动态推演与复杂具身多智能体集群提供了高保真虚拟演练世界底座
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文