AI 编程实时动态与要闻

Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

Artificial Analysis 11 月 13 日发布 Diarization Index,专门衡量语音转文字 API 能否把每个词归到真正说话的人:指标是 WDER(被分给错误说话人或无人说话的词占比),测试集为 97 段 2–8 人英文对话,按 2 人、3–4 人、5–8 人三档等权平均。NVIDIA 开源权重的 Nemotron 3.5 Transcribe 以 3.3% 居首,Voxtral Small Transcribe 3 以 7.5% 排第二,也是有标价 API 里最准的;MAI-Transcribe-2 为 8.8%,速度最快之一。
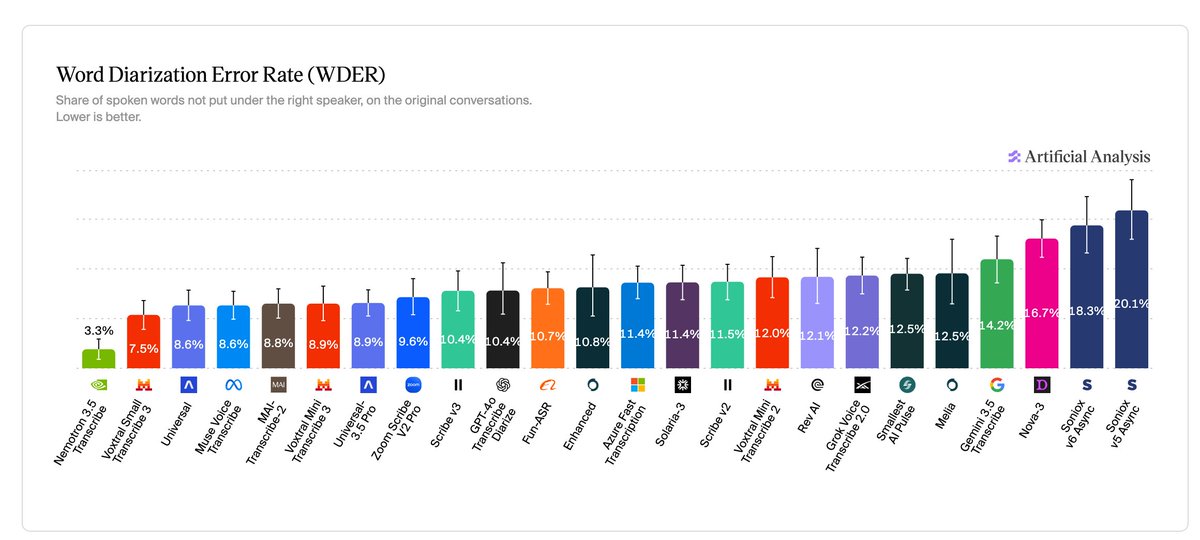
Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

核心要点速览

  • 新指标 WDER =(分错说话人的词 + 无人说话时段的词)÷ 参与评分的参考词数,越低越好;AA 称不用 DER,因为对 API 而言 DER 主要在考词时间戳而不是谁在说话
  • 测试集 97 段对话、每段约 2–9 分钟、总时长约 6.8 小时,真实与合成语音混合,大部分音频为私有留出集,另含约 126 分钟公开的 NOTSOFAR-1 会议录音
  • 评测时直接调用各 API 并开启说话人分离,不告诉模型有几个人在说话,整段音频一次送入;价格包含单独收费的分离功能
  • Nemotron 3.5 Transcribe 2 人对话 WDER 1.7%,5–8 人时也只有 5.6%;在人数最多的一档,其他所有 API 的 WDER 都超过 10%
  • Voxtral Small Transcribe 3 为 7.5%、每千分钟 4 美元;MAI-Transcribe-2 为 8.8%、每千分钟 1.67 美元,每等 1 秒可转写 93.7 秒音频;Nemotron 3.5 Transcribe 是开源权重模型,AA 未列价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe⚡ Voxtral Small Transcribe 3⚡ MAI-Transcribe-2🌐 Artificial Analysis🌐 NVIDIA🌐 Mistral AI🌐 Microsoft
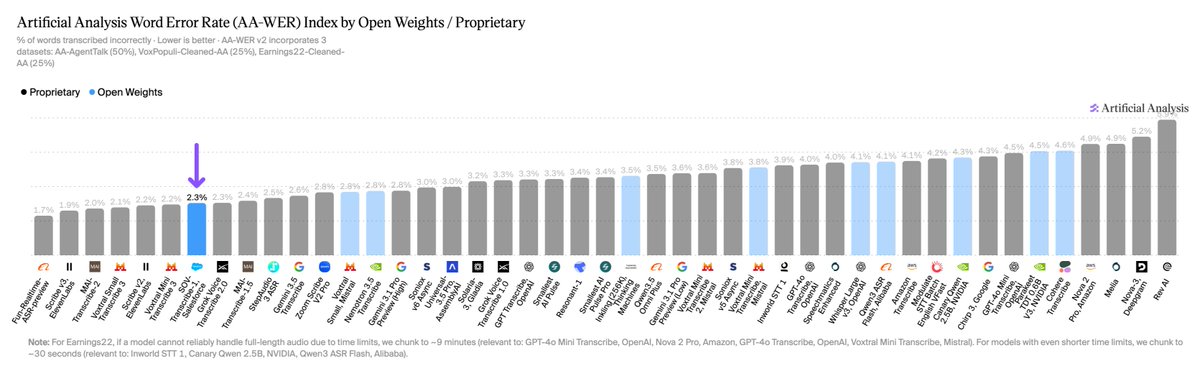
Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

新加坡时间 11 月 13 日 00:30,Artificial Analysis(@ArtificialAnlys)发帖称,Salesforce 新发布的 SOV-Transcribe-1 成为开源权重语音转文字模型第一名:在 AA-WER 指数上词错误率 2.3%,在包括闭源模型在内的 44 个模型中排第 7。它比紧随其后的开源模型 Mistral Voxtral Small 和英伟达 Nemotron 3.5 Transcribe(均为 2.8%)低 0.5 个百分点。模型由 Salesforce 主权 AI(Missionforce Sovereign AI)团队开发,总参数 26.6B、激活参数 4.6B,结构是 Whisper large-v3 音频编码器加 Gemma 4 26B A4B MoE 解码器,权重以 Apache 2.0 许可发布在 Hugging Face。它是非流式模型,适合整段录音转写,不适合实时字幕。

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

核心要点速览

  • AA-WER 2.3%:开源权重第 1、44 个模型中总榜第 7;Voxtral Small 与 Nemotron 3.5 Transcribe 均为 2.8%
  • 分数据集:Earnings22 财报电话 4.1%(Voxtral Small 4.8%),VoxPopuli 1.5%(对手 1.8%),AA-AgentTalk 语音客服对话 1.8%,与 Nemotron 持平
  • 26.6B 总参数 / 4.6B 激活;Whisper large-v3 编码器 + 投影层 + Gemma 4 26B A4B MoE;BF16,单段音频实测最长 30 分钟,支持英法德西意葡荷 7 种语言
  • 官方称 VoiceCodeBench(电话号码、邮箱等实体)任务成功率 76.3%、实体召回 93.4%,23 个系统中排第 2;AppTek 14 种英语口音平均 WER 8.21%,其中 8 种口音最低(含新加坡英语)
  • Apache 2.0;可用 vLLM 插件(vLLM 0.32.0)或 Transformers 部署;官方实测单张 RTX PRO 6000 Blackwell 每秒可转写 1,039 秒音频(配合 DFlash 草稿模型)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SOV-Transcribe-1⚡ Voxtral Small⚡ Nemotron 3.5 Transcribe⚡ Gemma 4⚡ Whisper large-v3🌐 Salesforce🌐 Artificial Analysis🌐 Mistral AI🌐 NVIDIA🌐 Google

X 热议:黄仁勋辞职半小时后,Hugging Face CEO Clem Delangue 发帖称「真是难过的一天」,但会「比以往更努力地为开源 AI 而战」;Raschka、Nathan Lambert 担心英伟达 Nemotron 开源路线与待交割的 Hugging Face 收购

新加坡时间 11 月 12 日 22:18,也就是英伟达官宣黄仁勋辞职约 29 分钟后,Hugging Face 联合创始人兼 CEO Clem Delangue(@ClementDelangue)发帖:「这整件事很糟糕,我希望它从没发生。真是难过的一天!但我想说清楚一点:我们会继续为开源 AI 而战,而且比以往更努力。」帖子本身没有点名黄仁勋或英伟达,但发布时间和评论区讨论都指向这次 CEO 交接。背景是英伟达 9 月已同意以 129.3 亿美元收购 Hugging Face,交易预计 2027 年上半年完成,尚待监管批准。截至发稿,该帖约 16.4 万浏览、4,800 赞、215 条回复。同一时段,Sebastian Raschka 写道「希望 Nemotron 继续做下去」,Nathan Lambert 也向英伟达 Nemotron 和 Hugging Face 团队喊话支持。本文是社区讨论,不代表英伟达或 Hugging Face 官方对后续安排的表态。

核心要点速览

  • Clem Delangue 帖子发于英伟达公告后约 29 分钟,约 16.4 万浏览、4,800 赞、436 转发、215 回复;原帖未点名黄仁勋
  • 英伟达 9 月 3 日官宣以 129.3 亿美元收购 Hugging Face(约 119 亿美元给股东,最多约 10 亿美元员工留任激励),预计 2027 年上半年交割,仍待监管批准
  • 官方收购公告承诺:Hugging Face 保持开放,不强制使用英伟达算力,继续支持多云和多种加速器
  • 英伟达官方称已在 Hugging Face 发布 500+ 个模型和 250+ 个开放数据集;Raschka 认为 Nemotron 的开放数据和完整训练配方最难被替代
  • 11 月 12 日 CEO 交接公告称运营、客户承诺和产品路线图预计不受影响,未单独提及 Hugging Face 交易或 Nemotron
阅读全文
关联模型 / 智能体 / 厂商:

ElevenLabs 纽约峰会发布 Agent 全家桶:Interaction Engine 按对话环节自动切换便宜模型与前沿模型,ElevenAgents 加入记忆和 Routines,NVIDIA Nemotron 3.5 Super VL 今起可选

ElevenLabs 11 月 11 日在纽约峰会上集中公布了下一阶段的 Agent 路线。已上线的有:NVIDIA Nemotron 3.5 Super VL 进入 ElevenAgents 模型列表;ElevenLabs Partner Program 与 McKinsey 联盟;新应用 ElevenAI 开放免费早期访问。预览或“未来几个月”推出的有:Interaction Engine(管理打断与轮流发言,并为对话每个环节挑选合适的 LLM,简单分流用便宜模型、退款等复杂环节交给前沿模型)、ElevenAgents 的 Memory 与 Routines,以及与企业合作微调开源 LLM 和自家语音模型。

ElevenLabs 纽约峰会发布 Agent 全家桶:Interaction Engine 按对话环节自动切换便宜模型与前沿模型,ElevenAgents 加入记忆和 Routines,NVIDIA Nemotron 3.5 Super VL 今起可选

核心要点速览

  • 已上线:NVIDIA Nemotron 3.5 Super VL 进入 ElevenAgents;在 ElevenAgents 客服任务基准上,端到端任务完成率领先,成本比其他主流开源模型低 70%,关闭推理后跻身平台最快的 3 个模型之列(厂商口径)
  • 预览:Interaction Engine 负责轮流发言和打断,并按对话环节在便宜模型与前沿模型之间切换,省 token
  • 即将推出:Memory 记住老客户提过的偏好与约束;Routines 在通话前、中、后执行多步任务(预审、回拨、写 CRM、发邮件)
  • 生态:合作伙伴超 550 家、覆盖 44 个国家;Marketplace 明年起可用现有 ElevenLabs 承诺额度购买行业 Agent
  • 算力:新增 15 MW NVIDIA Vera Rubin 容量;为波兰全国电子医疗平台(每年约 4000 万次预约)部署本地语音 Agent
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Omarchy 本地模型引擎 omarchy-local-ai 0.5.0 发布:64 GB 机器默认推荐 Nemotron 3.5 Bolt,DHH 称 Omarchy 4.6 将按硬件自动推荐最佳本地模型

11 月 9 日 08:30 UTC,Omarchy 作者 DHH 发布本地模型引擎 omarchy-local-ai v0.5.0,把本地模型支持扩展到 64 GB 的 NVIDIA GB10 / N1x 级机器,并把 Nemotron 3.5 Bolt 设为这一档的默认推荐(项目方实测:262K 完整上下文,短提示 91 tok/s、32K 提示 82 tok/s,峰值内存不到 40 GiB)。约 20 分钟后他在 X 上说,Omarchy 4.6 会为每台机器推荐能跑的最佳模型,并晒出 AMD 送他的 Ryzen AI Max+ 495 机器在 Agents 面板里同时挂着 Claude Code 订阅和本地 Qwen3.8 Flash Next(占用 94 GiB)。这套能力来自 11 月 1 日合并的 PR #17267:一条 omarchy agent local use best 命令按显卡家族和内存档位挑模型,在断网的 rootless Podman 容器里运行,供 OpenCode、pi 等编码 Agent 调用。4.6 的发布日期尚未公布。

Omarchy 本地模型引擎 omarchy-local-ai 0.5.0 发布:64 GB 机器默认推荐 Nemotron 3.5 Bolt,DHH 称 Omarchy 4.6 将按硬件自动推荐最佳本地模型

核心要点速览

  • 发布:omarchy-local-ai v0.5.0 于 11 月 9 日 08:30 UTC 由 DHH 发布;64 GB GB10 / N1x 默认 Nemotron 3.5 Bolt,备选 Qwen3.8 27B(131K 窗口)
  • 实测(项目方口径):Bolt 在 64 GB 上跑满 262K 上下文,短提示 91 tok/s、32K 提示 82 tok/s,峰值 <40 GiB
  • 推荐表 best.toml 目前覆盖 3 档:Strix Halo 128 GB(Flash Next → 27B)、GB10/N1x 128 GB(Flash Next → Bolt → 27B)、GB10/N1x 64 GB(Bolt → 27B)
  • Ryzen AI Max+ 395 / 128 GB 上 Flash Next 在 v0.3.0 达 47.5 tok/s(32K)、代码编辑 105 tok/s;27B 改 4-bit 后 20.7 tok/s、40 GiB
  • 安全边界:模型跑在无外网的 rootless Podman 容器,只读根文件系统、去掉全部 capabilities,API key 用 Podman secret;DHH 原帖约 20 分钟 163 赞、21 条回复
阅读全文

LG AI Research 免费开放 K-EXAONE 2.5 API:750B 总参数、31B 激活、512K 上下文,官方口径 SWE-Bench Pro 59.2 略高于 DeepSeek-V4.1-Flash

11 月 9 日,LG AI Research 在首尔 NVIDIA AI Day 上宣布,通过 EXAONE API 平台(docs.exaone.ai)免费开放 K-EXAONE 2.5 API,开发者、初创公司、企业和研究机构领取 API Key 即可用于服务开发与研究。K-EXAONE 2.5 是在 8 月发布的 K-EXAONE 2.0 基础上加训的技术验证模型:750B 总参数、31B 激活,纯文本,支持韩语和英语,上下文 512K,接口兼容 OpenAI。LG 自测四项 Agent 基准:SWE-Bench Pro 59.2、BrowseComp 78.0、AutomationBench 74.6、Claw-Eval 77.3,整体与 DeepSeek-V4.1-Flash、GLM-5.3 相当,但没有一项全面领先。NVIDIA 表示该模型训练用到了 Nemotron 数据集。官方未公布免费期限和额度,也未开放 2.5 权重。

LG AI Research 免费开放 K-EXAONE 2.5 API:750B 总参数、31B 激活、512K 上下文,官方口径 SWE-Bench Pro 59.2 略高于 DeepSeek-V4.1-Flash

核心要点速览

  • 免费开放:EXAONE API 平台 11 月 9 日上线,目前免费,领 API Key 即可调用;同批上线的还有 21M 参数的表格预测模型 EXAONE Tabular
  • 规格:750B 总参数 / 31B 激活,纯文本,韩语 + 英语,上下文与最大输出均为 512K,知识截止 2026 年 1 月;支持工具调用、结构化输出、代码生成和流式输出
  • 接口:OpenAI 兼容的 POST /v1/chat/completions,模型名 k-exaone_v2.5;推理无法关闭,reasoning_effort 可选 low / high / max,默认 max,推理 token 也计入 max_tokens
  • LG 自测(vs DeepSeek-V4.1-Flash / GLM-5.3):SWE-Bench Pro 59.21 vs 58.41 / 64.03;BrowseComp 78 vs 75.8 / 79;AutomationBench 74.6 vs 74.9 / 71.6;Claw-Eval 77.29 vs 75.78 / 77.64
  • 相比 K-EXAONE 2.0:AutomationBench 从 16.9 升到 74.6,SWE-Bench Pro 从 47.1 升到 59.21;以上均为厂商内部评测,未经独立复现,免费期限、额度和权重开放情况官方均未说明
阅读全文
关联模型 / 智能体 / 厂商:

BoxWorks 2026:Box 联手 NVIDIA 推出 Box Context Retrieval,用 Nemotron Retriever 给企业智能体做权限感知检索,并发布 Box Architect 与 Box Mount

Box 在 11 月 5 日的 BoxWorks 2026 上宣布与 NVIDIA 扩大合作:新检索引擎 Box Context Retrieval 基于 Nemotron Retriever 嵌入模型,结合关键词与语义搜索,按现有文件权限为 AI 智能体返回最相关段落,预计明年初向 Enterprise Advanced 客户 GA。Box 新闻稿称检索准确率(Recall@5)可提升 20%、token 用量减少 90%、问答快 4 倍。Nemotron 3 Ultra 等开源权重模型即日起进入 Box AI;同时发布描述目标即可设计工作流的 Box Architect、可把 Box 文件夹挂进智能体沙箱并配合 NVIDIA OpenShell 的 Box Mount,以及含 MCP Guardrails 的智能体安全控制。

BoxWorks 2026:Box 联手 NVIDIA 推出 Box Context Retrieval,用 Nemotron Retriever 给企业智能体做权限感知检索,并发布 Box Architect 与 Box Mount

核心要点速览

  • Box Context Retrieval 基于 NVIDIA Nemotron Retriever,混合关键词与语义检索,遵守原有文件权限
  • 厂商口径:Recall@5 准确率 +20%、token 用量 -90%、问答速度 4 倍;明年初对 Enterprise Advanced GA
  • Nemotron 3 Ultra 等开源权重模型即日起可在 Box AI 中使用
  • Box Mount 把 Box 文件夹挂进智能体沙箱,可配合 NVIDIA OpenShell 安全运行时
  • 新增 MCP Guardrails、分级访问策略和审计等智能体安全控制
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3 Ultra⚡ Nemotron Retriever🌐 Box🌐 Nvidia (NIM)

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

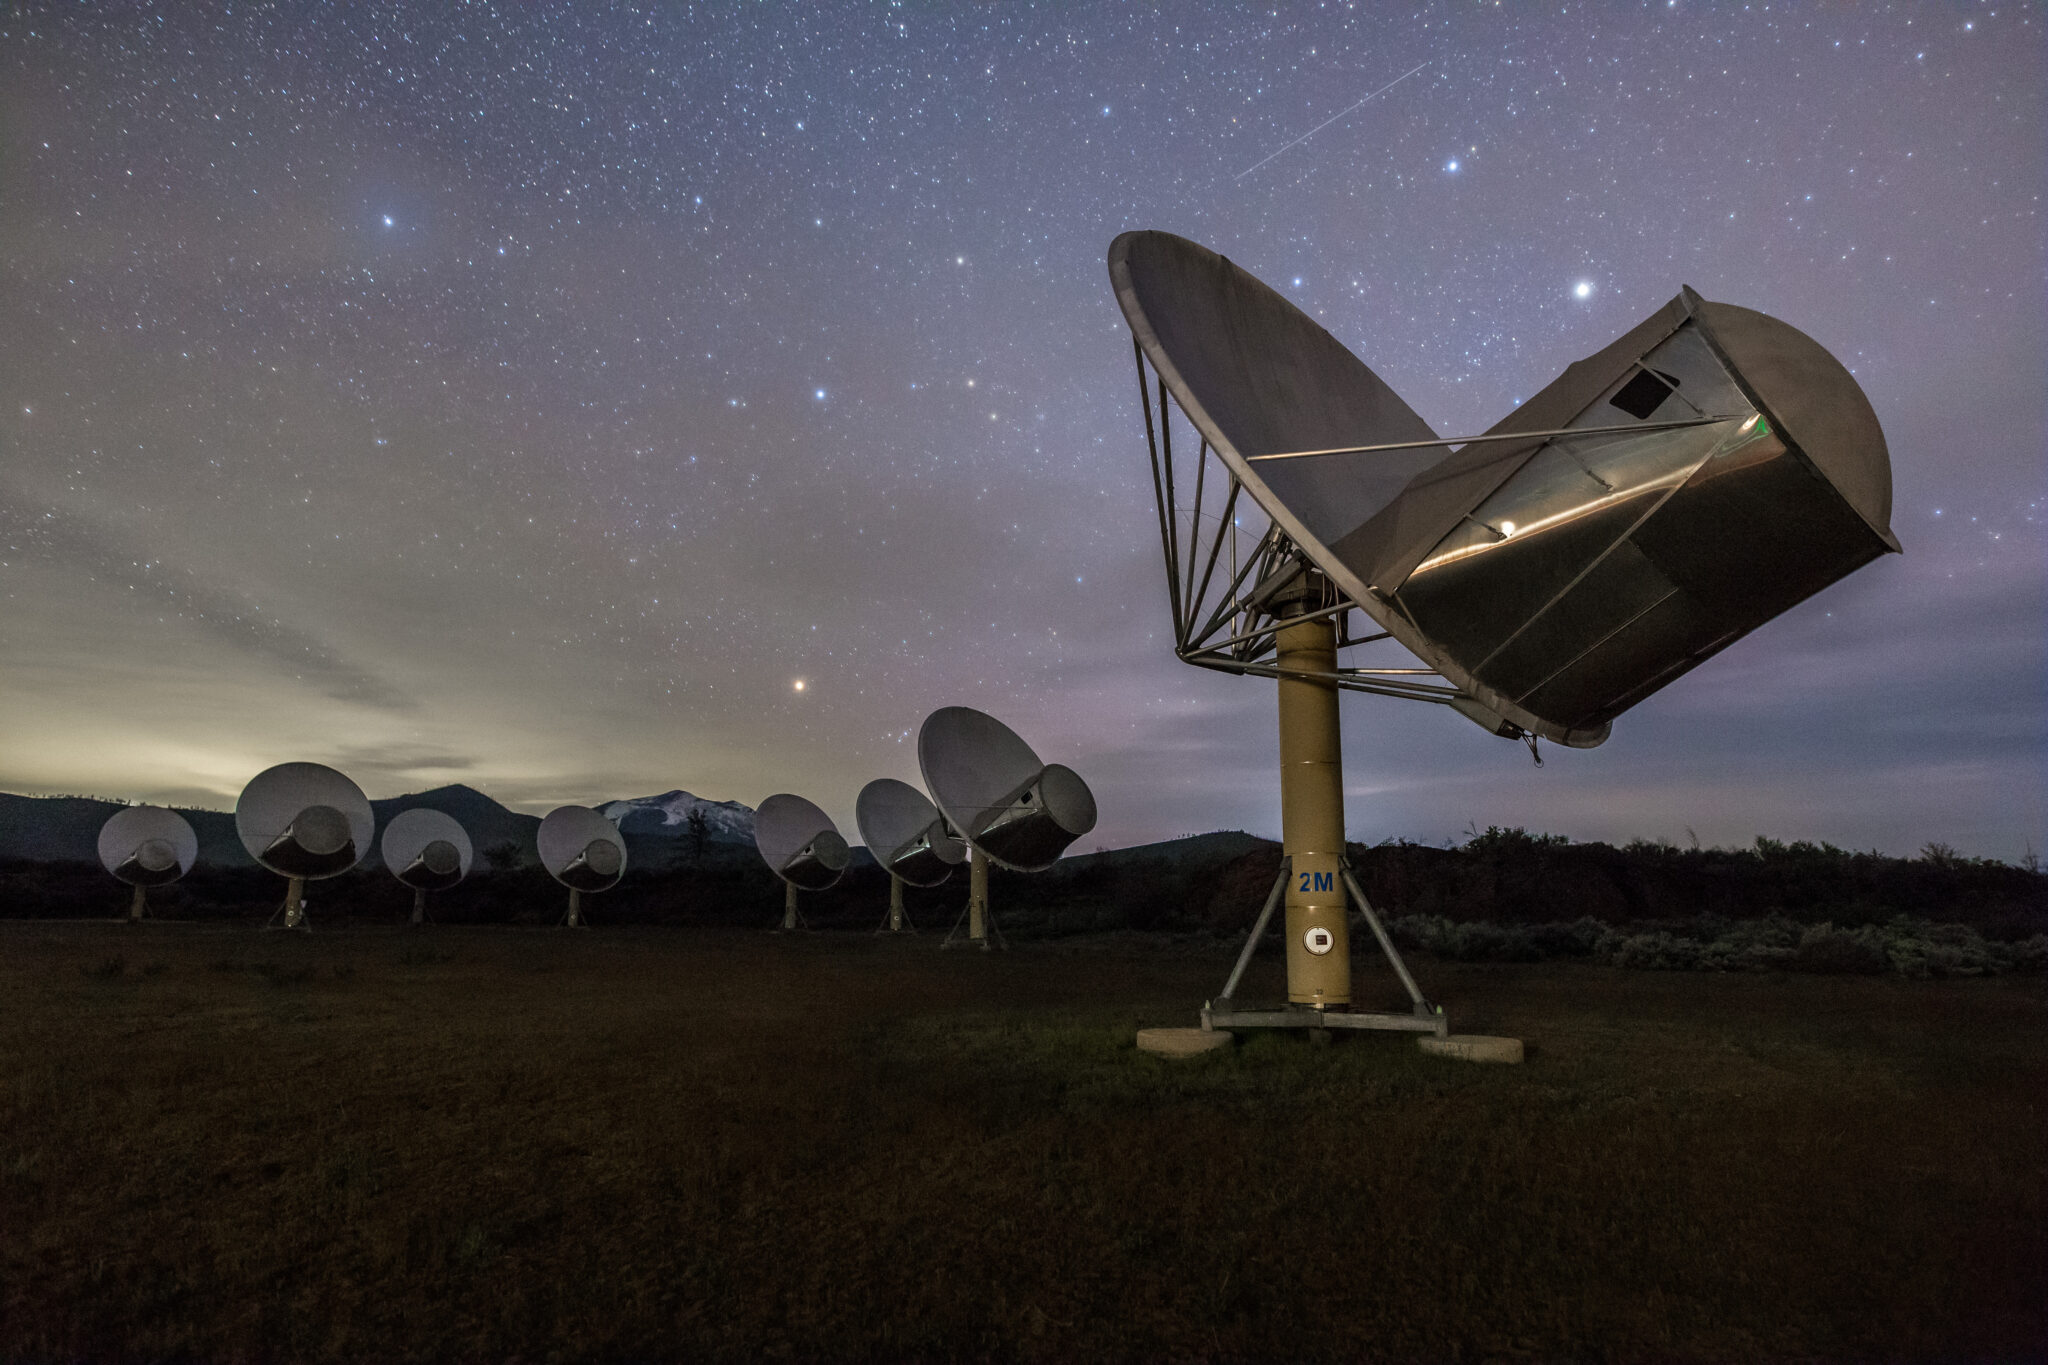
NVIDIA 官方博客 10 月 30 日披露,Breakthrough Listen 与 SETI 研究所已把 Agent 接入北加州艾伦望远镜阵列(ATA,42 面 6 米天线)的日常地外文明搜索:研究员用一句自然语言请求,Agent 就能转动天线、校准聚焦、纠正数据错误并对实时数据流跑 AI 模型。底层由 Holoscan 的 DAQIRI 库把传感器数据直接送进 GPU 显存,SETI 研究所的 CyberEther 做信号处理,Web 编排器 Nexus 充当 Agent harness,在 RTX PRO 6000 Blackwell 上本地处理最高 2.4 Tbps。系统已完成首次蟹状星云脉冲星的实时 AI 检测;团队正在评估 Nemotron 等开放模型。@NVIDIAAI 10 月 31 日万圣节帖约 274 赞。

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

核心要点速览

  • 吞吐:在 NVIDIA RTX PRO 6000 Blackwell GPU 上最高处理 2.4 Tbps 射电数据,推理在望远镜旁本地运行(NVIDIA 博客,厂商口径)
  • 三层架构:DAQIRI 把传感器数据直送 GPU 显存,CyberEther 用 cuFFT/cuBLAS 做信号处理,Nexus 作为 Agent harness 管理仪器状态、算力和流水线
  • 能力:一句自然语言即可转动 ATA 的 42 面 6 米天线、校准聚焦、修正数据错误并出图;官方称把人类数周到数年的工作压缩到数小时
  • 里程碑:完成蟹状星云脉冲星的首次实时 AI 检测;官方未公布误报率等量化指标,也没有发现地外信号
  • 下一步:评估 Nemotron 等开放模型,用于数据本地性要求高、甚至未来可能在月球背面离线运行的天文台
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

NVIDIA AI 官方账号 10 月 28 日发布 Nemotron 3.5 Transcribe,权重已上架 Hugging Face 和 ModelScope。它是可用自然语言指令驱动的离线语音模型,一个检查点同时做 40 种语言转写、31 种语言与英语互译、13 种语言的说话人标注和音频问答,可处理最长 1 小时录音、最多标注 8 位说话人。官方称它在 Hugging Face Open ASR 英文榜以 5.33% 平均 WER 居开源模型第一;Artificial Analysis 测得 AA-WER 2.8%,与 24B 激活参数的 Voxtral Small 并列开源第一。权重、Granary v2 训练数据和微调配方一并开放。

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

核心要点速览

  • 架构:语音编码器加 Mamba-2/Transformer 混合 MoE 语言模型,总参数约 30B(模型卡含音频编码器计为 34B),每 token 激活约 4B(模型卡为 4.3B),提供 BF16、FP8、NVFP4 版本
  • 能力:40 语种转写、31 语种与英语互译、13 语种说话人标注、音频问答(问答仅英语训练)、词级时间戳,单段最长 1 小时、最多 8 位说话人
  • 官方/第三方口径:Open ASR 英文榜开源第一(平均 WER 5.33%),多语种 7 语言平均 4.62%,长音频 10.98%;Artificial Analysis AA-WER 2.8%,语音智能体对话集 AA-AgentTalk 1.8%(次优开源 2.3%)
  • Artificial Analysis 在 DeepInfra 托管端点实测:速度因子 75 倍,1 分钟音频不到 1 秒转完,价格每 1000 分钟 2 美元
  • 许可为 OpenMDW-1.1,可商用;配套开放 Granary v2 数据和 NeMo Speech 微调工具,官方医疗案例中微调比最佳提示词再降 45.8% 相对 WER
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe 30B-A4B⚡ Voxtral Small🌐 NVIDIA🌐 Hugging Face🌐 Artificial Analysis

Cadence 发布 Maestro 芯片设计领域 AI 模型组合:结合 NVIDIA Nemotron 驱动 AI Super Agents,官方称质量最高提升 30%、token 效率最高 5 倍

EDA 巨头 Cadence 10 月 26 日发布 Maestro AI 模型组合,包含领域后训练 LLM、决策模型和可自我改进的 agent skills,用来驱动其 AuraStack、ChipStack、InnoStack、ViraStack 等 AI Super Agents 操作 EDA/SDA 工具。Cadence 用确定性求解器给输出打分,形成强化学习闭环。官方初步结果称相比通用基础模型质量最高提升 30%、token 效率最高 5 倍。NVIDIA 提供 Nemotron 与 OpenShell,可部署在 Cadence 云、公有云或客户本地。首批模型 2026 年第四季度向部分早期客户开放。

核心要点速览

  • Maestro 不是单个模型,而是一组领域后训练 LLM、决策模型和自我改进的 agent skills,按任务与前沿/开源模型混合调度
  • 确定性求解器和 EDA 工具对输出按工程目标与约束打分,作为强化学习反馈,形成可验证闭环
  • Cadence 口径:相比通用基础模型,质量最高提升 30%,token 效率最高 5 倍;暂无第三方评测
  • NVIDIA 提供 Nemotron 模型与 OpenShell 沙箱参考架构;客户可用自有设计数据继续后训练,支持本地部署
  • 首批模型仅在 2026 年 Q4 向部分早期客户开放;Socionext 称部署 InnoStack 预计最高 5 倍生产力提升
阅读全文
AD赞助内容

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

2026-10-23(UTC 15:41,SGT 23:41),NVIDIA AI 官方账号 @NVIDIAAI 宣布 Nemotron 3.5 Bolt E4B 4GB 上线,定位是能对话、能调用工具的本地小模型,用于本地助手、互动角色和机器人。Hugging Face 官方模型卡显示:它由 Gemma-4-E4B-it 后训练而来,总参数 8B(有效 4B),Q4_K_M 量化,输入输出各支持最多 64K token,可开关思考模式,并提供 DFlash 推测解码草稿模型和 BF16 版本;权重、数据和训练配方开放,许可证为 OpenMDW-1.1,可商用。模型卡跑分中,4GB 量化版 MultiChallenge 55.60(Gemma4 E4B-it 同量化 39.36、Qwen3.5 4B 52.23),但 Tau2-Bench 52.32、BFCL-v3 67.31 低于 Qwen3.5 4B。

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

核心要点速览

  • NVIDIA 官方发布 Nemotron 3.5 Bolt E4B 4GB,面向本地助手、互动角色和机器人
  • 基于 Gemma-4-E4B-it 后训练,总参数 8B(有效 4B),Q4_K_M 量化,64K 上下文,可开关思考模式
  • 权重、数据、训练配方开放,OpenMDW-1.1 许可可商用,附 DFlash 推测解码草稿模型
  • 模型卡跑分:MultiChallenge 55.60 领先同级,但 Tau2-Bench 和 BFCL-v3 不及 Qwen3.5 4B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Bolt E4B⚡ Gemma 4 E4B🌐 NVIDIA🌐 Google

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

在 GTC Berlin 开幕主题演讲中,NVIDIA 官方集中发布了横跨多个专业垂直领域的全新开源模型矩阵。核心亮点包括:支持长文本视觉推理的 Nemotron 3.5 Super VL 与即开即用的 Bolt 系列语言模型;专为高精度 RAG 打造的 Nemotron Retriever 嵌入、重排与文档解析全套套件;面向实体工业的 Cosmos 物理世界模型;面向自动驾驶的 Alpamayo 2 Edge;以及与华盛顿大学 Baker 实验室联合开发的蛋白质生成大模型 BioNeMo RFD4-Proteina。官方实测显示,RFD4-Proteina 在 10 项以上蛋白质设计基准中斩获全球第一,在 200 个氨基酸的靶点设计上比 RFdiffusion3 提速惊人的 13 倍。

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

核心要点速览

  • NVIDIA 在 GTC Berlin 集中开源全栈垂直基础模型:包含 Nemotron 3.5 Super VL、Bolt 4GB 端侧版与 Cosmos 物理世界模型
  • 发布 Nemotron Retriever 全套套件,将企业级 RAG 检索、跨模态重排与复杂 PDF 版面解析的准确率推至行业前列
  • 与顶尖 Baker 实验室联合开源 BioNeMo RFD4-Proteina,在 10 余项蛋白质靶向结合任务中登顶全球性能榜首
  • RFD4-Proteina 生成 200 氨基酸蛋白质结构的设计速度比前代标杆 RFdiffusion3 提速整整 13 倍,大幅缩短原研药发现周期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Super VL⚡ Nemotron 3.5 Bolt⚡ BioNeMo RFD4-Proteina⚡ Cosmos🌐 NVIDIA🌐 Baker Lab

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

欧洲前沿 AI 巨头 Mistral AI 与 NVIDIA 在 GTC Berlin 宣布达成工业工程 AI 深度战略合作,全面加速物理 AI、计算机辅助工程(CAE)与芯片设计(EDA)的智能化变革。合作将 Mistral 旗舰模型与 NVIDIA CUDA-X、Warp 物理引擎以及 Omniverse 实时数字孪生进行全链路打通。官方博客同时公布了备受瞩目的下一代旗舰模型 Mistral Large 4 的核心技术参数:总参数量接近 1 万亿(1T),激活参数为 490 亿(49B MoE),在 3800 张 Grace Blackwell GPU 集群上训练完成,模型权重定于 10 月底正式开源发布,并将联合 Nemotron 联盟共建工业基座。

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

核心要点速览

  • Mistral AI 与 NVIDIA 官宣战略合作,将大模型能力全面注入计算机辅助工程(CAE)、物理仿真与半导体芯片设计(EDA)
  • 深度融合 NVIDIA Warp、CUDA-X 物理加速库与 Omniverse 数字孪生平台,构建工程仿真领域的开源智能体评测与基准
  • 首次正式公开 Mistral Large 4 核心规格:约 1 万亿总参、49B 稀疏激活 MoE 架构,在 3800 张 Grace Blackwell 算力集群完成预训练
  • Mistral Large 4 官方权重定于 2026 年 10 月底全量开源发布,并宣布双方加入 Nemotron 联盟向 2030 年 1 GW 绿色算力推进
阅读全文
关联模型 / 智能体 / 厂商:
N
NVIDIA (Hugging Face model card)@AICoder·
👀227
🔥88

NVIDIA 低调开源 Dory1.0-4B 循环模型:同一权重可调推理深度,SWE-bench Verified 官方报 61.8

NVIDIA 于 10 月 16 日在 Hugging Face 上架 Nemotron-Labs Dory1.0-4B:20 层共享循环块可在推理时跑 1/2/4 轮,一份权重换不同算力档位;官方口径 4 轮 SWE-bench Verified 61.8,接近 Qwen3.5-9B。提供 BF16/MXFP8/NVFP4/GGUF,OpenMDW-1.1 许可。

NVIDIA 低调开源 Dory1.0-4B 循环模型:同一权重可调推理深度,SWE-bench Verified 官方报 61.8

核心要点速览

  • 结构:36 层 = 8 输入 + 20 共享循环 + 8 输出,循环 1/2/4 轮可在推理时切换,默认 2 轮(模型卡)
  • 官方口径 SWE-bench Verified:1 轮 50.3 / 2 轮 59.5 / 4 轮 61.8;同表 Qwen3.5-9B 为 61
  • Terminal-Bench 2.1 四轮 22.2,仍明显落后 Qwen3.6-35B-A3B 的 43,小模型短板依旧
  • DGX Spark 上 NVFP4 版 较 BF16 提速约 2.17–2.44 倍;last-loop KV 缓存让显存不随循环数增长
  • vLLM(PR #60149)与 llama.cpp(PR #30306)支持尚未合入正式版,需从 PR 构建
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dory1.0-4B⚡ Nemotron🌐 NVIDIA

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

NVIDIA 于 2026-10-15 发布开源多模态智能体模型 Nemotron 3.5 Super VL:120B 总参、每 token 激活 12B,Mamba-2/Transformer 混合 MoE + C-RADIO 视觉编码器,支持文本、图像、文档与视频输入,最长 1M 上下文,自带 MTP 与 LiLiCorr 投机解码。权重、数据集与训练配方以 OpenMDW-1.1 开放,已上 Hugging Face、OpenRouter、ModelScope 与 NIM。同日放出面向 RTX/DGX Spark 的 Bolt 74B-A9B 24GB(原生 2-bit 量化感知训练),4GB 的 Bolt E4B 将于 10 月 23 日跟进。

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

核心要点速览

  • 规模:Super VL 120B 总参 / 12B 激活,最长 1M 上下文;BF16 参考部署需 4×H100 或 2×GB200,另有 NVFP4 版(模型卡)
  • 编码与终端(官方口径):SWE-bench Verified 71.10、Terminal-Bench 2.1 66.70、LiveCodeBench v6 88.22;同表 Qwen3.5-122B-A10B 分别为 71.9 / 48.70 / 76.7,GLM-5.3-Flash 为 79.10 / 82.70 / 80.6
  • 智能体评测:Hermes Bench 63.44%(Nemotron 3 Ultra 56.33%),LangChain Evals 87.05%(Ultra 84.3%);NVIDIA 称单卡吞吐最高达同级开源模型 5 倍、Baseten 端点 600+ TPS(技术博客)
  • 本地版 Bolt 74B-A9B 24GB:原生 2-bit(IQ2+QAT)、256K 上下文,Terminal-Bench 2.1 50.98、BrowseComp 66.75,对照 Qwen3.6-35B-A3B 为 44.38 / 48.74;PinchBench 87.82 略低于 Qwen3.6 的 88.07(Bolt 模型卡)
  • 推理工程:LiLiCorr 投机解码在 DGX Spark 上最高提速 2.3 倍;Dynamo 方案在 16×B200、50 tok/s/用户下服务人数提升 8 倍、首 token 延迟降 85%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ nemotron-3.5-super-vl⚡ nemotron-3.5-bolt-74b-a9b⚡ nemotron-3.5-bolt-e4b⚡ Nemotron 3 Ultra🤖 hermes-agent🤖 opencode🤖 OpenHands (All-Hands AI)🤖 Cline (VS Code Agent)🌐 Nvidia (NIM)