AI 编程实时动态与要闻

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

新加坡时间 11 月 13 日 02:02,Google DeepMind、Google AI 和 Gemini 官方账号同时宣布 Gemini 4 Hydrogen 正式上线,Gemini API 更新日志标注为 GA,模型 ID 是 gemini-4-hydrogen。按官方口径,它在默认 high 思考档位下的 Artificial Analysis 智能指数为 51,高于 Gemini 4 Argon 的 50,新增的 xhigh 档位可到 54;完成任务的速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 得分从 18.2% 提高到 57%。价格在 100 万 token 上下文内统一为输入 1.5 美元、输出 7.5 美元(每百万 token),免费层也能用。它同时成为 Gemini 应用、Google 搜索和 Antigravity 托管智能体的默认模型。昨天站内报道过的 SKU 价目表泄露,今天由官方证实。Cursor 官方随后宣布 Hydrogen 已上线编辑器,默认努力档(high)在 CursorBench 4.0 上为 54.3%,高于 Gemini 3.8 Flash 的 39.6%。

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

核心要点速览

  • 官方口径:AA 智能指数 51(默认 high 档),高于 Gemini 4 Argon 的 50;新增 xhigh 档可达 54
  • 速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 从 18.2% 升到 57%,捏造陈述减少 5 倍以上
  • 定价:每百万 token 输入 1.5 美元、输出 7.5 美元,100 万 token 上下文内不分段加价,免费层可用
  • Antigravity 新功能 Orchestrator 在 Carbon 和 Hydrogen 之间自动切换:Terminal-Bench 4.0 成功率接近纯 Carbon,额度少用 24%,速度快 19%
  • 合作方实测:复杂图、SQL 和数据类企业任务比 3.8 Flash 快 2–2.8 倍,token 用量少 12%–23%
  • Cursor:官方宣布 Hydrogen 已上线编辑器;CursorBench 4.0 默认 High 54.3%(每任务约 5.59 美元),高于 Gemini 3.8 Flash 的 39.6%;Medium 46.7%(约 1.76 美元),Low 27.9%(约 0.28 美元);属第三方模型,不计入套餐包含用量(Cursor 文档、CursorBench)
阅读全文

Artificial Analysis 网络安全指数:腾讯 Hy4 得 58 分排第 3,在 CWE-Bench-AA 漏洞修复测试中以 76% 登顶,每题成本 0.92 美元

独立评测机构 Artificial Analysis 11 月 13 日公布腾讯混元 Hy4 在其网络安全指数(Cyber Index)上的结果:综合 58 分,排第 3,比 DeepSeek V4.1 Flash 1017(max)高 1 分,落后于 Kimi K3.1 Pro(64)和仅限受信任访问的 GPT-6 Sol(Daybreak Blue,max,69)。在三项子测之一的 CWE-Bench-AA 上,Hy4 以 76% 的单次通过率排第 1,领先第 2 名 DeepSeek 6 到 7 个百分点。每道题平均成本 0.92 美元,平均输出 6.4 万 token,处在能力与成本的帕累托前沿上。

Artificial Analysis 网络安全指数:腾讯 Hy4 得 58 分排第 3,在 CWE-Bench-AA 漏洞修复测试中以 76% 登顶,每题成本 0.92 美元

核心要点速览

  • 综合排名:Cyber Index 58 分排第 3,前两名为 GPT-6 Sol(Daybreak Blue,max,仅受信任访问)69 分、Kimi K3.1 Pro 64 分;DeepSeek V4.1 Flash 1017(max)57 分紧随其后
  • 单项第一:CWE-Bench-AA 单次通过率 76%,DeepSeek V4.1 Flash 1017(max)69%、Grok 4.7(xhigh)68%
  • 性价比:每题 0.92 美元,比 Grok 4.7(xhigh)高 2 分而成本约为其 1/11;比 DeepSeek 高 1 分,成本约为其 2 倍
  • 输出更省:每题约 6.4 万输出 token,比 DeepSeek 少 43%、比 Grok 4.7 少 37%,但比 Kimi K3.1 Pro 多 49%
  • 评测口径:AA 按 0.834/2.501 美元每百万输入/输出 token 计价;OpenRouter 目前把 tencent/hy4 标为 0.417/1.25 美元,实际成本可能更低
阅读全文

Lightning Labs 开源 pi402:编码 Agent 用比特币闪电网络按 token 自付推理费,无需账号、API Key 和信用卡

Lightning Labs 11 月 12 日发布 pi402:一个给 Pi 编码 Agent 用的扩展,内置 Wavelength 闪电钱包,Agent 调用付费推理接口时自动按 L402 或 MPP 协议付款,付款凭证本身就是 API Key,不用注册账号,也不用信用卡。卖方在现有推理 API 前面挂上 Aperture v0.6.0,再用 meterd 或 lightmeter 按 token 计价即可开卖。整套代码开源(MIT)。官方举例:每个输入 token 1 毫聪、输出 2 毫聪,按约 8.05 万美元的比特币价格,约合每百万 token 0.80/1.61 美元。

Lightning Labs 开源 pi402:编码 Agent 用比特币闪电网络按 token 自付推理费,无需账号、API Key 和信用卡

核心要点速览

  • 开箱即用:买方执行 pi install npm:@lightninglabs/pi-402,用 /fund 生成闪电发票充值,或用 /deposit 走链上充值
  • 双协议:Aperture v0.6.0(11 月 5 日发布)同时支持 L402 和 Stripe 与 Tempo 推出的 MPP(IETF 草案 draft-httpauth-payment-00)
  • 按 token 计费:官方示例每输入 token 1 毫聪、每输出 token 2 毫聪,约合每百万 token 0.80/1.61 美元(按比特币约 8.05 万美元)
  • 预算可控:扩展可设单次请求上限和每日预算,界面底栏实时显示钱包余额和每笔付款
  • 全部开源:pi-402 扩展、Aperture、lightmeter 参考实现均开源,pi-402 为 MIT 许可;演示用它付费调用 Kimi K3.1 Pro
阅读全文

DeepSeek 把 App 全套能力开放到 API:deepseek-flash 内置联网搜索、深度思考搜索、文件解析、读链接和安全审核,另推 OCR/ASR/TTS 独立接口与 MIT 开源聊天前端

11 月 13 日,DeepSeek 官方宣布把 DeepSeek App 背后的能力全部开放到 API:V4.1-Flash(模型名 deepseek-flash)在 Messages、Responses、Chat Completions 三种协议下都支持服务端执行的联网搜索(含图片搜索和引用)、深度思考搜索、PDF/Office/图片文件解析、自动读取消息中的链接,以及输入输出安全审核。OCR、语音识别(ASR)、语音合成(TTS)也作为独立接口上线。工具调用在 Token 费之外另计:搜索和抓取 0.75 美元/千次,OCR 0.225 美元/千页,ASR 限时 0.058 美元/小时,TTS 限时 0.225 美元/万字符。官方同时开源了可导入 DeepSeek 聊天记录的前端 Demo(MIT)。面向公众的应用必须开启安全审核。

DeepSeek 把 App 全套能力开放到 API:deepseek-flash 内置联网搜索、深度思考搜索、文件解析、读链接和安全审核,另推 OCR/ASR/TTS 独立接口与 MIT 开源聊天前端

核心要点速览

  • 三种协议都支持:Messages(/anthropic/v1/messages)、Responses(/responses)、Chat Completions(/chat/completions),模型统一用 deepseek-flash
  • 开启方式:工具 deepseek_web_search 和 deepseek_read_url,参数 safety_check 和 title;工具调用和上下文拼装都在服务端完成
  • 工具价格(官方口径,另加 Token 费):搜索/抓取 0.75 美元/千次,OCR 0.225 美元/千页,ASR 0.058 美元/小时、TTS 0.225 美元/万字符(均为限时 5 折)
  • 开源 Demo deepseek-ai/chat-demo:TypeScript、MIT 许可,支持导入 DeepSeek 聊天记录,API 密钥只存在浏览器本地
  • 首帖 2 小时内约 11.7 万浏览、2,100+ 点赞;官方未公布搜索质量或 OCR/ASR 准确率跑分
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Replit Agent 能替你的公司花钱了:经 Stripe 旗下 Link 和 Visa 代购经营所需物品,还能直接投放 Google 广告,每笔付款和广告上线都须老板先批准

Replit 11 月 12 日宣布给 Replit Agent 加两项新能力。一是「智能体代购」:Agent 结合对你业务的了解在商家网站比价、填购物车、准备结账,最后由你在 Link 钱包里批准总价才扣款,目前限美国的 Core 和 Pro 用户、仅限一次性购买。二是「智能体广告」:Agent 读取你的网站或应用,写广告文案、生成图片、建议日预算,经你审核后在 Google 的 Performance Max 活动里投放,Pro 用户全球可用。官方文档称,新建广告账户的日均预算至少 15 美元,广告费从 Replit 额度里扣。

Replit Agent 能替你的公司花钱了:经 Stripe 旗下 Link 和 Visa 代购经营所需物品,还能直接投放 Google 广告,每笔付款和广告上线都须老板先批准

核心要点速览

  • 两项新能力:Link(Stripe 旗下)+ Visa 支付的代购,以及 Google Ads 广告投放,均在 Replit 聊天里完成
  • 代购限制:仅 Core 和 Pro 用户、先在美国开放、只支持一次性购买;文档另说明可买初始价与续费价相同的固定价订阅
  • 安全设计:商家网站在 Browserbase 隔离浏览器里操作,Agent 停在结账页等批准;付款期间关闭 shell 和普通浏览,审批检查写在代码里而非交给模型
  • 广告门槛:Pro 套餐、个人工作区、开启自动充值;仅支持 Performance Max,新建账户一次只能跑 1 个活动,日均预算至少 15 美元且不是硬上限
  • 官方口径数字:5 月以来把 Replit 应用接入 Stripe 收款的创业者增至 9 倍;案例用户 30 天收入 17 万美元、广告回报约 4 倍(官方案例,未经独立核实)
阅读全文

ChatGPT dots 支持自定义指令:可在线程里规定语气和哪些操作须先经你同意,回复更快、术语更少、执行更到位

ChatGPT 官方账号 11 月 12 日(新加坡时间 13 日 04:04)宣布更新常驻智能体 dots:回复更快、术语更少、任务执行更到位,并开始遵循自定义指令。用户可以直接在线程里告诉 dot 怎么说话、哪些操作要先经过同意,例如「发邮件前先给我看草稿」;也能在手机端 Customize > Behavior 或网页、桌面端的 dot 菜单里设置。官方文档说明,dot 的指令与 ChatGPT 本身的自定义指令分开保存,另有四档「自定义规则」控制具体操作是否放行。官方未公布提速幅度等量化数据。

ChatGPT dots 支持自定义指令:可在线程里规定语气和哪些操作须先经你同意,回复更快、术语更少、执行更到位

核心要点速览

  • 三项体验改进:官方称回复更快、术语更少、执行更到位,但未公布任何提速或成功率数字
  • 自定义指令:可在线程里口头设定,也可在手机端 Customize > Behavior 或网页/桌面端 dot 菜单中编辑,且与 ChatGPT 自身的自定义指令分开
  • 4 档自定义规则:直接执行、你明确要求才执行、执行前先询问、交给你来做,可按单个操作设置
  • 官方示例:「always talk in lowercase」与「发任何邮件前先给我看草稿」;文档提醒「让它起草回复」不等于允许它发送
  • 可用范围:官方帮助文档称 dots 面向 18 岁以上 Pro 用户(不含欧洲经济区、瑞士和英国)及 Business Premium;企业工作区 11 月 18 日起默认开启
阅读全文
关联模型 / 智能体 / 厂商:

Fish Audio 推出无代码语音智能体平台 Fish Agent:一句话描述即可生成能打接电话的 AI 助手,官方称部署中位时间 32 秒,支持自带 LLM 和完整 API

Fish Audio 11 月 12 日(新加坡时间 13 日 01:00)发布 Fish Agent,一个无代码的语音智能体平台:用文字描述想要的助手即可生成,官方称部署时间中位数 32 秒。智能体可以租用或接入自有电话号码打接电话,可选平台大模型或接入自己的 OpenAI 兼容端点,并通过 Webhook、知识库和 REST API 扩展,对话由此前发布的全双工模型 Live 3 驱动。官方文档标注平台处于公开测试阶段。定价为每分钟 0.035 美元(原价 0.07 美元,优惠到 12 月 31 日),电话通话每分钟另加 0.01 美元,号码每月 1.20 美元,新用户送 5 美元额度。

Fish Audio 推出无代码语音智能体平台 Fish Agent:一句话描述即可生成能打接电话的 AI 助手,官方称部署中位时间 32 秒,支持自带 LLM 和完整 API

核心要点速览

  • 无代码生成:用文字描述即可生成语音智能体,官方称部署中位时间 32 秒(厂商口径)
  • 电话能力:可租用号码或自带运营商(BYO SIP)打接电话;托管号码目前只有美国和加拿大本地号,支持热转接和冷转接给人工
  • 可换大脑:默认用平台模型,也可接入自己的 OpenAI 兼容 chat completions 端点,语音识别、合成和打断处理仍由 Fish Audio 负责
  • 定价:每分钟 0.035 美元(原价 0.07 美元,优惠至 2026 年 12 月 31 日),通话每分钟另加 0.01 美元,号码每月 1.20 美元,新用户送 5 美元额度且无需绑卡
  • 测试与监控:支持单轮、多轮和工具调用测试,版本发布与回滚,通话录音、转写和通话后自动分析;平台仍为公开测试版
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Fish Audio Live 3🤖 Fish Agent🌐 Fish Audio

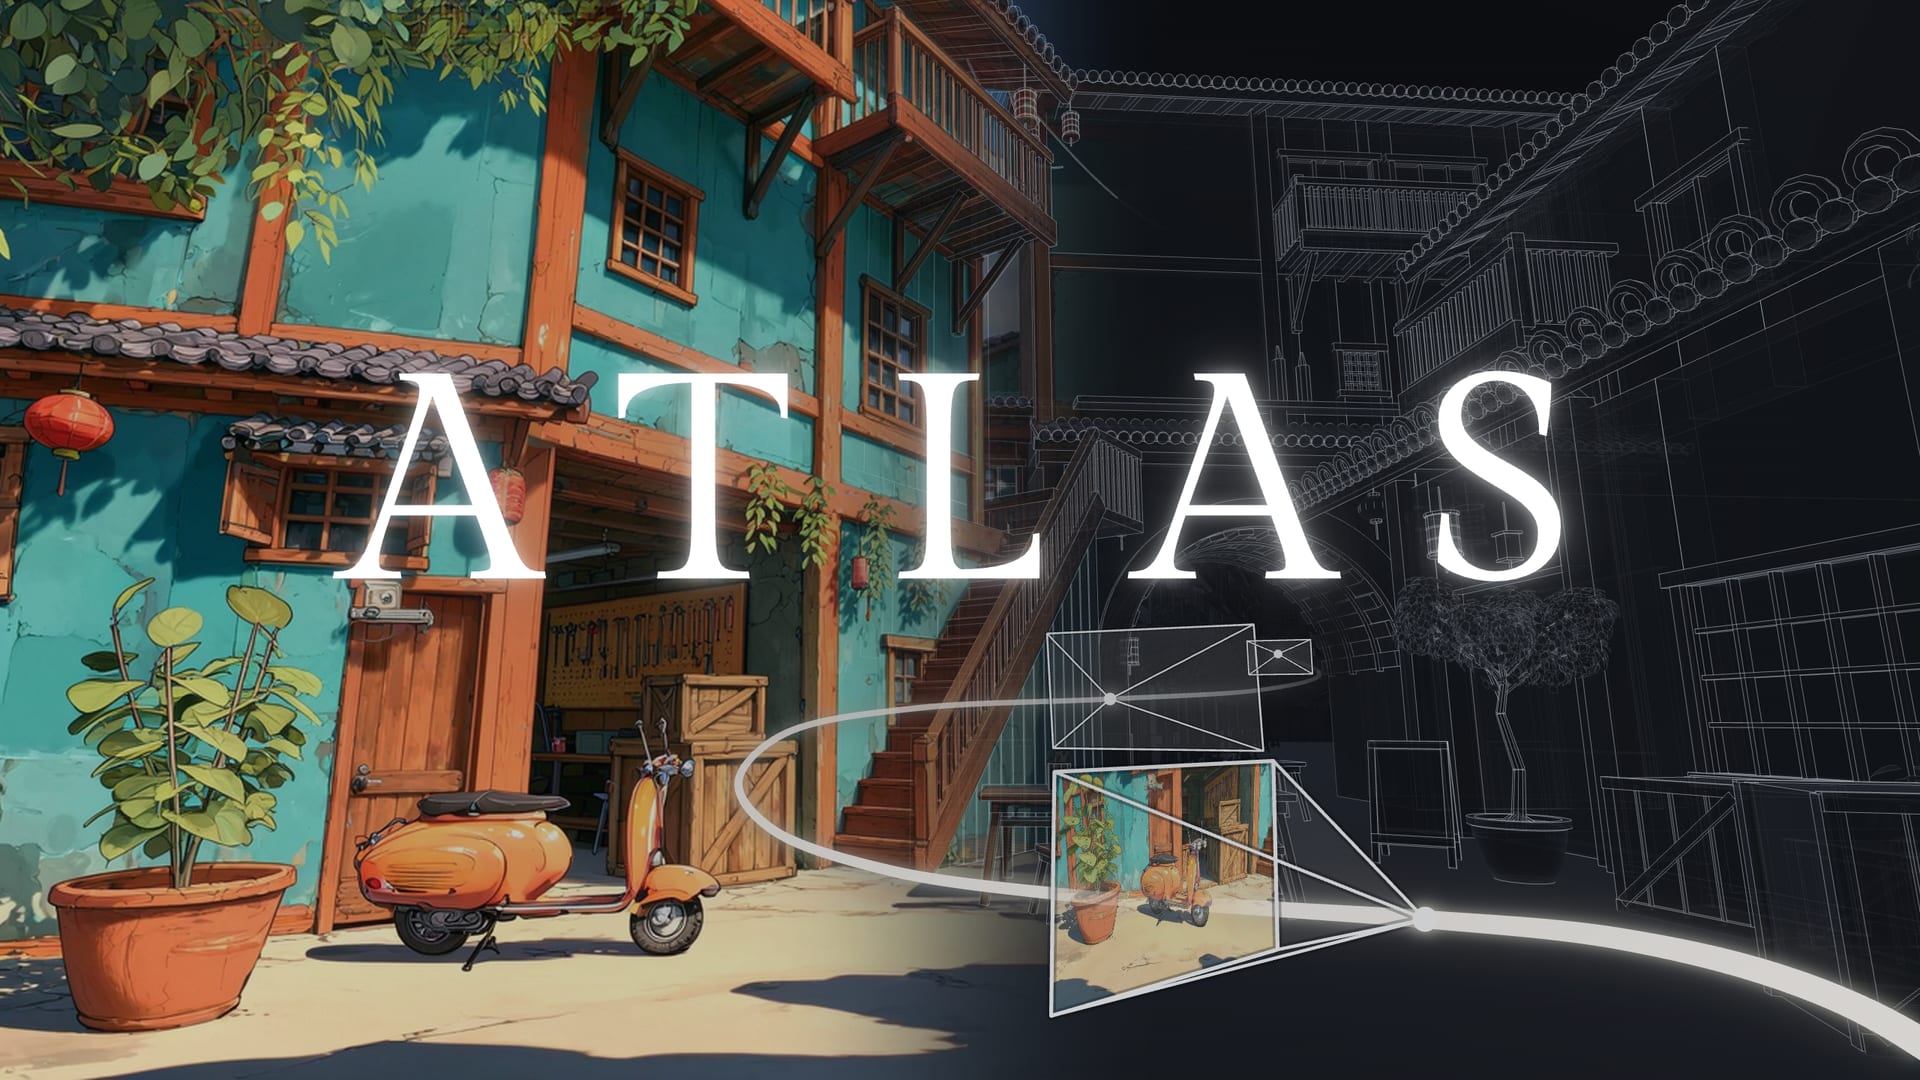
World Labs 向所有人开放世界模型 Atlas:上线 Viewfinder、Chisel 两款网页应用和开发者 API,照片可重建成能漫游的 3D 世界,并导出 3D 高斯泼溅或网格进 Blender

李飞飞创办的 World Labs 于 11 月 12 日把世界模型 Atlas 开放给所有注册用户。Atlas 9 月发布时只给少数合作伙伴试用,11 月 5 日推出的 Frameboy 也只能逛预设场景。这次上线四个工具:Viewfinder 用照片或生成图重建场景,Chisel 先摆白模再生成,Splats to Mesh 把高斯泼溅转成网格,Relight 调整光照。同时开放驱动这些应用的全部 API 端点,可接入 Blender。模型闭源、只能托管调用,官方未公布价格。

World Labs 向所有人开放世界模型 Atlas:上线 Viewfinder、Chisel 两款网页应用和开发者 API,照片可重建成能漫游的 3D 世界,并导出 3D 高斯泼溅或网格进 Blender

核心要点速览

  • 开放范围:11 月 12 日起任何人在 atlas.worldlabs.ai 注册即可使用,Viewfinder 此前是要排队的封闭测试
  • 四个工具:Viewfinder 从照片重建场景并渲染相机路径;Chisel 用白模控制场景结构;Splats to Mesh 把高斯泼溅转成带几何的网格;Relight 调整泼溅场景光照
  • 开发者 API:开放驱动这些应用的全部 API 端点,可输出关键帧、视频片段和 3D 高斯泼溅,官方列出 Blender 集成
  • 定位场景:官方主推影视特效、建筑设计和机器人仿真三类用途
  • 限制:模型闭源、只能托管调用,没有开放权重;官方未公布 Atlas 单价、配额和速率限制
阅读全文
关联模型 / 智能体 / 厂商:

Expo 推出 Expo Simulators:给 Claude Code、Codex、Cursor 等编程智能体按需开云端 iOS 模拟器和安卓模拟器,自动录屏留证据,每分钟 0.1 美元

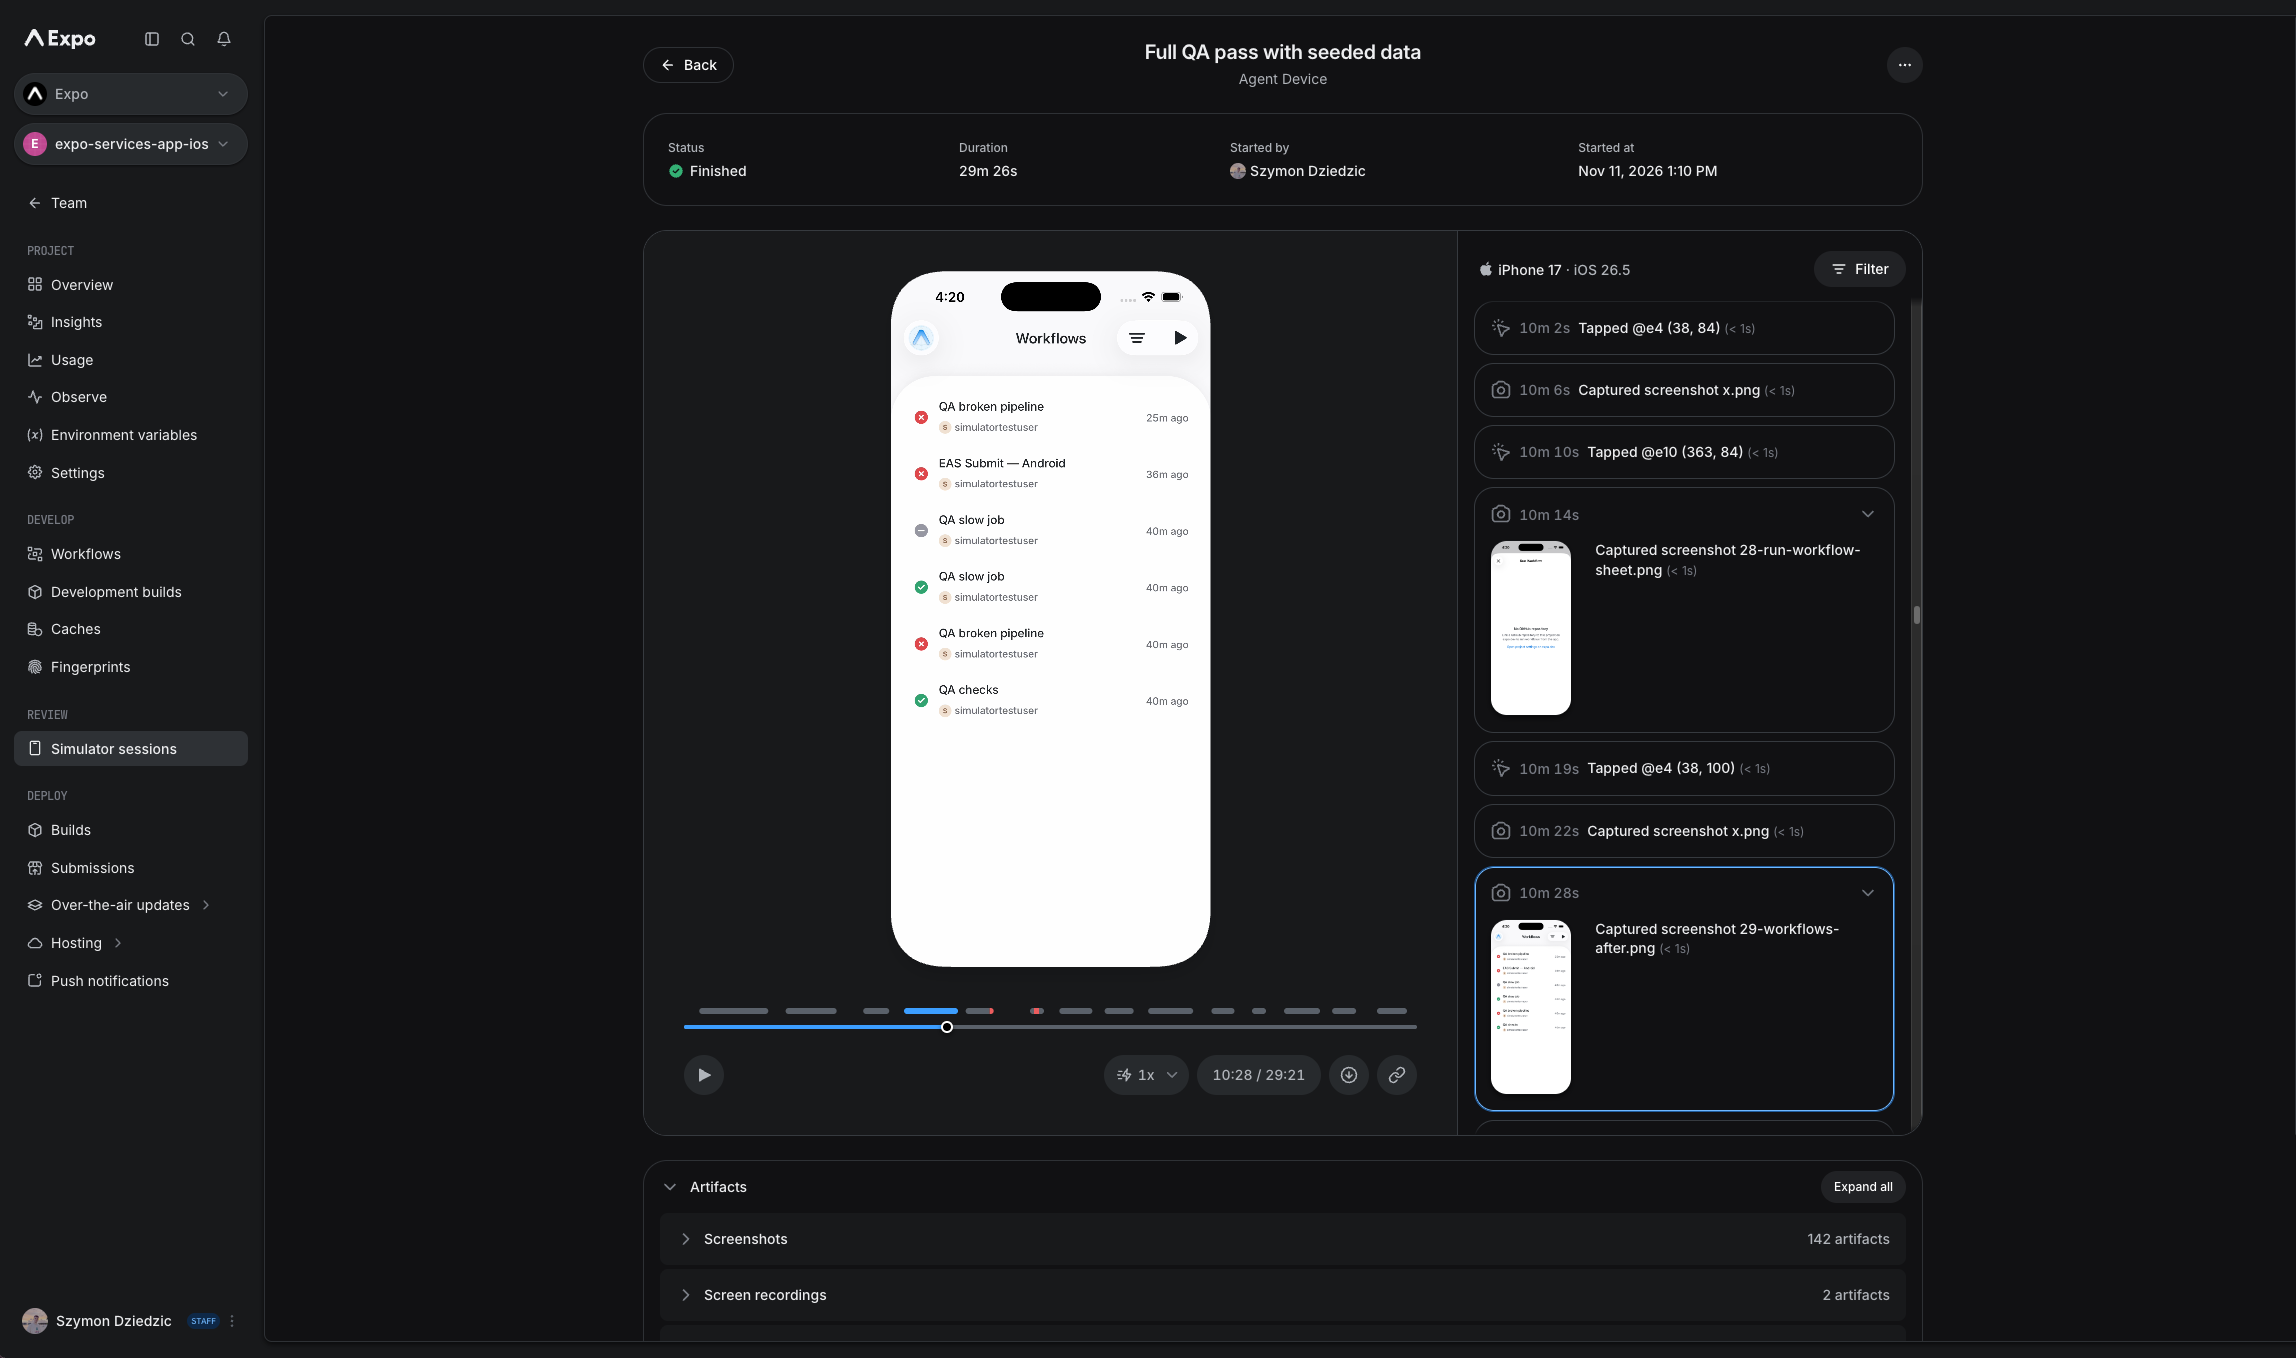
移动开发框架 Expo 于 11 月 12 日正式推出 Expo Simulators,所有付费套餐可用。编程智能体用一条命令就能开一台云端 iOS 模拟器或安卓模拟器,装上构建包自己点测,结束后留下完整录屏、截图、日志和网络记录,可附到 PR 上给人审。每个会话独占一台虚拟机,不用 Mac,Linux 和 Windows(WSL)都能跑 iOS 模拟器。按分钟计费,iOS 和安卓都是每分钟 0.1 美元,Starter 及以上套餐每月含 60 分钟。

Expo 推出 Expo Simulators:给 Claude Code、Codex、Cursor 等编程智能体按需开云端 iOS 模拟器和安卓模拟器,自动录屏留证据,每分钟 0.1 美元

核心要点速览

  • 一条命令开机:npx eas-cli@latest simulator --platform ios 即可启动云端会话,也可从 CI、REST API、Expo Workflows 或 GitHub Actions 启动
  • 兼容现有智能体:Claude Code、Codex、Cursor 等能跑命令行的智能体都能用,沿用 agent-device、Argent 或 Appium 命令;官方提供 eas-simulator 技能
  • 留证据:每个会话保留完整录屏、截图、日志、网络流量和 CPU 内存数据,可附到 PR,审阅者不用拉分支本地构建
  • 隔离与自动关机:每个会话独占一台虚拟机,最长 2 小时,可设更短上限和空闲超时,避免忘关计费
  • 价格:iOS 和安卓都按每分钟 0.1 美元计费,Starter、Production、Enterprise 套餐 2027 年前每月含 60 分钟;Expo 本身不提供 AI 模型
阅读全文
关联模型 / 智能体 / 厂商:

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

11 月 12 日,开源推理引擎 SGLang 背后的非营利组织 LMSYS Org 在旧金山首届 SGLang 峰会开幕主题演讲上宣布成立 SGLang 联盟。创始成员包括NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal 和 RadixArk,它们将与 SGLang 维护者一起参与路线图制定,重点方向是前沿模型支持、推理与多模态负载、分布式推理和跨硬件优化。每家成员指派一名技术代表,每年参加两次路线图会议;技术决策和代码合入权仍归 SGLang 维护者,项目继续对整个社区开放。

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

核心要点速览

  • 创始成员 8 家:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk(SGLang 核心作者创办的公司),覆盖 GPU/CPU 芯片、云和推理服务商
  • 治理方式:每家指派一名技术代表,每年两次路线图会议,期间可组建工作组并公开进展;技术决策与代码合入仍由 SGLang 维护者负责
  • 四个重点方向:前沿模型支持、推理与多模态负载、分布式推理、跨硬件平台优化
  • 规模(官方口径):SGLang 跑在数十万张 GPU 上,用户包括 Meta、微软、Google、亚马逊、Thinking Machines Lab、Cloudflare、Reflection、Modal
  • 背景:LMSYS 引用德勤数据称,2026 年推理约占全部 AI 算力的三分之二,2025 年约为一半;首届峰会 11 月 12–13 日在旧金山 Fort Mason 举行,100 多位演讲者
阅读全文
AD赞助内容

Cognition 推出 Devin Apps:让 Devin 直接在自己的云端机器上搭建并托管内部工具,私有可分享、地址固定,按机器唤醒时长计费

11 月 13 日,Cognition 发布 Devin Apps:用户描述需要的工具,Devin 在会话里把它做成网页应用,并直接从自己的云端机器上提供服务,不部署到第三方托管平台。每个 App 有固定地址(name--id.preview.devinapps.com),访问者必须登录 Devin,永不公开,可按个人、组织或企业分享。App 能用任何技术栈,复用已接入的 MCP、集成和代码库,数据(如 SQLite、Postgres)留在同一台机器上。机器无人访问 5 分钟后休眠,有人打开时唤醒,按唤醒时长计费,搭建和修改按普通会话计费。每次更新都是带 commit 的新版本,新版启动失败时旧版继续服务。功能正在逐步开放。

Cognition 推出 Devin Apps:让 Devin 直接在自己的云端机器上搭建并托管内部工具,私有可分享、地址固定,按机器唤醒时长计费

核心要点速览

  • 托管位置:App 运行在 Devin 自己的云端机器上,不部署到第三方平台,数据和上传文件都留在这台机器
  • 地址固定:形如 name--id.preview.devinapps.com,改名、更新都不变;访问者必须登录 Devin,永不公开
  • 计费:无人访问 5 分钟后休眠、按唤醒时长计费,休眠首次打开需几秒;搭建和修改按普通会话计费
  • 版本管理:每次部署前先 git commit,新版本启动失败时旧版本继续服务,可让会话回滚到任一旧版
  • 适用场景:内部工具、仪表盘、预发布环境、演示原型;功能逐步开放,官方未公布具体单价
阅读全文
关联模型 / 智能体 / 厂商:

Cognition 升级 Devin Teams 套餐:Devin Desktop 不再按席位收费,每人送 2 个并发 SWE-2 免费会话,新增 SSO、按人分档用量上限和标准 BAA,席位上限降到 100

11 月 12 日,Cognition 宣布升级 Devin Teams 套餐:团队所有人都能用新版 Devin Desktop,不再为席位额外付费;新增 Free 模式,每位用户有 2 个由自研模型 SWE-2 驱动的并发免费会话,Desktop 和 CLI 里的免费 SWE-2 也成为 Teams、Pro、Max 套餐的长期权益。管理员可接入 Okta、Entra ID 等 SAML/OIDC 单点登录,按人或按组设置最多 3 档用量上限,并可在设置里申请标准 BAA。同时,Teams 的配额席位 30 天后取消,席位上限从 200 降到 100。

Cognition 升级 Devin Teams 套餐:Devin Desktop 不再按席位收费,每人送 2 个并发 SWE-2 免费会话,新增 SSO、按人分档用量上限和标准 BAA,席位上限降到 100

核心要点速览

  • Desktop 免席位费:团队所有成员都能用新版 Devin Desktop,不再单独购买 Desktop 席位
  • 免费 SWE-2:Free 模式下每人 2 个并发免费会话,可付费加购;Desktop 与 CLI 的免费 SWE-2 成为 Teams、Pro、Max 的长期权益。官方称 SWE-2 接近前沿模型、成本只是零头(未给具体跑分)
  • 管理控制:SSO 支持 Okta、Microsoft Entra ID 及任意 SAML/OIDC,接入后可关闭邮箱登录;用量上限按人或按组设置,最多 3 档,超额申请可人工审批或在上限内自动批准
  • 合规:Teams 客户可在设置中申请标准 BAA(医疗数据所需),无需签企业合同
  • 变化:配额席位 30 天后取消,Teams 席位上限从 200 降到 100;初创计划最高提供 6.5 万美元额度
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

Perplexity 11 月 12 日发布 pplx-decider-v1.3(基于 Qwen3.8-27B,约 26.1B 参数)和蒸馏版 pplx-decider-flash-v1.3(基于 Qwen3.5-4B,约 4.5B),权重以 Apache 2.0 上架 Hugging Face,并通过 Decisions API 和 OpenRouter 提供。新版加入 Locate,可按标签或指令抽取原文片段并返回字符位置。官方称 v1.3 在 63 项分类任务上平均准确率 91.6%,比其生产分类器高 6.54 个百分点。

Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

核心要点速览

  • 两档开源权重:v1.3 约 26.1B 参数(Qwen3.8-27B 微调),Flash v1.3 约 4.5B(Qwen3.5-4B 蒸馏),均为 Apache 2.0;BF16 本地运行约需 49 GiB 显存
  • 新增 Locate:按标签或指令抽取原文片段,返回起止字符位置和分数,覆盖 NER、PII 检测、抽取式问答,可与分类、打分问题放在同一请求
  • 官方/厂商口径分类成绩:63 项分类任务平均准确率 91.6%,比 Perplexity 生产分类器高 6.54 个百分点;7 个领域全部领先 Jev 1.14,金融领域最多高 12.9 个百分点
  • 检索与稳定性:72 项检索任务 nDCG@10 为 83.99,比 Qwen3-Reranker-8B 高 1.81;输入改写后答案只变 0.27%,Jev 1.14 为 2.69%–4.84%
  • 上手渠道:Hugging Face 下载、Perplexity Decisions API、OpenRouter(两款 v1.3 模型 11 月 19 日前免费)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-decider-v1.3⚡ pplx-decider-flash-v1.3⚡ Qwen3.8-27B⚡ Qwen3.5-4B⚡ Jev 1.14⚡ Qwen3-Reranker-8B🌐 Perplexity🌐 Hugging Face🌐 OpenRouter

Thinking Machines 兑现承诺开源 Inkling 2 Small:594B 总参 / 17B 激活 MoE 权重上架 Hugging Face,Apache 2.0 可商用,原生 NVFP4 两张 B300 即可跑,SGLang、vLLM、Cloudflare 等首日支持

11 月 12 日(北京时间 13 日凌晨 4 点 50 分),Thinking Machines Lab 宣布 Inkling 2 Small 权重以 Apache 2.0 许可证在 Hugging Face 开放下载,兑现了 11 月 5 日发布闭源版时「完成安全测试后开源」的承诺。模型为 594B 总参、17B 激活的多模态 MoE,支持图文输入和 100 万 token 上下文;主权重是训练时就采用的原生 NVFP4,至少需要 500GB 显存(2 张 B300 或 4 张 H200),另有 MXFP8 版本。SGLang、vLLM、Unsloth 给出本地部署方案,Cloudflare Workers AI、OpenRouter、Together、Nebius 等首日上线,每百万 token 输入 0.30 美元、输出 1.00 美元。

Thinking Machines 兑现承诺开源 Inkling 2 Small:594B 总参 / 17B 激活 MoE 权重上架 Hugging Face,Apache 2.0 可商用,原生 NVFP4 两张 B300 即可跑,SGLang、vLLM、Cloudflare 等首日支持

核心要点速览

  • 许可与仓库:Hugging Face thinkingmachines/Inkling-2-Small(NVFP4 主权重)与 Inkling-2-Small-MXFP8,Apache 2.0,可商用、可微调、可集成到第三方产品
  • 规格(模型卡):48 层解码器,384 个专家每 token 路由 8 个,局部与全局注意力混合;594B 总参 / 17B 激活;图文输入、文本输出,上下文最长 100 万 token
  • 硬件门槛:NVFP4 至少 500GB 聚合显存(2×B300 或 4×H200);MXFP8 至少 800GB(4×B300 或 8×H200),官方称 MXFP8 评测只高 1–2 个百分点,推荐用 NVFP4
  • 跑分(厂商口径,模型卡):AA Index v5.0 30.6、DeepSWE v1.1 72.1%、FrontierCode v2.0 25.4%、BrowseComp 90.2%;DeepSeek-V4.1-Flash 在 AA Index(32.6)、DeepSWE(77.0%)上仍更高
  • 首日生态:SGLang、vLLM、TokenSpeed、Unsloth 本地推理,Miles、SkyRL、Snowflake Cortex 后训练;Cloudflare Workers AI 与 OpenRouter 均为输入 0.30 / 输出 1.00 美元每百万 token,OpenRouter 另有限免版本
阅读全文
关联模型 / 智能体 / 厂商:

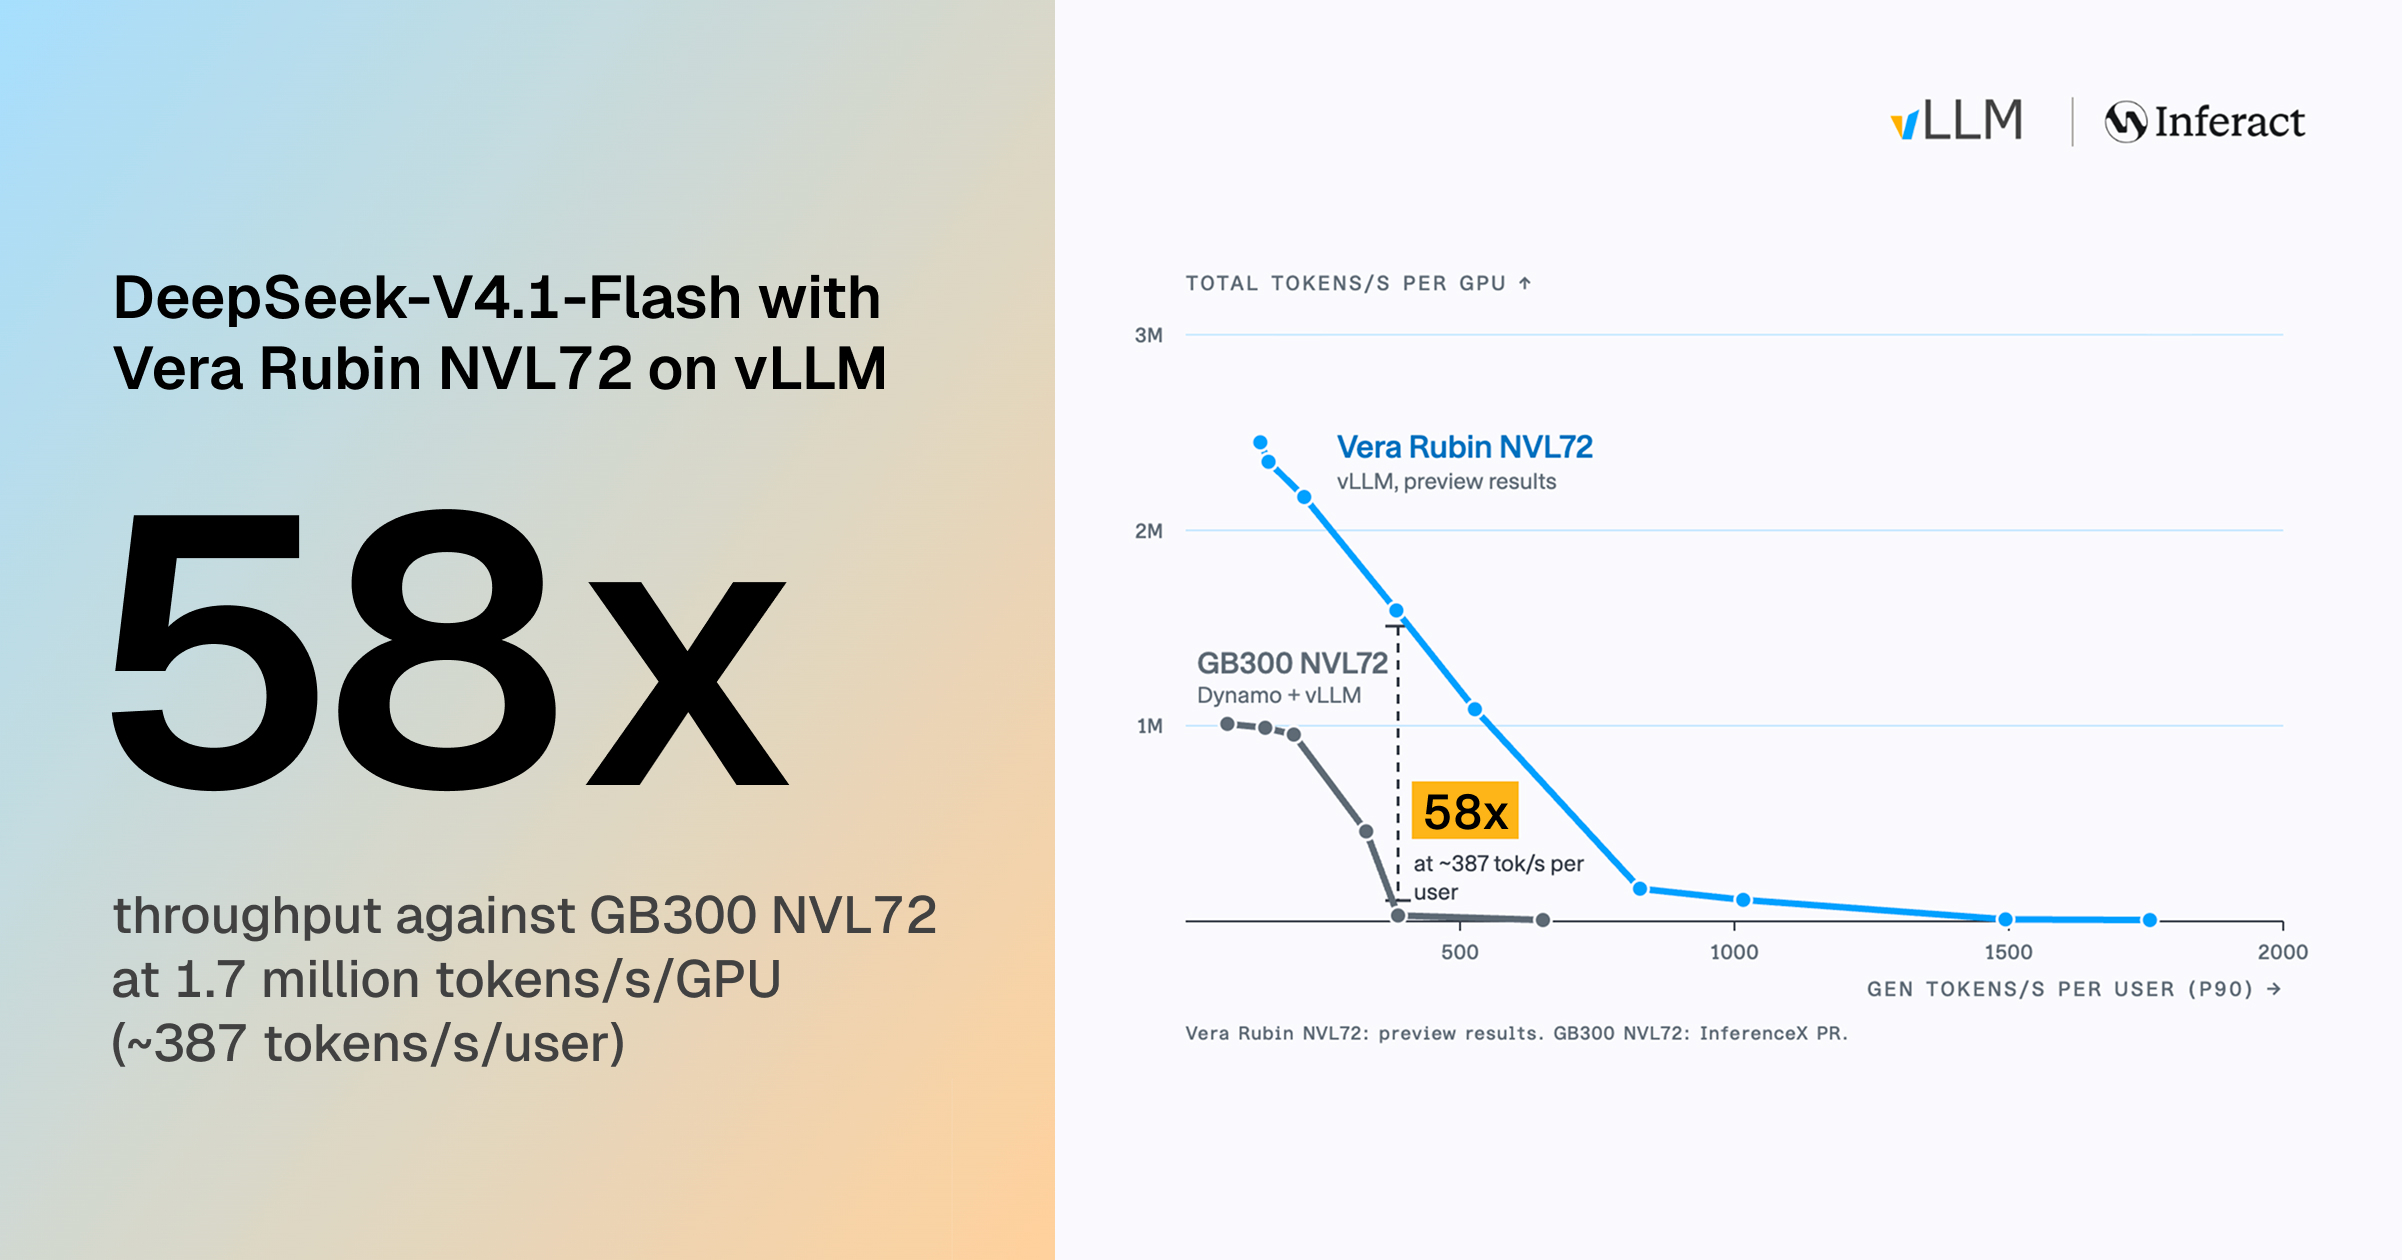
vLLM 在英伟达 Vera Rubin NVL72 上跑 DeepSeek-V4.1-Flash:每用户 387 token/s 时单卡 170 万 token/s,为 GB300 NVL72 的 58 倍;峰值吞吐则是 2.7 倍

11 月 12 日,vLLM 发布 DeepSeek-V4.1-Flash 系列第三篇博客(Inferact 主导):在一台 Vera Rubin NVL72 上,用 SemiAnalysis AgentX 负载测得每用户 P90 387 token/s 时单 GPU 总吞吐 170 万 token/s,是 GB300 NVL72 同一交互速度下的 58 倍;峰值吞吐 252 万 token/s/GPU,是 GB300 的 2.7 倍。58 倍只对应高交互速度这一点,Rubin 数据为预览结果。

vLLM 在英伟达 Vera Rubin NVL72 上跑 DeepSeek-V4.1-Flash:每用户 387 token/s 时单卡 170 万 token/s,为 GB300 NVL72 的 58 倍;峰值吞吐则是 2.7 倍

核心要点速览

  • 两个倍数要分开看(vLLM 口径):每用户 387 token/s 时 170 万 token/s/GPU,是 GB300 的 58 倍;峰值吞吐 252 万 token/s/GPU,是 GB300 的 2.7 倍
  • 单用户延迟:TP8 跨两个计算托盘的专用解码路径,并发 1 时 P90 达 1,810 token/s,P50 从 1,117 提升到 1,844 token/s
  • 内核重写:针对 Rubin 的双内存域和 SM107 新 MMA 指令,DEP2 prefill 步约快 28%,DEP decode 步约快 25%
  • 机架级内存池:Mooncake KV 池从 DRAM 扩到空闲 HBM,Engram 表分片到各 GPU HBM;并发 4,800 时请求量多 68%,TTFT P50 从 29.8 秒降到 4.2 秒
  • 数据性质:Rubin 结果为预览数据,GB300 对比来自 InferenceX PR,部分点为插值
阅读全文