AI 编程实时动态与要闻

Edge0 开放 145B 端侧模型 Edge0-145B 和 Edge0-120B 权重:每 token 激活约 10B,单张 24GB 消费级显卡可跑,厂商称 Terminal-Bench 2.1 得分 86.5 高于 Claude Opus 4.6

端侧模型公司 Edge0 于 11 月 12 日开放 Edge0-145B 和 Edge0-120B 的权重,并发布 C++ 推理引擎 edge0-infer 和 Edge0 Chat 0.2.0。145B 版基于 Qwen3.8-Flash-Next,是潜空间稀疏 MoE,每 token 激活约 10.12B 参数,原生 4 bit 训练,上下文 256K。官方称本地峰值内存 29GB,在 RTX 5090 D 24GB 上智能体解码 98.3 tok/s;Terminal-Bench 2.1 得分 86.52,Claude Opus 4.6(Max)为 78.2。所有成绩均为 Edge0 内部评测。
Edge0 开放 145B 端侧模型 Edge0-145B 和 Edge0-120B 权重:每 token 激活约 10B,单张 24GB 消费级显卡可跑,厂商称 Terminal-Bench 2.1 得分 86.5 高于 Claude Opus 4.6

核心要点速览

  • 规模与结构:Edge0-145B 总参 145B,每 token 激活约 10.12B;48 层,每层 512 个专家,10 个路由专家加 1 个共享专家;上下文 256K,原生 4 bit 训练
  • 跑分(厂商内部评测):Terminal-Bench 2.1 得分 86.52,Qwen3.8-Flash-Next 为 83.3,DeepSeek-V4-Flash-0731 为 82.7,Claude Opus 4.6(Max)为 78.2;DeepSWE 1.1 得分 64.6,GPQA-Diamond 得分 90.4
  • 本地速度(模型卡口径):RTX 5090 D 24GB 上 NVFP4 版智能体解码 98.3 tok/s,16K 输入预填充 3165.7 tok/s;RTX 4090 跑 Q3_K 版智能体解码 91.7 tok/s
  • 硬件门槛:Windows 包要求 NVIDIA RTX 20 系或更新、至少 16GiB 显存和 20GiB 内存;权重文件 NVFP4 版 47.79GiB,Q3_K 版 40.81GiB
  • 许可限制:模型用 Edge0 社区许可 1.0,同时受 Qwen 社区许可约束;个人、研究和内部使用可以,转售模型或做商业模型服务要另签授权;推理框架为 Apache-2.0
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Edge0-145B⚡ Edge0-120B⚡ Qwen3.8-Flash-Next⚡ DeepSeek-V4-Flash-0731⚡ Claude Opus 4.6🌐 Edge0🌐 Qwen🌐 Hugging Face🌐 NVIDIA
Runway 开源世界动作模型 Praxis-1:27B MoE 视频模型直接控制机器人,RoboLab-120 成功率 46.2% 居开源第一,Apache 2.0 可商用

Runway 11 月 11 日以 Apache 2.0 许可开放世界动作模型 Praxis-1 的权重、推理与微调代码(含 LoRA),可商用。它是 27B 参数的 MoE 扩散 Transformer(每 token 激活约 2.8B),同时预测未来视频和机器人动作,每次调用输出 1.6 秒动作,单张 H100 往返约 0.55 秒。官方称在 NVIDIA RoboLab-120 上成功率 46.2%,是世界动作模型和开源机器人基础模型中的第一,高于 FLUX 3 Action 42.9%、π0.5 28.0%。同一工位三项任务上,比让 GPT-6 Astra 直接驱动机械臂快 15.6 倍、单任务成本低 51 倍。权重已上 Hugging Face,并支持 LeRobot 与 vLLM-Omni。

Runway 开源世界动作模型 Praxis-1:27B MoE 视频模型直接控制机器人,RoboLab-120 成功率 46.2% 居开源第一,Apache 2.0 可商用

核心要点速览

  • 规模:总参数 27.2B,主干 26.9B、每 token 激活约 2.8B,另有 314M 动作专家;bf16 约 54.4GB,单张 80GB GPU 可跑
  • RoboLab-120(1,200 回合):46.2%,FLUX 3 Action 42.9%、Cosmos3 Nano 36.8%、π0.5 28.0%(官方口径)
  • 真机 Franka FR3 十项任务:88/100 对 FLUX 3 Action 80/100;RT-1 微调后 SimplerEnv 80.0%(原 RT-1 52.4%)
  • 对比 GPT-6 Astra 驱动同一机械臂:快 15.6 倍,单任务成本 0.04 美元对 1.87 美元(低 51 倍)
  • NVFP4 量化后权重缩到 17.5GB,RoboLab 抽样 46.5% 对 bf16 47.8%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Praxis-1⚡ FLUX 3 Action⚡ pi0.5⚡ GR00T N1.6⚡ GPT-6 Astra🌐 Runway🌐 NVIDIA

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

百度 11 月 11 日在 ERNIE 官网和 @Baidu_Inc 发布文心 5.5 Flash Preview,这是基于 11 月 5 日开源的 ERNIE 5.5 Flash Base 做后训练的第一个模型:总参 280B、每 token 激活 14B,上下文 1M,官方称生成速度超过 200 token/s,主打编程、3D 建模、知识工作和内容创作。API 已在百度智能云千帆上线,权重将于 11 月 25 日前开源,官方博客写明采用 Apache 2.0。官方跑分(厂商口径)中,它在 AutomationBench(61.9)和 SpreadsheetBench V2(36.4)上排在对比表第一,但 Terminal-Bench 4.0 只有 46.5,低于 Claude Opus 5.5 的 63.6。官方也说明这是后训练中途的检查点。

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

核心要点速览

  • 规格(官方):总参 280B、每 token 激活 14B,上下文 1M,生成速度 200+ token/s,纯文本模型
  • 厂商口径跑分:AutomationBench 61.9(Opus 5.5 为 58.0)、SpreadsheetBench V2 36.4(Opus 5.5 为 35.1),均为对比表第一
  • 短板同样明显:Terminal-Bench 4.0 46.5(Opus 5.5 63.6、GPT-6.1 Sol 56.1),DeepSWE v1.1 71.2(DeepSeek V4.1 Flash 77.0)
  • 价格:千帆每百万 token 输入忙时 2 元 / 闲时 1 元,输出 8 元 / 4 元,限时五折(每经报道);OpenRouter 标价 $0.28 / $1.13
  • 权重 11 月 25 日前开源,官方博客称 Apache 2.0;比 Base 的自定义协议宽松,以最终发布为准
阅读全文
关联模型 / 智能体 / 厂商:

月之暗面正式开放 Kimi K3.1 Pro 权重:2.8T 总参 / 104B 激活 MoE 上架 Hugging Face,MXFP4 量化约 1.56TB,自定义许可证限制大型 MaaS 商用

Kimi 官方账号 @Kimi_Moonshot 于 11 月 4 日 16:00(UTC)宣布开放 Kimi K3.1 Pro 模型权重,仓库 moonshotai/Kimi-K3.1-Pro 已公开、无需申请。模型卡显示它是 2.8T 总参、104B 激活的原生多模态 MoE,1M 上下文,权重以 MXFP4(量化感知训练)发布,仓库约 1.56TB;官方推荐 vLLM、SGLang 和 TokenSpeed 部署。许可证允许自由使用和修改,但年收入超 2000 万美元的 MaaS 业务需另签协议。

月之暗面正式开放 Kimi K3.1 Pro 权重:2.8T 总参 / 104B 激活 MoE 上架 Hugging Face,MXFP4 量化约 1.56TB,自定义许可证限制大型 MaaS 商用

核心要点速览

  • 架构:93 层(1 层稠密),69 层 KDA + 24 层 Gated DSA 注意力,896 个专家每 token 选 16 个外加 2 个共享专家,视觉编码器 MoonViT-V2(401M)。
  • 相比 K3,把全注意力的 Gated MLA 层换成了 Gated DeepSeek Sparse Attention,用于更高效的长上下文。
  • 模型卡厂商口径:Terminal-Bench 4.0 65.7(Opus 5.5 66.4)、SWE Marathon v1.1 51.7(Opus 5.5 46.3)、HLE-Full 带工具 70.0、BrowseComp 92.1;ProgramBench 31.5 明显落后 Opus 5.5 的 65.0。
  • 许可证:对外提供 MaaS 且连续 12 个月收入超 2000 万美元需与月之暗面另签协议;月活超 1 亿或月收入超 2000 万美元的产品须醒目标注「Kimi K3.1-Pro」,内部使用不受这两条限制。
阅读全文
AD赞助内容

LiberAI 发布机器人世界动作模型 Liber-0:用 220 万小时人类经验预训练,60 项零样本操作任务总成功率 36%

机器人公司 LiberAI 在官方 X 账号和技术博客发布 Liber-0,一个同时预测未来画面和动作的世界动作模型(World Action Model),用超过 220 万小时人类经验预训练,并用自研 LiberSense 手套采集的精确手部动作数据做“动作锚点”。在 GPT-6 随机提出的 60 项任务、600 次试验中,Liber-0 在没有针对这些任务采集机器人示范的情况下总成功率 36.0%,其中复杂多步任务仅 10.5%。官方未公布开源权重或 API。

LiberAI 发布机器人世界动作模型 Liber-0:用 220 万小时人类经验预训练,60 项零样本操作任务总成功率 36%

核心要点速览

  • 零样本成绩:抓取放置 63.5%、短程非抓取操作 34.0%、复杂多步任务 10.5%,总计 36.0%(60 项任务 × 10 次)
  • 对照:把 GPT-6 Astra 单独当机器人策略,同一套任务三类成功率只有 8.3%、5.0%、1.7%,平均每步推理 87.3 秒
  • 手套数据 10k 小时的效果超过 200 倍时长(2,000k 小时)的网络人类视频,说明“有精确动作标注”比单纯堆视频更关键
  • 手套数据配合 25% 机器人示范,进度分 75.6,超过用全部机器人示范的 72.8,即少用 75% 机器人数据
  • 所有数字均为 LiberAI 自报的内部评测;官方未公布开源权重、API 或商用时间
阅读全文
关联模型 / 智能体 / 厂商:

腾讯混元发布 Hy4 正式版:首次加入视觉理解与电脑操作,已上线腾讯云和 OpenRouter,权重“近期开源”

腾讯混元 11 月 4 日在官网发布 Hy4 正式版。相比 8 月的 Hy4 preview,官方称扩大了预训练和后训练规模,首次加入视觉理解,首次支持电脑操作(命令行+图形界面),并专项训练了 Blender、CAD、Unreal/Unity/Godot 等场景。Hy4 已上线腾讯云和 OpenRouter(tencent/hy4,1M 上下文),API 价格与 preview 相同;模型权重和系统卡片将在近期开源发布,更便宜的 Hy4 flash 也在路上。

核心要点速览

  • 官方博客:Introducing Hy4,发布日 2026-11-04;透明度中心同步列出 V1.0 Hy4
  • 两个“首次”:视觉理解(细粒度看图、复杂图表、数学视觉推理)和电脑操作(CLI+GUI 结合,针对 Blender、CAD 和跨应用长程任务专项训练)
  • 官方自测:579 项真实金融任务(213 位金融从业者评估)Hy4 得 3.04,开放权重模型中第一(DeepSeek-V4.1-Flash-1017 2.97、Kimi K3.1 Pro 2.68、GLM-5.3 2.68);GameDev +19.1%、GameLogic +9.8%;内部搜索评测幻觉率 15.76%→5.45%
  • API 价格与 preview 相同:每百万 token 缓存输入 $0.042、输入 $0.834、输出 $2.501;OpenRouter 页面目前标注 5 折($0.417/$1.251),1,048,576 上下文、最多 65,536 输出
  • 权重尚未公开:官方称将开源权重并发布完整系统卡片,已与 vLLM、SGLang 合作;Hy4 flash 近期发布
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

Mistral 10 月 29 日发布改进版 Mistral Large 4(Le Chonk)并开放权重,已上架 Hugging Face(另有 NVFP4 量化版),API 名为 mistral-large-4。相比 10 月初的公开预览,多做了约三周强化学习:官方口径 FrontierCode 2.0 得分 19.7%、Terminal-Bench 4.0 从 28% 升到 41%,并新增 low/medium/high 三档推理。许可证为改版 MIT,商用可用,但做模型即服务需另签商业许可。

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

核心要点速览

  • 规格:约 1T 总参数、每 token 激活 49B(含嵌入和输出层约 52B),128 个路由专家每次激活 4 个外加 1 个共享专家,1M 上下文,文本+图像输入
  • Mistral 口径:Cognition FrontierCode 2.0 得分 19.7%,高于 DeepSeek V4.1 Flash 的 19.3% 和 GLM-5.3 的 17.8%,开源模型第一
  • Artificial Analysis 编码智能体指数 48%,与 GLM-5.3 基本持平,但平均每任务少用 47% 的 token;Terminal-Bench 4.0 由预览版 28% 提升到 41%
  • Artificial Analysis Cyber Index 51%;对恶意网络安全请求的平均拒绝率 96.6%,官方称为开源模型中最高
  • 在 Mistral 自有欧洲数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练;Surge Code 盲评中仅次于 Claude Opus 5.5
阅读全文
关联模型 / 智能体 / 厂商:

上海 AI 实验室发布 Atria Dawn 正式版:基于 744B MoE GLM-5.2 的智能体模型,上下文翻倍至 512K,MIT 开源

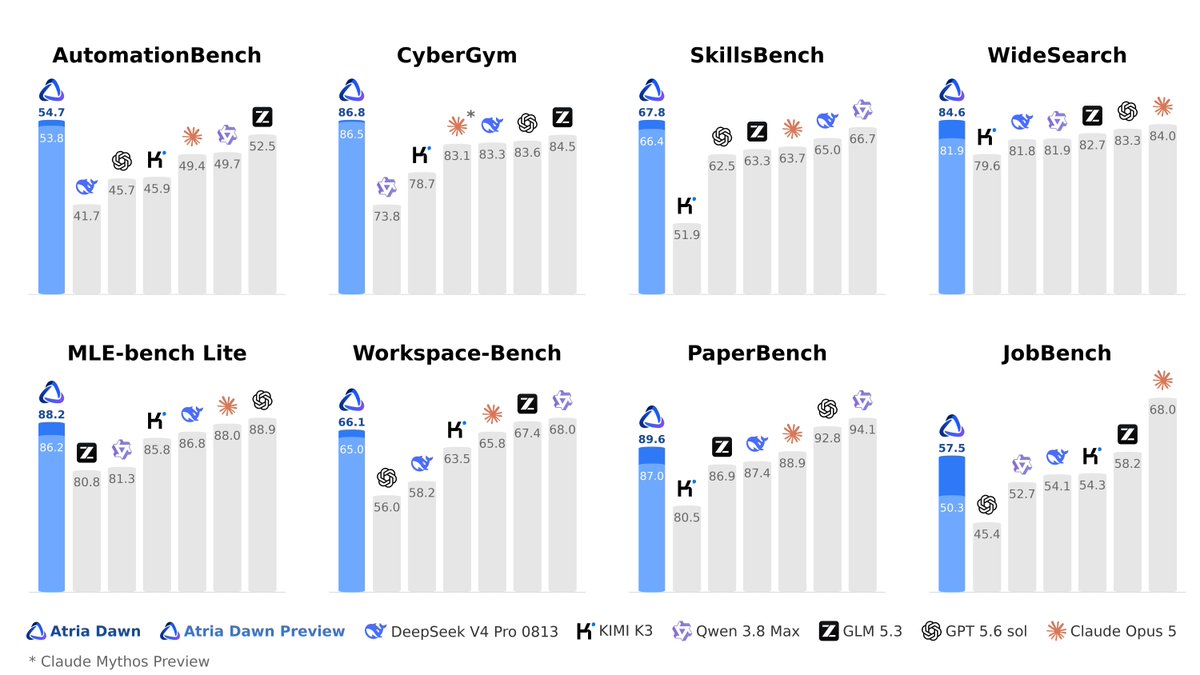
上海人工智能实验室把 Atria Dawn 从 Preview 升级为正式版,Hugging Face(internlm/Atria-Dawn 及 FP8 版)与 ModelScope 均已上线开放权重,MIT 许可。模型基于 744B 参数 MoE 的 GLM-5.2,面向科研与工程类长程智能体任务,上下文从 Preview 的 256K 翻倍到 512K,仅接受文本输入。官方表格显示其在 AutomationBench、CyberGym、SkillsBench 等智能体基准上领先所列模型,但在 SWE-bench Pro、Terminal-Bench 2.1 等编码基准上仍落后 Claude Opus 5(均为厂商口径)。

上海 AI 实验室发布 Atria Dawn 正式版:基于 744B MoE GLM-5.2 的智能体模型,上下文翻倍至 512K,MIT 开源

核心要点速览

  • 上下文 512K,是 Preview 版 256K 的两倍;基座为 744B 参数 MoE 的 GLM-5.2,仅支持文本输入
  • Hugging Face 与 ModelScope 提供 BF16 与 FP8 权重,MIT 许可
  • 厂商口径:AutomationBench 54.7、CyberGym 86.8、SkillsBench 67.8、BFCL V4 78.4,均为表内最高
  • 短板同样来自官方表:SWE-bench Pro 61.7 对 Claude Opus 5 的 76.5,Terminal-Bench 2.1 81.0 对 90.2
  • 本地部署需 SGLang v0.5.13.post1+ 或 vLLM v0.23.0+;也提供 OpenAI 兼容 API,可直接接入 Codex
阅读全文
关联模型 / 智能体 / 厂商:

BOSS 直聘南北阁实验室开源 Nanbeige4.3-33B:33B 稠密模型、512K 上下文、Apache 2.0,官方称 Terminal-Bench 2.1 达 80.9 超过 Qwen3.8-27B

BOSS 直聘(看准科技)旗下南北阁大模型实验室 @nanbeige 在 UTC 2026-10-25 12:11 发布 Nanbeige4.3-33B(原帖),模型和 Base 版已在 Hugging Face 以 Apache 2.0 开放权重(模型卡)。这是一个 Llama 架构的 33B 稠密模型,支持 512K 上下文,定位为 Nanbeige4.3 系列的「教师模型」,后续会蒸馏出 Nanbeige4.3-3B 等小模型。官方模型卡在同一套 harness、最高思考强度下对比 Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B:Terminal-Bench 2.1 为 80.9(Qwen3.8-27B 73.0),DeepSWE 65.5(42.5),但 SWE-Bench Pro 60.3 略低于 Qwen 的 61.7,GDPval 84.8 也低于 86.4。以上均为官方自测成绩,尚无第三方复现。

核心要点速览

  • 官方来源:@nanbeige X 原帖 与 Hugging Face 模型卡,抓取时原帖约 616 赞、79 转发、3.8 万浏览
  • 规格:33B 稠密、Llama 架构、512K 上下文、Apache 2.0,同时开放 Base 版
  • 官方自测编码:Terminal-Bench 2.1 80.9、Terminal-Bench 4.0 23.8、DeepSWE 65.5、SWE-Bench Pro 60.3(Qwen3.8-27B 分别为 73.0、6.3、42.5、61.7)
  • 官方自测协作类:Automation Bench 54.2、JobBench 44.8、GDPval 84.8(Qwen3.8-27B 为 38.3、34.5、86.4)
  • 部署:支持 Transformers、SGLang、vLLM,官方示例用 4 卡张量并行;后续将蒸馏 Nanbeige4.3-3B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nanbeige4.3-33B⚡ Qwen3.8-27B⚡ Gemma4-31B⚡ Muse-Glimmer-30B🌐 Nanbeige🌐 BOSS Zhipin🌐 Kanzhun

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

欧洲前沿 AI 巨头 Mistral AI 与 NVIDIA 在 GTC Berlin 宣布达成工业工程 AI 深度战略合作,全面加速物理 AI、计算机辅助工程(CAE)与芯片设计(EDA)的智能化变革。合作将 Mistral 旗舰模型与 NVIDIA CUDA-X、Warp 物理引擎以及 Omniverse 实时数字孪生进行全链路打通。官方博客同时公布了备受瞩目的下一代旗舰模型 Mistral Large 4 的核心技术参数:总参数量接近 1 万亿(1T),激活参数为 490 亿(49B MoE),在 3800 张 Grace Blackwell GPU 集群上训练完成,模型权重定于 10 月底正式开源发布,并将联合 Nemotron 联盟共建工业基座。

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

核心要点速览

  • Mistral AI 与 NVIDIA 官宣战略合作,将大模型能力全面注入计算机辅助工程(CAE)、物理仿真与半导体芯片设计(EDA)
  • 深度融合 NVIDIA Warp、CUDA-X 物理加速库与 Omniverse 数字孪生平台,构建工程仿真领域的开源智能体评测与基准
  • 首次正式公开 Mistral Large 4 核心规格:约 1 万亿总参、49B 稀疏激活 MoE 架构,在 3800 张 Grace Blackwell 算力集群完成预训练
  • Mistral Large 4 官方权重定于 2026 年 10 月底全量开源发布,并宣布双方加入 Nemotron 联盟向 2030 年 1 GW 绿色算力推进
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Cloudflare 发布 Clairic 抽取模型:一次前向传播输出带类型和置信度的数值、日期与预测,Workers AI 预览、每百万输入 token 0.10 美元

Cloudflare 10 月 19 日发布 Clairic 预览版,定位为「System One 抽取模型」:不逐 token 生成,而是一次并行前向传播,从文本或最多 4 张图片里抽取、计算、估计和预测带类型的值,每个答案附置信度、字符位置和缺失概率,缺失时返回 null。模型以 @cf/cloudflare/clairic 上线 Workers AI,文档标注 64K 上下文、支持视觉、每百万输入 token 0.10 美元且不收输出费。官方示例中,Clairic+Clef+GLM-5.3 级联比全用 GLM-5.3 快约 3.2 倍、成本低约 49%(官方口径),权重将在之后开放。

Cloudflare 发布 Clairic 抽取模型:一次前向传播输出带类型和置信度的数值、日期与预测,Workers AI 预览、每百万输入 token 0.10 美元

核心要点速览

  • 定价与规格:每百万输入 token 0.10 美元、无输出费,上下文 65,536 token,支持文本加最多 4 张图(官方文档)。
  • 输出类型:text、number、date/time、duration、list、estimate、forecast;每个答案附置信度与 p_null,缺失返回 null。
  • 级联实测:Clairic→Clef→GLM-5.3 端到端 19.3 秒对 61.7 秒,约快 3.2 倍;每百万次理赔 6032 美元对 11740 美元,省约 49%(官方口径)。
  • 预测示例:TSA 安检人数 21 天预测平均误差 3.3%,17/21 天落在 80% 区间内。
  • 局限:多步连锁算术、跨多行聚合尚不可靠;当前为预览检查点,开放权重时间未定。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ clairic⚡ clef⚡ GLM-5.3🌐 Cloudflare

DeepSeek 发布 V4.1-Flash-1017:MIT 开源权重同步上线网页、App 与 API,DeepSWE 官方报 77.0,API 价格不变并开放自研 Search/Fetch 接口

DeepSeek 于 10 月 17 日把 V4.1 Flash 升级为 V4.1-Flash-1017,网页、App 与 API 同步切换(deepseek-flash 调用方式和价格不变),权重以 MIT 协议上架 Hugging Face 与 ModelScope。官方口径下 DeepSWE v1.1 从 74.2 升至 77.0、Terminal-Bench 4.0 从 31.2 升至 42.3,同时任务耗时与输出长度下降;同步开放自研搜索引擎驱动的 Search/Fetch API($0.75/千次)。

DeepSeek 发布 V4.1-Flash-1017:MIT 开源权重同步上线网页、App 与 API,DeepSWE 官方报 77.0,API 价格不变并开放自研 Search/Fetch 接口

核心要点速览

  • 官方口径 DeepSWE v1.1 77.0(上一版 74.2),表中高于 Claude Opus 5 的 74.0 与 GPT-5.6 Sol 的 73.0
  • Terminal-Bench 4.0 由 31.2 升至 42.3、ProgramBench 由 20.3 升至 29.1,但仍低于 Opus 5 的 51.8 / 37.0;HLE(无工具)42.6 对 Opus 5 的 56.3
  • API 定价不变:deepseek-flash 高峰期输入(未命中缓存)$0.3、输出 $1.2 每百万 token,非高峰减半;上下文 1M、最大输出 384K
  • Search / Fetch API 各 $0.75/千次;经 DeepSeek Harness、Claude Code、Codex 服务端工具调用的部分免费至北京时间 11 月 1 日 00:00
  • 权重 MIT 开源,Hugging Face 为 FP8 存储(专家权重 FP4),不附 Jinja 模板,需用官方 encoding.py 或 deepseek-recipe
阅读全文

Meta 开源 Muse Spark Open:816B/42B 原生多模态美系开源旗舰,双 M5 Ultra Mac Studio 可本地跑智能体

Meta 于 2026-10-15 放出 Muse Spark Open 开源权重:816B 总参、每 token 激活 42B 的 MoE + Perception Encoder,原生支持文本/图像/视频/音频输入与 1M 上下文,定位编码与长程智能体。权重上 Hugging Face(BF16/NVFP4)、SageMaker、Model Garden 与 Foundry;API 已通 OpenRouter、Together、Fireworks、Groq 等。官方称其为迄今最强美系开源权重,并与 Apple 合作使双台 M5 Ultra Mac Studio 经 MLX 本地跑通。

Meta 开源 Muse Spark Open:816B/42B 原生多模态美系开源旗舰,双 M5 Ultra Mac Studio 可本地跑智能体

核心要点速览

  • 规格:MoE 816B 总参 / 42B 激活(256 experts,top-8),62 层,1M 上下文;输入文本+图像+视频+音频,输出文本(模型卡)
  • 本地门槛:NVFP4 约需 ≥700GB 显存,BF16 约 2TB;亦可双台 Apple M5 Ultra Mac Studio + MLX 统一内存部署(Meta 博客)
  • 智能体基准(xhigh,官方表):MCP-Atlas 89.2、JobBench 61.8、OSWorld Verified 80.4、Terminal-Bench 2.1 76.4、DeepSWE 1.1 60、AA Intelligence Index 39
  • 推理栈:SGLang / vLLM / TensorRT-LLM / Transformers / llama.cpp / Unsloth / MLX;附 Helion 内核(NVIDIA/AMD 内核级 1.03–3.95×)
  • 许可:Muse Model License(须标注 Built with Muse Spark Open;年收入超 $20M 的 MaaS 需另签);OpenRouter 约 $1.25/M 入、$4.25/M 出
阅读全文
关联模型 / 智能体 / 厂商:

阶跃星辰 Step 5 Preview 开源权重落地:600B/27B 稀疏 MoE、1M 上下文智能体旗舰,Hugging Face 与 ModelScope 同步上线

阶跃星辰于 2026-10-15 履约放出 Step 5 Preview 开源权重:600B 总参、每 token 激活 27B 的稀疏 MoE,支持最长 1M token 上下文与视觉输入,定位智能体与软件工程。权重已上 Hugging Face(FP8/BF16/NVFP4)与 ModelScope;官方评测 StepCodeBench 49.0%、FrontierFinance 66.4%、Artificial Analysis Intelligence Index 44。此前 9 月仅有 API/指数报道,本次是权重本身首次公开可下载。

阶跃星辰 Step 5 Preview 开源权重落地:600B/27B 稀疏 MoE、1M 上下文智能体旗舰,Hugging Face 与 ModelScope 同步上线

核心要点速览

  • 规格:稀疏 MoE 600B 总参 / 27B 激活,上下文最长 1M token,输入支持文本与图像(官方模型页)
  • 权重仓库:stepfun-ai/Step-5-Preview(及 BF16、NVFP4)已在 Hugging Face 与 ModelScope 可下载(HF 模型卡)
  • 编码基准:StepCodeBench avg@4 为 49.0%(开源权重对比中领先官方所列对手);DeepSWE v1.1 为 67.7%(官方评测表)
  • 金融与智能指数:FrontierFinance 66.4%;Artificial Analysis Intelligence Index 44(与此前 AA 报道一致)
  • 部署:官方给出 vLLM / SGLang Docker 与 OpenAI 兼容 API 示例;许可为 StepFun Model License 1.0(类 Apache-2.0 另附商用条件)
阅读全文
关联模型 / 智能体 / 厂商:

Fish Audio 发布 Drama 3:35B MoE 开源权重 TTS,词级情绪导演,发音鲁棒性 93.2% 登顶 Artificial Analysis

Fish Audio 于 2026-10-13 发布 Drama 3:以自然语言方括号指令导演情绪与节奏的 TTS,开源权重上架 Hugging Face,API 头 model: drama-3。骨干为约 35B 参数 MoE(每 token 约 3B 激活,自 Qwen3.5-35B-A3B 语言塔初始化),配合 codebook-MTP 音频解码器与人类偏好 RL。独立评测 Artificial Analysis Pronunciation Robustness 93.2%(S2.1 Pro 88.1%);支持 83 语种、最多 16 说话人;Community License 年营收低于 50 万美元可免费商用。启动至 11 月 12 日 API 特价约 $10/百万字符。

Fish Audio 发布 Drama 3:35B MoE 开源权重 TTS,词级情绪导演,发音鲁棒性 93.2% 登顶 Artificial Analysis

核心要点速览

  • 开源权重:Hugging Face fishaudio/drama-3;Community License v1.0,年营收 <US$50 万可免费商用,禁止未经同意克隆真人声音
  • 架构:35B MoE / ~3B 激活;混合注意力(每 4 层 1 个 full attention);codebook-MTP 解码 10 个 codebook;自 Qwen3.5-35B-A3B 语言塔初始化
  • 权威口径:Artificial Analysis Pronunciation Robustness 93.2%(#1),S2.1 Pro 88.1%;品牌/专名 95.9%,上下文相关读法 95.3%
  • 实测吞吐(厂商 H200 单卡流式):单流 271 frames/s;并发 1 时 TTFA p50 88.9 ms;并发 16 时约 927 frames/s、RTF 0.373
  • 接入:API POST /v1/tts 设 model: drama-3;本地可用 SGLang-Omni sgl-omni serve --model-path fishaudio/drama-3(建议 ≥48GB NVIDIA VRAM)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Drama 3⚡ Fish Audio S2.1 Pro⚡ Qwen3.5-35B-A3B🌐 Fish Audio🌐 Artificial Analysis🌐 SGLang