LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次
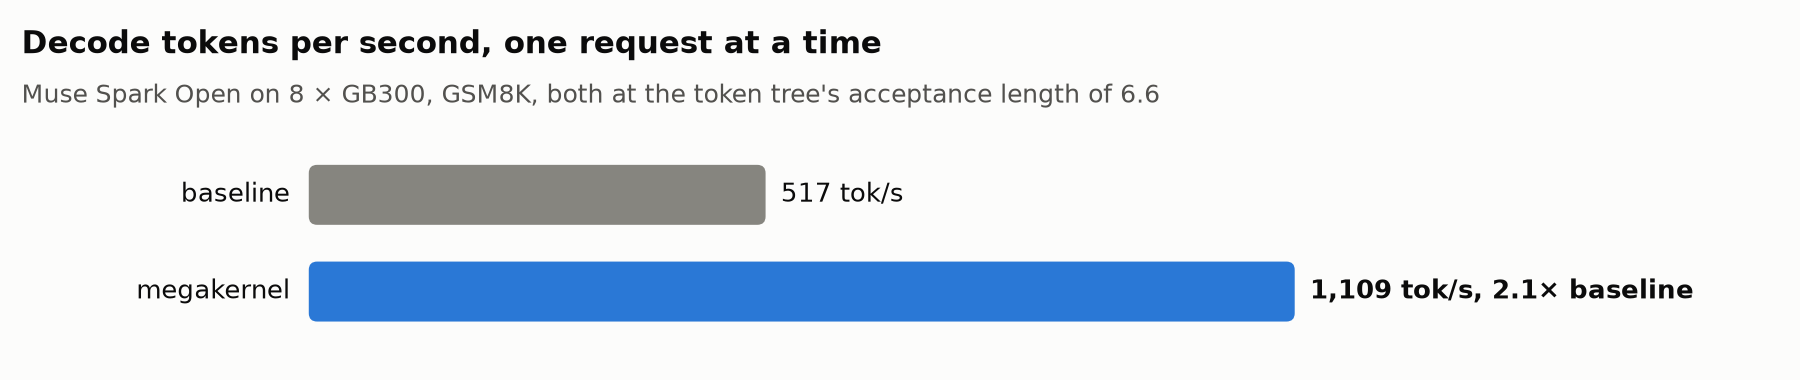
LMSYS 发布技术长文,介绍为 Meta 开源模型 Muse Spark Open 从零手写的 megakernel(CUDA C++ 与 PTX,约 8000 行):每个解码层只启动一次内核,把计算、显存加载和跨卡通信重叠起来。在 8 张 GB300 上,单请求解码速度从 SGLang 基线的 517 tok/s 提到 1,109 tok/s,约 2.1 倍;每个解码步从 12.9 毫秒降到 5.9 毫秒。代码以 SGLang 插件形式开源在 facebookresearch/sgl-muse-mega(MIT)。目前只支持 batch 1,属于实验功能,换来的是低延迟,不是更便宜的 token。
核心要点速览
- 速度翻倍:8×GB300、TP8、GSM8K 单请求,解码 517 → 1,109 tok/s,约 2.1 倍(同一草稿模型、同一接受长度)
- 内核启动大减:每个解码步从约 1,450 次内核启动降到 97 次,每层只启动一次
- 单步耗时:12.9 毫秒 → 5.9 毫秒;其中验证 10.9 → 5.3 毫秒,草稿 1.16 毫秒 → 0.44 毫秒(草稿从 175 次启动降到 8 次)
- 投机解码:DFlash V2 草稿每步猜 15 个 token,验证 16 个、平均接受 6.6 个;小米 MiMo-V2.5-Pro 为验证 8 个、接受 6.3 个
- 适用范围:仅 batch 1,其他请求回退到普通 SGLang;8 张顶级 GPU 只服务一个用户,卖的是延迟而不是成本