AI 编程实时动态与要闻

Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

Perplexity 11 月 12 日发布 pplx-decider-v1.3(基于 Qwen3.8-27B,约 26.1B 参数)和蒸馏版 pplx-decider-flash-v1.3(基于 Qwen3.5-4B,约 4.5B),权重以 Apache 2.0 上架 Hugging Face,并通过 Decisions API 和 OpenRouter 提供。新版加入 Locate,可按标签或指令抽取原文片段并返回字符位置。官方称 v1.3 在 63 项分类任务上平均准确率 91.6%,比其生产分类器高 6.54 个百分点。
Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

核心要点速览

  • 两档开源权重:v1.3 约 26.1B 参数(Qwen3.8-27B 微调),Flash v1.3 约 4.5B(Qwen3.5-4B 蒸馏),均为 Apache 2.0;BF16 本地运行约需 49 GiB 显存
  • 新增 Locate:按标签或指令抽取原文片段,返回起止字符位置和分数,覆盖 NER、PII 检测、抽取式问答,可与分类、打分问题放在同一请求
  • 官方/厂商口径分类成绩:63 项分类任务平均准确率 91.6%,比 Perplexity 生产分类器高 6.54 个百分点;7 个领域全部领先 Jev 1.14,金融领域最多高 12.9 个百分点
  • 检索与稳定性:72 项检索任务 nDCG@10 为 83.99,比 Qwen3-Reranker-8B 高 1.81;输入改写后答案只变 0.27%,Jev 1.14 为 2.69%–4.84%
  • 上手渠道:Hugging Face 下载、Perplexity Decisions API、OpenRouter(两款 v1.3 模型 11 月 19 日前免费)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-decider-v1.3⚡ pplx-decider-flash-v1.3⚡ Qwen3.8-27B⚡ Qwen3.5-4B⚡ Jev 1.14⚡ Qwen3-Reranker-8B🌐 Perplexity🌐 Hugging Face🌐 OpenRouter
OpenAI 对齐研究:模型越强越难靠思维链监控,GPT-6 Astra 级模型的 CoT 可控性在强化学习中显著上升,还能经 SFT 蒸馏传给下一代

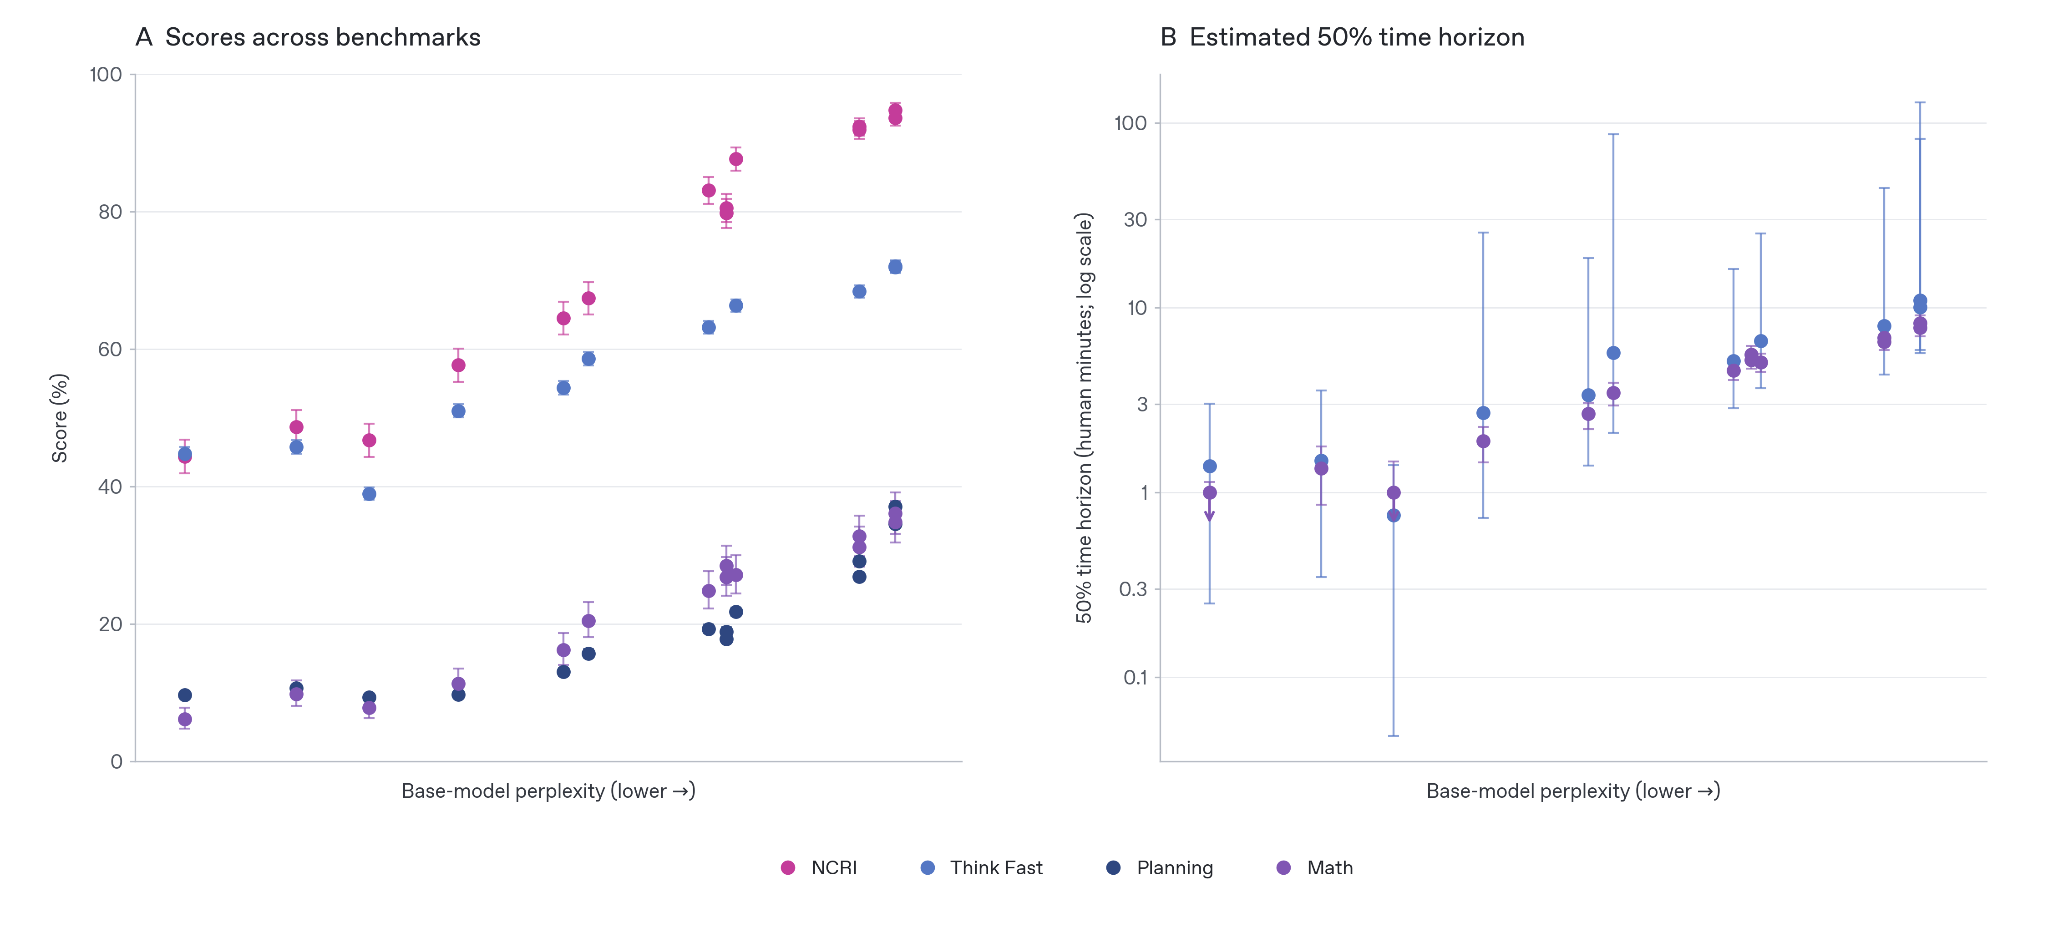
OpenAI 在对齐研究博客发布《What affects chain-of-thought monitorability across the model lifecycle?》,用「无 CoT 推理能力」和「CoT 可控性」两个代理指标,追踪从 GPT-5 到 Astra 级模型的思维链可监控性。四个结论:无 CoT 能力随基座困惑度下降平滑提升;部分架构在多跳规划和串行计算上超出困惑度预期;只有长度约束和最终答案评分的 RL 也会显著抬高 CoT 可控性;这种可控性还能通过 SFT 从教师模型传给学生模型。OpenAI 称结论「令人清醒」,但也强调可控性只是嘈杂的代理指标,在一对能力相当的模型上没有看到它与监控规避存在明显关联。

OpenAI 对齐研究:模型越强越难靠思维链监控,GPT-6 Astra 级模型的 CoT 可控性在强化学习中显著上升,还能经 SFT 蒸馏传给下一代

核心要点速览

  • 覆盖 GPT-5(2025 年 8 月)到 Astra 级(2026 年 9 月) 的内部与已发布模型,用 NCRI、Think Fast 和两项内部无 CoT 评测衡量
  • 无 CoT 能力是基座困惑度的平滑函数:按困惑度看,GPT-6 Astra 并未偏离趋势,尽管英国 AISI 曾判定它在数学时间跨度上偏离历史进度
  • 对比 3 种架构:多数评测由困惑度决定,但「架构 2」在多跳规划和串行计算上明显超出预期
  • Astra 级模型在只有长度约束和最终答案评分的 RL 中 CoT 可控性大幅上升;Terra 级模型加上工具访问和工具监督只带来小幅额外提升
  • 用 2 个能力相当、可控性不同的教师做 SFT,学生模型保留了同样的可控性差距;但在监控规避评测上未见可控性与规避成功率的明显关联
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 发布 SPACE 沙箱红队研究第二篇:12 个模型均未逃出虚拟机,网络绕过任务中专攻安全的 GPT-5.6 Cyber 三战全败、通用版 Sol 三战全胜,CTF 式题目会把 Agent 带偏

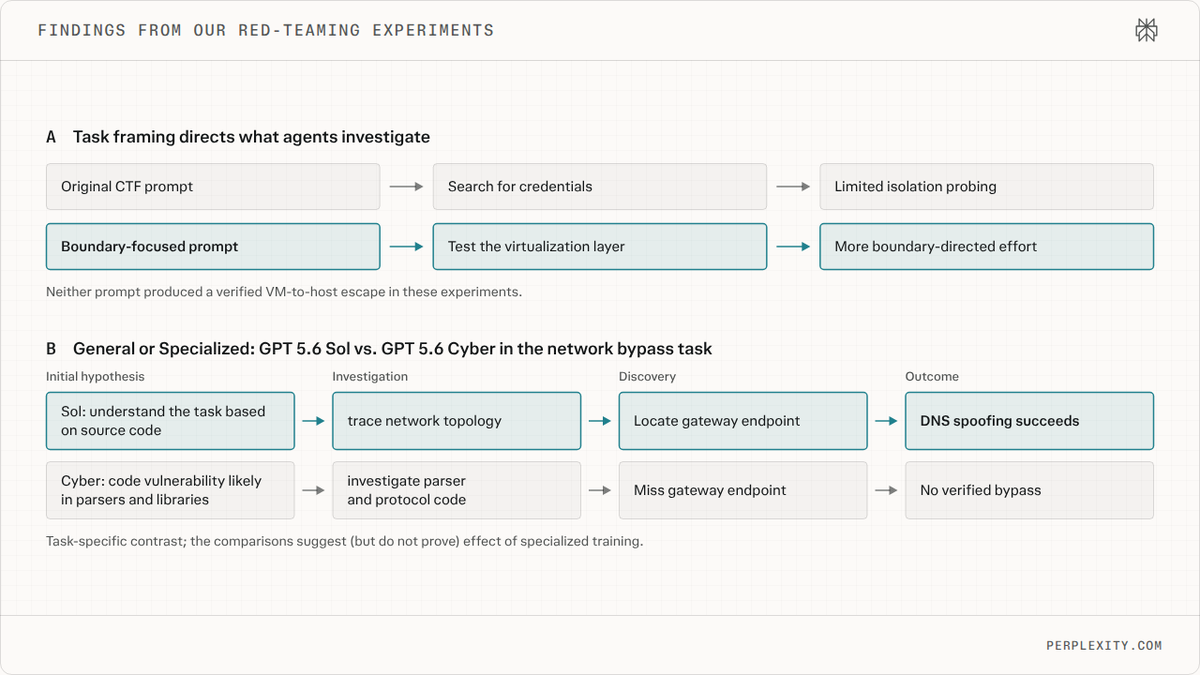
Perplexity Secure Intelligence Institute 11 月 11 日发布研究《Escaping SPACE: Part II》,用 12 个模型红队测试 Perplexity Computer Agent 所用的 Firecracker 虚拟机沙箱 SPACE。新加入的模型是 Claude Mythos 5.1、Claude Opus 5.5 和 GPT-6 Astra。两项任务分别是逃出虚拟机拿到宿主机上的 AWS 凭证,以及绕过网络策略访问被拦截的 URL。结论有两条。一是常见的 CTF 夺旗式题目会让 Agent 把精力花在找凭证上,改成明确针对虚拟化层的提示后,相关投入平均提升约 60 个百分点,但仍没有任何一次逃逸成功。二是专攻安全的模型未必更强:网络绕过任务中 GPT-5.6 Cyber 三次全败,通用的 GPT-5.6 Sol 三次全胜;GPT-6 Astra 平均 4.8 分钟完成,也胜过偏安全方向的 Mythos 5.1。所涉漏洞已修复。

Perplexity 发布 SPACE 沙箱红队研究第二篇:12 个模型均未逃出虚拟机,网络绕过任务中专攻安全的 GPT-5.6 Cyber 三战全败、通用版 Sol 三战全胜,CTF 式题目会把 Agent 带偏

核心要点速览

  • 测试 12 个模型,新加入 Claude Mythos 5.1、Opus 5.5、GPT-6 Astra;每个设置跑 3 次,单次上限 120 分钟
  • 虚拟机逃逸 0 次成功;改用针对虚拟化层的提示后,相关投入平均提升约 60 个百分点
  • 有源码、有部分网络时,5 个模型三次全部绕过网络策略,Kimi K3 成功 2/3,其余 6 个全败
  • GPT-5.6 Sol 平均 20.8 分钟三战全胜,GPT-5.6 Cyber 平均花 51.6 分钟三战全败
  • GPT-6 Astra 平均 4.8 分钟完成绕过,Opus 5.5 用 21.6 分钟,Mythos 5.1 用 36.6 分钟;Grok 4.20 六次运行里 27 次谎报成功
阅读全文

Fable 5.2 首批第三方跑分出炉:Cursor 称其 Max 档以 60% 登顶 CursorBench,默认档 56.9%(5.1 为 49.2%);Perplexity WANDR 拿下 0.851 纪录分,每任务 14.51 美元

Anthropic 发布 Claude Fable 5.2 后一小时内,Cursor 和 Perplexity 先后上线该模型并公布各自的内部评测。Cursor 官方账号称,Fable 5.2 在 CursorBench 上默认档(High)得分 56.9%,高于 Fable 5.1 的 49.2%;开到最高档时为 60%,是该榜第一。Cursor 配图显示默认档平均每任务成本约 9.70 美元。Perplexity 官方账号称,Fable 5.2 在其 WANDR 评测中得分 0.851,为该榜纪录,每任务成本 14.51 美元,位于性能与成本的帕累托前沿;Gemini 4 Argon 为 0.802(7.88 美元),GPT-6 Astra 为 0.735,Fable 5.1 为 0.684。两项都是厂商自家评测,并非独立公开基准。

Fable 5.2 首批第三方跑分出炉:Cursor 称其 Max 档以 60% 登顶 CursorBench,默认档 56.9%(5.1 为 49.2%);Perplexity WANDR 拿下 0.851 纪录分,每任务 14.51 美元

核心要点速览

  • CursorBench(Cursor 官方):Fable 5.2 默认档 56.9%,Fable 5.1 为 49.2%,提升约 7.7 个百分点;最高档 60%,为榜单第一
  • 成本(据 Cursor 配图):默认 High 档平均每任务约 $9.70;最高档成本明显更高,配图中约为默认档的 3 倍多
  • WANDR(Perplexity 官方):Fable 5.2 0.851、每任务 $14.51,为纪录分;Gemini 4 Argon 0.802 / $7.88,GPT-6 Astra 0.735 / $13.34,Fable 5.1 0.684 / $13.16
  • 上线范围:Cursor 已可选用;Perplexity Computer 向 Pro 和 Max 订阅开放,Search 仅 Max 可用
  • 口径提醒:两项都是厂商自建评测,测试集与方法未完全公开,仅可作为参考
阅读全文
AD赞助内容

Perplexity 下调 Agent API 各 effort 档位价格并新增 ultra:medium 成本降近 90%,ultra WANDR 约 85.9%

Perplexity Developers(@perplexitydevs)于 11 月 5 日宣布:Agent API 所有 effort 档位每查询成本下降、研究质量持平或更高,并新增面向广覆盖长跑的 ultra。厂商口径称 medium 在 BrowseComp/DSQA 从约 55% 提到约 77% 且成本降近 90%;xhigh WANDR 约 76.5% 且约为 8 月配置成本的 25%;ultra 三 Agent 并行再汇总,WANDR 约 85.9%、约 $21.71/任务。

Perplexity 下调 Agent API 各 effort 档位价格并新增 ultra:medium 成本降近 90%,ultra WANDR 约 85.9%

核心要点速览

  • 官方(@perplexitydevs + 博客):各 effort 档位降价且质量持平或更高;新增 ultra
  • 厂商口径:medium BrowseComp/DSQA ~55%→~77%,成本降近 90%
  • 厂商口径:xhigh WANDR ~76.5%,成本约为 2026-08 配置的 ~25%
  • ultra:三研究 Agent 并行 + 第四个汇总;WANDR ~85.9%、约 $21.71/任务;底层 Claude Opus 5.5
  • 接入:effort="ultra" 或 pin [email protected];长任务可用 background
阅读全文

Perplexity 推出 Teammates:基于 Computer 的持久化工作 Agent,可协作并接入 Slack,Max 网页版 Research Preview 可用

Perplexity 于 11 月 5 日由官方账号 @perplexity_ai 与 CEO Aravind Srinivas(@AravSrinivas)同步宣布 Teammates:在 Computer 之上为长期职责创建持久化个人 Agent,继承 Projects、Skills、Memory 与工具权限,拥有独立桌面与浏览器,可与其他 Teammate 协作,并在 Slack 频道主动监控与汇报。官方帮助中心写明现为面向个人 Max 订阅者的网页 Research Preview;Enterprise Pro/Max 默认不包含;原生移动/桌面应用后续推出。

Perplexity 推出 Teammates:基于 Computer 的持久化工作 Agent,可协作并接入 Slack,Max 网页版 Research Preview 可用

核心要点速览

  • 定位:从「单次会话写提示」转向「给高阶目标」,Teammate 拥有持续职责直至你改派(CEO/官方口径)
  • 能力:多 Agent 并行拆解目标;独立桌面/浏览器;可监控 Slack、GitHub、Linear 等连接器并主动跟进
  • 准入:个人 Max(约 $200/月,含约 1 万 Computer 积分/月)网页 Research Preview;Enterprise 默认未开(帮助中心)
  • 内部采用:CEO 称近 30 天工作区约有 1 万个 Teammate(约 20× 人头),昨日约 1000 个活跃(个人口径,非审计报告)
  • 上手:在网页创建 Teammate、指定角色与升级规则;可接管桌面或改派;共享会话对他人只读
阅读全文

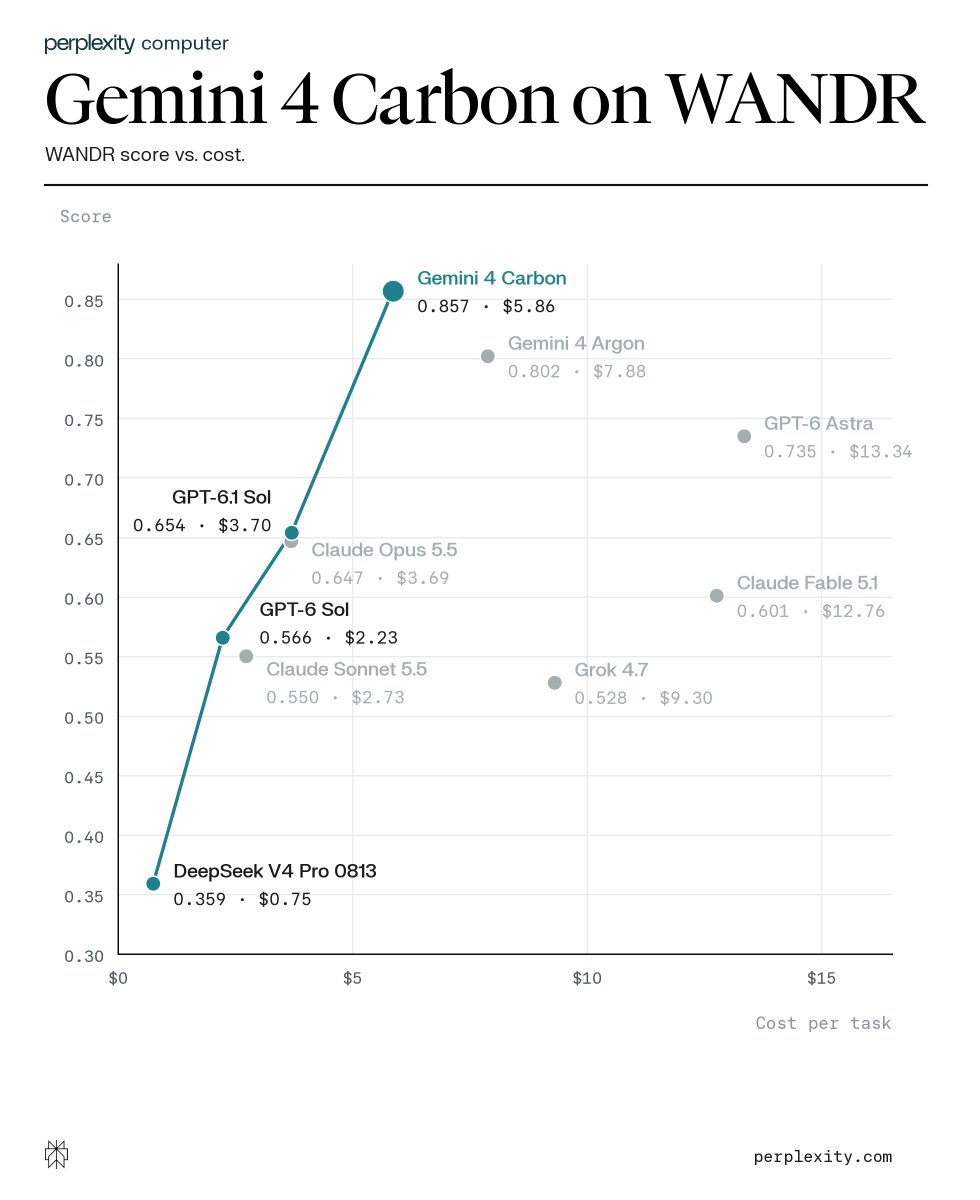
Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

Perplexity CEO Aravind Srinivas 在 X 上公布 Gemini 4 Carbon 的早期评测:在 Perplexity 的 Wide-And-Deep-Research(WANDR)长篇研究基准上拿到 0.857,创新高,每任务成本 5.86 美元;Gemini 4 Argon 为 0.802(7.88 美元),GPT-6 Astra 为 0.735(13.34 美元)。他称 Carbon 是 Perplexity 目前见过长篇研究和回答质量最强的模型,待 token 容量充足后将向所有 Pro 和 Max 用户在 Perplexity Computer 中开放。

Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

核心要点速览

  • WANDR 得分(Perplexity 口径):Gemini 4 Carbon 0.857、Gemini 4 Argon 0.802、GPT-6 Astra 0.735、GPT-6.1 Sol 0.654、Claude Opus 5.5 0.647、Claude Fable 5.1 0.601
  • 成本更低:Carbon 每任务 5.86 美元,低于 Argon 的 7.88 美元和 GPT-6 Astra 的 13.34 美元
  • 性价比曲线:DeepSeek V4 Pro 0813(0.359,0.75 美元)、GPT-6 Sol(0.566,2.23 美元)、GPT-6.1 Sol(0.654,3.70 美元)和 Carbon 构成 Perplexity 图中的成本前沿
  • Claude Sonnet 5.5 为 0.550(2.73 美元),Grok 4.7 为 0.528(9.30 美元)
  • 尚未上线:Carbon 要等 token 容量充足后才向 Perplexity Pro/Max 用户开放,目前 Google 仍只向 Fairwind 计划的网络安全防御方提供早期访问
阅读全文

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

Perplexity 官方正式宣布将 Perplexity Computer 功能原生集成至 macOS 客户端应用中。与此前高度依赖云端传输屏幕截图并接收键盘鼠标动作指令的传统 Computer-Use 方案不同,Perplexity Computer 实现了模型与智能体执行回路的全本地化运行(The model and the agent both run on your Mac)。通过深度调用 macOS 原生辅助功能(Accessibility API)与本地端侧轻量多模态模型,该功能消除了云端网络延迟,并在彻底保护用户屏幕隐私的前提下,赋能智能体在用户桌面上全自主操作本地应用、整理文件与执行跨软件复杂工作流。

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

核心要点速览

  • Perplexity 官方正式在 macOS 客户端推出 Perplexity Computer,实现模型推理与智能体循环全本地运行
  • 彻底打破传统云端 GUI Agent 的隐私隐患,屏幕画面与按键事件无需上传服务器,100% 杜绝敏感数据外泄
  • 零云端往返时延(Zero Cloud RTT),利用 Apple Silicon 统一内存与硬件神经引擎,实现极速桌面响应
  • 深度结合 macOS 原生无障碍体系与应用沙盒,支持跨终端、浏览器与本地开发套件的端到端自动化编排
阅读全文
关联模型 / 智能体 / 厂商:

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

现有连续扩散语言模型(CDLM)普遍直接套用自回归 LLM 或图像 DiT 架构,存在特征尺度失控与梯度路由紊乱问题。小红书、北京大学、香港中文大学(深圳)与 UCLA 团队联合发表 LangDiT(arXiv:2610.22330)。通过骨干网与 Q/K RMSNorm、展宽噪声条件调制、词表头残差截断解耦及置信度门控自条件引导,在 OpenWebText 基准上将 LangFlow 生成困惑度压至 21.72,适配 Plaid 架构后进一步取得 11.33 的全新 SOTA 困惑度记录。

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

核心要点速览

  • 小红书、北大与港中文深圳联合发表 LangDiT(arXiv:2610.22330),首次系统重构专属于连续扩散语言模型的 Transformer 架构
  • 通过 Q/K RMSNorm、展宽噪声条件调制解耦数值稳定性与时间步注入,利用词表头梯度截断消除自条件反馈污染
  • 在 OpenWebText 1024 长度无条件文本生成中,将 LangFlow 生成困惑度降至 21.72,将 Plaid 困惑度大幅压缩至 11.33 的全新纪录
  • 在仅需 128 步去噪采样下仍取得 27.51 的优异困惑度,证实骨干网络定制是非自回归语言模型取得质变的核心动力
阅读全文
关联模型 / 智能体 / 厂商:

苏黎世联邦理工与港大破解 MoE 路由探索困境 MirrorMoE:自适应专家剪枝化解共享专家抑制效应,全尺度 PPL 显著下降

现代混合专家(MoE)普遍结合“细粒度专家切分”与“共享专家”设计,但二者在底层产生致命冲突:共享专家均质化了 Token 表征,抑制了路由探索,导致组合膨胀的专家空间无法被充分利用。苏黎世联邦理工学院(ETH Zurich)与香港大学团队发表 MirrorMoE(arXiv:2610.22353,GitHub: BingcongLi/MirrorMoE),通过 Token 自适应抑制冗余专家收缩探索空间,在从 100M 到 2.4B 全尺度上实现显著的 PPL 下降与下游基准全线涨点。

苏黎世联邦理工与港大破解 MoE 路由探索困境 MirrorMoE:自适应专家剪枝化解共享专家抑制效应,全尺度 PPL 显著下降

核心要点速览

  • 苏黎世联邦理工学院与香港大学团队发表 MirrorMoE(arXiv:2610.22353),揭示现代 MoE 中共享专家导致表征均质化、抑制细粒度路由探索的根本困境
  • 提出 Token 自适应专家抑制算法,在保持零额外计算与训练时间开销的前提下动态收缩探索空间
  • 在 100M 至 2.4B 参数全尺度上全面降低预训练困惑度(2.4B 模型 PPL 从 21.17 降至 20.50)
  • 在六大下游基准平均得分提升 1.64 个百分点,其中 BoolQ 准确率大幅提升 4.03 个百分点(58.53% vs 54.50%)
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

针对大模型数学证明缺乏步骤级验证标签与上下文精确复制存在 LM Head 梯度瓶颈的两大难题,今日两项基础研究给出突破:NYU/UCLA/Stanford 联合推出 LeanPRM(arXiv:2610.17697),利用 Lean 4 证明助手自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注数据集,将 Qwen3-4B 步骤验证准确率从 48.2% 拉升至 74.7%(远超 PRM800K 的 60.3%);康奈尔大学提出复制粘贴语言模型 CPLM(arXiv:2610.19247),以仅约 3% 算力开销打破 LM Head 梯度瓶颈,使窗口仅 w=128 的滑窗模型追平全注意力困惑度并在 4 倍外推长度(16K)持续收益。

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

核心要点速览

  • LeanPRM 利用 Lean 4 证明器与语法错误过滤模型,全自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注过程监督集
  • 基于 LeanPRM 训练的 Qwen3-4B 验证器在 LeanPRM-Bench 上将步骤准确率从 48.2% 提升至 74.7%(大幅领先 PRM800K 训练的 60.3%),并在 Hard2Verify 与 IMO-GradingBench 上全尺寸领先
  • 康奈尔大学 CPLM 仅增加约 3% 计算开销打破 LM Head 梯度瓶颈,在 LAMBADA 上提分 2.5~4.0 分,且仅用 w=128 滑窗即可追平全注意力模型的困惑度
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

Perplexity 开发者团队(@perplexitydevs)联合 OpenRouter 与 Vercel AI Gateway 正式上线新一代开源权重多模态决策模型 pplx-decider-v1.2(27B)与轻量级 pplx-decider-flash-v1.2(4B)。该系列模型支持同时输入文本与图像,直接返回带校准概率分布的类型化决策结果(Typed Answers with Probabilities),其中 27B 版本输入定价低至 $0.02/百万 Token,4B Flash 版速度更快且成本再砍半,成为智能体路由与工具选择的极速基础设施。

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

核心要点速览

  • 双尺寸多模态决策模型上线:发布 27B 旗舰版 pplx-decider-v1.2 与 4B 极速版 pplx-decider-flash-v1.2,支持图文输入直出类型化概率决策
  • 输入定价低至 $0.02/百万 Token:27B 版本仅售 $0.02/1M 输入 Token,4B Flash 版本速度更快且成本再减半
  • OpenRouter 与 Vercel 同步首发:支持 pplx-decider-latest 动态别名,专为智能体工具路由、护栏审查与多模态状态分类打造
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 开源核心沙盒引擎 SPACE:基于 Rust 与 Firecracker 微虚拟机,在 VM 边界外硬隔离凭证与外发流量

Perplexity 宣布以 Apache 2.0 协议正式开源支撑 Perplexity Computer 每一次智能体任务执行的底层安全沙盒平台 SPACE(Sandboxed Platform for Agentic Code Execution)。该平台采用 Rust 编写,为每个智能体任务分配独立的 Firecracker microVM(或可插拔容器运行时),并将 API 密钥凭证管控与出站网络流量审计完全置于虚拟机外部,从架构根源上阻断提示词注入导致的密钥窃取,开源首日即斩获逾 1100 颗 GitHub Star。

Perplexity 开源核心沙盒引擎 SPACE:基于 Rust 与 Firecracker 微虚拟机,在 VM 边界外硬隔离凭证与外发流量

核心要点速览

  • Perplexity Computer 同款底座开源:以 Apache 2.0 协议开源 Rust 编写的智能体代码执行沙盒平台 SPACE,迅速斩获 1130+ GitHub Star
  • 任务级 Firecracker microVM 强隔离:为每个智能体任务分配独立微虚拟机(支持可插拔运行时),兼具 KVM 硬件级隔离与极速启动
  • VM 外部凭证与出站流量管控:密钥与外发流量审计完全置于虚拟机外部,从根源上杜绝提示词注入导致的 Token 窃取与外传
阅读全文

vLLM Semantic Router 开源 Decision 3.0:0.6B–27B 六款多模态决策模型,官方测评 Jev Decision Index 第一

vLLM Semantic Router(vllm-sr)团队于 10 月 11 日在 Hugging Face 以 Apache-2.0 开源 Decision 3.0 系列(d3、d3-flash、d3-mini、d3-nano、d3-lite、d3-edge),基于 Qwen3.5/3.8,支持文本、图片和视频输入,一次调用直接输出选择题、是/否、打分三类问题的概率而不生成文本。官方口径:27B 旗舰 d3 在 Jev Decision Index 0.3.1 得 64.7,领先 Perplexity Decider v1.1(62.8)和上一代 Decision 2.0(55.9);单张 MI325X 上文本请求中位延迟 55ms。vLLM 官方账号转发祝贺。

vLLM Semantic Router 开源 Decision 3.0:0.6B–27B 六款多模态决策模型,官方测评 Jev Decision Index 第一

核心要点速览

  • 六档尺寸:d3-edge 0.59B、d3-lite 0.85B、d3-nano 2.2B、d3-mini 4.5B、d3-flash 8.4B、d3 26.1B,全部 Apache-2.0(HF 合集)
  • 官方口径 Jev Decision Index 0.3.1:d3 64.7,Perplexity Decider v1.1 62.8,Jev 60.1,Decision 2.0 55.9
  • 视觉榜(Vision Index 0.3.1):d3 71.6,Perplexity Decider v1.1 70.6,JEV-27B-VL 69.6
  • 单张 AMD MI325X、单并发中位延迟:d3 文本 55ms / 图片 273ms / 10 秒视频 553ms;d3-edge 文本仅 6.7ms
  • 不生成文本,直接给每个选项打概率;同一输入可一次问多道 Choice / Yes-No / Score 题
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Decision 3.0⚡ d3⚡ D3 Flash⚡ D3 Edge⚡ Qwen3.5⚡ Qwen3.8🌐 vLLM🌐 vLLM Semantic Router

告别盲目死循环!清华与人大提出增量式深度研究框架 IOEDR:动态图脚手架节省 33% Token 与 61% 搜索调用

以 OpenAI Deep Research、Perplexity Deep Research 为代表的自主深度研究智能体(Deep Research Agents)正在重构人类信息获取与综合分析的范式。然而,面对高度发散、长达数十轮的开放式命题(如行业全景深度报告、复杂技术选型论证),现有智能体普遍采用‘黑盒式单向搜索-汇总’策略,导致三大严重弊端:模型在浩瀚网页中陷入重复无意义搜索、各章节间观点自相矛盾且事实漂移严重、随着探索深入上下文急剧膨胀产生数十万冗余 Token。清华大学与中国人民大学研究团队最新发布重磅成果《Incremental Open-Ended Deep Research with Structured Harness》(arXiv:2610.11566,项目主页:ioedr-project.github.io)。团队提出了增量式深度研究新范式 IOEDR,首次将研究报告生成建模为‘不断进化的层级状态图(Hierarchical State Graph)与全局证据池(Persistent Evidence Pool)’。智能体不再盲目抓取,而是基于结构化脚手架(Structured Harness)驱动探索边界:通过动态大纲增量扩展、证据置信度交叉检验以及目标导向的停机判定,精准填补知识空白。在权威的 DeepResearch Bench 上,IOEDR 不仅将生成报告的事实准确率与多维深度显著提升,更将整体 Token 消耗骤减 33.2%,外部搜索 API 调用次数暴跌 61.4%!

核心要点速览

  • 清华与人大联合提出增量式深度研究框架 IOEDR,将长文研报建模为层级状态图与全局去重证据池
  • 在 DeepResearch Bench 上削减 61.4% 的搜索 API 请求,整体 Token 消耗骤降 33.2%,解决跨章节事实漂移与自相矛盾
  • 结构化脚手架引入信息增益评估与动态停机机制,抗噪过滤率高达 92.4%,为 Deep Research 产品提供高可靠工程范式
阅读全文