AI 编程实时动态与要闻

GitHub Copilot 全面上线 Gemini 4 Hydrogen(VS Code、CLI、编码 Agent 等全平台,按厂商标价计费);同日宣布 12 月 14 日下线 Claude Fable 5、Gemini 3.8 Flash、Grok 4.6、Kimi K3 等 6 个模型

GitHub 于 11 月 13 日在官方 Changelog 宣布:Google 最新的 Flash 级模型 Gemini 4 Hydrogen 已在 GitHub Copilot 正式可用(GA),面向 Copilot Pro、Pro+、Max、Business 和 Enterprise 用户,可在 VS Code、Visual Studio、Copilot CLI、Copilot 编码 Agent、Copilot app、github.com、移动端、JetBrains、Xcode、Eclipse 和 Copilot SDK 的模型选择器中使用,逐步放量,按用量计费、价格为厂商标价。GitHub 称它面向快速高效的 Agent 编码、工具调用和多步工作流,指令遵循比 Gemini 3.8 Flash 更好。同一天 GitHub 还发布弃用通知:2026 年 12 月 14 日起,Copilot 全部体验将下线 Claude Fable 5、Claude Haiku 4.5、Gemini 3.8 Flash、Gemini 4 Argon、Grok 4.6 和 Kimi K3,并给出替代模型。
GitHub Copilot 全面上线 Gemini 4 Hydrogen(VS Code、CLI、编码 Agent 等全平台,按厂商标价计费);同日宣布 12 月 14 日下线 Claude Fable 5、Gemini 3.8 Flash、Grok 4.6、Kimi K3 等 6 个模型

核心要点速览

  • Gemini 4 Hydrogen 在 GitHub Copilot 正式可用,面向 Pro、Pro+、Max、Business、Enterprise 用户,逐步放量(GitHub Changelog)
  • 覆盖面很广:VS Code、Visual Studio、Copilot CLI、Copilot 编码 Agent、Copilot app、github.com、iOS/Android、JetBrains、Xcode、Eclipse 和 Copilot SDK 都能在模型选择器里选到
  • 计费:按用量计费、价格为厂商标价;企业和商业版默认自动启用新模型,管理员可在 Copilot 设置的模型策略里关闭
  • 12 月 14 日下线 6 个模型及官方建议替代:Claude Fable 5→Fable 5.2,Claude Haiku 4.5→Haiku 5.5,Gemini 3.8 Flash→Gemini 4 Hydrogen,Gemini 4 Argon→Gemini 4 Carbon,Grok 4.6→Grok 4.7,Kimi K3→待公布(弃用通知)
  • 例外:年付的 Copilot 个人订阅用户仍可继续使用 Claude Haiku 4.5
阅读全文

Fish Audio 推出无代码语音智能体平台 Fish Agent:一句话描述即可生成能打接电话的 AI 助手,官方称部署中位时间 32 秒,支持自带 LLM 和完整 API

Fish Audio 11 月 12 日(新加坡时间 13 日 01:00)发布 Fish Agent,一个无代码的语音智能体平台:用文字描述想要的助手即可生成,官方称部署时间中位数 32 秒。智能体可以租用或接入自有电话号码打接电话,可选平台大模型或接入自己的 OpenAI 兼容端点,并通过 Webhook、知识库和 REST API 扩展,对话由此前发布的全双工模型 Live 3 驱动。官方文档标注平台处于公开测试阶段。定价为每分钟 0.035 美元(原价 0.07 美元,优惠到 12 月 31 日),电话通话每分钟另加 0.01 美元,号码每月 1.20 美元,新用户送 5 美元额度。

Fish Audio 推出无代码语音智能体平台 Fish Agent:一句话描述即可生成能打接电话的 AI 助手,官方称部署中位时间 32 秒,支持自带 LLM 和完整 API

核心要点速览

  • 无代码生成:用文字描述即可生成语音智能体,官方称部署中位时间 32 秒(厂商口径)
  • 电话能力:可租用号码或自带运营商(BYO SIP)打接电话;托管号码目前只有美国和加拿大本地号,支持热转接和冷转接给人工
  • 可换大脑:默认用平台模型,也可接入自己的 OpenAI 兼容 chat completions 端点,语音识别、合成和打断处理仍由 Fish Audio 负责
  • 定价:每分钟 0.035 美元(原价 0.07 美元,优惠至 2026 年 12 月 31 日),通话每分钟另加 0.01 美元,号码每月 1.20 美元,新用户送 5 美元额度且无需绑卡
  • 测试与监控:支持单轮、多轮和工具调用测试,版本发布与回滚,通话录音、转写和通话后自动分析;平台仍为公开测试版
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Fish Audio Live 3🤖 Fish Agent🌐 Fish Audio

AWS 发布新一代 Bedrock AgentCore 运行时:智能体会话启动最多快 15 倍、2 秒内冷启动,单会话可达 8 vCPU / 32 GB,空闲缩到零,内存占用最多降 68%

11 月 12 日,AWS 发布新一代 Amazon Bedrock AgentCore 运行时(定价页称 Runtime v2)。每个智能体会话仍跑在独立的 Firecracker 微虚拟机里,但官方称启动最多快 15 倍、2 秒内完成且与镜像大小和并发无关,单会话上限提到 8 vCPU、32 GB 内存和 10 GB 容器镜像。会话等待模型或工具返回时内存会被回收,空闲时缩到零,多轮对话型智能体每会话内存最多少用 68%。会话还能把 S3 等存储挂成文件系统,数据不出隔离边界。v2 单价高于 v1,省钱靠按实际用量计费。

AWS 发布新一代 Bedrock AgentCore 运行时:智能体会话启动最多快 15 倍、2 秒内冷启动,单会话可达 8 vCPU / 32 GB,空闲缩到零,内存占用最多降 68%

核心要点速览

  • 官方口径:会话启动最多快 15 倍,冷启动不到 2 秒,与镜像大小和并发量无关,不再需要预热池
  • 单会话资源扩大 4 倍:最高 8 vCPU、32 GB 内存,容器镜像最大 10 GB;microVM 会话最长 8 小时
  • 空闲缩到零、等待期间回收内存,多轮对话型智能体每会话内存最多少用 68%
  • v2 按量单价:CPU 每 vCPU 小时 0.1276 美元、内存每 GB 小时 0.0169 美元,高于 v1 的 0.0895 / 0.00945 美元;承诺基线价 0.0997 / 0.0132 美元
  • 客户口径:Coinbase 冷启动从近 1 分钟降到 5 秒以内,Zuora 单次调用内存约降 60%
阅读全文
关联模型 / 智能体 / 厂商:

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

新加坡时间 11 月 13 日 02:02,Google DeepMind、Google AI 和 Gemini 官方账号同时宣布 Gemini 4 Hydrogen 正式上线,Gemini API 更新日志标注为 GA,模型 ID 是 gemini-4-hydrogen。按官方口径,它在默认 high 思考档位下的 Artificial Analysis 智能指数为 51,高于 Gemini 4 Argon 的 50,新增的 xhigh 档位可到 54;完成任务的速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 得分从 18.2% 提高到 57%。价格在 100 万 token 上下文内统一为输入 1.5 美元、输出 7.5 美元(每百万 token),免费层也能用。它同时成为 Gemini 应用、Google 搜索和 Antigravity 托管智能体的默认模型。昨天站内报道过的 SKU 价目表泄露,今天由官方证实。Cursor 官方随后宣布 Hydrogen 已上线编辑器,默认努力档(high)在 CursorBench 4.0 上为 54.3%,高于 Gemini 3.8 Flash 的 39.6%。

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

核心要点速览

  • 官方口径:AA 智能指数 51(默认 high 档),高于 Gemini 4 Argon 的 50;新增 xhigh 档可达 54
  • 速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 从 18.2% 升到 57%,捏造陈述减少 5 倍以上
  • 定价:每百万 token 输入 1.5 美元、输出 7.5 美元,100 万 token 上下文内不分段加价,免费层可用
  • Antigravity 新功能 Orchestrator 在 Carbon 和 Hydrogen 之间自动切换:Terminal-Bench 4.0 成功率接近纯 Carbon,额度少用 24%,速度快 19%
  • 合作方实测:复杂图、SQL 和数据类企业任务比 3.8 Flash 快 2–2.8 倍,token 用量少 12%–23%
  • Cursor:官方宣布 Hydrogen 已上线编辑器;CursorBench 4.0 默认 High 54.3%(每任务约 5.59 美元),高于 Gemini 3.8 Flash 的 39.6%;Medium 46.7%(约 1.76 美元),Low 27.9%(约 0.28 美元);属第三方模型,不计入套餐包含用量(Cursor 文档、CursorBench)
阅读全文
AD赞助内容

X 热议:Google 尚未官宣的 Gemini 4 Hydrogen 先出现在官方 SKU 价目表,输入每百万 token 1.5 美元、输出 7.5 美元,比 Gemini 4 Carbon 12 月新价便宜 62.5%,社区称已能在 Vertex AI 调通

11 月 12 日下午(新加坡时间),模型追踪账号 AI Tracker Bot(@aitrackerbot)发帖称,在 Vertex AI 全球端点调用 gemini-4-hydrogen 返回了 HTTP 200,模型自称「Gemini 4 Hydrogen,由 Google 构建的大型语言模型」。该帖约 5.8 万浏览、361 赞。稍早 Google AI Studio 负责人 Logan Kilpatrick 只发了一个词「Gemini」,约 47.5 万浏览、846 条回复。随后有人发现 Google Cloud 公开 SKU 页面已列出 Gemini 4 Hydrogen 的计费条目:文本输入每百万 token 1.50 美元、输出 7.50 美元,缓存输入 0.075 美元。我们打开 Google 官方 SKU 页核对,价格一致;但 Gemini API 模型页和定价页仍没有 Hydrogen,Google 也未发布任何公告。讨论焦点是:这是不是 Gemini 4 的 Flash 档,以及价格是否有竞争力。

核心要点速览

  • Google Cloud 官方 SKU 页(Gemini API 服务)已列出 Gemini 4 Hydrogen:文本/图像/音频输入 1.50 美元、文本输出 7.50 美元、缓存输入 0.075 美元(每百万 token,global 区域)
  • 分档价格:Batch 与 Flex 输入 0.75 美元,Batch 输出 3.75 美元,Priority 输入 2.70 美元(约为标准价 1.8 倍)
  • 对比官方定价页:Gemini 4 Carbon 当前 2/10 美元,12 月 1 日起 4/20 美元;Hydrogen 比 12 月新价便宜 62.5%,与 Gemini 3.8 Flash 2027 年 1 月 1 日起的 1.50/7.50 美元相同
  • 「Vertex AI 返回 200、模型自报家门」来自 @aitrackerbot 的说法(约 5.8 万浏览),我们无法独立复现;Google 未公布上下文长度、发布日期或任何跑分
  • Logan Kilpatrick 的一字帖「Gemini」约 47.5 万浏览、5,114 赞,但帖子本身没有提到任何模型名
阅读全文

X 热议:levelsio 用 3 小时把「视频转 3D 房间」上线 Interior AI:上传客厅漫游视频,自建无头 Blender 生成可行走、可改色挪家具的 3D 空间

独立开发者 Pieter Levels(@levelsio)11 月 12 日在 X 上连发三帖:先说 AI 现在已能从一段粗糙的手机视频、几张照片甚至一张平面图生成无头 Blender 3D 场景,这给他做了 4 年、一直基于「照片进、效果图出」图像模型的 Interior AI 打开了新维度;约半小时后放出原型,可以清空房间、挪动或删除家具、给墙面地面天花板任意上色;约 3 小时后宣布功能已对全部用户上线,渲染跑在他自己 VPS 上的无头 Blender。三帖合计约 11.5 万浏览、600+ 赞、250 条回复。讨论集中在处理耗时、自建渲染 vs 调用 3D API、订阅还是按次计费。以下为开发者分享与讨论,功能效果以本人演示为准,未经第三方测评。

X 热议:levelsio 用 3 小时把「视频转 3D 房间」上线 Interior AI:上传客厅漫游视频,自建无头 Blender 生成可行走、可改色挪家具的 3D 空间

核心要点速览

  • 时间线:11 月 12 日 06:15 宣布想法、06:43 放出原型、09:34 宣布对 全部用户 上线(均为新加坡时间),从原型到上线约 3 小时
  • 实现:输入一段客厅漫游视频、几张照片或一张平面图,生成可编辑的 3D 场景,渲染跑在作者自己 VPS 上的 无头 Blender(作者口径,未说明具体用的是哪个模型)
  • 可做的编辑:清空房间、挪动/删除/新增家具、给墙面地面天花板和任意物体换色,并可生成平面图;下一步计划一键切换装修风格
  • 热度:三帖合计约 11.5 万 浏览、600+ 赞、250 条回复、570+ 收藏
  • 作者称 Interior AI 过去 4 年 一直基于「照片进、效果图出」的图像模型,过去 12 个月可用的新技术不多
阅读全文
关联模型 / 智能体 / 厂商:

ElevenLabs 发布 Scribe v3 与 Scribe v3 Live 语音转文字模型:102 种语言词错误率比 v2 降 27%,实时版首次支持说话人分离,API 每小时 0.20/0.22 美元

ElevenLabs 11 月 10 日(新加坡时间 11 日凌晨 02:10)发布两款语音转文字模型:面向录音文件的 Scribe v3 和面向实时流的 Scribe v3 Live。官方口径:Scribe v3 在 FLEURS 102 种语言上词错误率(WER)比 Scribe v2 低 27%,且每种语言都有提升;Scribe v3 Live 的语义 WER 比 Scribe v2 Realtime 低 43%,并首次在实时转写中提供说话人分离和基于上下文的断句检测。两款模型已上线 ElevenAPI,从 v2 切换只需改 model ID;API 定价页列出每音频小时 0.20 美元(v3)和 0.22 美元(v3 Live)。第三方评测方 Voice Arena 用 70+ 小时真实电话录音测试,称 v3 Live 在罗马尼亚语和印度英语里排第一。

ElevenLabs 发布 Scribe v3 与 Scribe v3 Live 语音转文字模型:102 种语言词错误率比 v2 降 27%,实时版首次支持说话人分离,API 每小时 0.20/0.22 美元

核心要点速览

  • 准确率(官方口径):Scribe v3 在 102 种语言上 WER 比 v2 低 27%,德语 -42%、西班牙语 -35%、英语 -23%、泰语 -28%
  • 实时版:Scribe v3 Live 语义 WER 比 v2 Realtime 低 43%、WER 低 31%,希腊语提升 77%,官方称延迟约 150ms
  • 说话人分离:v3 比 v2 少 12% 错误,3 人以上录音少 17%;v3 Live 比次优实时模型少 39%,英语分离错误率 3.1%
  • 价格:API 每音频小时 $0.20(v3)/ $0.22(v3 Live),关键词提示另加 $0.05/小时,转写编辑另加 $0.07/小时
  • 上手:model ID 为 scribe_v3 / scribe_v3_live,关键词提示最多 1000 个术语;企业版提供欧盟、印度、新加坡数据驻留
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Scribe v3⚡ Scribe v3 Live🤖 ElevenAgents🌐 ElevenLabs

OpenAI 推出「Businesses in ChatGPT」Beta:商家可通过 Business Hub 认领并核验资料、查看提及与点击数据,美国电商和在线服务商家可搭建自己的 Business Agent

OpenAI 11 月 10 日推出 Businesses in ChatGPT Beta,面向每周 12 亿 ChatGPT 用户背后的商家。通过 Business Hub,商家可以认领并核验自己的主页,更新信息、上传带价格和库存的商品数据,并查看被提及次数、网站点击和「发现话题」等汇总数据,OpenAI 表示不会把用户对话分享给商家。符合条件的美国电商和在线服务商家还能搭建 Business Agent,在 ChatGPT 里回答顾客关于产品和政策的问题;该对话会单独标注,并可作为 ChatGPT 广告的落地页。

OpenAI 推出「Businesses in ChatGPT」Beta:商家可通过 Business Hub 认领并核验资料、查看提及与点击数据,美国电商和在线服务商家可搭建自己的 Business Agent

核心要点速览

  • 覆盖面:ChatGPT 每周 12 亿用户;凡在 ChatGPT 可用地区的合格商家都能认领主页,认领后显示蓝色认证标记,无需广告账户或 Enterprise 合同(官方公告)
  • 核验方式:电话、企业邮箱、网站域名或 Shopify 等;Shopify 商家可在 Business Hub 或 Shopify 后台直接连接,符合条件的商品已通过 Shopify Catalog 接入 ChatGPT
  • 数据洞察:提供提及次数、网站点击和「发现话题」,全部为汇总数据,达到一定对话量门槛才显示,不共享用户对话或 Business Agent 聊天内容
  • Business Agent:首批仅限美国、有网站的电商和在线服务商家,需符合 Business Agents 政策的行业要求;对话与 ChatGPT 原回答分开并明确标注(帮助文档)
  • 商业化:商家可赞助自己的 Business Agent,并把它作为 ChatGPT Ads 的落地页,赞助位单独标注;OpenAI 表示之后会扩展到更多市场和行业
阅读全文

Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2:降价至每百万 token 输入 8 美元、输出 40 美元,FrontierCode 2.0 拿下 49.1% 刷新已发布模型最高分,1000 个 Agent 30 小时完成费马大定理形式化

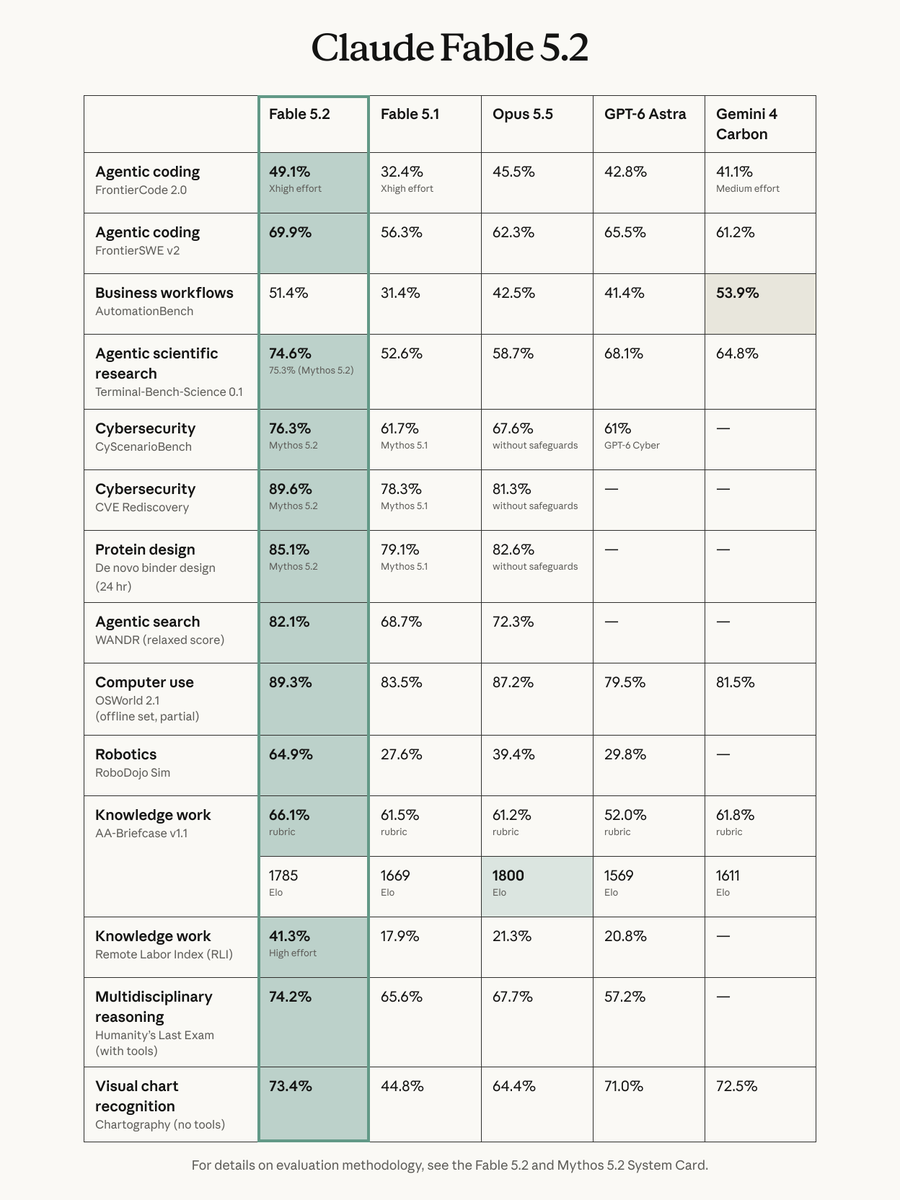
北京时间 11 月 10 日凌晨 2:58,Claude 官方账号发布 Claude Fable 5.2 和 Claude Mythos 5.2。两者是同一个底层模型:Fable 带有网络安全和生物安全防护,面向所有付费用户、Claude Platform 和各大云平台开放;Mythos 去掉部分防护,只通过网络安全与生命科学验证计划提供给审核过的机构。价格从 Fable 5.1 的每百万 token 10/50 美元降到 8/40 美元,输出速度最多快 30%,另有最多提速 2.5 倍的 fast mode(16/80 美元)。官方口径下,Fable 5.2 在 FrontierCode 2.0 上以 Xhigh 档拿到 49.1%,高于 Opus 5.5 的 45.5% 和 GPT-6 Astra 的 42.8%;High 档与 Opus 5.5 最高分持平,单任务成本约为一半。API 模型名为 claude-fable-5-2。

Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2:降价至每百万 token 输入 8 美元、输出 40 美元,FrontierCode 2.0 拿下 49.1% 刷新已发布模型最高分,1000 个 Agent 30 小时完成费马大定理形式化

核心要点速览

  • 定价:$8 / $40 每百万 token(输入/输出),比 Fable 5.1 的 $10 / $50 便宜 20%;fast mode 最多提速 2.5 倍,价格 $16 / $80
  • 编码(官方口径):FrontierCode 2.0 Xhigh 档 49.1%(Opus 5.5 为 45.5%,GPT-6 Astra 为 42.8%);High 档 45.3% 追平 Opus 5.5 最高分,单任务成本约 一半;FrontierSWE v2 69.9%
  • 长程 Agent:1000 个 Fable 5.2 Agent 用 30 小时 完成费马大定理的 Lean 形式化,同样配置下 Opus 5.5 18 小时只完成 26%;一名工程师让它协调 1000 多个子 Agent 连续 8 天写出可在笔记本上启动的原型操作系统
  • 其他跑分(官方口径):RoboDojo Sim 64.9%(Fable 5.1 为 27.6%)、HLE(带工具)74.2%、OSWorld 2.1 89.3%、Remote Labor Index 41.3%;Mythos 5.2 CVE Rediscovery 89.6%
  • 防护:Fable 与 Mythos 是 同一模型;Fable 5.2 的安全分类器误拦截比 5.1 少约 55%;preserved thinking 防蒸馏功能扩展到 所有账号
阅读全文

Meta 发布最小最省的 Muse Ember:每百万 token 输入 0.10 美元、输出 0.50 美元,1M 上下文,AA 智能指数 36 分追平 Claude Haiku 5.5,单任务成本约为其三分之一

北京时间 11 月 10 日凌晨,AI at Meta 官方账号发布 Muse Ember,称其是 Meta 目前最小、最高效的模型,面向 Agent 每天反复执行的工作:工具调用、编码子任务、路由、信息抽取和长文档解析。Muse Ember 支持 1M token 上下文、最多 512K 输出,原生理解文本、图像、音频和视频。定价为每百万 token 输入 0.10 美元、缓存输入 0.004 美元、输出 0.50 美元,已在 Meta Model API(模型名 muse-ember-1.0)和 Muse Code 上线。Artificial Analysis 测得其智能指数 36 分,与 Claude Haiku 5.5(max)持平,但单任务成本约 0.14 美元,只有后者的约三分之一。它是第一个用 Muse Wonder Full 训练出来的模型,权重不开放。

Meta 发布最小最省的 Muse Ember:每百万 token 输入 0.10 美元、输出 0.50 美元,1M 上下文,AA 智能指数 36 分追平 Claude Haiku 5.5,单任务成本约为其三分之一

核心要点速览

  • 定位:Meta 最小、最高效的模型,专做 Agent 的高频小任务(工具调用、编码子任务、路由、抽取、长文档解析);官方建议「Muse Wonder 负责规划,Muse Ember 负责跑量」
  • 规格:1M 上下文、最多 512K 输出,原生支持 文本/图像/音频/视频 输入,支持 Responses API
  • 定价:输入 $0.10、缓存输入 $0.004、输出 $0.50 / 百万 token;输入价约为 Muse Spark 1.3($1.25)的 1/12
  • 跑分(Artificial Analysis):智能指数 36,与 Claude Haiku 5.5(max)持平,单任务成本 $0.14 vs $0.41;Coding Agent Index 46(Haiku 5.5 在 Claude Code 中为 37,GPT-6 Luna 在 Codex 中为 31),但 FrontierCode 2.0 27.2% 落后 Haiku 的 34.9%
  • 短板:AA-Omniscience 知识准确率仅 21.1%,主要因为它拒答 64% 的问题,幻觉率因此只有 17.4%;不开放权重,只能通过 Meta Model API 和 Muse Code 使用
阅读全文
AD赞助内容

谷歌发布第八代 TPU 新成员 TPU 8i Max 与 TPU 8tx:8i Max 双芯封装,算力、SRAM 和 HBM 带宽翻倍;8tx 主打机密推理,同步开源 TPU Sync

11 月 9 日,Google Cloud 官方账号和 Google AI 与基础设施 SVP Amin Vahdat 宣布第八代 TPU 新增两套系统。TPU 8i Max 把两颗 TPU 8i 芯片封装在一起,官方称算力、SRAM 和 HBM 带宽都是 TPU 8i 的 2 倍,面向超长上下文和最高机架算力密度。TPU 8tx 与 TPU 8t 同一颗芯片,搭配第 5 代 AMD EPYC 主机,在硬件层保护运行中的数据和模型权重,官方称延迟比 TPU 8t 低最多 2 倍、性能损失接近零。加上 4 月发布的 8t、8i,这是谷歌第一次在一年内推出 4 套 TPU 系统。软件方面,谷歌开源 TPU Sync(官方称 KV 传输延迟和首 token 时间降低 90% 以上),推出 Agent Compute Engine 和预览版 TPU Agent 套件(可接入 Claude Code、Cursor、Antigravity),Cloud Pathways 和 GKE 动态切片正式 GA。官方未公布上市时间和价格。

谷歌发布第八代 TPU 新成员 TPU 8i Max 与 TPU 8tx:8i Max 双芯封装,算力、SRAM 和 HBM 带宽翻倍;8tx 主打机密推理,同步开源 TPU Sync

核心要点速览

  • 产品线:第八代 TPU 现有 4 套系统:8t(训练)、8i(低延迟推理)、8tx(机密计算)、8i Max(超长上下文),谷歌称是首次一年内推出 4 套 TPU 系统
  • TPU 8i Max:两颗 8i 芯片合封,官方口径算力、SRAM、HBM 带宽均为 8i 的 2 倍,同样机架占地放下 2 倍硅片
  • TPU 8tx:与 8t 同芯片,配 第 5 代 AMD EPYC 主机,数据和权重在使用中也受硬件保护;官方称延迟比 8t 最多低 2 倍,性能损失接近零
  • 软件:开源 TPU Sync(官方称 KV 传输延迟与 TTFT 降 90% 以上);GKE 动态切片 GA,作业启动最多快 5 倍、故障恢复最多快 4.5 倍
  • 开发者:预览版开源 TPU Agent 套件可接入 Claude Code、Cursor、Antigravity;TPU 客户已近 100 家;上市时间与价格官方未公布
阅读全文

Vercel AI Gateway 上线 DeepSeek V4.1 Flash 1017 Ultrafast:厂商口径逾 1000 tokens/s,经 Fireworks 加速端点公测

Vercel 于 2026-11-07 发布更新日志(作者 Jerilyn Zheng、Zachary Chen),宣布 DeepSeek V4.1 Flash 1017 Ultrafast 经 Fireworks 加速无服务器端点接入 AI Gateway;官方开发者账号 @vercel_dev 在 17:25 UTC 发帖。厂商口径称生成速度逾 1000 tokens/s,服务的是 2026-10-17 的 V4.1 Flash 更新,而非新的基础模型权重。型号页列出上下文窗口 1,048,576 Token,定价为输入 $2.40 / 百万 Token、输出 $9.60 / 百万 Token;公开预览无 waitroom、无会话时限。型号 ID 为 deepseek/deepseek-v4.1-flash-1017-ultrafast,可通过 AI SDK、OpenAI 兼容接口,以及 Claude Code / Codex / Cursor 的 npx vercel ai-gateway setup 调用。

Vercel AI Gateway 上线 DeepSeek V4.1 Flash 1017 Ultrafast:厂商口径逾 1000 tokens/s,经 Fireworks 加速端点公测

核心要点速览

  • 发布:Vercel 更新日志日期为 2026-11-07,作者 Jerilyn Zheng、Zachary Chen;@vercel_dev 于 17:25 UTC 发帖,抓取时约 909 赞、390 收藏、约 9.8 万次展示
  • 型号:deepseek/deepseek-v4.1-flash-1017-ultrafast,服务 2026-10-17 的 V4.1 Flash 更新,走 Fireworks 加速无服务器端点,不是新的基础模型权重
  • 速度(厂商口径):逾 1000 tokens/s;型号页列出上下文窗口和最大输出均为 1,048,576 Token;公开预览无 waitroom、无会话时限
  • 定价(Vercel 型号页):输入 $2.40 / 百万 Token,输出 $9.60 / 百万 Token;更新日志称 AI Gateway 按提供商价格、不加价,BYOK 推理也不收平台费
  • 接入:AI SDK 或 base_url https://ai-gateway.vercel.sh/v1;Claude Code / Codex / Cursor 可用 npx vercel ai-gateway setup;fx 可用 /model deepseek/deepseek-v4.1-flash-1017-ultrafast
阅读全文

Kimi K3.1 Pro 高速版上架 Amazon Bedrock:Global 定价 $4/$20 与月之暗面官方持平,Flex 档再打 5 折

AWS 于 2026-11-06 宣布 Moonshot AI 的 Kimi K3.1 Pro(Highspeed 高速版)上架 Amazon Bedrock,通过跨区域推理覆盖所有 Bedrock 区域,主打编码与文档处理类 Agent。官方模型卡显示 Global CRIS 每百万 Token 输入 $4、输出 $20、缓存读 $0.20,与 Kimi 官方高速版同价;US/印度区 +10%,Priority 档 1.75 倍、Flex 档 0.5 倍。

核心要点速览

  • 定价(AWS 官方模型卡):Global CRIS 输入 $4 / 输出 $20 / 缓存读 $0.20 / 缓存写 $5(每百万 Token)
  • US 与印度地理路由为 $4.40 / $22,比 Global 贵 10%
  • Priority 档按 1.75 倍计费,Flex 档 0.5 倍,即 Flex 约 $2 / $10,与 Kimi 官方标准版同价
  • 模型 ID moonshotai.kimi-k3.1,1M 上下文,支持显式 Prompt 缓存、工具调用、结构化输出与 Guardrails
  • 这是 Kimi K3 九月上架 Bedrock 之后,月之暗面旗舰第二次进入 AWS 托管目录
阅读全文
关联模型 / 智能体 / 厂商:

Microsoft Foundry 联手 fal 公测上线 Kling / LTX / MiniMax 视频模型:Azure 一等服务,附官方秒级定价

2026-11-05 Microsoft 与 fal 宣布在 Foundry 公测接入 Kling v3 Pro、LTX-2.5 Fast/Pro、MiniMax H3 Max/Turbo;@Azure 于 11-06 转发。厂商称美国托管且为首个美国 Kling 端点,并公布按生成秒计价表;更多模型与定价页更新仍待数周内。

Microsoft Foundry 联手 fal 公测上线 Kling / LTX / MiniMax 视频模型:Azure 一等服务,附官方秒级定价

核心要点速览

  • 来源:Microsoft Tech Community 博文(2026-11-05)+ @Azure 2026-11-06 转发
  • 组合:公测 Kling v3 Pro、LTX-2.5 Fast/Pro、MiniMax H3 Max/Turbo,经 fal 以 Azure 一等服务接入 Foundry
  • 托管:厂商称美国托管,并为首个美国托管 Kling 端点(仍需核对各模型数据处理条款)
  • 定价(官方,美元/生成秒):H3 Max 1080p $0.16;Turbo $0.08;LTX Fast $0.13;LTX Pro $0.17;Kling 音频关/开/声控约 $0.1232/$0.1848/$0.2156
  • 状态:公开预览;更多模型与 Azure 定价页列入计划中的数周内,未给 GA 日期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kling v3 Pro⚡ LTX-2.5⚡ MiniMax H3 Max🌐 Microsoft Azure AI🌐 Fal

Thinking Machines 发布 Inkling 2 Small:594B/17B MoE、厂商口径 AA Intelligence Index 约 31,Tinker 可推理与微调,权重拟下周 Apache 2.0 开源

Thinking Machines Lab 于 11 月 5 日发布第二代首款模型 Inkling 2 Small:594B 总参 / 17B 激活 MoE,支持图像输入与可变 thinking effort。官方博客称 Artificial Analysis Intelligence Index 约 31,编码、视觉与知识工作相对上一代明显提升。现可在 Tinker 上推理与微调(闭源权重);完成外部安全测试后拟以 Apache 2.0 释出全量权重。Tinker 标价约 $0.30/$1.00 每百万 input/output token(64K)。

Thinking Machines 发布 Inkling 2 Small:594B/17B MoE、厂商口径 AA Intelligence Index 约 31,Tinker 可推理与微调,权重拟下周 Apache 2.0 开源

核心要点速览

  • 规格(官方):594B 总参 / 17B 激活 MoE;Hybrid + Vision;可变 effort;不支持音频(相对上一代)
  • 跑分(厂商口径):AA Intelligence Index 约 31;FrontierCode v2.0 约 25.4%;DeepSWE v1.1 约 72.1%;DesignArena Website Elo 约 1340
  • 供应:今日起 Tinker Playground / 微调与采样可用;闭源;拟下周安全测试后 Apache 2.0 开源权重
  • 定价(Tinker 文档):Prefill $0.30 / Sample $1.00 / Train $1.50 每百万 token(64K);缓存 Prefill $0.03
  • 训练要点(官方):统一 RL 约 1075 步、1700 万+ rollout;早期 checkpoint 曾以 Fledge-Alpha 名在 OpenCode 实测
阅读全文
关联模型 / 智能体 / 厂商: