
AI 编程实时动态与要闻

Deepnote 发布 Agent Initiative Benchmark:测 12 个前沿模型做「主动型智能体」,GPT-6 Astra 以 8.97 分居首,GPT-6.1 Sol 每任务仅 0.11 美元排第二

数据笔记本公司 Deepnote 开源 Agent Initiative Benchmark v1.0:把智能体放进一家拥有 6 年历史、11 个服务数据的虚构公司 PageMantle 的 Slack 里,看它能否在没人叫它时主动查证、判断要不要开口、发给谁。50 个场景测 12 个模型,GPT-6 Astra 8.97 分第一,GPT-6.1 Sol 8.65 分第二,Claude Fable 5.2 8.17 分第三。
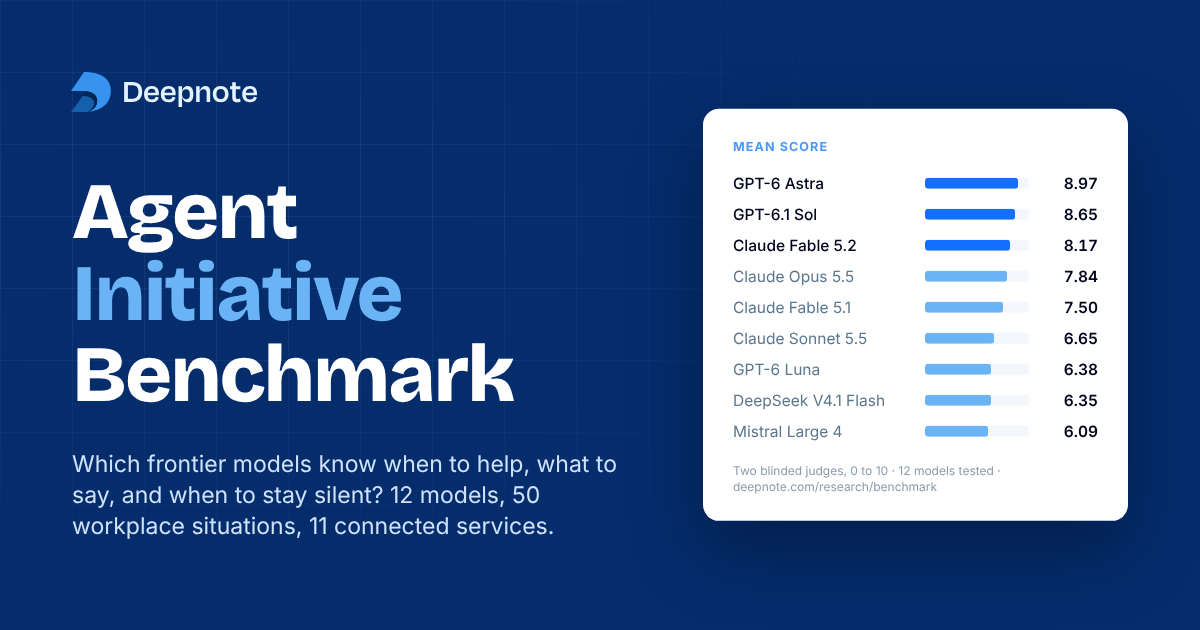
Deepnote 发布 Agent Initiative Benchmark:测 12 个前沿模型做「主动型智能体」,GPT-6 Astra 以 8.97 分居首,GPT-6.1 Sol 每任务仅 0.11 美元排第二

核心要点速览

  • 排名前三:GPT-6 Astra 8.97、GPT-6.1 Sol 8.65、Claude Fable 5.2 8.17;Gemini 4 Argon 5.60、Grok 4.7 4.51 垫底(官方结果页)
  • 最贵不等于最好:Sol 每任务 0.11 美元,Fable 5.2 为 1.87 美元;GPT-6 Luna(0.007 美元)与 Claude Fable 5.1(3.02 美元)价差约 430 倍,分数只差 1.1 分
  • 模型擅长帮忙、不擅长闭嘴:该开口时约 9/10 会发消息,该沉默时只有约 6/10 忍住;多说一次的成本约是沉默的 1.8 倍
  • 工具调用最多的两个模型得分最低:Gemini 4 Argon 平均 35 次、Grok 4.7 平均 36 次,约一半需要帮忙的任务没给出答案
  • 代码与任务 Apache 2.0、PageMantle 数据集 CC BY 4.0,已放在 GitHub 与 Hugging Face
阅读全文

不叫自到还会读心?KAIST 等确立主动智能体 3T 原则:开源 Proactivity-Gym,揭露过度干预引发信任崩塌

当前绝大多数大模型智能体仍处于“被动响应(Reactive)”阶段——必须等待用户下达明确指令才开始执行。随着算力成本降低与持续驻留系统的普及,能够利用空闲计算资源、在用户开口前主动预测需求并执行辅助的“主动智能体(Proactive Agents)”正迅速成为人机协作的下一个竞争焦点。然而,主动并不等同于擅作主张;即使智能体自主执行的任务结果百分之百正确,一旦介入时机不当或打扰用户当前心流,就会带来极大的审核认知负担,甚至引发毁灭性的用户信任崩塌。韩国科学技术院(KAIST)与明尼苏达大学团队在最新研究(arXiv:2609.37267)中,首次系统性奠定了主动智能体的理论基石,确立了任务能力(Task Capability)、时间分配(Temporal Allocation)与用户信任(Trust)三大联合核心原则(3T 原则)。团队同步开源了多天状态交互评测基准 PROACTIVITY-GYM,涵盖状态化虚拟环境与角色化模拟用户。在一项包含 30 名真实人类受试者的严格实验中,研究揭示:人类用户在遭遇非预期打扰时信任度会断崖式暴跌,但绝大多数用户高度欢迎智能体在人类睡眠或休息时段(Sleep-Time)开展主动异步辅助。

核心要点速览

  • 奠定主动智能体(Proactive Agents)理论基础,提出任务能力、时间分配与用户信任构成的 3T 联合核心原则
  • 开源多日跨会话仿真评测靶场 PROACTIVITY-GYM,涵盖状态化虚拟环境与多重人格模拟人类测试器
  • 30 人纵向实验揭示时机错位的主动干预会导致信任雪崩,实证夜间静默算力(Sleep-Time Compute)是用户满意度最高的主动模式
阅读全文
关联模型 / 智能体 / 厂商: