AI 编程实时动态与要闻

LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次

LMSYS 发布技术长文,介绍为 Meta 开源模型 Muse Spark Open 从零手写的 megakernel(CUDA C++ 与 PTX,约 8000 行):每个解码层只启动一次内核,把计算、显存加载和跨卡通信重叠起来。在 8 张 GB300 上,单请求解码速度从 SGLang 基线的 517 tok/s 提到 1,109 tok/s,约 2.1 倍;每个解码步从 12.9 毫秒降到 5.9 毫秒。代码以 SGLang 插件形式开源在 facebookresearch/sgl-muse-mega(MIT)。目前只支持 batch 1,属于实验功能,换来的是低延迟,不是更便宜的 token。
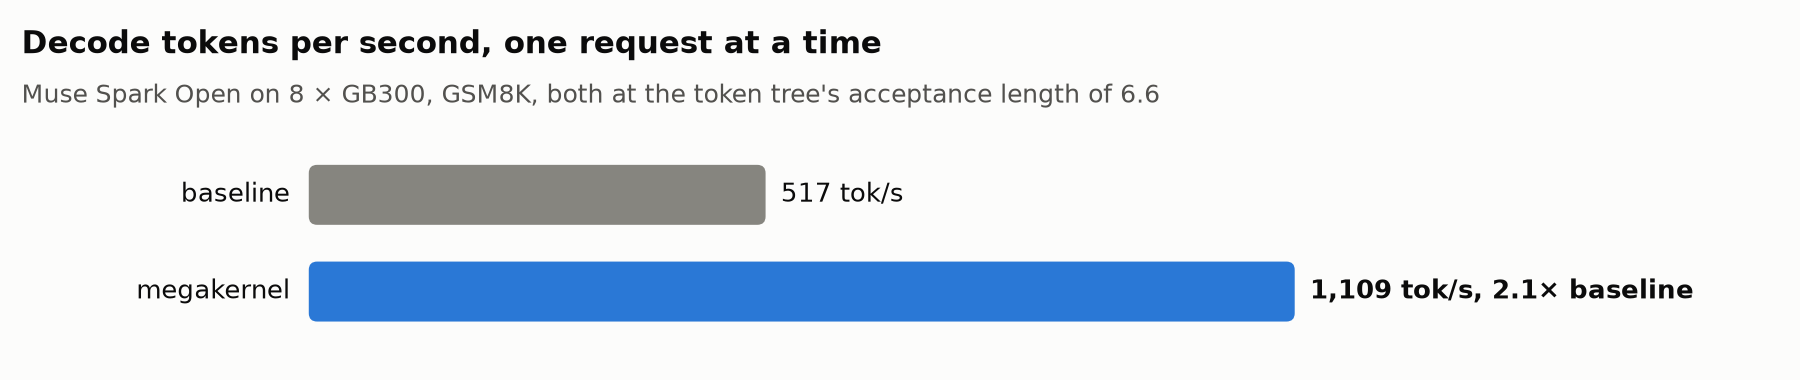
LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次

核心要点速览

  • 速度翻倍:8×GB300、TP8、GSM8K 单请求,解码 517 → 1,109 tok/s,约 2.1 倍(同一草稿模型、同一接受长度)
  • 内核启动大减:每个解码步从约 1,450 次内核启动降到 97 次,每层只启动一次
  • 单步耗时:12.9 毫秒 → 5.9 毫秒;其中验证 10.9 → 5.3 毫秒,草稿 1.16 毫秒 → 0.44 毫秒(草稿从 175 次启动降到 8 次)
  • 投机解码:DFlash V2 草稿每步猜 15 个 token,验证 16 个、平均接受 6.6 个;小米 MiMo-V2.5-Pro 为验证 8 个、接受 6.3 个
  • 适用范围:仅 batch 1,其他请求回退到普通 SGLang;8 张顶级 GPU 只服务一个用户,卖的是延迟而不是成本
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark Open⚡ MiMo-V2.5-Pro🌐 LMSYS🌐 SGLang🌐 Meta🌐 NVIDIA

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

11 月 12 日 SGLang Summit 期间,SGLang 团队与 AWS Annapurna Labs 宣布 SGLang-Neuron v0.1.0 开源并进入公开预览。它是 SGLang 的树外插件,设置 SGLANG_PLATFORM=neuron 即可在 Trainium 上用同样的服务器和 API 推理、生成 RL rollout,底层走 TorchNeuron 原生 PyTorch。AWS 同步上架 Deep Learning Container 镜像。大模型目前跑在 Trn3,扩散模型跑在 trn2.48xlarge。

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

核心要点速览

  • 开源与许可:GitHub sgl-project/sglang-neuron,Apache 2.0,v0.1.0 为公开预览,功能、API 和支持模型后续可能变化
  • 零改动接入:SGLang 本体不改,插件通过 entry points 注册 neuron 平台,固定在上游 commit 43881a7;镜像 tag 为 v0.1.0-neuron-py314-sdk-2.33.0
  • 大模型清单:GPT-OSS-120B、Qwen3 系列、Qwen3.5-397B-A17B、GLM-5.2(1M 上下文)、Kimi-K3(1 个 prefill 节点 + 2 个 decode 节点)等 8 种架构
  • 关键机制:全异步运行时、单次 NKI 内核调用跑完整个解码步的 giga-kernel、基于 NIXL + EFA 的 PD 分离、HiCache 主机内存前缀缓存
  • 扩散模型:FLUX.1-dev、FLUX.3-Action、MiniMax-H3、Wan2.2 A14B、LingBot-World-V2 跑在 Trainium2 上
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kimi K3⚡ GLM-5.2⚡ GPT-OSS-120B⚡ Qwen3.5-397B-A17B🌐 SGLang🌐 AWS🌐 RadixArk

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

11 月 12 日,开源推理引擎 SGLang 背后的非营利组织 LMSYS Org 在旧金山首届 SGLang 峰会开幕主题演讲上宣布成立 SGLang 联盟。创始成员包括NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal 和 RadixArk,它们将与 SGLang 维护者一起参与路线图制定,重点方向是前沿模型支持、推理与多模态负载、分布式推理和跨硬件优化。每家成员指派一名技术代表,每年参加两次路线图会议;技术决策和代码合入权仍归 SGLang 维护者,项目继续对整个社区开放。

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

核心要点速览

  • 创始成员 8 家:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk(SGLang 核心作者创办的公司),覆盖 GPU/CPU 芯片、云和推理服务商
  • 治理方式:每家指派一名技术代表,每年两次路线图会议,期间可组建工作组并公开进展;技术决策与代码合入仍由 SGLang 维护者负责
  • 四个重点方向:前沿模型支持、推理与多模态负载、分布式推理、跨硬件平台优化
  • 规模(官方口径):SGLang 跑在数十万张 GPU 上,用户包括 Meta、微软、Google、亚马逊、Thinking Machines Lab、Cloudflare、Reflection、Modal
  • 背景:LMSYS 引用德勤数据称,2026 年推理约占全部 AI 算力的三分之二,2025 年约为一半;首届峰会 11 月 12–13 日在旧金山 Fort Mason 举行,100 多位演讲者
阅读全文

Thinking Machines 兑现承诺开源 Inkling 2 Small:594B 总参 / 17B 激活 MoE 权重上架 Hugging Face,Apache 2.0 可商用,原生 NVFP4 两张 B300 即可跑,SGLang、vLLM、Cloudflare 等首日支持

11 月 12 日(北京时间 13 日凌晨 4 点 50 分),Thinking Machines Lab 宣布 Inkling 2 Small 权重以 Apache 2.0 许可证在 Hugging Face 开放下载,兑现了 11 月 5 日发布闭源版时「完成安全测试后开源」的承诺。模型为 594B 总参、17B 激活的多模态 MoE,支持图文输入和 100 万 token 上下文;主权重是训练时就采用的原生 NVFP4,至少需要 500GB 显存(2 张 B300 或 4 张 H200),另有 MXFP8 版本。SGLang、vLLM、Unsloth 给出本地部署方案,Cloudflare Workers AI、OpenRouter、Together、Nebius 等首日上线,每百万 token 输入 0.30 美元、输出 1.00 美元。

Thinking Machines 兑现承诺开源 Inkling 2 Small:594B 总参 / 17B 激活 MoE 权重上架 Hugging Face,Apache 2.0 可商用,原生 NVFP4 两张 B300 即可跑,SGLang、vLLM、Cloudflare 等首日支持

核心要点速览

  • 许可与仓库:Hugging Face thinkingmachines/Inkling-2-Small(NVFP4 主权重)与 Inkling-2-Small-MXFP8,Apache 2.0,可商用、可微调、可集成到第三方产品
  • 规格(模型卡):48 层解码器,384 个专家每 token 路由 8 个,局部与全局注意力混合;594B 总参 / 17B 激活;图文输入、文本输出,上下文最长 100 万 token
  • 硬件门槛:NVFP4 至少 500GB 聚合显存(2×B300 或 4×H200);MXFP8 至少 800GB(4×B300 或 8×H200),官方称 MXFP8 评测只高 1–2 个百分点,推荐用 NVFP4
  • 跑分(厂商口径,模型卡):AA Index v5.0 30.6、DeepSWE v1.1 72.1%、FrontierCode v2.0 25.4%、BrowseComp 90.2%;DeepSeek-V4.1-Flash 在 AA Index(32.6)、DeepSWE(77.0%)上仍更高
  • 首日生态:SGLang、vLLM、TokenSpeed、Unsloth 本地推理,Miles、SkyRL、Snowflake Cortex 后训练;Cloudflare Workers AI 与 OpenRouter 均为输入 0.30 / 输出 1.00 美元每百万 token,OpenRouter 另有限免版本
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Zyphra 开源语音合成模型 ZONOS3-Mini:800M 总参、100M 激活的 MoE,Apache 2.0 协议,手机浏览器内实时运行,可逐词控制语气与声线克隆

Zyphra 11 月 9 日发布开源语音合成(TTS)模型 ZONOS3-Mini,权重以 Apache 2.0 协议上架 Hugging Face。它是稀疏 MoE 模型,总参数 8 亿、每 token 激活约 1 亿,用 112 张 H100 训练 2.5 天。官方口径:在 Pixel 9 浏览器里首段音频延迟低于 570 毫秒,M3 MacBook Air 上低于 150 毫秒;在自建的 ZTTS2-Eval(35 种语言朗读 + 20 种语言真实录音)能力指数上排名开源模型第一,领先 Fish S2 Pro 和 MOSS TTS v1.5。支持声线克隆、年龄/口音/性别调节和逐词语气控制,提供 WebGPU、SGLang、vLLM、GGML、MLX 等运行时。

Zyphra 开源语音合成模型 ZONOS3-Mini:800M 总参、100M 激活的 MoE,Apache 2.0 协议,手机浏览器内实时运行,可逐词控制语气与声线克隆

核心要点速览

  • 规模:800M 总参、约 100M 激活(64 专家、top-2 路由),上一代 ZONOS2 为 8B,Apache 2.0 开放权重
  • 速度(官方口径):Pixel 9 浏览器首段音频 <570 ms,M3 MacBook Air <150 ms;单张 H100 在 8 并发下中位首音 80 ms,峰值每秒生成 457 秒音频
  • 自研 ZAC-1 编解码器帧率 15 Hz(原 DAC 为 86 Hz),同等数据下词错率降低约 10 倍;单次最多生成 10 分钟 44.1 kHz 音频
  • 评测:ZTTS2-Eval 覆盖 35 种语言朗读 + 20 种语言真实录音,420 项能力指数中开源模型排名第一,其次为 Fish S2 Pro 与 MOSS TTS v1.5(自建基准,暂无第三方复现)
  • 上手:浏览器 WebGPU 免安装试用,或 sgl-omni serve --model-path Zyphra/ZONOS3-Mini 起 OpenAI 兼容 /v1/audio/speech 接口
阅读全文
关联模型 / 智能体 / 厂商:
⚡ ZONOS3-Mini🌐 Zyphra

美团开源 LongCat-2.5 权重:1.6T 总参数、约 48B 激活的原生多模态 MoE,MIT 协议上架 Hugging Face,同步放出 W4A4 量化版

11 月 9 日晚,美团 LongCat 官方账号宣布开源 LongCat-2.5 权重,采用 MIT 协议,已上架 Hugging Face。LongCat-2.5 是 11 月 2 日以 API 形式发布的原生多模态 MoE 模型,总参数 1.6 万亿、每 token 激活约 480 亿,主打长程 Agent 任务、智能体编程、创意设计和 3D 任务。这次同时放出 BF16 主模型(仓库约 3.56TB)和 W4A4 量化版(约 1.34TB)。模型卡显示目前只提供 NPU 部署指南(基于 SGLang-FluentLLM),支持思考与非思考两种模式。官方跑分中 Terminal Bench v2.1 为 88.4、BrowseComp 为 91.9,LongCat 自己的分数为内部测试,仅供参考。

美团开源 LongCat-2.5 权重:1.6T 总参数、约 48B 激活的原生多模态 MoE,MIT 协议上架 Hugging Face,同步放出 W4A4 量化版

核心要点速览

  • 开源:LongCat-2.5 权重以 MIT 协议上架 Hugging Face(主模型、W4A4 量化版),距 11 月 2 日 API 发布 一周
  • 规模:1.6T 总参数、约 48B 激活的原生多模态 MoE;BF16 仓库约 3.56TB,W4A4 仓库约 1.34TB
  • 部署:模型卡目前只给出 NPU 部署指南(SGLang-FluentLLM 分支),训练和推理都在国产 AI 加速器上完成;普通显卡本地运行不现实
  • 跑分(官方、LongCat 分数为内部测试):Terminal Bench v2.1 88.4(Claude Opus 5 为 89.1)、BrowseComp 91.9、AutomationBench 51.8、DeepSWE v1.1 64.6
  • 用法:混合模型,支持 思考模式(建议保留全部推理内容)和 非思考模式(更省 token),兼容 OpenAI 风格调用和工具调用
阅读全文
关联模型 / 智能体 / 厂商:

腾讯开源 DSpine:Qwen3.8-27B 专用并行草稿模型,厂商口径 SWE-bench Pro 回放吞吐约 3.19 倍、全面高于 DFlash2

腾讯于 2026-11-07 14:20 UTC 在 Hugging Face 发布 tencent/Qwen3.8-27B-DSpine-b16:一个约 2B 参数、5 层的投机解码草稿模型,块大小 16、8,192 Token 滑动窗口,Apache 2.0 许可,配套代码在 GitHub Tencent/DSpine,论文为 arXiv 2609.36173。模型卡(厂商口径)显示,在 SGLang 0.5.22、BF16、并发 8 的条件下,SWE-bench Pro 回放在 xhigh 推理下输出吞吐从约 248 提升到约 791 tokens/s(约 3.19 倍),官方 DFlash2 为 2.87 倍;10 组 Agent 场景接受长度全部高于 DFlash2。注意 DSpine 每块草拟 16 个 Token,DFlash2 为 8 个,配置并不完全相同,结果尚无第三方复现。

腾讯开源 DSpine:Qwen3.8-27B 专用并行草稿模型,厂商口径 SWE-bench Pro 回放吞吐约 3.19 倍、全面高于 DFlash2

核心要点速览

  • 发布:腾讯 2026-11-07 14:20 UTC 上传 tencent/Qwen3.8-27B-DSpine-b16,约 20.3 亿参数(BF16 约 4GB),5 层、块大小 16、8,192 Token 滑动窗口,Apache 2.0
  • 吞吐(厂商口径):SWE-bench Pro 回放 xhigh 推理从约 248 到约 791 tokens/s,约 3.19 倍;DFlash2 为 2.87 倍
  • 最高加速(厂商口径):WorkBuddy Office 在 low 推理下约 3.84 倍(DFlash2 为 3.17 倍)
  • 接受长度(厂商口径):SWE-bench Pro xhigh 为 4.77 对 DFlash2 的 4.00;GSM8K 贪心解码 7.20 对 5.69
  • 注意:DSpine 草拟块 16、DFlash2 为 8,测试条件不完全对等;目前只有模型卡数据,尚无第三方复现
阅读全文

月之暗面正式开放 Kimi K3.1 Pro 权重:2.8T 总参 / 104B 激活 MoE 上架 Hugging Face,MXFP4 量化约 1.56TB,自定义许可证限制大型 MaaS 商用

Kimi 官方账号 @Kimi_Moonshot 于 11 月 4 日 16:00(UTC)宣布开放 Kimi K3.1 Pro 模型权重,仓库 moonshotai/Kimi-K3.1-Pro 已公开、无需申请。模型卡显示它是 2.8T 总参、104B 激活的原生多模态 MoE,1M 上下文,权重以 MXFP4(量化感知训练)发布,仓库约 1.56TB;官方推荐 vLLM、SGLang 和 TokenSpeed 部署。许可证允许自由使用和修改,但年收入超 2000 万美元的 MaaS 业务需另签协议。

月之暗面正式开放 Kimi K3.1 Pro 权重:2.8T 总参 / 104B 激活 MoE 上架 Hugging Face,MXFP4 量化约 1.56TB,自定义许可证限制大型 MaaS 商用

核心要点速览

  • 架构:93 层(1 层稠密),69 层 KDA + 24 层 Gated DSA 注意力,896 个专家每 token 选 16 个外加 2 个共享专家,视觉编码器 MoonViT-V2(401M)。
  • 相比 K3,把全注意力的 Gated MLA 层换成了 Gated DeepSeek Sparse Attention,用于更高效的长上下文。
  • 模型卡厂商口径:Terminal-Bench 4.0 65.7(Opus 5.5 66.4)、SWE Marathon v1.1 51.7(Opus 5.5 46.3)、HLE-Full 带工具 70.0、BrowseComp 92.1;ProgramBench 31.5 明显落后 Opus 5.5 的 65.0。
  • 许可证:对外提供 MaaS 且连续 12 个月收入超 2000 万美元需与月之暗面另签协议;月活超 1 亿或月收入超 2000 万美元的产品须醒目标注「Kimi K3.1-Pro」,内部使用不受这两条限制。
阅读全文

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

面壁智能旗下 OpenBMB 10 月 27 日开源 MiniCPM-OCR 套件,含两款模型:1.3B 参数的文档解析模型 MiniCPM-OCR 1.0(Real5-OmniDocBench 93.68、OCRBench v2 54.7,官方口径),以及 2B 参数的 OCR 质量判定模型 MiniCPM-OCR Jev,可给任意 OCR 解析结果按区域打 0–1 分、标出需人工复核的内容。代码和权重均为 Apache 2.0,首发即支持 vLLM、SGLang、llama.cpp、Ollama 及多家芯片平台。

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

核心要点速览

  • 解析模型 MiniCPM-OCR 1.0 仅 1.3B 参数:Real5-OmniDocBench 93.68、OCRBench v2 54.7(官方口径,均称 SOTA)
  • 判定模型 MiniCPM-OCR Jev 2B 参数:JevOCRBench AUROC 93.6,高于 JEV-35B-A3B 的 90.1,接近 Qwen3.5-397B-A17B 的 93.8(官方口径)
  • Jev 与解析器无关:对 MiniCPM-OCR、GLM-OCR、PaddleOCR-VL-1.6、Xiaomi-OCR-0 的结果 AUROC 都在 91.9–93.4
  • 吞吐约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍;配合 SDK 并发最高约 128 页/分钟(官方口径)
  • GitHub 代码与权重全部 Apache 2.0,提供 GGUF/AWQ/GPTQ 量化版与 SKILL.md
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniCPM-OCR 1.0⚡ MiniCPM-OCR Jev⚡ PaddleOCR-VL-1.6⚡ MinerU2.5 Pro⚡ Qwen3.5-397B-A17B🌐 OpenBMB🌐 ModelBest🌐 Intel🌐 NVIDIA🌐 Arm

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

扩散智能 DiffuSpace(成员来自推出 Dream 7B 的港大 NLP 实验室)10 月 28 日发布首个模型 Clover-35B-A3B-Preview:基于 Qwen3.6-35B-A3B 初始化的 MoE 扩散语言模型,总参 35B、激活约 3B、128K 上下文,按块并行去噪生成。官方口径下 SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、GPQA Diamond 83.8,单张 GB300 上 Agent 场景生成速度 680 tokens/s。权重 Apache 2.0,已上 Hugging Face、ModelScope 和 GitHub,支持 SGLang 与 llama.cpp。

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

核心要点速览

  • 35B 总参、约 3B 激活的 MoE 扩散模型,由 Qwen3.6-35B-A3B 初始化,128K 上下文,支持思考模式
  • 官方称六项 Agent 评测全部第一:SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3,超过 LLaDA2.2 flash、Mercury 2.5 和 Qwen3.6-35B-A3B
  • 速度(官方口径):单张 GB300、BF16、batch=1 下 Agent 场景 680 tokens/s;单张 H200 上 515 tokens/s,高于 DFlash2 加速 Qwen 的 365 tokens/s
  • INT4 量化后可在 16GB 显存的 RTX 5070 Ti 上运行,MATH-500 生成速度 101.8 tokens/s
  • Hugging Face 权重 Apache 2.0,BF16 约 69GB,官方推荐用 SGLang 部署
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Clover-35B-A3B-Preview⚡ Qwen3.6-35B-A3B⚡ Dream 7B⚡ LLaDA2.2 flash⚡ Mercury 2.5🌐 DiffuSpace🌐 HKU NLP🌐 Alibaba Qwen🌐 NVIDIA
AD赞助内容

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

Cloudflare 10 月 26 日在官方博客发布事故报告:8 月 27 日至 9 月 9 日,Workers AI 上的 GLM-5.3(@cf/zai-org/glm-5.3)对超过 681,280 token 的长提示,有 155 条回复混入了其他用户刚发过的请求内容,且都返回 HTTP 200。原因是 prefill 节点 KV 缓存池小于 1,048,576 token 的上下文窗口,叠加 SGLang 在 prefill/decode 分离模式下处理超长请求的漏洞。Cloudflare 称未发现恶意利用,已修复并建议运营方升级到 SGLang v0.5.22 或更高版本。

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

核心要点速览

  • 影响范围:2026-08-27 至 09-09 共 155 条回复受影响,均为超过 681,280 token 的提示;Cloudflare 确认 Workers AI 其他模型未受影响
  • 根因 1:GLM-5.3 上下文 1,048,576 token,但 prefill KV 池只有 681,280 token;修复后池容量约 204 万 token,约为上下文的 2 倍
  • 根因 2:SGLang 把超长请求标记为拒绝并换成 1 token 占位,却没中止,decode 节点读到了未被覆盖的旧缓存页
  • 响应:9 月 8 日经 HackerOne 收到 Knostic 的 Gadi Evron 报告,9 月 9 日宣布事故后 40 分钟内下线模型,当天 19:40 UTC 恢复
  • 行动建议:自建 SGLang 的团队升级到 v0.5.22 或更高版本,并直接核对 KV 池大小与上下文长度
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Z.ai GLM 5.3🌐 Cloudflare🌐 Zai

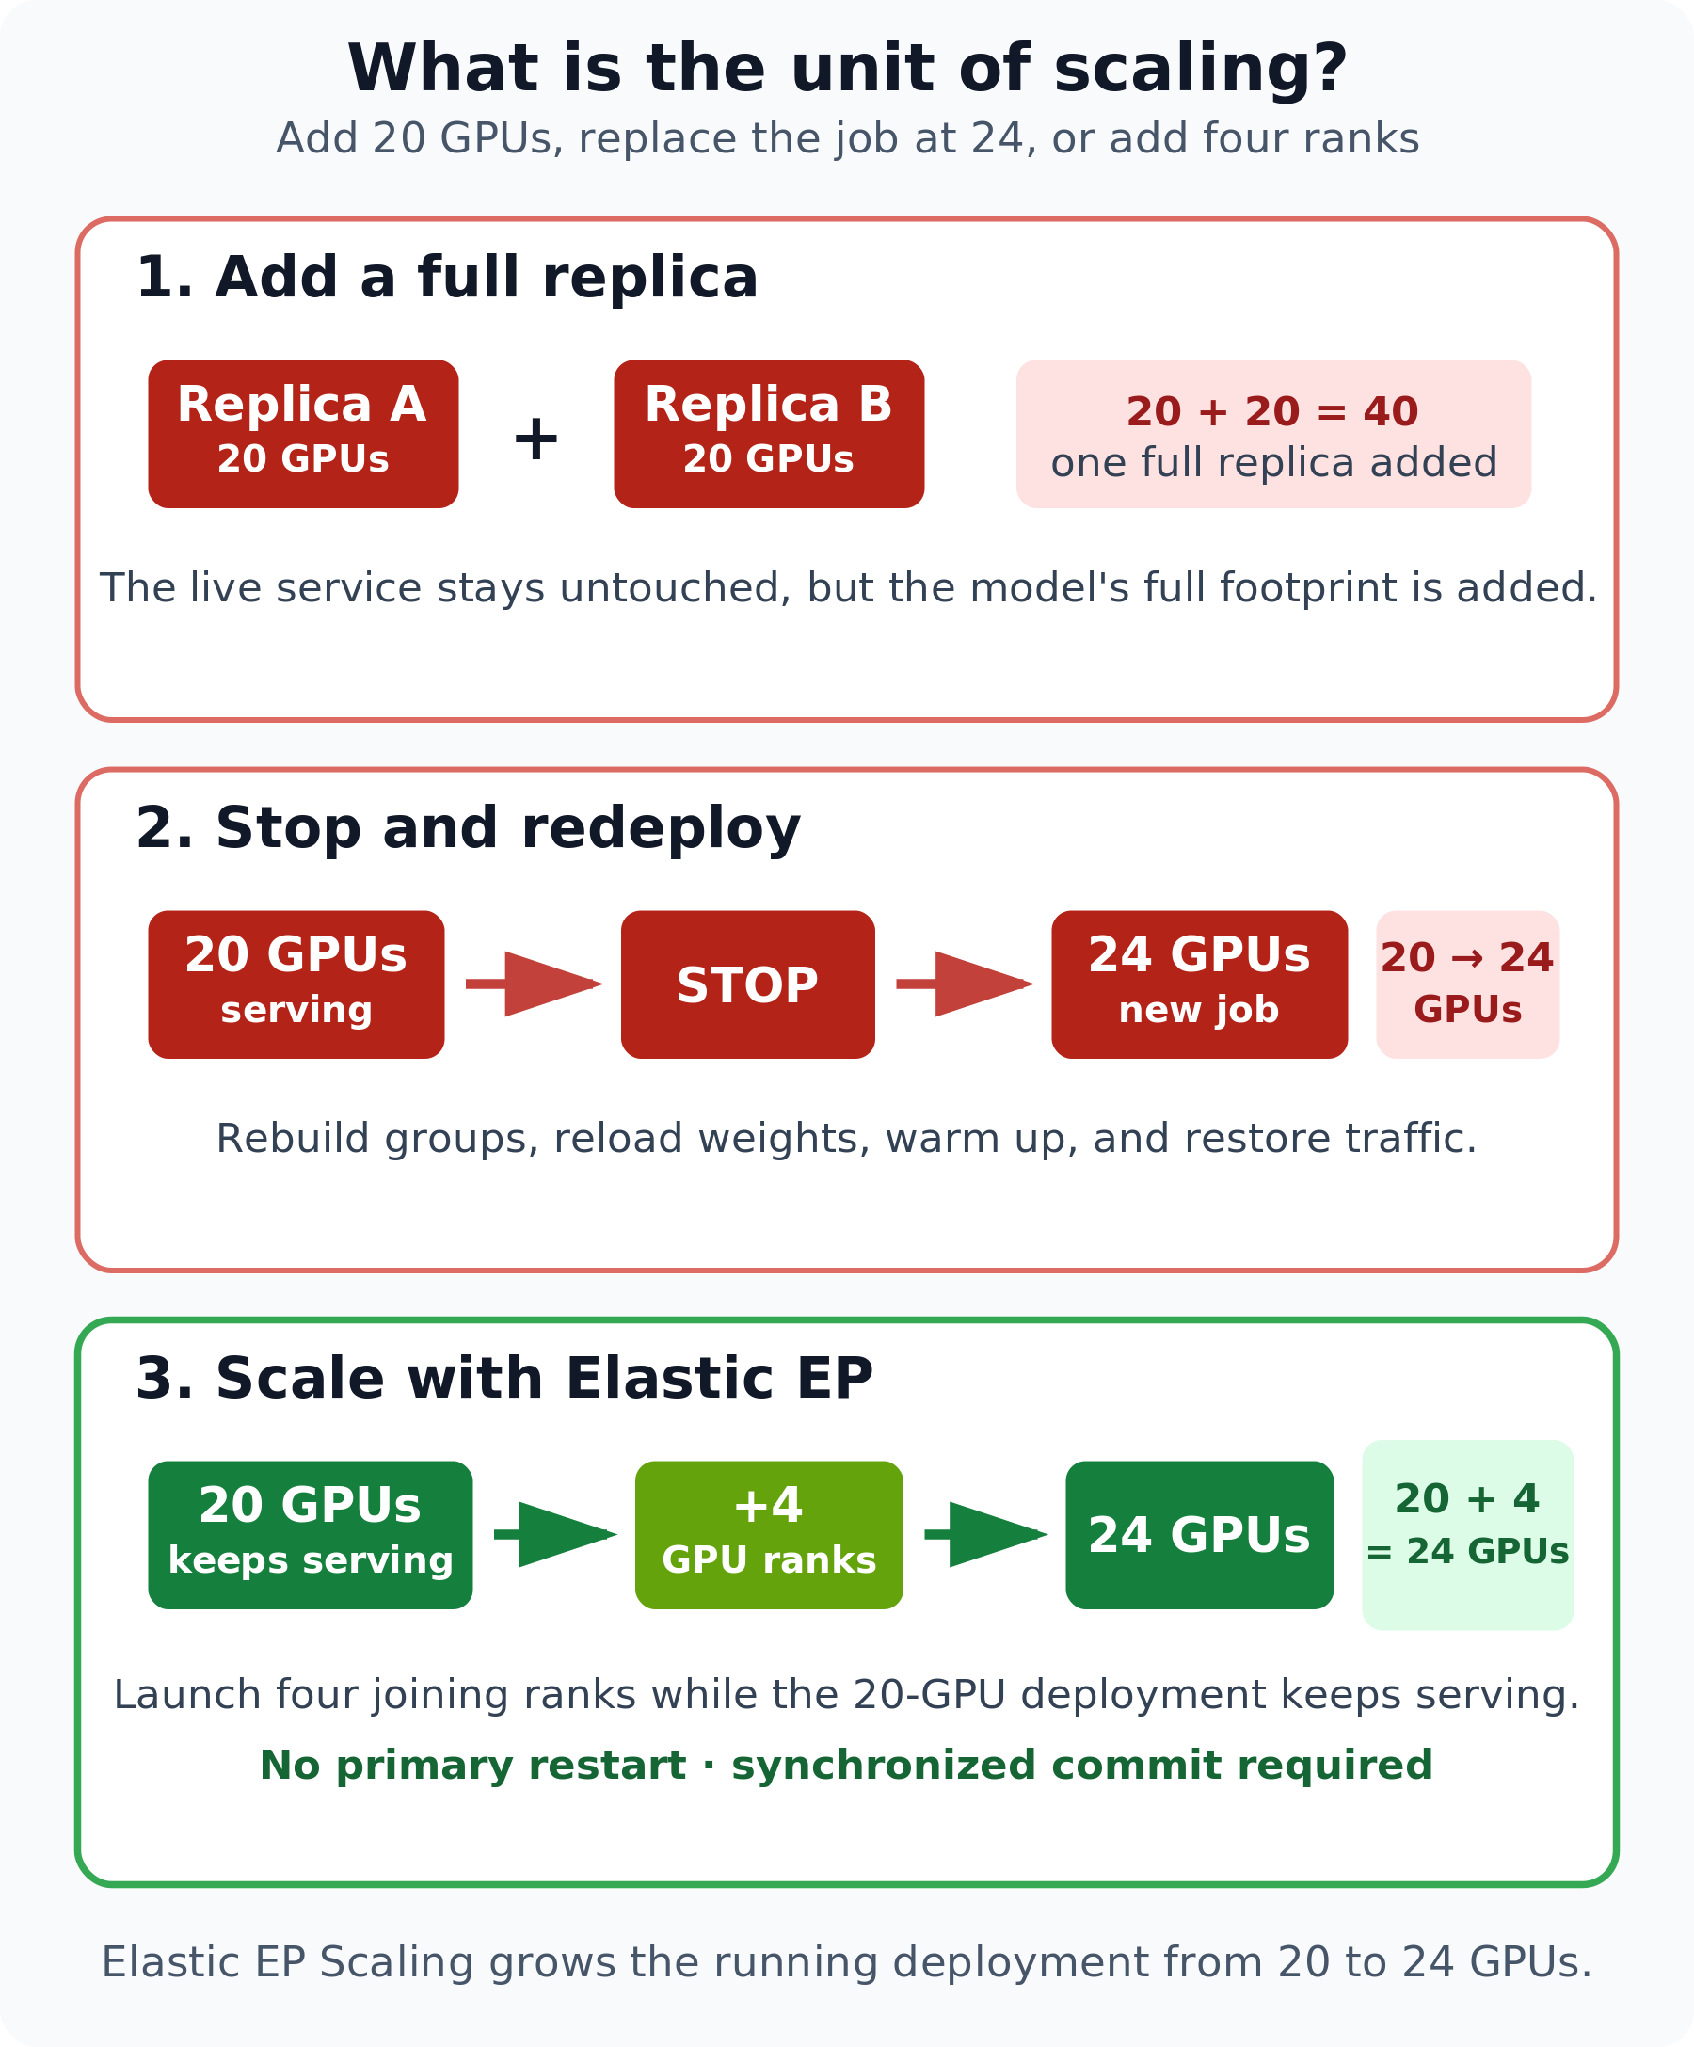
SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

核心要点速览

  • LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
  • 彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
  • 集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
  • 实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
阅读全文

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

Google Cloud 官方正式宣布开源 TorchTPU 核心加速框架,首次实现 PyTorch 框架原生、无编译壁垒地直接运行在 Google TPU(TPU v5p 与最新 TPU v6e)芯片之上。传统基于 PyTorch/XLA 的方案因复杂的计算图编译开销和动态形状限制,严重制约了 PyTorch 开发者在 TPU 上的创新步伐。TorchTPU 彻底打通了原生 PyTorch Eager 模式与自定义 Triton/C++ 硬件内核;主流高性能大模型推理引擎 vLLM 与 SGLang 同步官宣提供首发适配。同时,Google Cloud 宣布在其 Model Garden 引入 OpenAI 旗舰模型与 Codex,成为首个集齐全部三大顶级闭源模型的超算云平台。

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

核心要点速览

  • Google Cloud 官方开源 TorchTPU,支持 PyTorch 原生、免转译直接运行在 TPU v5p 与 TPU v6e 芯片
  • 彻底消除 PyTorch/XLA 传统图编译开销,原生支持 PyTorch Eager 动态模式与自定义 Triton/C++ 算子加速
  • vLLM 与 SGLang 同步发布专为 TorchTPU 深度优化的官方版本,实现高并发大模型推理吞吐量翻倍
  • OpenAI 旗舰模型与 Codex 正式登陆 Google Cloud Model Garden,打造最全面的跨厂商大模型生态
阅读全文

Eagle 发布 EAGLE-4 推测解码草稿模型:一个 drafter 按批量与硬件自适应,官方称 Qwen3.8-27B 单请求 961.6 tok/s

10 月 20 日,推理加速公司 Eagle 发布 EAGLE-4,这是 EAGLE 推测解码系列的第四代。它用一个草稿模型按批量、硬件和负载动态调整推测树,同时保持目标模型输出分布不变。官方口径下,Qwen3.8-27B 在 4 张 B300 上单请求达 961.6 tokens/s。代码以 eagle-harness v0.1.0 发布,支持 SGLang、vLLM 和实验性的 TokenSpeed。注意:多数转发称其“开源”,但官方许可证是源码可用(source-available)许可,并非 OSI 开源。

Eagle 发布 EAGLE-4 推测解码草稿模型:一个 drafter 按批量与硬件自适应,官方称 Qwen3.8-27B 单请求 961.6 tok/s

核心要点速览

  • 官方/厂商口径:Qwen3.8-27B + TokenSpeed,BF16、4× B300、TP4、单请求、T=0 下达 961.6 tokens/s(论文图 1(a))
  • 仓库实测表:vLLM 4× B300 单并发 241.6→722.8 tok/s(2.99×),并发 8 为 1.70×;SGLang 并发 8 为 1.91×、并发 64 降到 1.35×
  • AMD 也有数:SGLang 单卡 MI355X 并发 8 为 2.07×、并发 32 为 1.56×(ROCm 7.2)
  • 架构:滑动窗口草稿层 + 低秩候选头 + 只追加草稿缓存;harness 先离线标定验证延迟,再按“收益/成本”决定树的宽深
  • 许可:Eagle 4 Source-Available License,非商用免费;商用仅限 12 个月总营收不超过 2000 万美元且不构成竞品,超出需另签授权
阅读全文
关联模型 / 智能体 / 厂商:

Google 联合 Meta 开源 TorchTPU:PyTorch 原生跑在 TPU 上,把 .to("cuda") 改成 .to("tpu") 即可迁移,vLLM、SGLang 同步上 TPU 原生后端

10 月 20 日 PyTorch Conference 2026 上,Google 宣布与 Meta PyTorch 团队共同开发的 TorchTPU 在 GitHub 开源,让 TPU 和 GPU、CPU 一样成为 PyTorch 原生设备:支持 eager 模式和 torch.compile、约 450 个 ATen 算子、torch.distributed 集合通信。同时开源 vLLM-TorchTPU、SGLang-TorchTPU 推理引擎,打通 TorchTitan、Ray、VeRL、Hugging Face Transformers v5(device_map="tpu"),并预览面向 Claude Code、Antigravity 等编码助手的 TPU agent suite。前一天 AWS 刚发布同类的 TorchNeuron。

Google 联合 Meta 开源 TorchTPU:PyTorch 原生跑在 TPU 上,把 .to("cuda") 改成 .to("tpu") 即可迁移,vLLM、SGLang 同步上 TPU 原生后端

核心要点速览

  • 迁移门槛(PyTorch 官方博客):现有代码把 model.to("cuda") 改成 model.to("tpu")、分布式后端换成 tpu_dist 即可跑起来;官方也说明想拿到峰值性能仍需按 TPU 调整形状和切分
  • 覆盖面(官方口径):约 4,917 个热门 Hugging Face 模型中 98%(4,821 个)可在 TPU 上无报错运行,657 个架构代表模型里 97%(638 个)与 GPU 数值一致
  • 训练扩展(官方口径):TorchTitan 上 Qwen3 MoE 235B 从 1,024 扩到 8,192 颗 TPU v7,MFU 基本稳定在 27%–29%;64 颗 TPU v7 上吞吐 1,828 TPS,接近 JAX/MaxText 的 1,937 TPS
  • 推理成本(官方转引 SemiAnalysis InferenceX):TPU v7 加 vLLM-TorchTPU 在 8K/1K 场景每百万 token 2.01 美分,9 月首测时为 3.6 美分
  • 同步开源 4 个仓库:torch_tpu、vllm-torchtpu、sglang-torchtpu、TorchTitan TPU 版;TPU agent suite 以预览形式上线,支持 TPU v6e 与 TPU7x
阅读全文