AI 编程实时动态与要闻

微软 MAI-Transcribe-2 语音识别模型在 Foundry 正式 GA:单模型覆盖 60 种语言、内置说话人分离,1 小时音频约 10 秒转完,年底前每小时 0.10 美元

Microsoft AI 官方账号 11 月 12 日宣布,自研语音转文字模型 MAI-Transcribe-2 在 Microsoft Foundry 正式商用(GA),可用于生产环境,价格为每小时音频 0.10 美元(限时到 2026 年底)。该模型 9 月 3 日以公开预览上线,单模型支持 60 种语言,自带说话人分离、词级时间戳和关键词偏置;微软称 1 小时音频约 10 秒推理完成,FLEURS 前 25 种语言平均词错误率 3.4%。

微软 MAI-Transcribe-2 语音识别模型在 Foundry 正式 GA:单模型覆盖 60 种语言、内置说话人分离,1 小时音频约 10 秒转完,年底前每小时 0.10 美元

核心要点速览

  • 从预览转正式:9 月 3 日公开预览,11 月 12 日在 Microsoft Foundry GA,可用于生产负载(Microsoft Learn 文档)
  • 价格:每小时音频 0.10 美元,官方写明是到 2026 年 12 月 31 日的限时价,之后价格以官方定价页为准
  • 一个模型 60 种语言:自动识别语种,支持印英混说(Hinglish)、西英混说(Spanglish)等语码切换,噪声环境下保持准确率
  • 功能内置:说话人分离、词级时间戳、关键词偏置(phraseList)、clean / verbatim 两种转写风格,无需另接服务
  • 速度与精度为微软自测:1 小时音频约 10 秒推理,比 GPT-Transcribe 快 10 倍、比 Scribe v2 快 7 倍、比 Gemini 3.5 Transcribe 快 5 倍;FLEURS 60 语言平均词错误率 5.2%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Transcribe-2⚡ MAI-Transcribe-1.5⚡ GPT-Transcribe⚡ Scribe v2⚡ Gemini 3.5 Transcribe🌐 Microsoft🌐 Microsoft AI

DeepSeek 把 App 全套能力开放到 API:deepseek-flash 内置联网搜索、深度思考搜索、文件解析、读链接和安全审核,另推 OCR/ASR/TTS 独立接口与 MIT 开源聊天前端

11 月 13 日,DeepSeek 官方宣布把 DeepSeek App 背后的能力全部开放到 API:V4.1-Flash(模型名 deepseek-flash)在 Messages、Responses、Chat Completions 三种协议下都支持服务端执行的联网搜索(含图片搜索和引用)、深度思考搜索、PDF/Office/图片文件解析、自动读取消息中的链接,以及输入输出安全审核。OCR、语音识别(ASR)、语音合成(TTS)也作为独立接口上线。工具调用在 Token 费之外另计:搜索和抓取 0.75 美元/千次,OCR 0.225 美元/千页,ASR 限时 0.058 美元/小时,TTS 限时 0.225 美元/万字符。官方同时开源了可导入 DeepSeek 聊天记录的前端 Demo(MIT)。面向公众的应用必须开启安全审核。

DeepSeek 把 App 全套能力开放到 API:deepseek-flash 内置联网搜索、深度思考搜索、文件解析、读链接和安全审核,另推 OCR/ASR/TTS 独立接口与 MIT 开源聊天前端

核心要点速览

  • 三种协议都支持:Messages(/anthropic/v1/messages)、Responses(/responses)、Chat Completions(/chat/completions),模型统一用 deepseek-flash
  • 开启方式:工具 deepseek_web_search 和 deepseek_read_url,参数 safety_check 和 title;工具调用和上下文拼装都在服务端完成
  • 工具价格(官方口径,另加 Token 费):搜索/抓取 0.75 美元/千次,OCR 0.225 美元/千页,ASR 0.058 美元/小时、TTS 0.225 美元/万字符(均为限时 5 折)
  • 开源 Demo deepseek-ai/chat-demo:TypeScript、MIT 许可,支持导入 DeepSeek 聊天记录,API 密钥只存在浏览器本地
  • 首帖 2 小时内约 11.7 万浏览、2,100+ 点赞;官方未公布搜索质量或 OCR/ASR 准确率跑分
阅读全文
关联模型 / 智能体 / 厂商:

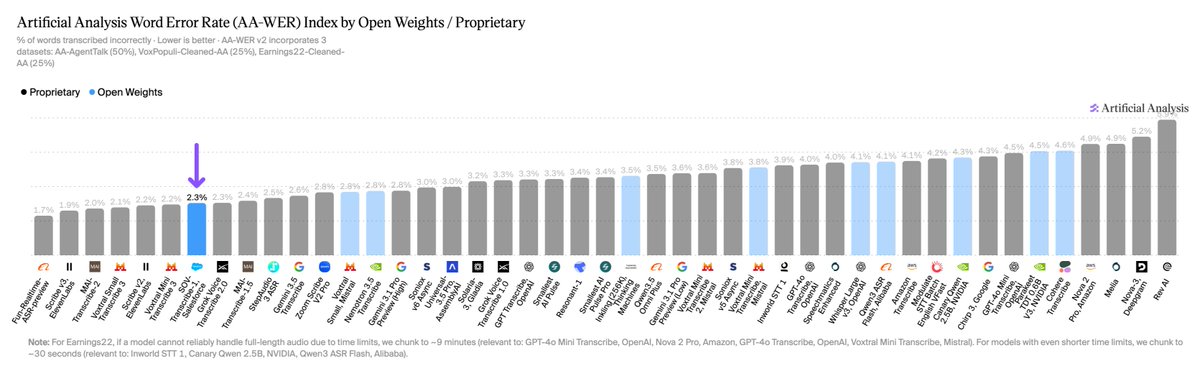
Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

新加坡时间 11 月 13 日 00:30,Artificial Analysis(@ArtificialAnlys)发帖称,Salesforce 新发布的 SOV-Transcribe-1 成为开源权重语音转文字模型第一名:在 AA-WER 指数上词错误率 2.3%,在包括闭源模型在内的 44 个模型中排第 7。它比紧随其后的开源模型 Mistral Voxtral Small 和英伟达 Nemotron 3.5 Transcribe(均为 2.8%)低 0.5 个百分点。模型由 Salesforce 主权 AI(Missionforce Sovereign AI)团队开发,总参数 26.6B、激活参数 4.6B,结构是 Whisper large-v3 音频编码器加 Gemma 4 26B A4B MoE 解码器,权重以 Apache 2.0 许可发布在 Hugging Face。它是非流式模型,适合整段录音转写,不适合实时字幕。

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

核心要点速览

  • AA-WER 2.3%:开源权重第 1、44 个模型中总榜第 7;Voxtral Small 与 Nemotron 3.5 Transcribe 均为 2.8%
  • 分数据集:Earnings22 财报电话 4.1%(Voxtral Small 4.8%),VoxPopuli 1.5%(对手 1.8%),AA-AgentTalk 语音客服对话 1.8%,与 Nemotron 持平
  • 26.6B 总参数 / 4.6B 激活;Whisper large-v3 编码器 + 投影层 + Gemma 4 26B A4B MoE;BF16,单段音频实测最长 30 分钟,支持英法德西意葡荷 7 种语言
  • 官方称 VoiceCodeBench(电话号码、邮箱等实体)任务成功率 76.3%、实体召回 93.4%,23 个系统中排第 2;AppTek 14 种英语口音平均 WER 8.21%,其中 8 种口音最低(含新加坡英语)
  • Apache 2.0;可用 vLLM 插件(vLLM 0.32.0)或 Transformers 部署;官方实测单张 RTX PRO 6000 Blackwell 每秒可转写 1,039 秒音频(配合 DFlash 草稿模型)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SOV-Transcribe-1⚡ Voxtral Small⚡ Nemotron 3.5 Transcribe⚡ Gemma 4⚡ Whisper large-v3🌐 Salesforce🌐 Artificial Analysis🌐 Mistral AI🌐 NVIDIA🌐 Google

ElevenLabs 发布 Scribe v3 与 Scribe v3 Live 语音转文字模型:102 种语言词错误率比 v2 降 27%,实时版首次支持说话人分离,API 每小时 0.20/0.22 美元

ElevenLabs 11 月 10 日(新加坡时间 11 日凌晨 02:10)发布两款语音转文字模型:面向录音文件的 Scribe v3 和面向实时流的 Scribe v3 Live。官方口径:Scribe v3 在 FLEURS 102 种语言上词错误率(WER)比 Scribe v2 低 27%,且每种语言都有提升;Scribe v3 Live 的语义 WER 比 Scribe v2 Realtime 低 43%,并首次在实时转写中提供说话人分离和基于上下文的断句检测。两款模型已上线 ElevenAPI,从 v2 切换只需改 model ID;API 定价页列出每音频小时 0.20 美元(v3)和 0.22 美元(v3 Live)。第三方评测方 Voice Arena 用 70+ 小时真实电话录音测试,称 v3 Live 在罗马尼亚语和印度英语里排第一。

ElevenLabs 发布 Scribe v3 与 Scribe v3 Live 语音转文字模型:102 种语言词错误率比 v2 降 27%,实时版首次支持说话人分离,API 每小时 0.20/0.22 美元

核心要点速览

  • 准确率(官方口径):Scribe v3 在 102 种语言上 WER 比 v2 低 27%,德语 -42%、西班牙语 -35%、英语 -23%、泰语 -28%
  • 实时版:Scribe v3 Live 语义 WER 比 v2 Realtime 低 43%、WER 低 31%,希腊语提升 77%,官方称延迟约 150ms
  • 说话人分离:v3 比 v2 少 12% 错误,3 人以上录音少 17%;v3 Live 比次优实时模型少 39%,英语分离错误率 3.1%
  • 价格:API 每音频小时 $0.20(v3)/ $0.22(v3 Live),关键词提示另加 $0.05/小时,转写编辑另加 $0.07/小时
  • 上手:model ID 为 scribe_v3 / scribe_v3_live,关键词提示最多 1000 个术语;企业版提供欧盟、印度、新加坡数据驻留
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Scribe v3⚡ Scribe v3 Live🤖 ElevenAgents🌐 ElevenLabs
AD赞助内容

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

语音模型公司 Cartesia 于 10 月 29 日发布 Managed Agents,一个面向企业电话场景的端到端语音 agent 平台,把自家语音识别、语音合成模型与 agent 框架一起设计调优,并自带电话接入、知识库、工具调用和批量外呼。官方称它在 Artificial Analysis 的 Speech Agent Arena 中以 1115 Elo 排第 1,在 ServiceNow 的 EVA-Bench 上拿到 87.4% 准确率和 90.7% 体验分(均为厂商口径,推理模型为 GPT-5.5);上线期价格打五折,为每分钟 0.03 美元。

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

核心要点速览

  • Artificial Analysis Speech Agent Arena 盲测偏好中,Managed Agents 以 1115 Elo 在 30 个 agent 中排第 1,高于 Gemini 3.1 Flash Live Minimal(1099)、Grok Voice 3.0(1064)和 GPT-Live-1(1041)(Cartesia 博客,厂商引用口径)
  • ServiceNow EVA-Bench 200 多个客服、IT 服务和 HR 场景首轮成绩:准确率 87.4%、体验分 90.7%,对比 Grok Voice 3.0 为 73.7%/71.2%、GPT Realtime 2.1 为 59.0%/61.6%(EVA-Bench)
  • 以上跑分都以 GPT-5.5 作为推理模型;Cartesia 内部评测称 85% 的通话没有抢话/打断问题,其他 agent 为 67%
  • 上线期五折,每分钟 0.03 美元;官方称该平台此前已在金融、零售、酒店、医疗场景跑过数千万次对话
  • 支持 44 种语言,目前英语、西班牙语、印地语、法语、日语可在通话中途切换,其余语言「即将支持」
阅读全文

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

10 月 20 日,Mistral 发布 Voxtral 3:语音转文字模型 Voxtral Small/Mini Transcribe 3、实时转写 Voxtral Mini Transcribe Realtime 3、语音合成 Voxtral Mini TTS 3(Voxtral Speech 3),以及基于 LiveKit 的语音 Agent SDK,把“听—思考调工具—说”串成一条流式管线,官方称每轮响应不到 1 秒。转写覆盖 50+ 语言并支持说话人分离和上下文偏置,TTS 覆盖 35+ 语言、50+ 方言,另有 30 分钟录音即可复刻音色的 Pro Voice。模型已通过 Mistral API(欧盟、美国、全球端点)上线,也可自部署。

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

核心要点速览

  • 多语种转写(官方口径):FLEURS 45 种语言宏平均 WER,Voxtral Small Transcribe 3 为 4.1%(指定语言)/4.0%(自动识别),与 Microsoft AI Transcribe 2 持平,优于 Scribe v2 的 4.9% 和 Whisper large-v3 的 16.0%/14.9%
  • 说话人分离(官方口径):cpWER 方面 Small 为 18.4%、Mini 为 18.6%,上一代 Voxtral Mini Transcribe 2 为 30.9%,Gemini 3.5 Transcribe 为 38.4%
  • 价格:Voxtral Mini Transcribe 3 为 4B 参数,每分钟 0.0035 美元(文档标注 Public Preview、32k 上下文);Voxtral Speech 3 每百万字符 13 美元
  • 实时转写:Voxtral Mini Transcribe Realtime 3 延迟可低于 500 毫秒;官方 FLEURS 35 语言图中 480ms 档 WER 为 6.4%,仍高于 Gemini 3.5 Realtime Transcribe 的 4.2%
  • 语音 Agent SDK 基于 LiveKit,支持 SIP 电话与 WebRTC,每个环节可单独替换 LLM、音色或语言,Pro Voice 用 30 分钟录音即可复刻音色
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Voxtral Small Transcribe 3⚡ Voxtral Mini Transcribe 3⚡ Voxtral Mini Transcribe Realtime 3⚡ Voxtral Mini TTS 3🤖 Voxtral voice agent SDK🌐 Mistral AI🌐 LiveKit

Google 发布 Gemini 3.8 Live 与扩展思考版

Google for Developers 发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking。两款音频模型强化轮替对话与近实时推理,可用单次多模态 API 替代语音转写、推理与语音合成的级联流水线,已通过 Gemini API 与 Google AI Studio 提供。

核心要点速览

  • Google for Developers 发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking。两款音频模型强化轮替对话与近实时推理,可用单次多模态 API 替代语音转写、推理与语音合成的级联流水线,已通过 Gemini API 与 Google AI Studio 提供。
阅读全文
关联模型 / 智能体 / 厂商:

Google 发布 Gemini 3.8 Live 与 Extended Thinking

Google for Developers 发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking。这两款音频模型强化了对话轮次与近实时推理,可用一次多模态 API 调用替代语音识别、推理和语音合成的级联流程,从而降低延迟与成本。模型已通过 Gemini API 在 Google AI Studio 提供,并将很快登陆 Gemini Enterprise Agent Platform。

核心要点速览

  • Google for Developers 发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking。这两款音频模型强化了对话轮次与近实时推理,可用一次多模态 API 调用替代语音识别、推理和语音合成的级联流程,从而降低延迟与成本。模型已通过 Gemini API 在 Google AI Studio 提供,并将很快登陆 Gemini Enterprise Agent Platform。
阅读全文
关联模型 / 智能体 / 厂商:

xAI 发布 Grok Voice Transcribe 2.0:短指令 WER 降至 6.8%,批处理约 $0.10/小时

SpaceXAI(xAI)正式上线 Grok Voice Transcribe 2.0,宣称在客服通话、口述凭证与短语音指令等真实场景上准确率约为上一代两倍,且价格不变。官方称其在 Artificial Analysis 32 个流式转写模型中准确率排名第一;短指令词错误率从约 20.6% 降至约 6.8%。支持流式/批处理、自动语种检测与中途换语、词级时间戳与置信度、免费说话人分离,批处理约 $0.10/小时、实时流式约 $0.20/小时,既有 Speech-to-Text API 集成可无感升级。

核心要点速览

  • 宣称客服通话/口述凭证/短指令等场景准确率约为 Transcribe 1.0 的两倍,价格不变。
  • Artificial Analysis 流式转写榜准确率第 1;短指令 WER 约 20.6%→6.8%。
  • 批处理约 $0.10/小时、实时流式约 $0.20/小时;含说话人分离、语种切换与词级时间戳,API 可无感升级。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Grok Voice Transcribe 2🌐 xAI

Meta 发布 Muse Voice Transcribe:实时多语 ASR,支持 20+ 说话人分离,API 约 0.18 美元/小时

Meta Superintelligence Labs 于 9 月 1 日推出首个实时音频感知模型 Muse Voice Transcribe:流式 ASR、20+ 说话人 diarization、endpointing,原生支持句内/句间语码转换,训练覆盖 70+ 语言(首发验证 25 种),可处理超一小时音频。官方称在 Artificial Analysis 流式语音转写榜单排名第一(截至 9 月 1 日)。已接入 Meta AI for Mac(按住 Fn 全局听写)、Muse Code,并向 Meta Model API 开放,定价为每 1000 音频分钟 3 美元(约合每小时 0.18 美元)。

核心要点速览

  • 流式 ASR + 说话人分离 + 端点检测一体,无需后处理拼流水线
  • Mac 全局听写与 Muse Code 已切换到该模型;开发者可走 Meta Model API
  • API 价约 0.18 美元/小时;自适应 delay 在速度与准确率之间动态权衡
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Voice Transcribe⚡ Muse Spark🤖 muse-code🌐 Meta AI
AD赞助内容

Google DeepMind 发布 Gemini 3.5 Transcribe:高精度多语种语音转写模型,已上线 macOS 与 Antigravity

Google DeepMind 正式推出 Gemini 3.5 Transcribe,专为复杂嘈杂真实场景设计的高精度智能语音转写大模型。自动去除语气词并结构化输出,已全面上线 macOS 版 Gemini、Android Gboard 以及 Google AI Studio / Antigravity。

核心要点速览

  • 高噪声环境下关键结构化实体(电话号码、邮编、代码片段、订单号)召回率提升显著;
  • 智能过滤口语语气词并支持自定义专业术语表与多语种混杂自动识别(支持超 85 种语言);
  • 首发集成于 macOS Gemini 客户端、Android Gboard 以及 Google AI Studio / Antigravity。
阅读全文
关联模型 / 智能体 / 厂商:

Google DeepMind 发布 Gemini 3.5 Transcribe:流式 WER 4.0%,可在 Antigravity 对着代码库听写

Google DeepMind 推出 Gemini 3.5 Transcribe,面向实时语音交互的高精度语音转写模型。Artificial Analysis 测得流式 WER 4.0%、非流式 2.6%,支持 85+ 语言,并可结合 Antigravity 屏幕上下文准确转写文件名、变量与 Agent 思路。

核心要点速览

  • 流式 WER 4.0%、非流式 2.6%;相对 Chirp 3,最终转写时延改善约 70%,FLEURS 多语种流式 WER 为 5.50%
  • Live API 模型 gemini-3.5-transcribe-live 亚秒级双向流式;Interactions API 的 gemini-3.5-transcribe 支持说话人分离与词级时间戳
  • 已在 Google AI Studio、Antigravity(结合屏幕与对话上下文)、Gemini macOS 与 Android Gboard Rambler 上线,支持自定义词表与 85+ 语言自动检测
阅读全文