AI 编程实时动态与要闻

Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

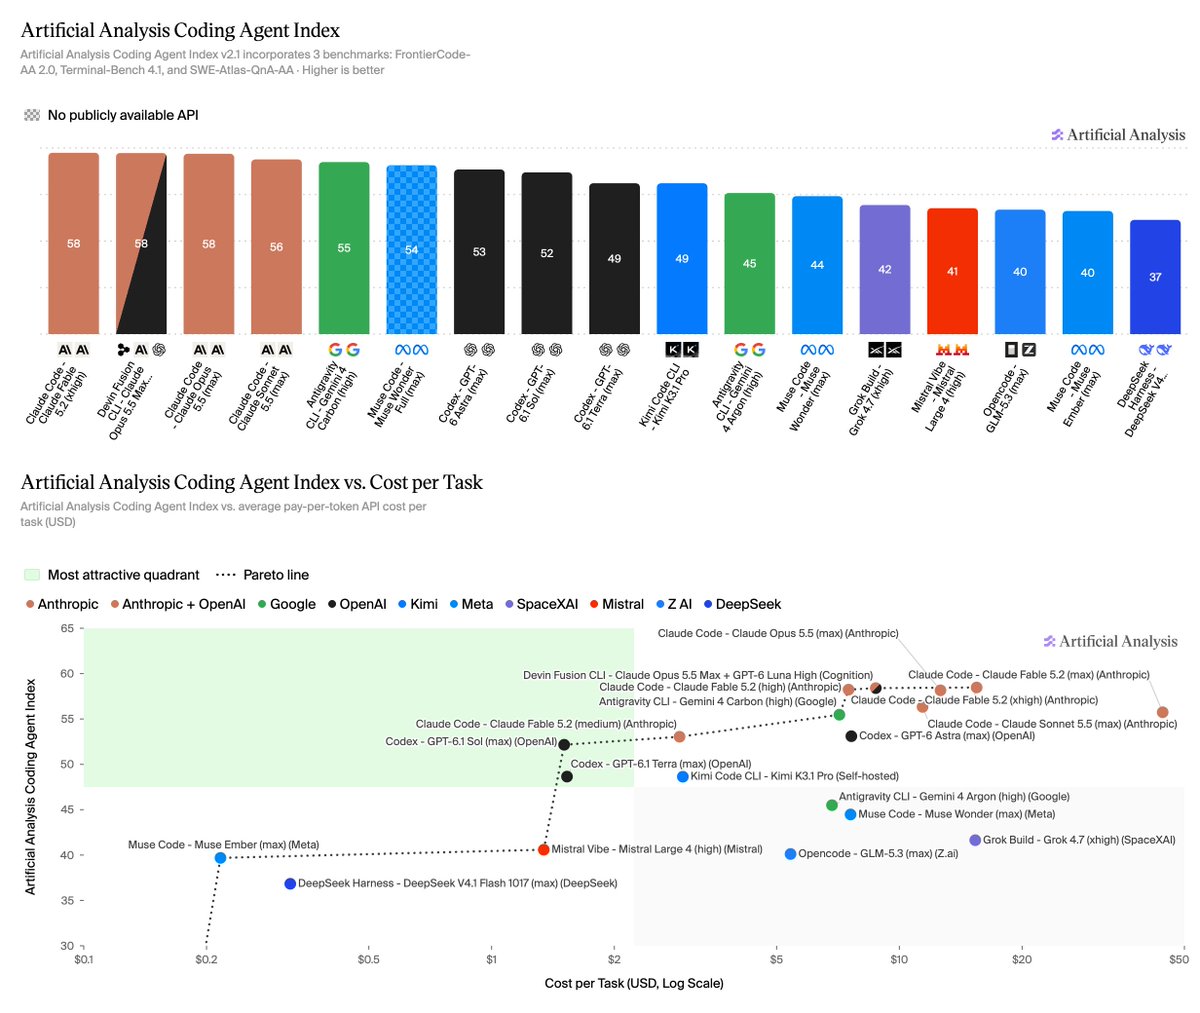
Artificial Analysis 11 月 14 日发布编码智能体指数 v2.1:把 FrontierCode 从 1.1 换成 Cognition 的 FrontierCode 2.0(132 个真实任务,按维护者是否愿意合并评分),Terminal-Bench 从 4.0 升到 4.1,保留 SWE-Atlas-QnA-AA。Claude Code + Claude Fable 5.2(xhigh/high)和 Claude Opus 5.5(max)并列 58 分居首;因新版 FrontierCode 更难,各配置平均降 5 分,只有 Codex + GPT-6.1 Terra(max)基本没掉分。
Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

核心要点速览

  • v2.1 构成:FrontierCode-AA 2.0(132 个真实编码任务,按仓库维护者是否会合并评分)、Terminal-Bench 4.1(同样 66 题,更新验证器以提高可靠性、防奖励投机)、SWE-Atlas-QnA-AA
  • 并列第一 58 分:Claude Code + Claude Fable 5.2(xhigh 与 high 均为 58)、Claude Code + Claude Opus 5.5(max),以及 Devin Fusion CLI(Opus 5.5 max + GPT-6 Luna High);其后为 Claude Sonnet 5.5(max)56、Antigravity CLI + Gemini 4 Carbon(high)55
  • 23 个两版都测过的配置在 FrontierCode-AA 2.0 上全部低于 v1.1,均值从 45% 降到 29%;Claude Code + Fable 5.2 以 49% 领先。Terminal-Bench 4.1 各配置变化都不到 3 分,Kimi Code CLI + Kimi K3.1 Pro 以 68% 居首
  • 成本差约 30 倍:48 分以上配置中,Codex + GPT-6.1 Sol(max,52 分)每题 1.51 美元,Claude Code + Fable 5.2(max,56 分)每题 44.22 美元;Fable 5.2 在 medium/high/xhigh 分别为 2.89/7.51/15.47 美元
  • Claude Code 与 Devin Fusion CLI 遇到安全拒答会切换到备用模型:Devin Fusion CLI 与 Opus 5.5(max)约 9% 的尝试由备用模型完成,Fable 5.2(xhigh)6%,Sonnet 5.5 5%
阅读全文

Edge0 开放 145B 端侧模型 Edge0-145B 和 Edge0-120B 权重:每 token 激活约 10B,单张 24GB 消费级显卡可跑,厂商称 Terminal-Bench 2.1 得分 86.5 高于 Claude Opus 4.6

端侧模型公司 Edge0 于 11 月 12 日开放 Edge0-145B 和 Edge0-120B 的权重,并发布 C++ 推理引擎 edge0-infer 和 Edge0 Chat 0.2.0。145B 版基于 Qwen3.8-Flash-Next,是潜空间稀疏 MoE,每 token 激活约 10.12B 参数,原生 4 bit 训练,上下文 256K。官方称本地峰值内存 29GB,在 RTX 5090 D 24GB 上智能体解码 98.3 tok/s;Terminal-Bench 2.1 得分 86.52,Claude Opus 4.6(Max)为 78.2。所有成绩均为 Edge0 内部评测。

Edge0 开放 145B 端侧模型 Edge0-145B 和 Edge0-120B 权重:每 token 激活约 10B,单张 24GB 消费级显卡可跑,厂商称 Terminal-Bench 2.1 得分 86.5 高于 Claude Opus 4.6

核心要点速览

  • 规模与结构:Edge0-145B 总参 145B,每 token 激活约 10.12B;48 层,每层 512 个专家,10 个路由专家加 1 个共享专家;上下文 256K,原生 4 bit 训练
  • 跑分(厂商内部评测):Terminal-Bench 2.1 得分 86.52,Qwen3.8-Flash-Next 为 83.3,DeepSeek-V4-Flash-0731 为 82.7,Claude Opus 4.6(Max)为 78.2;DeepSWE 1.1 得分 64.6,GPQA-Diamond 得分 90.4
  • 本地速度(模型卡口径):RTX 5090 D 24GB 上 NVFP4 版智能体解码 98.3 tok/s,16K 输入预填充 3165.7 tok/s;RTX 4090 跑 Q3_K 版智能体解码 91.7 tok/s
  • 硬件门槛:Windows 包要求 NVIDIA RTX 20 系或更新、至少 16GiB 显存和 20GiB 内存;权重文件 NVFP4 版 47.79GiB,Q3_K 版 40.81GiB
  • 许可限制:模型用 Edge0 社区许可 1.0,同时受 Qwen 社区许可约束;个人、研究和内部使用可以,转售模型或做商业模型服务要另签授权;推理框架为 Apache-2.0
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Edge0-145B⚡ Edge0-120B⚡ Qwen3.8-Flash-Next⚡ DeepSeek-V4-Flash-0731⚡ Claude Opus 4.6🌐 Edge0🌐 Qwen🌐 Hugging Face🌐 NVIDIA

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

新加坡时间 11 月 13 日 02:02,Google DeepMind、Google AI 和 Gemini 官方账号同时宣布 Gemini 4 Hydrogen 正式上线,Gemini API 更新日志标注为 GA,模型 ID 是 gemini-4-hydrogen。按官方口径,它在默认 high 思考档位下的 Artificial Analysis 智能指数为 51,高于 Gemini 4 Argon 的 50,新增的 xhigh 档位可到 54;完成任务的速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 得分从 18.2% 提高到 57%。价格在 100 万 token 上下文内统一为输入 1.5 美元、输出 7.5 美元(每百万 token),免费层也能用。它同时成为 Gemini 应用、Google 搜索和 Antigravity 托管智能体的默认模型。昨天站内报道过的 SKU 价目表泄露,今天由官方证实。Cursor 官方随后宣布 Hydrogen 已上线编辑器,默认努力档(high)在 CursorBench 4.0 上为 54.3%,高于 Gemini 3.8 Flash 的 39.6%。

Google 正式发布 Gemini 4 Hydrogen:AA 智能指数 51 超过 Argon,比 3.8 Flash 快 2.5 倍,Terminal-Bench 4.1 从 18.2% 提到 57%;每百万 token 1.5/7.5 美元,免费层可用

核心要点速览

  • 官方口径:AA 智能指数 51(默认 high 档),高于 Gemini 4 Argon 的 50;新增 xhigh 档可达 54
  • 速度是 Gemini 3.8 Flash 的 2.5 倍,Terminal-Bench 4.1 从 18.2% 升到 57%,捏造陈述减少 5 倍以上
  • 定价:每百万 token 输入 1.5 美元、输出 7.5 美元,100 万 token 上下文内不分段加价,免费层可用
  • Antigravity 新功能 Orchestrator 在 Carbon 和 Hydrogen 之间自动切换:Terminal-Bench 4.0 成功率接近纯 Carbon,额度少用 24%,速度快 19%
  • 合作方实测:复杂图、SQL 和数据类企业任务比 3.8 Flash 快 2–2.8 倍,token 用量少 12%–23%
  • Cursor:官方宣布 Hydrogen 已上线编辑器;CursorBench 4.0 默认 High 54.3%(每任务约 5.59 美元),高于 Gemini 3.8 Flash 的 39.6%;Medium 46.7%(约 1.76 美元),Low 27.9%(约 0.28 美元);属第三方模型,不计入套餐包含用量(Cursor 文档、CursorBench)
阅读全文

Hugging Face Harness Leaderboard 加入 DeepSeek Harness:DSH 在全部 5 组评测中与第一名统计持平,DeepSWE 排第 2,Terminal-Bench 因收尾时关掉后台服务仅排第 6

Hugging Face 研究员 Joël Niklaus 11 月 11 日宣布,DeepSeek 开源编码 Agent DeepSeek Harness(DSH,开发者预览版 0.2.2-rc.1)已加入他维护的 Harness Leaderboard。该榜单固定模型和推理力度、只换 harness,比较 10 款编码 Agent。作者口径:DSH 在 DeepSeek-V4.1-Flash、GLM-5.3-Flash(低/高推理力度)和 Flint 共 5 组评测中都与第一名统计持平;DeepSWE 三模型平均排第 2,仅比 Nous Research 的 Hermes Agent 低 0.5 分;Terminal-Bench 排第 6。主要原因是 DSH 结束任务时会关掉自己启动的后台程序,3 道要求留着服务器给评分器检查的任务 36 次只过 2 次,每组评测因此丢 1.5–1.7 分。平均每解出一题花费 0.53 美元。这是个人维护的研究榜单,并非 DeepSeek 或 Hugging Face 官方公告。

Hugging Face Harness Leaderboard 加入 DeepSeek Harness:DSH 在全部 5 组评测中与第一名统计持平,DeepSWE 排第 2,Terminal-Bench 因收尾时关掉后台服务仅排第 6

核心要点速览

  • 榜单固定模型只换 harness,比较 10 款编码 Agent;DSH 在 5/5 组评测中与第一名统计持平(作者口径)
  • DeepSWE 三模型平均排 第 2,比 Hermes Agent 低 0.5 分;Terminal-Bench 排 第 6
  • 3 道需保留服务器的 Terminal-Bench 任务:DSH 2/36 通过,OpenCode、Pi、Hermes Agent 均为 36/36
  • 这 3 题让 DSH 每组评测丢 1.5–1.7 分;在 DeepSeek-V4.1-Flash 高推理力度下超过它与第一名的 1.3 分差距
  • 平均每解出一题 0.53 美元;测试版本 0.2.2-rc.1,因需 DeepSeek 账号密钥关闭了网页搜索
阅读全文
AD赞助内容

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

百度 11 月 11 日在 ERNIE 官网和 @Baidu_Inc 发布文心 5.5 Flash Preview,这是基于 11 月 5 日开源的 ERNIE 5.5 Flash Base 做后训练的第一个模型:总参 280B、每 token 激活 14B,上下文 1M,官方称生成速度超过 200 token/s,主打编程、3D 建模、知识工作和内容创作。API 已在百度智能云千帆上线,权重将于 11 月 25 日前开源,官方博客写明采用 Apache 2.0。官方跑分(厂商口径)中,它在 AutomationBench(61.9)和 SpreadsheetBench V2(36.4)上排在对比表第一,但 Terminal-Bench 4.0 只有 46.5,低于 Claude Opus 5.5 的 63.6。官方也说明这是后训练中途的检查点。

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

核心要点速览

  • 规格(官方):总参 280B、每 token 激活 14B,上下文 1M,生成速度 200+ token/s,纯文本模型
  • 厂商口径跑分:AutomationBench 61.9(Opus 5.5 为 58.0)、SpreadsheetBench V2 36.4(Opus 5.5 为 35.1),均为对比表第一
  • 短板同样明显:Terminal-Bench 4.0 46.5(Opus 5.5 63.6、GPT-6.1 Sol 56.1),DeepSWE v1.1 71.2(DeepSeek V4.1 Flash 77.0)
  • 价格:千帆每百万 token 输入忙时 2 元 / 闲时 1 元,输出 8 元 / 4 元,限时五折(每经报道);OpenRouter 标价 $0.28 / $1.13
  • 权重 11 月 25 日前开源,官方博客称 Apache 2.0;比 Base 的自定义协议宽松,以最终发布为准
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:YC 总裁 Garry Tan 开源 harness 评测,7 种「模型+harness」组合在 20 道任务上通过率都落在 71–79%,差距主要在成本:OpenClaw 每解一题约 $0.44,Claude Code $0.22,Codex $0.17

Y Combinator 总裁兼 CEO Garry Tan(@garrytan)于 2026-11-08 18:09 UTC 在 X 发帖,称出于好奇在做「frontier 模型 + harness」的开源评测,并贴出初步结论截图;随后公开了 GitHub 仓库 garrytan/g-harness-evals(MIT)。仓库做法是固定模型(Opus 5.5 或 GPT-6.1 Sol)和任务,只换 harness(系统提示、工具、记忆)。截图称 7 种组合在同样 20 道编码任务上通过率都在 71–79%,其中 14 道题在所有组合里结果相同,所以「测试太简单、分不出高下」,更难的 Terminal-Bench 复跑正在进行。成本差距明显:Opus 上 OpenClaw 约 $0.44/题、Claude Code $0.22、Hermes $0.24、QM $0.19;Sol 上 Codex 最便宜最快,$0.17。抓取时原帖约 312 赞、84 回复、117 收藏、约 4.2 万展示。仓库自带利益披露:QM 属于 YC 项目,YC 投资了 Hermes。

X 热议:YC 总裁 Garry Tan 开源 harness 评测,7 种「模型+harness」组合在 20 道任务上通过率都落在 71–79%,差距主要在成本:OpenClaw 每解一题约 $0.44,Claude Code $0.22,Codex $0.17

核心要点速览

  • 原帖:Garry Tan(简介「President & CEO @ycombinator」)2026-11-08 18:09 UTC 发帖,抓取时约 312 赞、16 转发、10 引用、84 回复、117 收藏、约 41,767 展示
  • 方法(仓库 README):固定模型 Opus 5.5 或 GPT-6.1 Sol 与 20 道公开任务,只换 harness;指标是通过率、每解一题成本、单次耗时
  • 通过率:7 种组合都在 71–79%,Opus 上 Claude Code 76.3%、Hermes 78.8%、OpenClaw 76.3%、QM 72.5%;95% 区间互相重叠,作者明确说「分不出高下」
  • 成本与速度:Opus 上 OpenClaw $0.44/题、99.4 秒/次,Claude Code $0.22、40.1 秒;Sol 上 Codex $0.17、30.1 秒(作者口径,描述性,未做显著性检验)
  • 定性:个人发起的开源评测引发的讨论,不是任何厂商的官方 Benchmark;作者自述 QM 是 YC 项目、YC 投资了 Hermes,gstack/gbrain 是他本人项目
阅读全文
E
E. Kelly Buchananarxiv.org·
👀35
🔥90

斯坦福等审计 Terminal-Bench 2.0:89 题中 28 题有缺陷,修复后发布 2.1,单 Agent 分数最多变动约 12 分

斯坦福 / 康奈尔团队(E. Kelly Buchanan、Crystal Zhou、Scott W. Linderman、Christopher Ré)于 arXiv 2611.08417(2026-11-05)提出「benchmark maintenance debt」:即使用发布前人工+模型红队审过的 Terminal-Bench 2.0,仍有约 30%(28/89)任务存在指令—验证器不一致、外部依赖漂移或资源预算过紧。修复版 Terminal-Bench 2.1 已开源;重跑 19 个 Agent 后,个体分数最多变动约 12 分、名次最多变动 3 位,总排序仍高度相关(Spearman ρ=0.958)。延长超时后,GPT 5.4 上约 20 分的 harness 差距基本消失。

斯坦福等审计 Terminal-Bench 2.0:89 题中 28 题有缺陷,修复后发布 2.1,单 Agent 分数最多变动约 12 分

核心要点速览

  • 缺陷规模:28/89 题需修;指令—验证不一致约 57%、任务漂移约 43%、环境/资源约 29%(可重叠)
  • 影响:重跑 19 个 Agent,个体分数最多约 ±12 分、名次最多变动 3;Spearman ρ=0.958
  • 典型修复:如 query-optimize 验证器要求字节级保留数据库文件但题面未写——改为写清约束;5 道题通过率从 ≤15% 升到 >50%
  • 资源:默认超时下失败试验超 50% 是 timeout;把时限拉到 32× 后,Codex 与 Terminus-2 在 GPT 5.4 上的约 20 分差距基本闭合
  • 产物:github.com/harbor-framework/terminal-bench-2-1 与 PR #53;工作流已并入 Terminal-Bench 持续审题
阅读全文

微软 Foundry Local 接 GitHub Copilot:本地跑 Qwen3.8-27B 做编码 Agent,约 24GB 显存即可,厂商口径 Terminal-Bench 2.1 约 73.0

微软 Foundry 团队于 2026-11-05 发博:Foundry Local CLI ≥0.13.0 可用 ONNX Runtime 在本机跑 4bit Qwen3.8-27B(权重约 18GB),经 Bring Your Own Key 接到 GitHub Copilot。需 NVIDIA ≥24GB 显存(24GB 时上下文约 64K;≥32GB 可达模型上限 262K)。官方引用模型卡口径 Terminal-Bench 2.1 73.0、SWE-bench Pro 61.7;并称在 RTX 5090 / DGX Spark 上生成速度优于同量化的 llama.cpp。Mac/AMD 尚在路线图。

微软 Foundry Local 接 GitHub Copilot:本地跑 Qwen3.8-27B 做编码 Agent,约 24GB 显存即可,厂商口径 Terminal-Bench 2.1 约 73.0

核心要点速览

  • 形态:Foundry Local ≥0.13.0 + 4bit Qwen3.8-27B(约 18GB 权重),经 BYOK 接 GitHub Copilot App
  • 硬件:NVIDIA ≥24GB 显存;24GB→约 64K 上下文,≥32GB→可达 262K;需自装 CUDA/cuDNN
  • 官方引用跑分(模型卡口径,非 4bit 复测):Terminal-Bench 2.1 73.0、SWE-bench Pro 61.7、NL2Repo-Bench 42.3、DeepSWE 1.1 42.2
  • 推理栈:ONNX Runtime + DFlash2 推测解码 + INT4/KV 量化 + 前缀缓存;厂商称长上下文相对 llama.cpp 优势更大
  • 边界:微软承认复杂推理仍宜云端;Mac/AMD 未上线;Copilot CLI 本地模型≠自动离线,需另开 COPILOT_OFFLINE
阅读全文

Hugging Face 的 Joël Niklaus 发布 Harness Leaderboard:28,849 次试验比较 9 款编码 Agent Harness,厂商口径 mini-swe-agent 均值约 51.4%

2026-11-05,Hugging Face Harness Optimization 研究员 Joël Niklaus(@joelniklaus)发布 Harness Leaderboard:在固定模型/供应商/推理力度下只换 harness,跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash 与 Flint,基准 Terminal-Bench 2.1 与 DeepSWE,共 28,849 次试验、推理花费约 $4,746。作者口径:三模型平均 mini-swe-agent 解决率约 51.4%,Pi 约 49.4% 且每解一题约 $0.29。本条为个人研究排行榜,非 Hugging Face 公司官方产品公告。

Hugging Face 的 Joël Niklaus 发布 Harness Leaderboard:28,849 次试验比较 9 款编码 Agent Harness,厂商口径 mini-swe-agent 均值约 51.4%

核心要点速览

  • 来源:HF 的 Joël Niklaus(Harness Optimization)个人帖 2026-11-05T16:04:08Z,非公司官宣
  • 规模(作者口径):9 款 harness × 开源模型,28,849 次试验,推理花费约 $4,746
  • 方法:固定模型/供应商/推理力度,每任务 3 次尝试;基准 Terminal-Bench 2.1 与 DeepSWE
  • 结果(作者口径):三模型平均 mini-swe-agent ~51.4%,openclaw ~27.3%;Pi ~49.4% / 约 $0.29 每解一题
  • 落地:排行榜与轨迹公开在 HF Space;对照 Harness Lens 看各 harness 提示词与工具差异
阅读全文

Artificial Analysis:腾讯 Hy4 在 Intelligence Index v5 获 35 分,中国实验室模型第 2,FrontierCode 2.0 达 31%

独立评测机构 Artificial Analysis 11 月 5 日(UTC 08:28)公布腾讯混元 Hy4 的 Intelligence Index v5 成绩:综合 35 分,与 Grok 4.7(xhigh)持平,落后 Claude Haiku 5.5(max)1 分;在中国实验室模型中仅次于 Kimi K3.1 Pro(46)。Agent 编码方面 FrontierCode 2.0 为 31%、Terminal-Bench 4.0 为 37%;单任务成本约 0.78 美元,约为同分 Grok 4.7 的十分之一。

Artificial Analysis:腾讯 Hy4 在 Intelligence Index v5 获 35 分,中国实验室模型第 2,FrontierCode 2.0 达 31%

核心要点速览

  • Intelligence Index v5 综合 35:与 Grok 4.7(xhigh)并列,落后 Haiku 5.5(max,36)1 分;中国实验室仅次于 Kimi K3.1 Pro(46)
  • FrontierCode 2.0 31%(中国实验室领先;DeepSeek V4.1 Flash 1017 max 28%,Kimi K3.1 Pro 25%),Terminal-Bench 4.0 37%
  • AA-Omniscience v1.1 准确率 50%,但幻觉率 89%(Kimi K3.1 Pro 幻觉率 37%);HLE-Diamond 33%
  • 单任务成本约 $0.78:约为同分 Grok 4.7 的 1/10、Qwen3.8 Max(34)的 1/13,约为 Haiku 5.5 的两倍
  • 定价约 $0.834/$2.501 每百万输入/输出 token,缓存读 $0.042;1M 上下文,支持图文输入
阅读全文
AD赞助内容

Cognition 发布 SWE-2 Flash:基于 Inkling-Small 的快速编码模型,200 tok/s、价格为 SWE-2 的五分之一

Cognition 于 11 月 4 日(UTC 19:55)发布 SWE-2 Flash。官方博客称它以 Thinking Machines 的 Inkling-Small(276B 总参、12B 激活)为底座,首次在强化学习前加入大规模中训练,把 FrontierCode 2.0 从 3.2% 提到 24.0%、Terminal-Bench 4.0 从 0.9% 提到 20.0%,自称超过所有美国开源权重模型。生成速度约 200 tok/s,价格为 SWE-2 的五分之一、速度为其 3 倍;本月底前对 Devin Desktop 和 CLI 的 Pro、Max、Teams 用户免费。权重暂不公开,将通过安全共享计划提供给合作方和研究者。

Cognition 发布 SWE-2 Flash:基于 Inkling-Small 的快速编码模型,200 tok/s、价格为 SWE-2 的五分之一

核心要点速览

  • SWE-2 Flash 底座为 Thinking Machines Inkling-Small,276B 总参、12B 激活,规模约为 SWE-2(2.8T-A104B)的十分之一。
  • 训练流程:先用数万亿 token 的科学文章、博客、代码等数据分三阶段中训练,再做大规模强化学习,重点提升 RL 任务质量和多样性。
  • 官方跑分:FrontierCode 2.0 24.0(SWE-2 为 23.8)、DeepSWE 1.1 60.1、Terminal-Bench 2.1 89.2、SWE-Bench Pro v2 Hard 89.9、Terminal-Bench 4.0 20.0。
  • 速度约 200 tok/s(SWE-2 约 60 tok/s),价格为 SWE-2 的五分之一;11 月底前 Devin Desktop/CLI 的 Pro、Max、Teams 用户免费。
  • 出于网络安全风险考虑,权重不直接开源,Cognition 将在未来几周公布安全权重访问计划的细节。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SWE-2 Flash⚡ SWE-2⚡ Inkling-Small🤖 Devin🌐 Cognition🌐 Thinking Machines
T
Tsinghua University & Z.AI (HarnessPro, arXiv 2610.26770)arxiv.org·
👀50
🔥80

清华与智谱 Z.AI 开源 HarnessPro:Agent 自己改写 harness,Terminal-Bench 2 通过率 80.8%、单任务成本降 34%

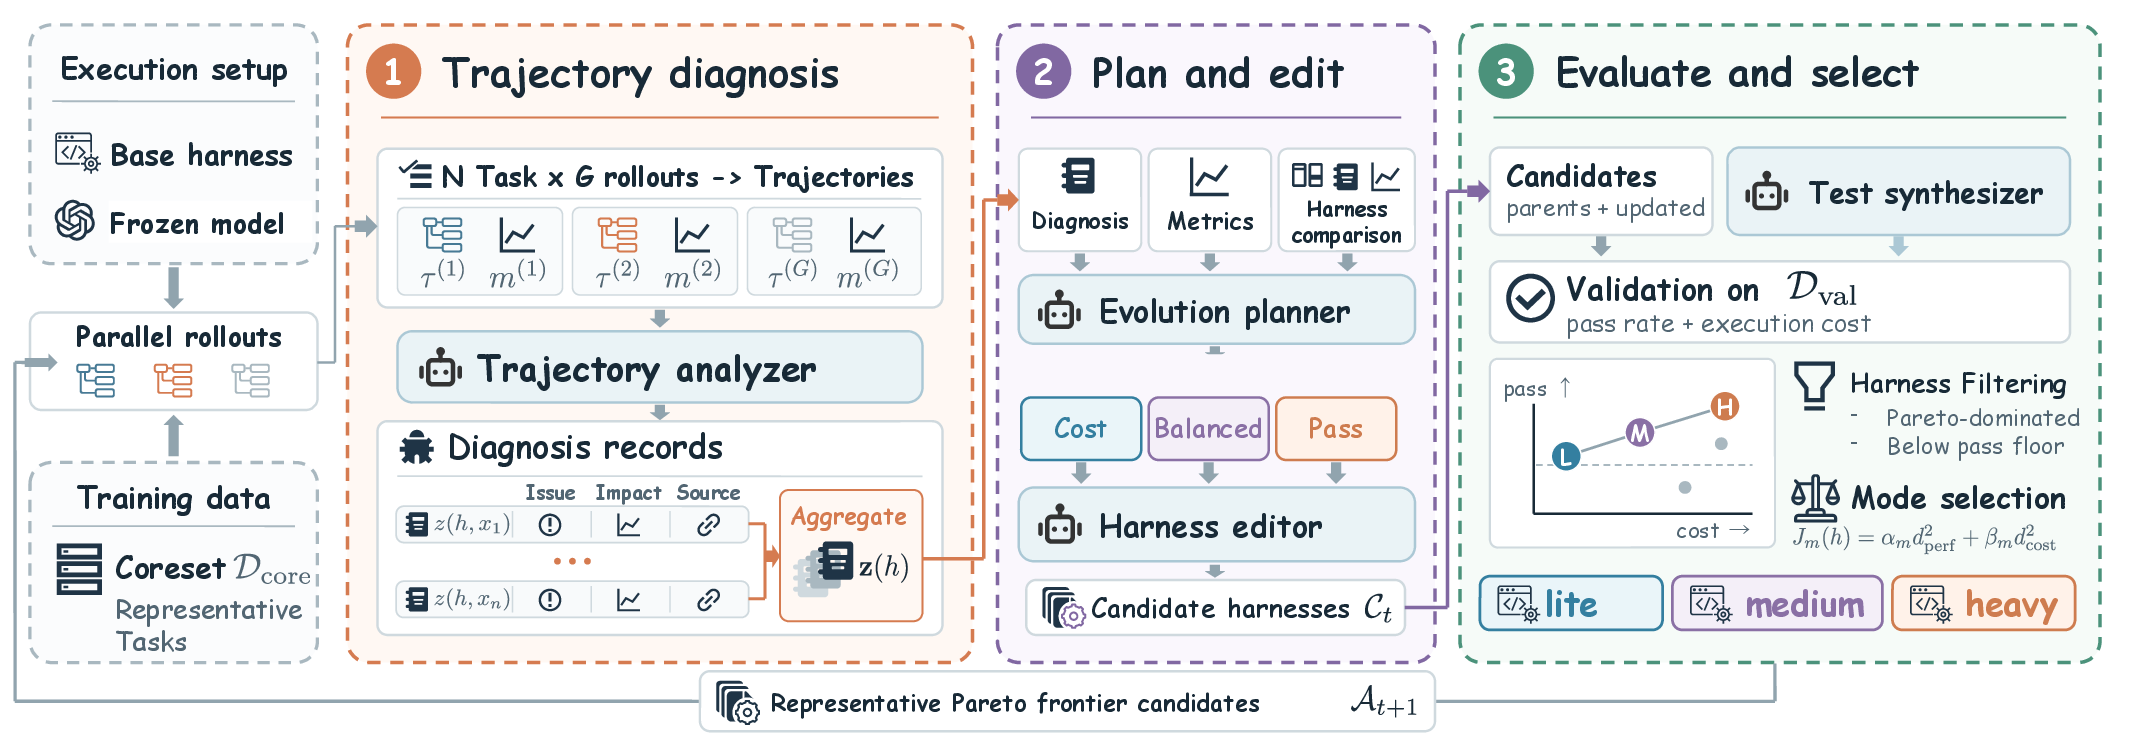
清华大学与 Z.AI(智谱)等机构的论文 HarnessPro(arXiv 2610.26770,10 月 19 日提交、10 月 20 日更新 v2)提出一种无需标准答案的 harness 自我改进方法:让专门的 agent 诊断执行轨迹、改写指令与运行时策略,再用 LLM 生成的测试评估,并按性能与成本给出 Lite、Medium、Heavy 三档 harness。论文口径:GPT-5.5 搭配 Codex 时,Heavy 档在 Terminal-Bench 2 达到 80.8%,比此前方法 RHO 高 4.5 个百分点,单任务成本从 1.09 美元降到 0.72 美元。代码以 MIT 协议开源,本周被 Pandaily 等媒体集中报道。

清华与智谱 Z.AI 开源 HarnessPro:Agent 自己改写 harness,Terminal-Bench 2 通过率 80.8%、单任务成本降 34%

核心要点速览

  • Terminal-Bench 2(GPT-5.5 × Codex,三次平均):Heavy 档 80.8%、单任务 0.72 美元;RHO 为 76.3%、1.09 美元,成本降 33.9%(论文口径,见 arXiv)
  • 三个基准平均:相对 RHO 通过率 +2.0 个百分点、单任务成本 -26.1%;基准为 Terminal-Bench 2、SWE-Bench Pro、ProgramBench
  • 换模型也成立:GLM-5.2 × Claude Code 在 Terminal-Bench 2 上,Heavy 档 81.4%、0.62 美元,对比原版 74.6%、0.92 美元和 RHO 78.0%、1.00 美元
  • 省钱档:Medium 档在 Terminal-Bench 2 上 76.3%(与 RHO 持平)但只要 0.56 美元;Lite 档 72.9%、0.43 美元
  • 训练代价小:每个基准只用 10 个训练任务、跑 3–4 轮进化,测试集为 59/100/100 个留出任务;GitHub 以 MIT 协议开源三档 harness
阅读全文

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

AI 编程 Agent 公司 Factory 10 月 29 日 22:31(UTC)在 X 和官方博客发布 Droid 1.0,称这是其 agent harness 迄今最大的一次更新。核心变化是把程序化工具调用(PTC)设为默认:模型写一段 JavaScript 脚本,在沙箱里一次跑完多达上百次工具调用。官方自测 Terminal-Bench 4 中,用 GPT-6.1 Sol 通过率 57.6%(每个通过任务 $0.79),用 Claude Opus 5.5 通过率 65.2%($4.73),均高于同模型下的 Codex、Claude Code、Cursor、OpenCode 和 Devin。

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

核心要点速览

  • 程序化工具调用成默认:模型写 JavaScript 脚本,在无文件/网络/系统权限的沙箱里运行,一次请求可跑上百次工具调用,互不依赖的调用并发执行
  • 官方示例:移动并核对 151 个 Linear issue 需 312 次工具调用,直接调用约 36 次请求、310 万输入 token,用 Script 只需 2 次请求、6.1 万 token
  • Terminal-Bench 4(Factory 自测,10 月 23–28 日,每任务 3 次):GPT-6.1 Sol 下 Droid 57.6% 对 Codex 54.0%、OpenCode 51.0%、Devin 45.0%;Opus 5.5 下 Droid 65.2% 对 Cursor/OpenCode 62.1%、Devin 59.6%、Claude Code 57.6%
  • 首轮请求从 20,887 降到 13,055 token(-37%),开局工具定义从 11 个减到 2 个;新加载的 MCP 工具追加到请求末尾,不破坏 prompt cache,生产中典型请求 98% 输入命中缓存
  • 已上线:macOS/Windows 桌面版、终端 TUI,以及 Droid SDK(@factory/droid-sdk);跑分为厂商自测,尚无第三方复现
阅读全文

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

Mistral 10 月 29 日发布改进版 Mistral Large 4(Le Chonk)并开放权重,已上架 Hugging Face(另有 NVFP4 量化版),API 名为 mistral-large-4。相比 10 月初的公开预览,多做了约三周强化学习:官方口径 FrontierCode 2.0 得分 19.7%、Terminal-Bench 4.0 从 28% 升到 41%,并新增 low/medium/high 三档推理。许可证为改版 MIT,商用可用,但做模型即服务需另签商业许可。

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

核心要点速览

  • 规格:约 1T 总参数、每 token 激活 49B(含嵌入和输出层约 52B),128 个路由专家每次激活 4 个外加 1 个共享专家,1M 上下文,文本+图像输入
  • Mistral 口径:Cognition FrontierCode 2.0 得分 19.7%,高于 DeepSeek V4.1 Flash 的 19.3% 和 GLM-5.3 的 17.8%,开源模型第一
  • Artificial Analysis 编码智能体指数 48%,与 GLM-5.3 基本持平,但平均每任务少用 47% 的 token;Terminal-Bench 4.0 由预览版 28% 提升到 41%
  • Artificial Analysis Cyber Index 51%;对恶意网络安全请求的平均拒绝率 96.6%,官方称为开源模型中最高
  • 在 Mistral 自有欧洲数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练;Surge Code 盲评中仅次于 Claude Opus 5.5
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文