AI 编程实时动态与要闻

X 热议:前 OpenAI 研究员 Will DePue 发布「检查点取证」报告,称在 DeepSeek、Kimi、MiniMax、蚂蚁 Ling 的 6 款开源模型权重里找到英伟达 Blackwell 初始化指纹;报告自称不能证明违反出口管制

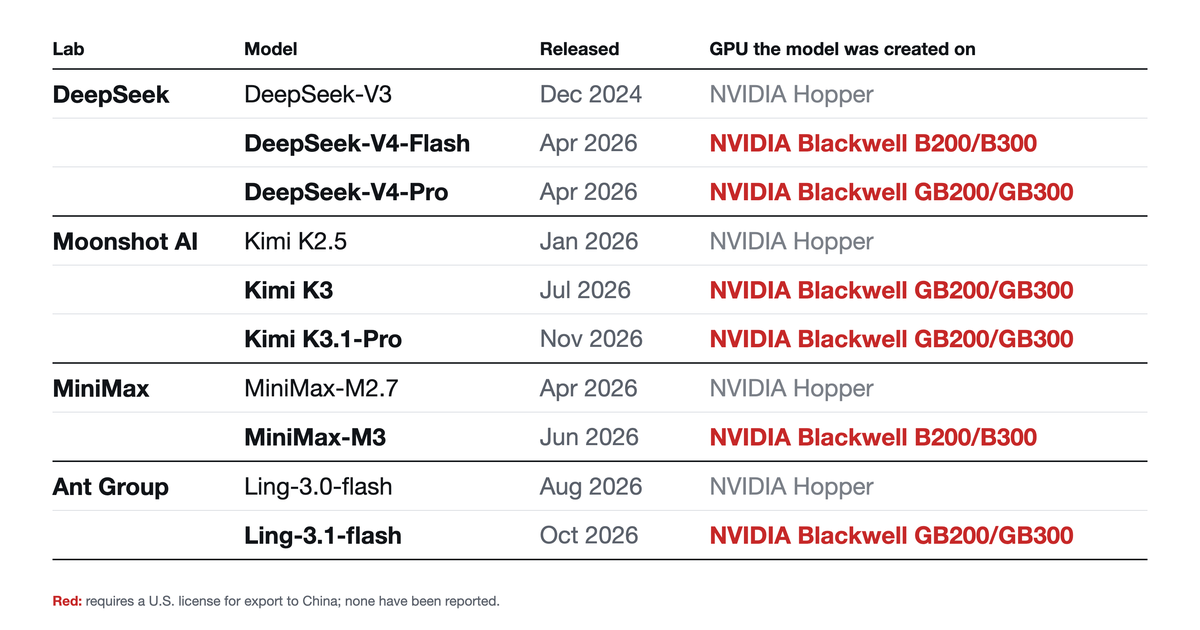
11 月 12 日,前 OpenAI 研究员 Will DePue 在 X 发帖并发布报告,称通过分析公开权重里残留的随机初始化模式,发现 DeepSeek-V4-Flash/Pro、Kimi K3/K3.1-Pro、MiniMax-M3、Ling-3.1-flash 六款模型是在英伟达 Blackwell 上初始化的,而这些公司更早的模型对应 Hopper。帖子约 205 万浏览、2 万赞。这是个人研究结论,不是官方认定;报告本身也写明,它不能确定芯片在哪里、如何获得,也不能确定是否违反出口管制。
X 热议:前 OpenAI 研究员 Will DePue 发布「检查点取证」报告,称在 DeepSeek、Kimi、MiniMax、蚂蚁 Ling 的 6 款开源模型权重里找到英伟达 Blackwell 初始化指纹;报告自称不能证明违反出口管制

核心要点速览

  • 6 款模型被判为 Blackwell 初始化(作者口径):DeepSeek-V4-Flash、MiniMax-M3 对应 B200/B300(148 个 SM);DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro、Ling-3.1-flash 对应 GB200/GB300(152 个 SM)
  • 方法:PyTorch 用 Philox 随机数按线程数填充初始权重,线程数由 GPU 的 SM 数决定;作者搜索约 6 万亿种「种子 + 布局」组合去匹配公开权重
  • 统计强度(作者口径):随机巧合最多约 8 sigma,六款模型的最强证据在 49–1,385 sigma 之间;在 24 个开发者公开过训练硬件的模型上,方法结论全部一致
  • 并非所有中国实验室:报告称 Qwen、GLM、腾讯、小米、阶跃的最新模型仍读作 Hopper,美团 LongCat-2.0 未发现英伟达指纹
  • 规模估算不确定:作者估计五次训练合计约 1.2 万张 Blackwell(区间 7,000–20,000),并明确说对估算「没有信心」;文中「OpenAI、Anthropic 资深研究员已独立验证」为其本人说法
阅读全文

X 热议:前 OpenAI 研究员 Will Depue 称人类「非手工」经济劳动「彻底完了」,好比卡尔森对 Stockfish;斯坦福数据显示 AI 暴露岗位年轻人就业已落后 19%

曾参与 Sora 1/2 和 o3、4o 后训练的前 OpenAI 研究员 Will Depue 11 月 10 日(新加坡时间 11 日 06:29)在一条回复里说,人类所有「非手工」经济劳动(价值不来自「由人完成」的工作)都「彻底完了」,以后就像卡尔森对 Stockfish 13。帖子约 13.5 万浏览、1000+ 赞、395 收藏,被 X 汇总成热门话题。他随后补充是「哲学意义上的结束」而非灾难。这是个人观点,不是预测数据;可对照的实证是斯坦福数字经济实验室 2026 年 8 月更新的论文:没有全经济范围的岗位替代,但 22–25 岁年轻人在 AI 暴露岗位的就业已比对照组低 19%。

核心要点速览

  • 原帖(个人观点):所有「非手工」经济劳动都「彻底完了」,「我们很快都会在场边看着」,类比 卡尔森 vs Stockfish 13;约 13.5 万 浏览、1027 赞、395 收藏、51 条引用
  • Depue 在后续回复里称,2–3 年内除前 3% 的人以外,任何科学领域的人都会被 AI 超越;又补充是「哲学意义上」的结束,「我们大概会没事」
  • 争论起点:CMU 助理教授 Niloofar Mireshghallah 批评 OpenAI 年轻员工轻视学术界,并说她每天面对担心前途的本科生和博士生,想给出更乐观的图景
  • 实证对照(斯坦福数字经济实验室,ADP 薪资数据截至 2026 年 6 月):没有全经济范围的岗位替代,但 22–25 岁 年轻人在 AI 暴露岗位的就业比对照组低 19%,主要来自少招新人而非裁员
  • 论文同时发现:AI 主要起「替代」作用的岗位下滑集中,主要起「辅助」作用的岗位就业持平或上升;作者强调这是描述性信号,不是因果估计
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Theo 分析 110 万次请求称 200 美元 Claude Ultra 每月约合 1.5 万美元 Opus 5.5 用量、Fable 5.2 只有约 3000 美元,「每周干完多少活」才是该比的指标

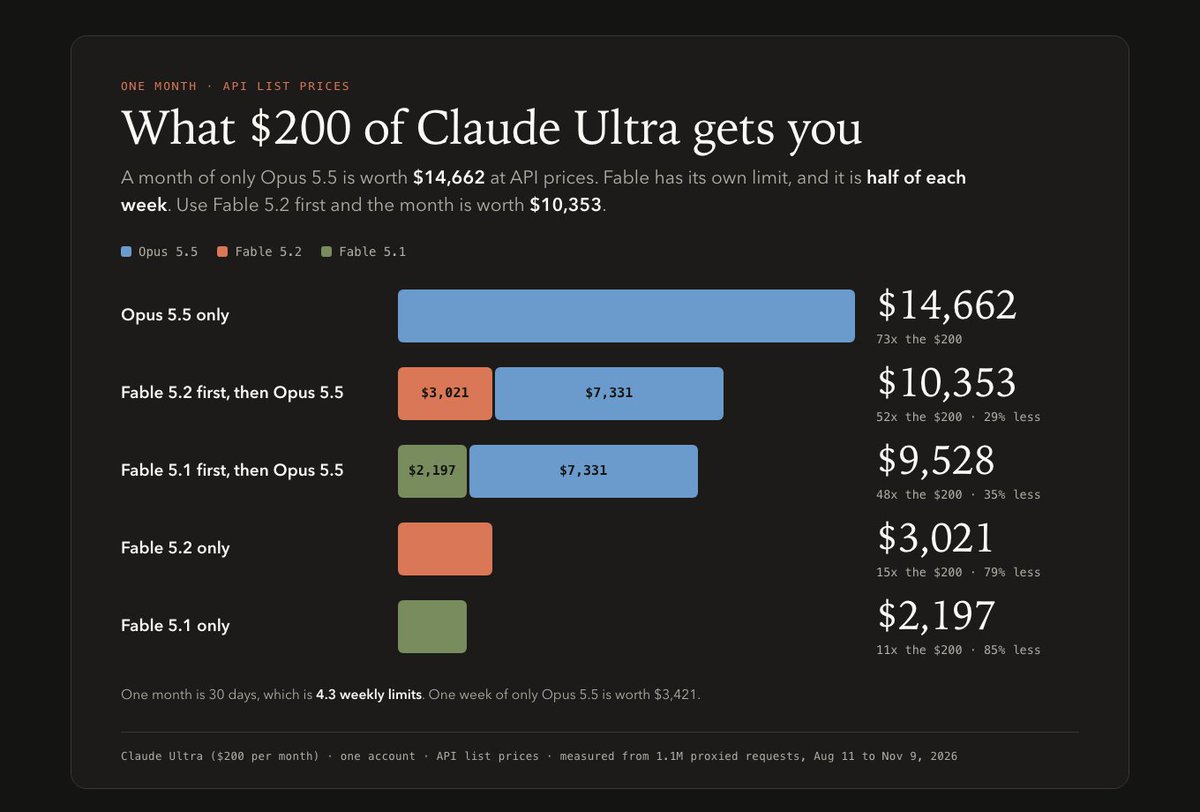
T3 Code CEO Theo 11 月 10 日发帖称,按他用 Ultra 订阅发出的 110 多万次真实请求折算,200 美元的 Claude Ultra 每月能用掉约 1.5 万美元 API 价的 Opus 5.5,换成 Fable 5.2 只有约 3000 美元。帖子获 3900 多赞、1000 多收藏。他也指出 Fable 更常一次做完任务,按每周完成的轮次算差距没那么大。这是个人样本,不是官方数据;官方确认的是 Fable 5.2 降价到 $8/$40,以及上线周的 Fable 用量规则。

X 热议:Theo 分析 110 万次请求称 200 美元 Claude Ultra 每月约合 1.5 万美元 Opus 5.5 用量、Fable 5.2 只有约 3000 美元,「每周干完多少活」才是该比的指标

核心要点速览

  • Theo 的估算(个人口径):200 美元 Ultra 每月约合 $15,000 的 Opus 5.5 API 用量,Fable 5.2 只有约 $3,000,相差约 5 倍;数据来自他 Ultra 订阅下 110 万+ 次真实请求
  • 按「每周完成的工作」算:只用 Opus 约 1200 轮、230 个会话;先用完 Fable 额度再切 Opus 约 900 轮、会话数略多。他认为 Fable 更常一次做完任务,但这周大量用量是在跑评测
  • 官方价格:Fable 5.2 为每百万 token $8 / $40,比 Fable 5.1 的 $10 / $50 低 20%;Opus 5.5 为 $4 / $20(Anthropic 发布页)
  • 官方上线福利:Pro 和 Team 标准席位一周内可用 Fable,至多占每周额度的 50%,外加 1 次 Fable 额度重置;Max、Ultra 与高级席位按订阅时长获得 1–3 次重置(帮助中心)
  • 帖子获 3900+ 赞、1084 收藏、约 28.7 万 次浏览;Theo 在回复里称 API 定价「严重虚高」,所以订阅显得格外划算
阅读全文

X 热议:Ethan Mollick 让 Claude 自主搭建「传送门」3D 网站,约 2.5 万次 Agent 运行做出 471 个世界,Agent 还自己长出了 204 节、8.75 万词的「官僚规则手册」

沃顿商学院教授 Ethan Mollick 11 月 9 日在 X 分享实验:他只给 Claude 一段描述,要求做一个穿过传送门、在 3D 世界间无尽飞行的网站,20 小时后上线 204 个世界,现已开源 471 个、约 140 万行 JavaScript。他在博客中写道,Agent 团队后来自发建立评审规则,规则手册膨胀到 204 节,开发速度从每天数百个跌到约十几个。帖子约 10 小时获 1262 赞、158 条回复。

X 热议:Ethan Mollick 让 Claude 自主搭建「传送门」3D 网站,约 2.5 万次 Agent 运行做出 471 个世界,Agent 还自己长出了 204 节、8.75 万词的「官僚规则手册」

核心要点速览

  • 一段描述起步,20 小时上线 204 个世界;仓库 README 显示截至 11 月 9 日共 471 个世界、约 140 万行 JavaScript(GitHub)
  • Claude 自己估计约 2.5 万次 Agent 运行,大多只做单一任务(如给图片打分);第 10 天形成 1 个主 Agent + 28 个并行团队(One Useful Thing)
  • Agent 自建评审制度:新版本须在 12 张测试截图上赢过盲评;规则手册 12 天内从 84 节涨到 204 节、8.75 万词,上线一个世界要约 1 天
  • 引入外部「顾问」Agent 团队梳理流程后,产出恢复到每天 30 个以上世界(Mollick 博客口径)
  • Mollick 帖子约 10 小时获 1262 赞、108 转发、158 条回复、约 6.2 万次浏览;回复焦点集中在「Agent 也会长出中层管理」和 token 成本
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

X 热议:OpenAI 总裁 Greg Brockman 转发 OpenTable 案例,称「接入 OpenAI 能带来大量生意」,Booking 财报电话会披露 ChatGPT 内订餐 9 月带来 19 万人次就座

OpenAI 总裁兼联合创始人 Greg Brockman 在 X 上引用 Juozas Kaziukėnas 的帖子,只写了一句「接入 OpenAI 能带来大量生意」。被引用的帖子指出,OpenTable 与 OpenAI 的原生集成在 9 月一个月带来 19 万名就座食客,并称这可能是最大的 Agent 商务成功案例之一。这个数字来自 Booking Holdings 11 月 3 日的 Q3 财报电话会,CFO Ewout Steenbergen 亲口披露。不过同一场电话会上,Booking 也强调 AI 渠道整体流量「仍然很小」,大模型引荐占 Booking.com 间夜量「远低于 1%」。讨论焦点在于:Agent 商务到底是真增量,还是基数很小的早期信号。

X 热议:OpenAI 总裁 Greg Brockman 转发 OpenTable 案例,称「接入 OpenAI 能带来大量生意」,Booking 财报电话会披露 ChatGPT 内订餐 9 月带来 19 万人次就座

核心要点速览

  • 数字:Booking Holdings CFO 在 Q3 财报电话会上披露,OpenTable 与 OpenAI 的原生集成 9 月带来 19 万名就座食客(seated covers,按人头计,不是订单数)
  • 定性:Booking CEO 称其为 OpenTable 增长最快的渠道之一,但强调是「从很小的基数」起步
  • 大盘:同一场电话会上,大模型引荐占 Booking.com 间夜量「远低于 1%」,AI 渠道流量整体「仍然很小」
  • 背景:据 Hospitality.today 报道,ChatGPT 订餐 8 月 10 日上线、覆盖所有套餐,9 月是第一个完整月;该媒体按 OpenTable 自称年服务 19 亿人次估算,19 万约占当月 0.1%
  • 观点:Brockman 借此强调接入 OpenAI 的商业价值;被引用的原帖作者也坦言数字高到要「三次核对」CFO 的原意,属于讨论而非定论
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Redis 作者 antirez 称拒绝 AI 编程辅助的人已明显落后,「活在泡沫里」、会更快丢掉工作

11 月 9 日 08:53 UTC,Redis 创始人 Salvatore Sanfilippo(@antirez)发帖说,他已经看到「明确的信号」:拒绝在编程中使用 AI 辅助的人正在明显落后,他们「活在一个泡沫里」,比其他人更快面临失去工作。约 3 小时内该帖获得约 355 赞、30 条回复、16 次转发和约 1.3 万次浏览。回复区分成两派:支持者把拒绝 AI 比作「放着汽车骑马」,也有人认为真正的差距在于天天用 Agent 的人更懂它在哪里出错;反对者则说这是「AI 鼓吹话术」,或认为不用 AI 的人反而保住了对系统的理解。也有人追问他到底看到了哪些信号,原帖没有给出具体例子或数据。这是个人观点帖,不是行业统计。

核心要点速览

  • 热度:@antirez 原帖发于 11 月 9 日 08:53 UTC,约 3 小时内 约 355 赞、30 条回复、16 次转发、约 1.3 万次浏览
  • 观点:拒绝 AI 编程辅助的人「正在明显落后」,活在泡沫里,失去工作会来得更快
  • 背景:antirez 的博客文章《Control the ideas, not the code》约 34 万次阅读,他已重新加入 Redis,并在开发本地大模型推理开源软件
  • 支持:有回复把拒绝 AI 比作「放着汽车骑马」;也有人说差距在于每天用 Agent 的人更懂它在哪里出错
  • 反对:有人称这是「AI 鼓吹话术」,也有人认为不用 AI 的人保住了对系统的理解
  • 注意:原帖没有给出具体信号或数据,有回复专门追问
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Theo 称自己进入「流失期」,嫌贵、MCP 烂、响应慢就让 Claude 现做一个替代品,警告跟不上快节奏客户的软件公司会被取代

11 月 9 日 03:41 UTC,T3 Chat / T3 Code 创始人 Theo(@theo)发帖说自己进入了「churn era(流失期)」:收费太贵,就自己「糊」一个替代品;MCP 服务器不好用,Claude 能做个更好的;响应太慢,Claude 不会;缺关键功能,也就一个提示词的事。他的结论是:跟不上「行动最快的那批客户」需求的软件公司会被取代。约 7.5 小时内该帖获得约 1,770 赞、205 收藏、135 条回复、19 条引用和约 7.5 万次浏览。讨论分成两派:有人晒出已用 AI 自建替代的 Mailchimp、Calendly 等订阅;也有人提醒 Theo 属于 1% 的重度用户,自建工具之后的维护和 bug 都得自己扛。这是个人观点帖,不是行业数据。

核心要点速览

  • 热度:@theo 原帖发于 11 月 9 日 03:41 UTC,约 7.5 小时内 约 1,770 赞、205 收藏、135 条回复、19 条引用、约 7.5 万次浏览
  • 观点:嫌贵、MCP 服务器不好用、响应慢、缺功能,都可以让 Claude 现做一个替代品
  • 结论:跟不上「行动最快的客户」需求的软件公司「会被取代」
  • 支持:引用帖里有人晒出已自建替代的 Mailchimp、Supabase Cloud、Google Analytics、Calendly 等订阅
  • 反对:有人指出 Theo 属于 1% 重度用户,多数人仍愿意付费;自建工具后维护和 bug 都得自己扛
  • 注意:这是个人观点,原帖没有给出任何流失率或市场数据
阅读全文

X 热议:Node.js / Deno 作者 Ryan Dahl 称软件工程已「100% 由 AI 编写」,AI 写 C++ 比他好,但「确保它能跑」的难题没有消失

11 月 9 日 04:11 UTC,Node.js 与 Deno 的作者 Ryan Dahl 在 X 上发帖:软件工程这么短时间就转成「100% AI 编写」令人震惊,更震惊的是工程师们照常工作,仿佛什么都没发生。他说 AI 写 C++ 比他自己写得好,但「确保它能正常工作」的问题并没有神奇地消失,大家只是在以更高质量交付多得多的代码。约 6 小时内该帖获得约 1,370 赞、236 收藏、83 条回复、25 条引用和近 9 万次浏览。引用帖分成几派:有人认为瓶颈已从写代码转向验证,测试和评审更值钱;有人质疑「100%」和「更高质量」的说法。这是个人观点帖,「100%」并非统计数据。

核心要点速览

  • 热度:@rough__sea 原帖发于 11 月 9 日 04:11 UTC,约 6 小时内 约 1,370 赞、236 收藏、83 条回复、25 条引用、近 9 万次浏览
  • 观点:软件工程已转向「100% AI 编写」,AI 写 C++「比我好」,但确保代码能跑的问题没有消失
  • 结论:工程师们在以更高质量交付多得多的代码量,却「照常工作,仿佛什么都没发生」
  • 分歧:引用帖有人称瓶颈已从生成转向验证,测试与评审更值钱;也有人直接质疑「100%」和「更高质量」
  • 注意:这是个人观点,「100%」不是统计口径,原帖未给出任何数据或项目来源
阅读全文

X 热议:Simon Willison 把 AI 写的 PR 描述折叠进 <details>,只留一段人工把关的开场白,称能让「PR 垃圾文」没那么累人

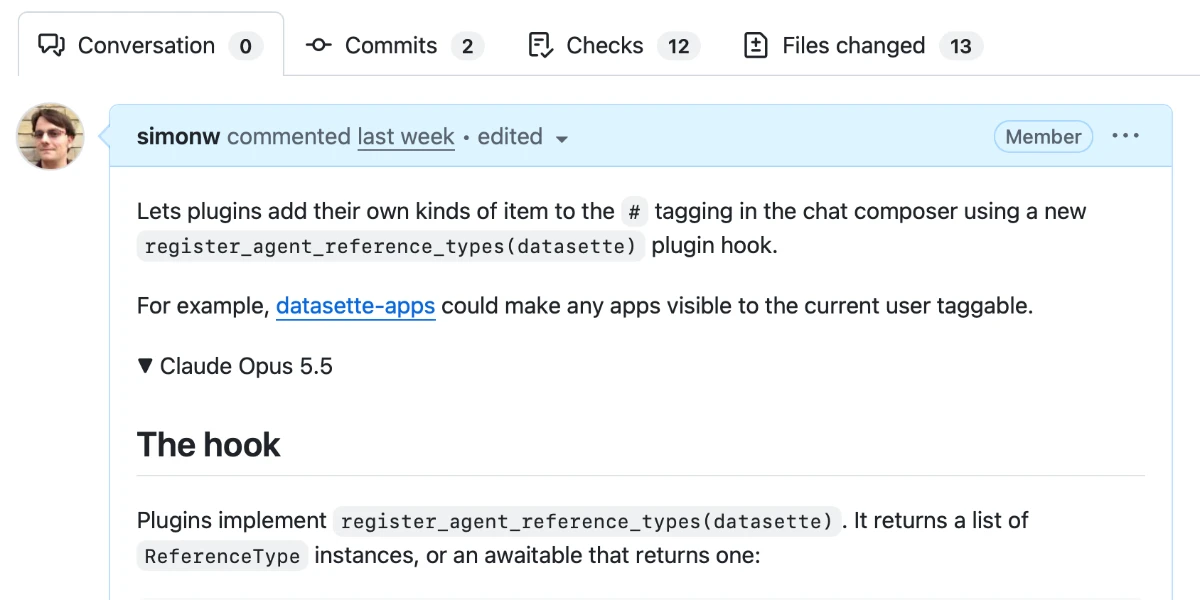
11 月 9 日,Datasette 作者、Django 联合创建者 Simon Willison 在 X 上说,他最近把 Claude Code、Codex 生成的 PR 描述大段折叠进 GitHub Markdown 支持的 <details><summary> 标签,认为这能让「PR 垃圾文」读起来没那么累。该帖约 4 小时内获得 650+ 赞、400+ 收藏、近 150 条回复。他在同日博客里解释:Agent 写的描述准确又全面,问题是太长,读着像垃圾文;他的做法是 PR 开头只放一段经人工判断的简短说明(必要时配截图),完整的 Agent 长文折叠起来,折叠标题写模型名和推理档位,比如「Claude Opus 5.5 Medium」。这是个人工作习惯分享,不是产品发布。

X 热议:Simon Willison 把 AI 写的 PR 描述折叠进 <details>,只留一段人工把关的开场白,称能让「PR 垃圾文」没那么累人

核心要点速览

  • 热度:@simonw 原帖发于 11 月 9 日 04:36 UTC,约 3.5 小时内 656 赞、409 收藏、149 条回复、3.8 万次浏览
  • 做法:PR 第一段是人工把关的最短说明,告诉读者这个 PR 做什么、值不值得细看,常配一张截图;Agent 写的完整描述放进 <details>
  • 标注:折叠标题直接写模型名 + 推理档位(如 Claude Opus 5.5 Medium),让读者一眼知道下面是 AI 写的
  • 实例:他列了 5 个近期 PR,涉及 datasette(#3052、#3043、#3042)、datasette-agent(#51)和 llm(#1838)
  • 回复区补充:</summary> 后要空一行,否则折叠块里的 Markdown 不渲染;也有人提醒,多轮修改后折叠的长描述可能和最终 diff 对不上
阅读全文

X 热议:Theo 称大模型「仍然很不擅长给 Agent 造工具」,让 Opus 搭 MCP 认证流程屡屡出错,提醒别轻信 Agent 给的 MCP「最佳实践」

T3 Chat / T3 Code CEO、YouTuber Theo(@theo)11 月 8 日发帖称,大模型「在给 Agent 造工具这件事上仍然非常糟糕」:每次让 Opus 搭建 MCP 认证路径,它都会做出离谱的假设,写出「根本跑不通」的东西。两小时后他追发一帖:他在写一份给自家 Agent 用的「MCP 正确用法」指南,先让 Agent 起草初稿,结果 Agent 建议把 MCP 地址渲染成给用户点击的链接,他直言「别相信 Agent 关于 MCP、连接策略和 Agent『最佳实践』说的任何话」。截至发稿,主帖约 880 赞、136 条回复、6.5 万次浏览。

X 热议:Theo 称大模型「仍然很不擅长给 Agent 造工具」,让 Opus 搭 MCP 认证流程屡屡出错,提醒别轻信 Agent 给的 MCP「最佳实践」

核心要点速览

  • 主帖(@theo,11 月 8 日):让 Opus 搭 MCP 认证路径时,它总会「做出离谱的假设」,写出「根本跑不通」的实现
  • 追帖(@theo):Agent 起草的「MCP 正确用法」指南建议把 MCP 地址渲染成可点击链接,Theo 称 Agent 在 MCP 和连接策略上「一无所知」
  • 热度(X 公开数据,截至发稿):主帖约 880 赞、136 条回复、138 次收藏、约 6.5 万次浏览;追帖约 344 赞、51 条回复、164 次收藏
  • 背景:MCP 授权规范基于 OAuth 2.1,要求客户端实现 PKCE,并引用受保护资源元数据(RFC 9728)、动态客户端注册(RFC 7591)等多份标准;stdio 传输则不走这套流程(MCP 规范)
  • 回帖观点:有人认为 MCP 认证一年里改过几版、训练数据跟不上;也有人建议先把规范原文和一个能跑通的请求喂给模型,无头服务器场景默认用设备码授权(RFC 8628)
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

X 热议:Eric S. Raymond 称刻意只和 AI「聊天写代码」,不碰子 Agent、技能库和「软件工厂」,把「苦涩的教训」用在自己的工作流上

开源运动代表人物、《大教堂与集市》作者 Eric S. Raymond(ESR)11 月 8 日发长帖称,他刻意把使用大模型的方式保持得「极其简单,甚至原始」:不派生子 Agent、不积累技能库、不搭建无人值守的「软件工厂」,只和「机器人朋友」对话,让它分析和生成代码,并称至今没看到这样会损失效率的有力证据。他的理由是:这些复杂流程都是在弥补前沿模型「还不够聪明」,而模型一直在变强,花心思学习「半衰期很短」的流程不值得。截至发稿,该帖约 1,300 赞、127 条回复、2.6 万次浏览。同一时段,Box CEO Aaron Levie 则发帖力挺 Agent 集群,形成鲜明对照。

核心要点速览

  • 原帖(@esrtweet,11 月 8 日):只和模型对话来分析、生成代码,不用子 Agent、技能库和无人值守的「软件工厂」,称「还没看到这会让我损失效率的有力证据」
  • 核心论证:复杂流程是在弥补模型「还不够聪明」,模型持续变强,这些流程的「半衰期」很短;他称这是把 Rich Sutton 的 「苦涩的教训」 用在自己的工作流上
  • 热度(X 公开数据,截至发稿):约 1,316 赞、127 条回复、78 次转发、214 次收藏、约 2.6 万次浏览
  • 反方:Box CEO Aaron Levie 同日发帖称,Agent 集群把效率提升从「大约 20%–50%」变成「没有明确上限」,编码、网络安全、生命科学都会受益
  • 中间派:有开发者回应「先靠对话把问题想清楚,再去搭工厂」;也有人认为 harness 的能力迟早会被模型本身吸收
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:开源工具 BLA(Blind LLM Agents)专门反制 AI 逆向 Agent REA,往构建产物里埋诱饵与资源陷阱,项目自称让逆向多烧 300–2800 倍 Token,GitHub 已近 3800 星

过去一天,X 上大量开发者转发讨论开源项目 BLA(Blind LLM Agents,GitHub qybaihe/bla,MIT 许可)。它被定位为 AI 逆向工具 REA(Reverse Engineer Anything)的「反制盾」:在 JS 包、Electron .asar、WASM、SQLite、Go/原生二进制等构建产物里植入假密钥、诱饵逻辑和触发分析器上限的资源陷阱,让 AI 逆向 Agent 在死胡同里耗尽预算,而正常用户运行结果不变。账号 codila 的介绍帖获得约 5,700 赞、65 万次浏览;自称作者的 Timo Zhang(@xteam3301)11 月 8 日发帖称项目几周内获得 3,278 星。截至发稿,GitHub 显示约 3,800 星、466 fork,11 月 8 日连发 v3.1.2 与 3.2.0。300–2800 倍等数字是项目自己的估算,尚无第三方复测。

X 热议:开源工具 BLA(Blind LLM Agents)专门反制 AI 逆向 Agent REA,往构建产物里埋诱饵与资源陷阱,项目自称让逆向多烧 300–2800 倍 Token,GitHub 已近 3800 星

核心要点速览

  • 项目(GitHub qybaihe/bla):MIT 许可,提供 CLI、MCP 服务器和 Vite/Rollup/Webpack/esbuild 插件,一条 npx bla-agents harden . 即可对构建产物做「审计→加固→验证」
  • 原理(项目 README 口径):三板斧是投毒(假凭据、蜜罐 SourceMap、影子状态机)、耗尽(故意触发 REA 的 ASAR 16MiB、WASM、JSON 嵌套等分析上限)和绑定(多产物 SHA-256 互相校验,防止诱饵被剥离)
  • 数字要分开看:README 称对真实 REA 的实测会让多种格式报容量/预算错误;而「300–2800 倍 Token、约 640 倍平均放大」来自 14 个目标的内部估算表,项目自己标注为 internal estimates
  • 热度(X 公开数据):codila 的介绍帖约 5,700 赞、65 万浏览;自称作者的 Timo Zhang(@xteam3301)帖子称几周内 3,278 星;GitHub 当前约 3,800 星、466 fork
  • 讨论焦点:支持者把它看作 AI 逆向「军备竞赛」的防守方;也有人认为迟早会有人去逆向 BLA 本身。项目声明仅限保护自有或已授权软件
阅读全文

X 热议:YC 总裁 Garry Tan 开源 harness 评测,7 种「模型+harness」组合在 20 道任务上通过率都落在 71–79%,差距主要在成本:OpenClaw 每解一题约 $0.44,Claude Code $0.22,Codex $0.17

Y Combinator 总裁兼 CEO Garry Tan(@garrytan)于 2026-11-08 18:09 UTC 在 X 发帖,称出于好奇在做「frontier 模型 + harness」的开源评测,并贴出初步结论截图;随后公开了 GitHub 仓库 garrytan/g-harness-evals(MIT)。仓库做法是固定模型(Opus 5.5 或 GPT-6.1 Sol)和任务,只换 harness(系统提示、工具、记忆)。截图称 7 种组合在同样 20 道编码任务上通过率都在 71–79%,其中 14 道题在所有组合里结果相同,所以「测试太简单、分不出高下」,更难的 Terminal-Bench 复跑正在进行。成本差距明显:Opus 上 OpenClaw 约 $0.44/题、Claude Code $0.22、Hermes $0.24、QM $0.19;Sol 上 Codex 最便宜最快,$0.17。抓取时原帖约 312 赞、84 回复、117 收藏、约 4.2 万展示。仓库自带利益披露:QM 属于 YC 项目,YC 投资了 Hermes。

X 热议:YC 总裁 Garry Tan 开源 harness 评测,7 种「模型+harness」组合在 20 道任务上通过率都落在 71–79%,差距主要在成本:OpenClaw 每解一题约 $0.44,Claude Code $0.22,Codex $0.17

核心要点速览

  • 原帖:Garry Tan(简介「President & CEO @ycombinator」)2026-11-08 18:09 UTC 发帖,抓取时约 312 赞、16 转发、10 引用、84 回复、117 收藏、约 41,767 展示
  • 方法(仓库 README):固定模型 Opus 5.5 或 GPT-6.1 Sol 与 20 道公开任务,只换 harness;指标是通过率、每解一题成本、单次耗时
  • 通过率:7 种组合都在 71–79%,Opus 上 Claude Code 76.3%、Hermes 78.8%、OpenClaw 76.3%、QM 72.5%;95% 区间互相重叠,作者明确说「分不出高下」
  • 成本与速度:Opus 上 OpenClaw $0.44/题、99.4 秒/次,Claude Code $0.22、40.1 秒;Sol 上 Codex $0.17、30.1 秒(作者口径,描述性,未做显著性检验)
  • 定性:个人发起的开源评测引发的讨论,不是任何厂商的官方 Benchmark;作者自述 QM 是 YC 项目、YC 投资了 Hermes,gstack/gbrain 是他本人项目
阅读全文

X 热议:DeepMind 副总裁、Google Cloud 首席科学家 Pushmeet Kohli 称科研发现节奏出现「真正的相变」,并说未来几周发布会给出一瞥

Google DeepMind 副总裁、Google Cloud 首席科学家 Pushmeet Kohli(@pushmeet,个人简介写明该职务)于 2026-11-08 10:15 UTC 在 X 发帖称,在 DeepMind 的多个项目中,他们正见证科学发现节奏的一次「真正的相变」(genuine phase transition),并说「未来几周的发布里你们会看到一瞥」。他随后跟帖补充:随着这种 AI 驱动的加速展开,重点将是帮助更广泛的科学界负责任地使用这些工具。抓取时原帖约 1,996 赞、149 转发、48 引用、71 回复、272 收藏、约 72,735 展示。帖中未点名具体领域、模型或发现,也不是 Google DeepMind 官方账号公告。

核心要点速览

  • 原帖:Pushmeet Kohli(个人简介「Chief Scientist, Google Cloud. VP DeepMind」)2026-11-08 10:15 UTC 发帖,抓取时约 1,996 赞、149 转发、48 引用、71 回复、272 收藏、约 72,735 展示
  • 原话是:在 DeepMind 的多个项目中,他们正见证科学发现节奏的一次「真正的相变」,「未来几周的发布里你们会看到一瞥」
  • 跟帖(同一分钟发出)只补充:随着这种 AI 驱动的加速展开,重点将是帮助更广泛的科学界负责任地使用这些工具
  • 帖中没有点名学科、模型、产品或任何一项具体发现;回复区有人追问「哪一个发现从几年变成了几周」,作者未在原帖作答
  • 定性:DeepMind 副总裁的个人账号发言引发的讨论,不是 @GoogleDeepMind 官方公告,也没有新的官方数据或可核对的发布清单
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Claude Code 团队的 Addy Osmani 发长文《你的 coding agent 把你变成了经理》,把管理团队的方法映射到管 agent

Anthropic Claude Code 团队的 Addy Osmani(@addyosmani)于 2026-11-08 07:32 UTC 在 X 发布长文《Your coding agents made you a manager》,核心观点是:整天用 coding agent 的工程师其实在做管理,最有效的习惯依次是给 agent 可运行的验证手段、交代仓库里看不到的上下文、把重复纠正写进 CLAUDE.md、只对不能违反的规则用 hook 强制、先定计划再动手,并且「委派任务,不委派判断」。抓取时约 964 赞、1,528 收藏、101 转发、39 引用、约 5.4 万展示。这是员工个人文章引发的讨论,不是 Anthropic 官方公告或新功能发布。

核心要点速览

  • 原帖:Addy Osmani(个人简介「Claude Code @anthropicai」)2026-11-08 07:32 UTC 发布 X 长文,抓取时约 964 赞、1,528 收藏、101 转发、39 引用、94 回复、约 53,672 展示,收藏数高于点赞数
  • 文章按影响排序列出 10 条习惯,第一条是给 agent 能给出明确通过/失败的验证手段(测试、构建退出码、lint、截图),并让它出示结果作为证据
  • 规则分层:prompt、CLAUDE.md、skills 是 agent 可以自行判断的「请求」,hooks、deny 规则和托管设置才是总会执行的「要求」;ALL CAPS、「think harder」这类旧习惯应停用
  • 「纠正两次就重开」:两次纠偏失败后清空会话、改写 prompt;他自己日常同时跑 4–5 个后台 agent 加几个本地会话,并称有时已经太多(作者自述)
  • 定性:员工个人文章引发的讨论,文中没有新的官方数据或产品发布;引用帖中流传的「Claude 写了约 90% Claude Code 代码」等说法不在原文中
阅读全文
关联模型 / 智能体 / 厂商: