AI 编程实时动态与要闻

ClickHouse 开源 Loom:给编码智能体的共享记忆 + 实时代码索引,代码问答得分 0.78→0.84

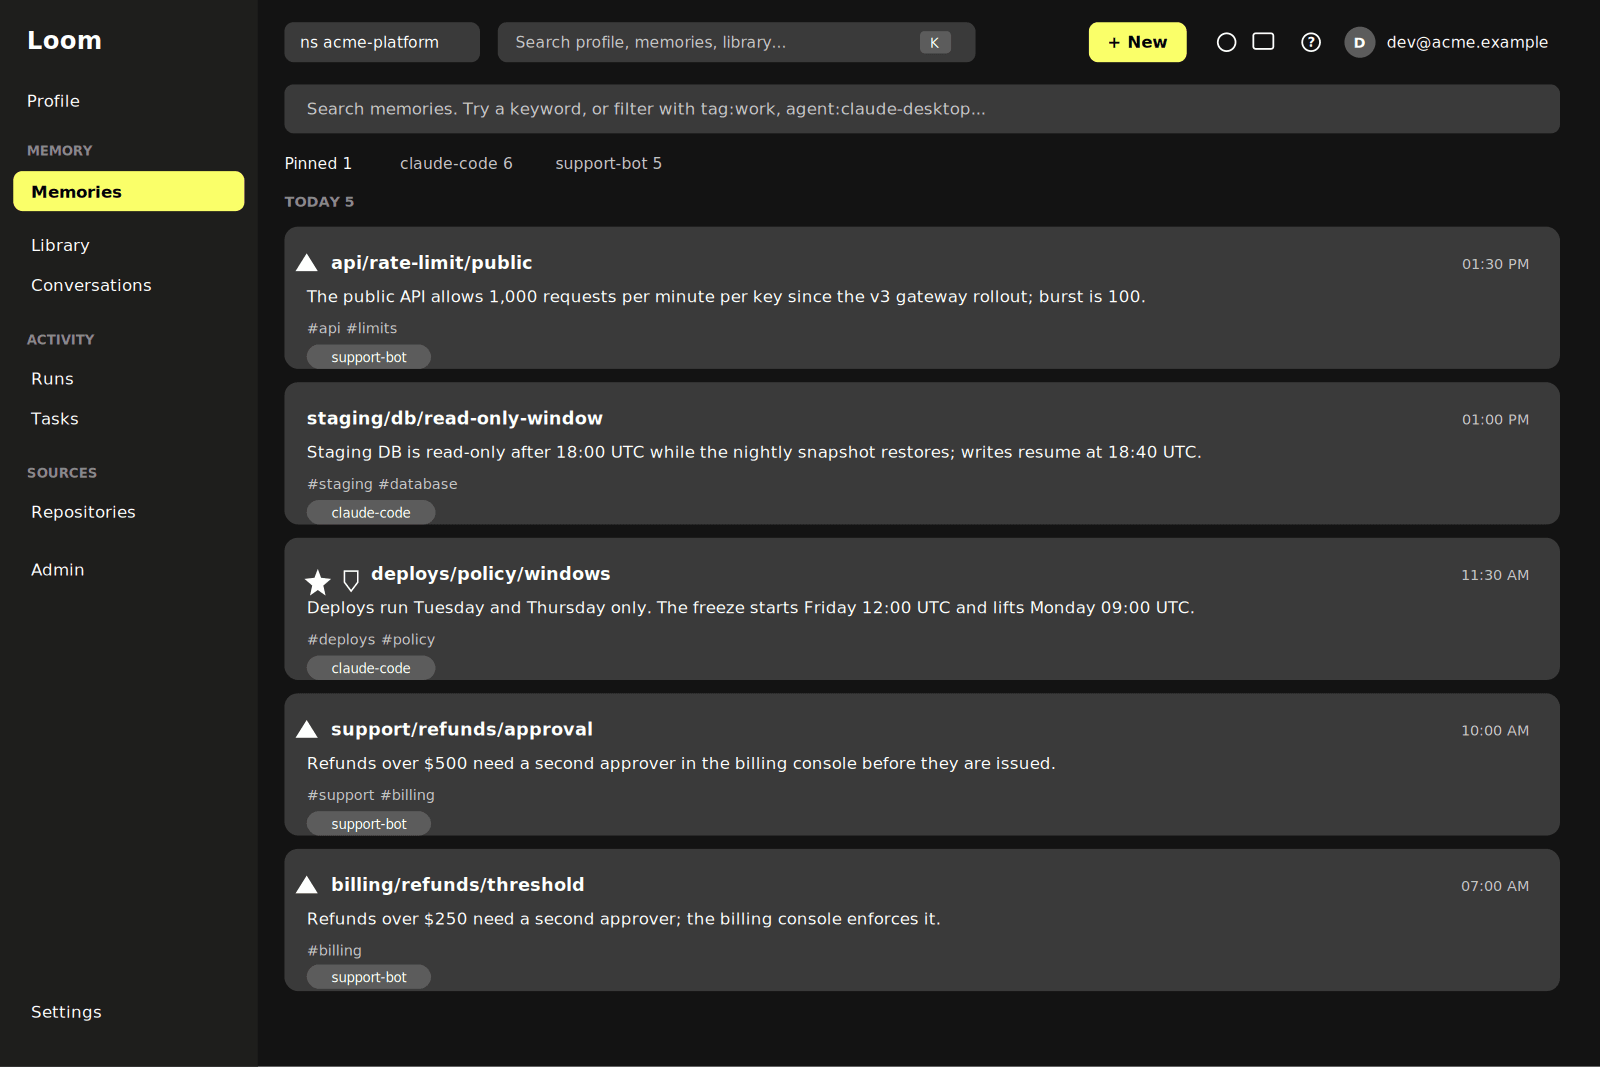
ClickHouse 发布开源(Apache-2.0)的智能体记忆系统 Loom,把记忆、代码索引和运行日志放进同一个 ClickHouse 库,记忆与代码关联,代码变动时标记可能过时的记忆。支持 MCP、HTTP API、Python/TS SDK,提供 Claude Code 和 Codex 插件。官方测试中代码问答平均分从 0.78 升到 0.84。
ClickHouse 开源 Loom:给编码智能体的共享记忆 + 实时代码索引,代码问答得分 0.78→0.84

核心要点速览

  • 代码问答(24 题×3 次)平均分 0.78→0.84,单题平均成本 $0.212→$0.17(官方口径,博客)
  • 找文件任务(36 题×10 次)准确率 91.4%→96.4%
  • LongMemEval-S 100 题:检索记忆 94% 对比塞入完整历史 90%,读取 token 少约 90%;完整 500 题 memory.ask 96.6%(官方口径)
  • 记忆与代码索引同库:函数改名会跟随,被重写则标记待复核,不自动改写
  • Apache-2.0 开源,需 ClickHouse 26.5+(推荐 26.8+),一行脚本用 Docker 启动
阅读全文

Anthropic 工程博文《Agent 记忆组件》:用「做梦」离线整理笔记、纠错并预载上下文,附 CL-Bench / Pokémon 评测

2026-11-06,Anthropic 发布工程博文《The components of agent memory》,系统阐述会话内记忆笔记与离线「做梦」(对照 transcript 纠错、建 wiki、提升记忆层级)。文中给出 CL-Bench、Pokémon 与内部语料 wiki 等评测示例;官方账号同步转发。属工程方法分享,非新产品 GA。

Anthropic 工程博文《Agent 记忆组件》:用「做梦」离线整理笔记、纠错并预载上下文,附 CL-Bench / Pokémon 评测

核心要点速览

  • 来源:Anthropic Engineering《The components of agent memory》(2026-11-06)+ @AnthropicAI
  • 核心:记忆笔记(会话内写规则)+ 做梦(空闲时对照 transcript 纠错、建 wiki、预载顶层记忆)
  • 评测示例:CL-Bench 数据库任务上 Opus 5+ 可闭环学习;Pokémon 中 Fable 5 九文件进度远超 Sonnet 3.7 的 413 文件
  • Wiki:对约 35 万内部文件,做梦 2→128 轮后 25 题评分约 13%→48%;搜索+wiki 约 61% vs 仅搜索约 53%
  • 落地:Claude Code auto memory 仅预载 MEMORY.md 前 200 行或 25KB;本稿为方法文,未宣布新公开 API
阅读全文

Letta 发布 FrontierMemory 1.0:首个按下游任务成绩衡量 Agent 记忆质量的基准,Opus 5.5 与 GLM-5.3 并列 73.3% 居首

10 月 21 日,Letta 发布 FrontierMemory 1.0。它不再考 Agent 记不记得生日、爱好这类事实,而是给 Agent 一批过去的执行轨迹,让它生成记忆或技能,再看这些记忆能让任务 Agent 多解出多少编码和知识工作任务。首版共 15 个任务,改编自 DeepSWE、SkillsBench、APEX-Agents 等公开基准。模型榜(Letta Dream 生成记忆,Letta Code 执行)上 Opus 5.5 与 GLM-5.3 均为 73.3%,Grok 4.7 为 33.3%;Harness 榜上 Letta 自家 Letta Dream 第一。数据为厂商(Letta)口径。

Letta 发布 FrontierMemory 1.0:首个按下游任务成绩衡量 Agent 记忆质量的基准,Opus 5.5 与 GLM-5.3 并列 73.3% 居首

核心要点速览

  • 模型榜(厂商口径,最高推理档):Opus 5.5 73.3%(单任务约 $2.80)、GLM-5.3 73.3%($3.58)、Kimi K3 66.7%、GPT-6.1 Sol 60.0%($0.77,最省)、Gemini 4 Argon 60.0%、Muse Wonder 46.7%、Grok 4.7 33.3%
  • Harness 榜:Letta Dream 73.3%、Prime Agent 60.0%、OpenAI Agents SDK 40.0%、Claude Managed Agents 33.3%、Hermes Agent 26.7%
  • 首版 15 个任务;665 条历史轨迹中只有 219 条与评测任务相关,Agent 需要自己挑出有用经验
  • Letta 称复核时发现保留下来的原始任务中 53% 的判题器有问题并已修复;记忆生成限时 6 小时、禁止联网
  • 记忆分三类:任务约定、用户偏好、环境特性;接受第三方提交模型与 Harness
阅读全文

零人工标注造就自进化智能体!DAEDALUS 框架开源:探索-解题双 Agent 自博弈练习,程序化记忆使成功率狂升 15.9%

大模型智能体进入陌生环境或操作新工具时,往往极度缺乏系统运维经验与环境隐性规则,导致在类似步骤中反复触礁。现有的智能体记忆系统严重依赖昂贵的人工标注指南或预先提供的基准任务与 Oracle 判定器。Illuin Technology 团队在最新研究(arXiv:2610.08048)中开源了全新无监督记忆自演进框架 DAEDALUS。DAEDALUS 独创“探索者(Explorer)与解答者(Solver)”双智能体自博弈范式:Explorer 自主在沙箱环境中挖掘有挑战性但可解的新任务;Solver 尝试解题并在遭遇失败时提炼启发式规则(Heuristics);只有当该规则在后续重试中持续带来确定性成功时,系统才会将其持久化写入记忆库。在 AppWorld、tau^2-bench 和 AutomationBench 三大高难度真实环境基准中,DAEDALUS 在零人工干预下将任务平均成功率最高提升 15.9 个百分点,Pass^5 成功率实现 2.2 倍翻倍提升,且提炼出的记忆规则具备出色的跨模型家族通用迁移能力。

核心要点速览

  • Illuin Technology 开源 DAEDALUS 框架,实现零人工标注与无 Oracle 判定器的智能体程序化记忆自演进
  • 首创探索者(Explorer)与解答者(Solver)自博弈架构,基于失败轨迹提炼可重复验证的黄金启发式规则
  • 在 AppWorld 等三大基准上任务成功率最高提升 15.9%,Pass^5 翻倍达 2.2x,沉淀出的经验具备跨模型通用迁移能力
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

记忆提取税暴降 3061 倍!Engram 发布预注册智能体记忆实验:原始轮次精选打平事实蒸馏,打破记忆神话

在自主智能体(LLM Agents)架构设计中,持久化跨会话记忆长期存在两条针锋相对的技术路线:一条主张使用昂贵的大模型异步将多轮对话‘蒸馏提取(Fact Extraction)’为三元组或结构化摘要记忆库(如 Mem0、Zep);另一条则主张直接保留‘原始对话轮次(Raw Turns)’并依靠检索排序进行上下文注入。学术界过去对两者的优劣各执一词。研究团队在 Zenodo 平台完成了严谨的科学预注册,并在 LoCoMo 与 LongMemEval 两大基准上展开了首个双盲受控实验(arXiv:2609.34227)。实验给出了令人震动的明确结论:在紧凑预算下,使用微型类型化决策模型 Jev 直接精选出的原始对话轮次,在下游任务准确率上与耗资巨大的大模型提取记忆库达成非劣效(Non-Inferiority,统计置信度 95%),而写入记忆的计算与 API 成本足足降低了 3,061 倍!此外,研究首次阐明了重排序(Reranking)与预算大小的因果关系,并指出盲目重排序会严重削弱智能体的正确弃权(Correct Abstention)能力。开源代码库与评估数据已发布(github.com/ris3abh/Engram)。

核心要点速览

  • 首个完成科学预注册的双盲智能体记忆实证研究 Engram,系统对比原始轮次精选与大模型事实提取
  • 紧凑预算下轻量决策模型 Jev 挑选的原始对话与昂贵 LLM 提取达成统计非劣效,而记忆写入成本骤降 3,061 倍
  • 揭示重排序增益随上下文预算扩大急剧衰减,并实证激进重排会破坏模型在证据不足时的正确弃权(Abstention)能力
阅读全文
关联模型 / 智能体 / 厂商:

彻底颠覆合成记忆刷榜!RealCompanion 发布 120 天真实对话集:揭秘真实场景记忆触发仅占 2.2%

在长记忆智能体(Memory-Augmented Agents)与伴侣型 AI 领域,学术界通常依赖合成人物画像与人工编造的问题进行记忆评测,导致测试集存在严重的“线索泄露(Cue Leakage)”与虚高得分。为了还原真实的长期人机交互真相,研究团队重磅发布了首个基于真人长达 120 天真实私密交互的权威评测集 RealCompanion(arXiv:2610.01780):涵盖 10 段完全真实的伴侣对话,跨越 27,218 条真实历史消息,并由人工逐级校验还原出精准的用户档案、人物画像、问答基准与严格对齐的推理思考链(Reasoning Traces)。实测揭示了三大颠覆性技术真相:其一,“过去的记忆极少被需要,且相隔遥远”——95.9% 的交互仅靠近期滑动窗口即可解答,仅有 2.2% 的探针真正需要检索远期记忆,传统聚合指标产生了严重统计假象;其二,现存的所有记忆触发检测器(Memory Detectors)在真实消息中几乎完全失效,合成基准的人为提问严重泄露了检索意图,单纯给消息贴上“记忆”标签就会诱导模型调用率暴增 10~14 个点;其三,测试的多款 Agent 系统在画像重构 F1 分数完全一致的情况下,API 算力消耗差距竟然高达 31 倍之巨。

彻底颠覆合成记忆刷榜!RealCompanion 发布 120 天真实对话集:揭秘真实场景记忆触发仅占 2.2%

核心要点速览

  • 发布首个基于 120 天真实真人交互的权威评测集 RealCompanion,彻底戳破合成数据“记忆刷榜”的虚高泡沫
  • 揭秘真实场景下仅有 2.2% 的对话真正需要调取远期记忆,95.9% 仅靠近期上下文即可完美解决
  • 实测现有记忆检测器在自然对话中几乎全军覆没,不同 Agent 架构在相同 F1 分数下的计算成本竟相差 31 倍
阅读全文
关联模型 / 智能体 / 厂商:

MemoryAthena 突破智能体检索瓶颈:潜在印记与反事实生成记忆动态融合,QA 跑分提升至 39.28

针对智能体长期记忆过度依赖显式检索表(RAG/Engram)而忽略模型内部自主生成有效记忆可能性的痛点,研究团队提出 MemoryAthena 架构。构建包含直接印记检索(E)、检索线索生成(GE)和因果骨干生成(GH)的三通道路由机制,仅凭轻量 201M 因果路由头与反事实未来 Token 似然优势即可实现自适应修正,在五项问答基准上将平均准确率由 37.65 跃升至 39.28。

MemoryAthena 突破智能体检索瓶颈:潜在印记与反事实生成记忆动态融合,QA 跑分提升至 39.28

核心要点速览

  • 三通道路由记忆范式:颠覆单纯从外部表中检索事实的传统方法,建立直接检索(E)、检索线索生成(GE)与骨干状态无表生成(GH)三大协同通道。
  • 轻量级因果干预路由头:主干模型与读者完全冻结,仅通过训练约 201M 参数的轻量因果路由头,根据反事实未来 Token 似然优势动态决定何时介入与插值强度。
  • 全方位能力增强与泛化:在五项长程问答基准评测中平均分从 37.65 提升至 39.28,在六项通用自然语言处理(NLP)基准上由 76.73 提升至 79.13。
阅读全文
关联模型 / 智能体 / 厂商:

CoreSpeed 上线:单一 MCP 端点连接应用、跨 Agent 记忆与媒体/网页/社媒工具

CoreSpeed(@CoreSpeedHQ)宣布产品上线:通过单一 MCP 端点连接应用,并内置跨 Agent 记忆、媒体生成、网页与社媒研究工具,以及 Agent 身份、预算与活动日志。起步地址 https://corespeed.io。

核心要点速览

  • 单一 MCP 端点连接应用与工具链。
  • 内置跨 Agent 记忆、媒体生成与网页/社媒研究。
  • 包含 Agent 身份、预算与活动日志。
阅读全文
关联模型 / 智能体 / 厂商:

LatentPress:把长对话与文档压成连续 memory tokens,冻结 LLM 直接读入

LatentPress 提出第三种上下文载体:连续 memory tokens。小 writer(约 4.2M–26.2M 参数适配器,约等于解码器 0.1%)把对话史与长文档压成 4–16×,冻结 decoder 经输入嵌入接口直接读取,推理时无需重建文本。LongMemEval 上 7.70× 压缩准确率 0.504,高于未压缩证据 0.490,并明显优于文本摘要与 OCR 压缩;写入约 43ms/会话,读取比原始上下文快 5–9×,利于长上下文智能体记忆。

核心要点速览

  • 表示:连续 memory tokens,冻结 LLM 经嵌入接口直读,无需重建文本。
  • 压缩:4–16×;LongMemEval 7.70× 时准确率 0.504,高于未压缩 0.490。
  • 效率:写入约 43ms/会话,读取比原始上下文快 5–9×,适配长上下文智能体。
阅读全文
关联模型 / 智能体 / 厂商: