AI 编程实时动态与要闻

Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

Perplexity 11 月 12 日发布 pplx-decider-v1.3(基于 Qwen3.8-27B,约 26.1B 参数)和蒸馏版 pplx-decider-flash-v1.3(基于 Qwen3.5-4B,约 4.5B),权重以 Apache 2.0 上架 Hugging Face,并通过 Decisions API 和 OpenRouter 提供。新版加入 Locate,可按标签或指令抽取原文片段并返回字符位置。官方称 v1.3 在 63 项分类任务上平均准确率 91.6%,比其生产分类器高 6.54 个百分点。
Perplexity 开源决策模型 pplx-decider v1.3:新增 Locate 原文片段抽取,26B 版 63 项分类任务平均准确率 91.6%,Apache 2.0,OpenRouter 免费至 11 月 19 日

核心要点速览

  • 两档开源权重:v1.3 约 26.1B 参数(Qwen3.8-27B 微调),Flash v1.3 约 4.5B(Qwen3.5-4B 蒸馏),均为 Apache 2.0;BF16 本地运行约需 49 GiB 显存
  • 新增 Locate:按标签或指令抽取原文片段,返回起止字符位置和分数,覆盖 NER、PII 检测、抽取式问答,可与分类、打分问题放在同一请求
  • 官方/厂商口径分类成绩:63 项分类任务平均准确率 91.6%,比 Perplexity 生产分类器高 6.54 个百分点;7 个领域全部领先 Jev 1.14,金融领域最多高 12.9 个百分点
  • 检索与稳定性:72 项检索任务 nDCG@10 为 83.99,比 Qwen3-Reranker-8B 高 1.81;输入改写后答案只变 0.27%,Jev 1.14 为 2.69%–4.84%
  • 上手渠道:Hugging Face 下载、Perplexity Decisions API、OpenRouter(两款 v1.3 模型 11 月 19 日前免费)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-decider-v1.3⚡ pplx-decider-flash-v1.3⚡ Qwen3.8-27B⚡ Qwen3.5-4B⚡ Jev 1.14⚡ Qwen3-Reranker-8B🌐 Perplexity🌐 Hugging Face🌐 OpenRouter
Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

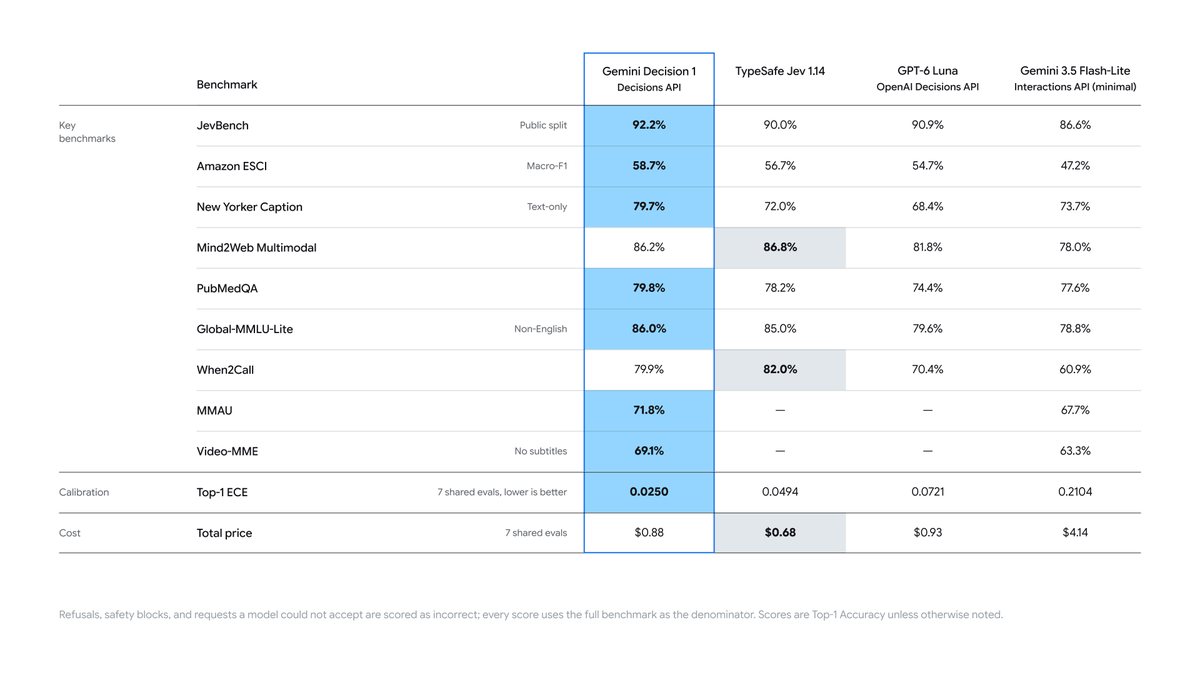
Google 11 月 11 日(北京时间 12 日凌晨)由 Sundar Pichai、@Google、@GoogleAIStudio 和 Logan Kilpatrick 正式宣布 Gemini Decisions API 与专用判定模型 Gemini Decision 1(gemini-decision-1)。它不逐 token 生成文字,而是一次前向计算给最多 1,000 个是否、单选(2–255 个选项)、打分题给出概率和置信度,支持文本、图片、音频、视频和 PDF,上下文 256K。官方称端到端延迟 150–250 毫秒,1 到 100 题延迟几乎不变;输入每百万 token 0.10 美元,输出不计费,在共享评测集上总成本约为 Gemini 3.5 Flash-Lite 的五分之一。官方跑分表中,它在 9 项评测里 7 项第一,7 项共享评测的 Top-1 校准误差 0.0250,低于 TypeSafe Jev 1.14 和 OpenAI 的 GPT-6 Luna。此前本站依据 API 更新日志报道时官方尚未公告,现已正式发布,此前「模型被撤下」的说法不成立。第三方 Artificial Analysis 测得其 Decision Index 为 66 分,尚未登顶。

Google 正式发布 Gemini Decision 1 与 Decisions API:一次最多判 1,000 题、端到端 150–250 毫秒,9 项评测 7 项领先、校准误差最低,输入每百万 0.10 美元且输出不计费

核心要点速览

  • 官方正式发布:Sundar Pichai、@Google、@GoogleAIStudio、Logan Kilpatrick 同步宣布,模型 ID gemini-decision-1
  • 单次最多 1,000 个问题、上下文 256K;模型计算中位数 50–100 毫秒,端到端 150–250 毫秒(官方口径)
  • 官方跑分:9 项评测 7 项第一,如 JevBench 92.2%、Amazon ESCI 58.7%;Mind2Web 多模态 86.2% 和 When2Call 79.9% 落后 TypeSafe Jev 1.14
  • Top-1 校准误差 0.0250,TypeSafe Jev 1.14 为 0.0494、GPT-6 Luna 为 0.0721、Gemini 3.5 Flash-Lite 为 0.2104;第三方 Artificial Analysis:Decision Index v2.1 66 分,落后榜首 Drex Max v1.1 / GLiDE v1.2(73)7 分,Brier 0.18
  • 价格:输入 0.10 美元/百万 token、输出 0;7 项共享评测总花费 0.88 美元,Flash-Lite 为 4.14 美元,TypeSafe Jev 1.14 为 0.68 美元更便宜
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini Decision 1⚡ Gemini Decision 1🌐 Google

Artificial Analysis 发布 Decision Index v2:改用奖励「校准置信度」的 Decision Score,私有数据占比升至 45%,Drex Max v1.1 以 73 分险胜

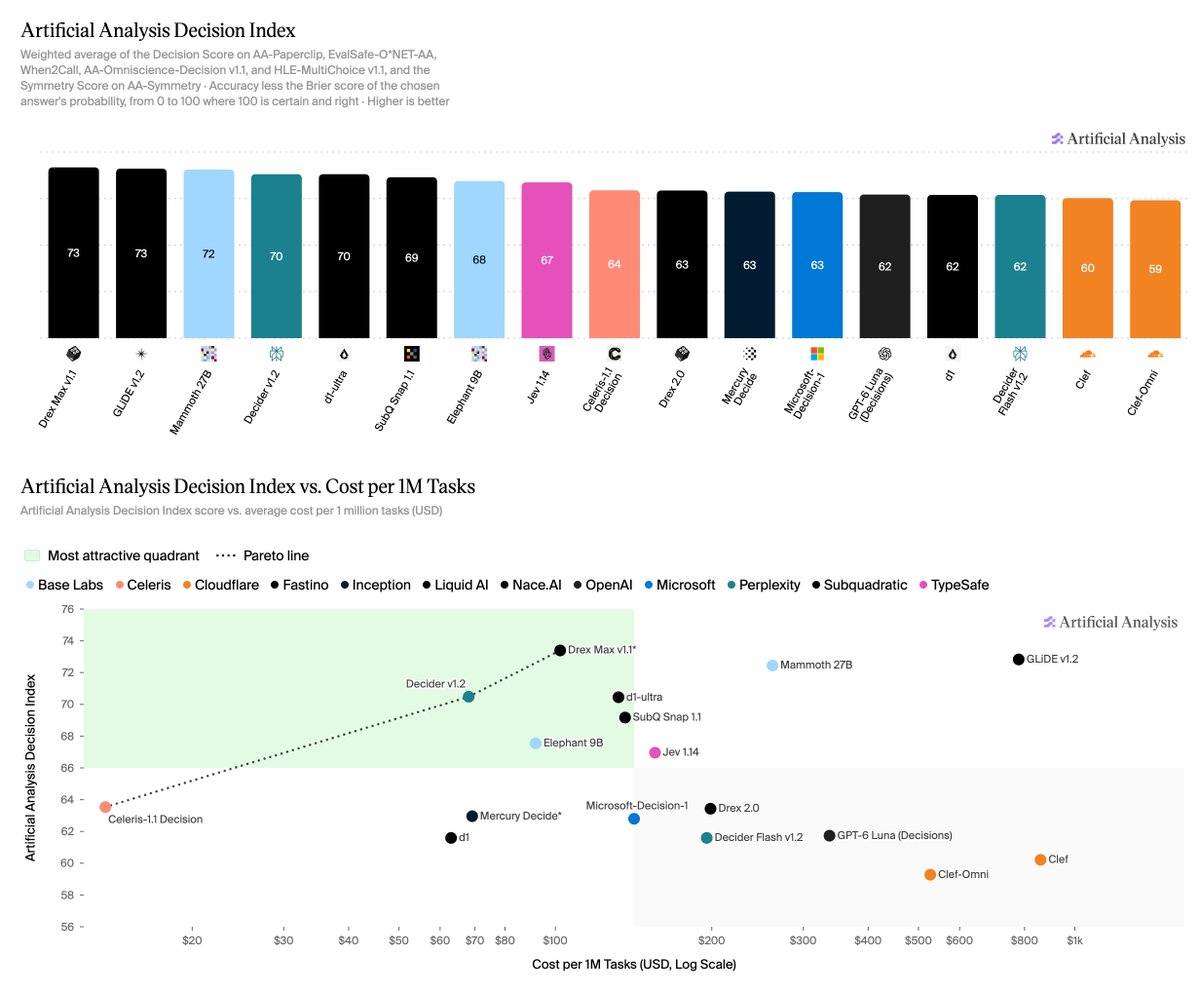
11 月 8 日(北京时间 11 月 9 日早上),独立评测机构 Artificial Analysis 发布决策模型榜单 Decision Index 第二版。新版把头号指标换成同时看「答对没有」和「置信度准不准」的 Decision Score,私有数据占比从 v1 的 25% 提到 45%,新增 1,500 份私有文档的 AA-Paperclip 和测一致性的 AA-Symmetry。决策模型中 Nace AI 的 Drex Max v1.1 与 Fastino 的 GLiDE v1.2 同为 73 分,Drex Max 以小数微弱领先,Base Labs 的 Mammoth 27B 72 分。通用大模型 Claude Haiku 5.5 (Max) 77 分、GPT-6 Luna (Max) 76 分更高,但每百万任务成本分别为 6,240 和 1,530 美元,远高于 Drex Max 的 102 美元。

Artificial Analysis 发布 Decision Index v2:改用奖励「校准置信度」的 Decision Score,私有数据占比升至 45%,Drex Max v1.1 以 73 分险胜

核心要点速览

  • 新指标(官方榜单):单题得分 = 50 ×(1 + c −(p − c)²),整体等于 50 ×(1 + 准确率 − Brier 分数),答对必高于 50、答错必低于 50,置信度在各自半区内拉开差距
  • 权重重排:AA-Paperclip 30%、AA-Symmetry 15%、EvalSafe-O*NET-AA 15%、AA-Omniscience-Decision v1.1 15%、HLE-MultiChoice v1.1 15%、NVIDIA When2Call 10%(v1 为 25%),饱和的 WildGuardTest 被移除
  • 决策模型前三(官方口径):Drex Max v1.1 73、GLiDE v1.2 73、Mammoth 27B 72;通用模型 Claude Haiku 5.5 (Max) 77、GPT-6 Luna (Max) 76
  • 成本差距超 60 倍:Celeris-1.1 Decision 每百万任务 14 美元、Drex Max v1.1 102 美元、Clef 859 美元;GLiDE v1.2 每道题重复计费输入,成本 780 美元,约为 Drex Max 的 8 倍
  • 速度:Celeris-1.1 Decision 单任务 56 毫秒、Elephant 9B 70 毫秒;GPT-6 Luna (Max) 11.34 秒、Claude Haiku 5.5 (Max) 32.65 秒
阅读全文
关联模型 / 智能体 / 厂商:

阿里淘宝 MNN 团队开源 3 亿参数端侧模型 MNN-Pocket-0.3B:INT4 版仅 173MB,iPad Pro M5 解码最高 466 token/s,Apache 2.0

阿里巴巴淘宝 MNN 推理引擎团队于 2026-11-04 在 GitHub alibaba/MNN 与 Hugging Face(taobao-mnn)发布 MNN-Pocket-0.3B,这是一个与 MNN 推理栈协同设计、面向手机 App 的约 3 亿参数中英双语指令模型,Apache 2.0 许可。官方模型卡称:INT4(W4A16)QAT 构建仅 173MB,支持 32K 上下文,在 iPad Pro M5(Metal)上解码最高 466 token/s,iPhone 18 Pro 实测约 350 token/s;在 11 项中英评测上平均 50.00,高于 Qwen3-0.6B(44.28)等更大的约 5 亿参数基线(均为官方口径)。同系列还放出 Base、SFT、GGUF、MNN 端侧包和一次前向即作答的 Dec 决策模型。11-08 起已有第三方 iOS 应用 Local LLM 接入、社区转出 LiteRT 版本。官方明确不建议用于高阶数学和长代码生成。

阿里淘宝 MNN 团队开源 3 亿参数端侧模型 MNN-Pocket-0.3B:INT4 版仅 173MB,iPad Pro M5 解码最高 466 token/s,Apache 2.0

核心要点速览

  • 规格(官方模型卡):约 3 亿参数、28 层、隐藏维度 896、GQA 14 头/2 KV 头、词表 65,536,部署支持 32K 上下文,中英双语
  • 体积与速度(官方口径):INT4(W4A16)QAT 构建 173MB;512 token 上下文下 iPad Pro M5 Metal 预填充 8,721 token/s、解码 466 token/s,骁龙 8 Gen 5 CPU 解码 251 token/s;GitHub README 称 iPhone 18 Pro 解码约 350 token/s
  • 跑分(官方口径):11 项中英评测平均 50.00,INT4 版 49.59,仅掉 0.41 分;IFEval 73.20、GSM8K 54.36、HumanEval 53.66,平均分高于 Qwen3-0.6B(44.28)和 MiniCPM4-0.5B(46.81)
  • 全家桶:Base、SFT、指令版、GGUF(llama.cpp)、MNN 端侧包,以及一次前向作答的 Dec 决策模型;Apache 2.0 可商用
  • 定位:官方建议用于端侧助手、信息抽取和轻量 Agent 流水线,不建议做高阶数学或长代码生成
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MNN-Pocket-0.3B⚡ Qwen3-0.6B⚡ MiniCPM4-0.5B🌐 Alibaba🌐 Taobao mnn
AD赞助内容

Kakao 开源 Kanana-2-v-decide-3b:3.67B 多模态决策模型,输出概率/选择/分数,厂商口径 Decision Index 均值 61.23

Kakao 于 2026-11-06 在 Hugging Face 开源 Kanana-2-v-decide-3b-2611(约 3.67B),基于 Kanana-2-v-3b:不生成自然语言,只返回 choice / noul / score 及概率。厂商口径:Kanana Decision Bench 72.50;Decision Index+Vision 均值 61.23;H200 单卡平均 <0.04 秒,称较 GPT-6 Luna 约快 43 倍。Kanana Open License 可商用。

Kakao 开源 Kanana-2-v-decide-3b:3.67B 多模态决策模型,输出概率/选择/分数,厂商口径 Decision Index 均值 61.23

核心要点速览

  • 官方:HF 开源 kakaocorp/kanana-2-v-decide-3b-2611(~3.67B),Kanana Open License 可商用
  • 形态:嵌入相似度 + softmax;输出 choice / noul / score,不生成句子
  • 厂商口径:Kanana Decision Bench 72.50;Decision Index+Vision 均值 61.23
  • 厂商口径:H200x1 平均 <0.04s,称较 GPT-6 Luna 约快 43 倍
  • 上手:transformers system_one / pipeline("decision") 或 HTTP System One
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kanana-2-v-decide-3b-2611⚡ Kanana-2-v-3b⚡ GPT-6 Luna🤖 Agent decision / tool selection🌐 Kakao

Sarvam 发布开源决策模型 Prism:基于 Sarvam 105B,单次前向只输出选项概率,中位响应 44 毫秒,Apache 2.0

印度 AI 公司 Sarvam 于 11 月 3 日发布 Sarvam Prism,一款面向企业工作流的「System One」决策模型:给定上下文和若干带固定选项的问题,它在一次前向计算里直接返回每个选项的概率,不生成文本。官方称在其测试的 25 个决策模型中,Prism 三项指数平均 71.8 分、在单张 B200 上中位响应 44 毫秒,是 100 毫秒内得分最高的模型;印度语言基准 82.5。权重以 Apache 2.0 发布在 Hugging Face,同时提供托管 API。以上分数均为 Sarvam 自测。

Sarvam 发布开源决策模型 Prism:基于 Sarvam 105B,单次前向只输出选项概率,中位响应 44 毫秒,Apache 2.0

核心要点速览

  • 基于 Sarvam 105B(105B-10B MoE 基座)训练,只输出选项概率,答案一定落在给定选项内。
  • 官方口径三项指数:Jev Decision Index 67.0、自建的 Artificial Analysis 决策指数复刻版 65.9、内部印度语言基准 82.5,平均 71.8;Perplexity Decider v1.2 平均 68.0 但响应约 117 毫秒。
  • 校准:英文 90% 以上置信度回答,预期错误 3.3%、实际 2.2%;印度语言预期 5.4%、实际 4.4%,对比模型低估错误 1.5 到 4.8 倍。
  • 先把选项排成固定顺序再打分,2,000 道题四次打乱选项顺序后 0 道答案改变。
  • 评测 700 条 Agent 运行记录,整体判断准确率 78.5%,Claude Haiku 5.5 为 70.7%。
  • 本地部署需一张支持 FP8、约 120GB 空闲显存的 GPU(如 B200/H200),权重约 106GB。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Sarvam Prism⚡ Sarvam 105B⚡ Perplexity Decider v1.2⚡ Jev 1.14⚡ Microsoft-Decision-1⚡ Claude Haiku 5.5🌐 Sarvam

Cadence 发布 Maestro 芯片设计领域 AI 模型组合:结合 NVIDIA Nemotron 驱动 AI Super Agents,官方称质量最高提升 30%、token 效率最高 5 倍

EDA 巨头 Cadence 10 月 26 日发布 Maestro AI 模型组合,包含领域后训练 LLM、决策模型和可自我改进的 agent skills,用来驱动其 AuraStack、ChipStack、InnoStack、ViraStack 等 AI Super Agents 操作 EDA/SDA 工具。Cadence 用确定性求解器给输出打分,形成强化学习闭环。官方初步结果称相比通用基础模型质量最高提升 30%、token 效率最高 5 倍。NVIDIA 提供 Nemotron 与 OpenShell,可部署在 Cadence 云、公有云或客户本地。首批模型 2026 年第四季度向部分早期客户开放。

核心要点速览

  • Maestro 不是单个模型,而是一组领域后训练 LLM、决策模型和自我改进的 agent skills,按任务与前沿/开源模型混合调度
  • 确定性求解器和 EDA 工具对输出按工程目标与约束打分,作为强化学习反馈,形成可验证闭环
  • Cadence 口径:相比通用基础模型,质量最高提升 30%,token 效率最高 5 倍;暂无第三方评测
  • NVIDIA 提供 Nemotron 模型与 OpenShell 沙箱参考架构;客户可用自有设计数据继续后训练,支持本地部署
  • 首批模型仅在 2026 年 Q4 向部分早期客户开放;Socionext 称部署 InnoStack 预计最高 5 倍生产力提升
阅读全文

Baseten 开源两款决策模型 mammoth-1(27B)与 elephant-1(9B):不生成文本直接输出选项概率,Jev 决策榜第一

10 月 21 日,Baseten 旗下研究团队 Base Labs 发布开源决策模型 mammoth-1(27B)与 elephant-1(9B),基于 Qwen3.5 全量微调,不生成文本,一次前向传播即返回每个选项的概率,适合分流、分类、打分和路由。官方口径下 mammoth-1 以 71.24 分登顶 Jev Decision Index 0.4,elephant-1 在 Artificial Analysis Decision Index 上并列第一。权重已上 Hugging Face,Baseten API 免费开放至 10 月 27 日。

Baseten 开源两款决策模型 mammoth-1(27B)与 elephant-1(9B):不生成文本直接输出选项概率,Jev 决策榜第一

核心要点速览

  • 跑分(官方口径):mammoth-1 在 Jev Decision Index 0.4 得 71.24 分,208 个决策模型中排名第一;AA Decision Index 65.9
  • elephant-1(9B):Jev 62.6 分、9B 级第一;AA Decision Index 65.2,与 d1-ultra 并列第一
  • 训练:基于 Qwen3.5-27B / 9B 全量微调,621 万条决策样本,含弃答与安全数据
  • 机制:块状双向注意力 + 共享前缀缓存,一次前向返回多问题概率;官方称比推理模型最高快约 10 倍
  • 上手:Hugging Face 权重(MIT),Baseten API 免费至 10/27 23:59 PT,默认零数据保留
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mammoth 1⚡ Elephant 1⚡ Qwen3.5-27B⚡ Qwen3.5-9B🌐 Baseten🌐 Base Labs

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

Perplexity 开发者团队(@perplexitydevs)联合 OpenRouter 与 Vercel AI Gateway 正式上线新一代开源权重多模态决策模型 pplx-decider-v1.2(27B)与轻量级 pplx-decider-flash-v1.2(4B)。该系列模型支持同时输入文本与图像,直接返回带校准概率分布的类型化决策结果(Typed Answers with Probabilities),其中 27B 版本输入定价低至 $0.02/百万 Token,4B Flash 版速度更快且成本再砍半,成为智能体路由与工具选择的极速基础设施。

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

核心要点速览

  • 双尺寸多模态决策模型上线:发布 27B 旗舰版 pplx-decider-v1.2 与 4B 极速版 pplx-decider-flash-v1.2,支持图文输入直出类型化概率决策
  • 输入定价低至 $0.02/百万 Token:27B 版本仅售 $0.02/1M 输入 Token,4B Flash 版本速度更快且成本再减半
  • OpenRouter 与 Vercel 同步首发:支持 pplx-decider-latest 动态别名,专为智能体工具路由、护栏审查与多模态状态分类打造
阅读全文
关联模型 / 智能体 / 厂商:

Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

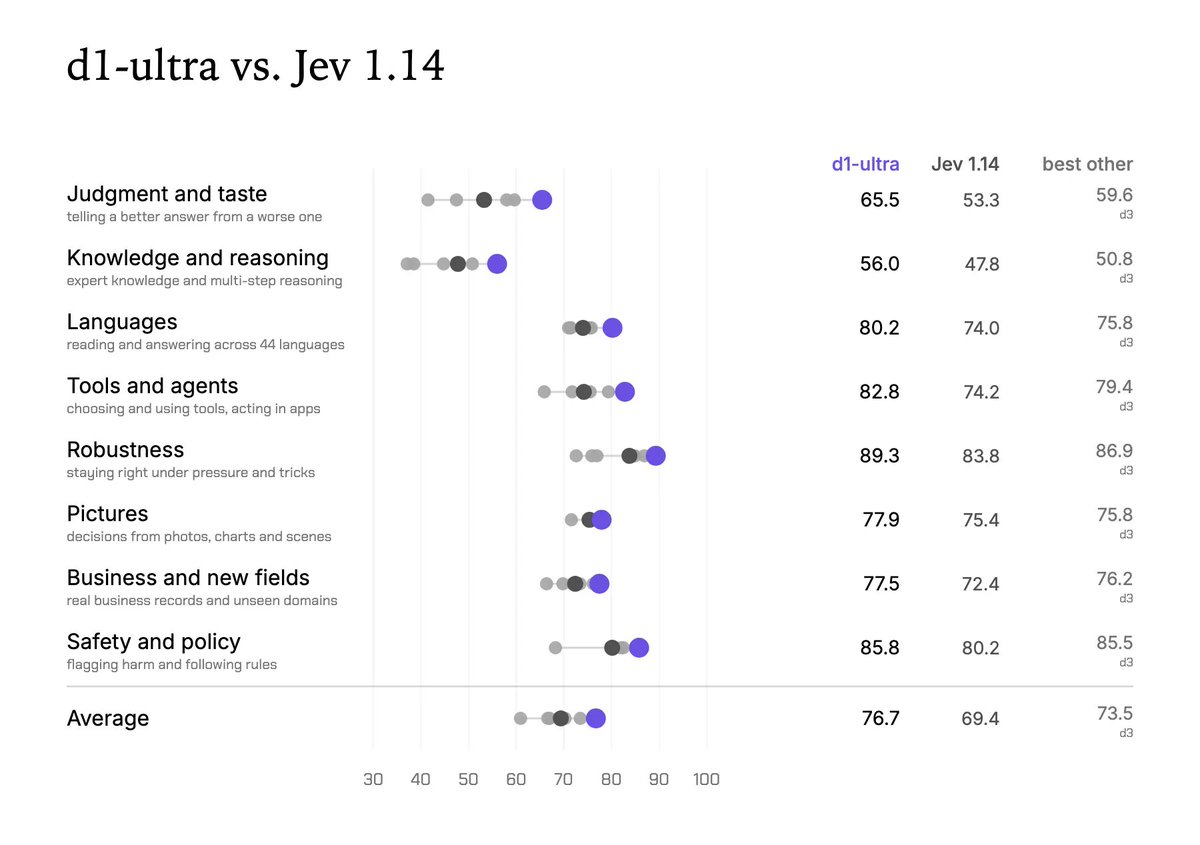
Liquid AI 于 10 月 15 日发布多模态决策模型 d1-ultra,输入文本和图像,一次前向传播直接返回是非、单选、打分三类问题的概率,不生成任何 token,只按输入计费。Artificial Analysis 独立评测中它以 65 分登顶 Decision Index v1.0,领先至少 8 分,非幻觉率 85%;已上线 Liquid API、Vercel AI Gateway 与 OpenRouter。

Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

核心要点速览

  • Artificial Analysis Decision Index v1.0 得分 65,第一名,领先其他决策模型至少 8 分(独立评测)
  • AA-Omniscience-Decision 非幻觉率 85%,第二名 Microsoft-Decision-1 为 40%;但因更多弃答,准确率 32% 低于 d1 的 41%
  • 定价 $0.042 / 百万输入 token,输出免费;1024×1024 图像计 1,536 token(官方博客)
  • 上下文 32,768 token,支持 44 种语言,Liquid 自有 112 项评测中八大类全部领先(厂商口径)
  • 调用方式:Liquid /decisions/v1/systemone 端点 model: d1-ultra,或 Vercel/OpenRouter 的 liquid/d1-ultra(文档)
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

智能体提速 2.5 倍、降本 89%!JevAgentHarness 让 4B 决策小模型与大模型共享控制权:跨分布解决率高达 91.5%

现有智能体运行框架(Harness)在每一步都调用昂贵的大模型,但大多数步骤本质上只是‘下一步调用哪个工具’的多项选择决策。UIUC、耶鲁与普林斯顿团队推出 JevAgentHarness 与开源模型 AgentDecision-4B,通过在智能体自身纠错轨迹上训练 4B 决策模型并拟合逐项置信度阈值,实现与大模型动态共享控制权。实测使智能体运行成本降低 81.1%–89.0%,速度提升最高达 2.5 倍,分布外任务解决率达 91.5%。

智能体提速 2.5 倍、降本 89%!JevAgentHarness 让 4B 决策小模型与大模型共享控制权:跨分布解决率高达 91.5%

核心要点速览

  • 揭示孤立评测与动态控制鸿沟:构建 AgentDecisionBench,发现无阈值盲目委派工具选择会导致智能体成功率暴跌 19.0 个百分点
  • 逐选项阈值校准+纠错状态训练:推出 JevAgentHarness 与开源 AgentDecision-4B,专门在智能体犯错后的真实恢复状态上强化训练
  • 提速 2.5 倍且成本锐减 89%:端到端开销降低 81.1%–89.0%,在分布外未知任务上解决率高达 91.5%(显著超越原版 Jev 的 82.0%)
阅读全文

Subquadratic 发布 SubQ Snap:384K 上下文决策模型,专接 Agent 的路由/选工具/判通过

Subquadratic 于 10 月 12 日发布 SubQ Snap(公测 ID subq-snap-preview):不生成文本、只对预定义答案打概率的「决策模型」,基于次二次稀疏注意力 SSA,单次可读 384K 文本+图像,100K token 约 1 秒出结果;官方称 Decision Index 0.2.1 得 61.7(Jev 57.9),输入 $0.05/百万 token、输出免费。

Subquadratic 发布 SubQ Snap:384K 上下文决策模型,专接 Agent 的路由/选工具/判通过

核心要点速览

  • 上下文 384K(文本+图像),官方称为 Jev 的 12 倍
  • Decision Index 0.2.1:61.7 vs Jev 57.9(厂商自测)
  • 16 项企业任务均分 67.6 vs 61.6,13/16 领先;When2Call 落后 7.6 分
  • Decision LCR(72K–115K 多文档):一次读完 74.0 vs Jev 分块 48.0
  • 定价 $0.05/百万输入 token,输出免费;100K 输入约 1 秒
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SubQ Snap⚡ SubQ⚡ Jev🌐 Subquadratic🌐 TypeSafe

vLLM Semantic Router 开源 Decision 3.0:0.6B–27B 六款多模态决策模型,官方测评 Jev Decision Index 第一

vLLM Semantic Router(vllm-sr)团队于 10 月 11 日在 Hugging Face 以 Apache-2.0 开源 Decision 3.0 系列(d3、d3-flash、d3-mini、d3-nano、d3-lite、d3-edge),基于 Qwen3.5/3.8,支持文本、图片和视频输入,一次调用直接输出选择题、是/否、打分三类问题的概率而不生成文本。官方口径:27B 旗舰 d3 在 Jev Decision Index 0.3.1 得 64.7,领先 Perplexity Decider v1.1(62.8)和上一代 Decision 2.0(55.9);单张 MI325X 上文本请求中位延迟 55ms。vLLM 官方账号转发祝贺。

vLLM Semantic Router 开源 Decision 3.0:0.6B–27B 六款多模态决策模型,官方测评 Jev Decision Index 第一

核心要点速览

  • 六档尺寸:d3-edge 0.59B、d3-lite 0.85B、d3-nano 2.2B、d3-mini 4.5B、d3-flash 8.4B、d3 26.1B,全部 Apache-2.0(HF 合集)
  • 官方口径 Jev Decision Index 0.3.1:d3 64.7,Perplexity Decider v1.1 62.8,Jev 60.1,Decision 2.0 55.9
  • 视觉榜(Vision Index 0.3.1):d3 71.6,Perplexity Decider v1.1 70.6,JEV-27B-VL 69.6
  • 单张 AMD MI325X、单并发中位延迟:d3 文本 55ms / 图片 273ms / 10 秒视频 553ms;d3-edge 文本仅 6.7ms
  • 不生成文本,直接给每个选项打概率;同一输入可一次问多道 Choice / Yes-No / Score 题
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Decision 3.0⚡ d3⚡ D3 Flash⚡ D3 Edge⚡ Qwen3.5⚡ Qwen3.8🌐 vLLM🌐 vLLM Semantic Router

开源决策模型 Vega:冻结 Qwen3.5-0.8B + 57 MB 物理引擎,“滚小球”给出带校准概率的类型化答案

独立开发者 Nandakishor M 以 Apache 2.0 开源 Vega(pip 包 vegaml):冻结的 Qwen3.5-0.8B(另有 4B)只负责读取,57 MB 的可训练引擎把答案建模成势能“山谷”,小球带摩擦滚落后停在哪个谷就是答案,并给出校准概率、保形答案集与弃答标记。支持 73,728 token 上下文与图像输入。作者自测在钓鱼邮件识别等任务上胜过托管的 Jev 1.13.0,但也承认在重排与多步推理上落后。

开源决策模型 Vega:冻结 Qwen3.5-0.8B + 57 MB 物理引擎,“滚小球”给出带校准概率的类型化答案

核心要点速览

  • 体积:0.8B 版引擎 14.3M 参数 / 57 MB,任务适配器仅 0.84M 参数;4B 版引擎 124 MB(GitHub README)
  • 作者自测 typed-decisions 测试集(2,050 条):0.8B 加适配器 0.763、4B 0.803,单次决策 22 ms / 28 ms
  • 钓鱼邮件 800 封:Vega 准确率 75.4、识别 252/400,Jev 1.13.0 为 61.9、99/400(作者口径,McNemar p=3e-11)
  • 中位延迟 267 ms(T4 fp16)对比托管 Jev 591 ms;MMMU-Pro 仅 0.240,作者明确不适合大学级推理
  • pip install vegaml,HF 模型卡与在线 Space可直接试用
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Vega 0.8B⚡ Vega 4B⚡ Qwen3.5-0.8B⚡ Jev 1.13.0🌐 Nandakishor M

Jev 开发商 TypeSafe AI 完成 8.7 亿美元 A 轮、估值 75 亿美元:a16z 领投,Jev 发布不到一个月

TypeSafe AI 10 月 9 日宣布完成 8.7 亿美元 A 轮融资、投后估值 75 亿美元,由 a16z 领投,Sequoia 与老股东 DCVC 跟投,Martin Casado 加入董事会。其“System One”决策模型 Jev 于 9 月 15 日发布,不输出文本而输出校准概率/类型化决策。公司称三分之一财富 500 强在用,a16z 博文则写 25%,两者口径不一。

Jev 开发商 TypeSafe AI 完成 8.7 亿美元 A 轮、估值 75 亿美元:a16z 领投,Jev 发布不到一个月

核心要点速览

  • 融资:8.7 亿美元 A 轮、估值 75 亿美元,a16z 领投,Sequoia、DCVC 跟投,Martin Casado 进董事会
  • Jev 于 2026-09-15 发布,据 TechCrunch,距融资仅约 3.5 周
  • a16z 口径:Jev 发布后 3 天生成 1 万亿 token,是其见过增长最快的模型
  • 企业渗透口径不一致:TypeSafe 博客称“三分之一财富 500 强”,a16z 写“25%”,均为公司/投资方自报
  • 公司承诺推出更多 machine-native 模型与企业功能,开发者入口见 docs.typesafe.ai
阅读全文
关联模型 / 智能体 / 厂商: