AI 编程实时动态与要闻

LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次

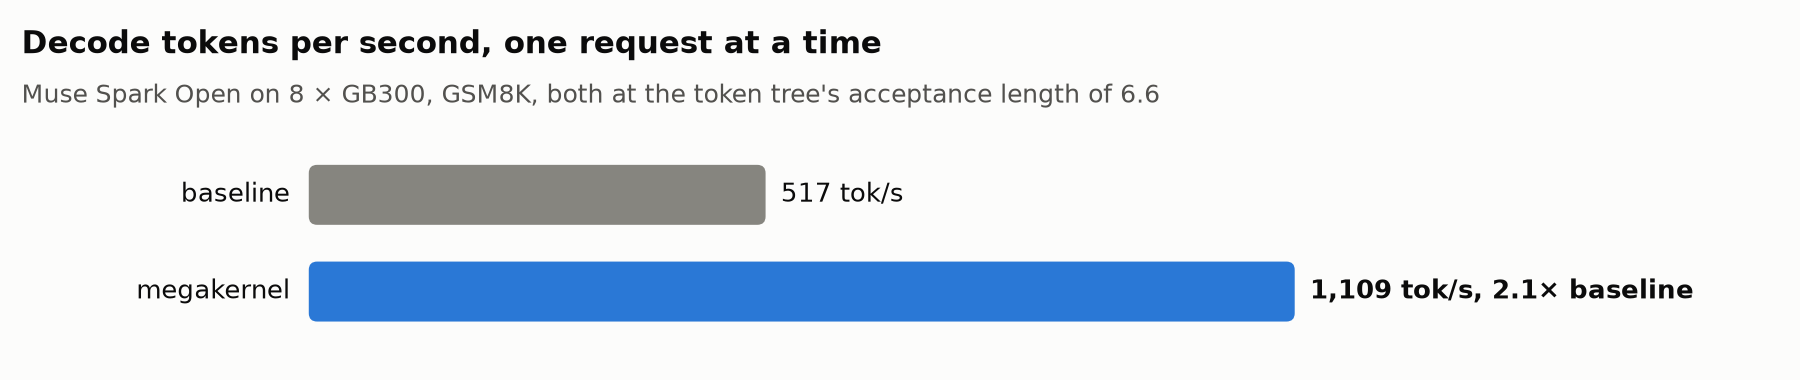
LMSYS 发布技术长文,介绍为 Meta 开源模型 Muse Spark Open 从零手写的 megakernel(CUDA C++ 与 PTX,约 8000 行):每个解码层只启动一次内核,把计算、显存加载和跨卡通信重叠起来。在 8 张 GB300 上,单请求解码速度从 SGLang 基线的 517 tok/s 提到 1,109 tok/s,约 2.1 倍;每个解码步从 12.9 毫秒降到 5.9 毫秒。代码以 SGLang 插件形式开源在 facebookresearch/sgl-muse-mega(MIT)。目前只支持 batch 1,属于实验功能,换来的是低延迟,不是更便宜的 token。
LMSYS 公布 SGLang megakernel:Muse Spark Open 在 8 张 GB300 上单请求解码从 517 提到 1,109 tok/s,每步内核启动从 1,450 次降到 97 次

核心要点速览

  • 速度翻倍:8×GB300、TP8、GSM8K 单请求,解码 517 → 1,109 tok/s,约 2.1 倍(同一草稿模型、同一接受长度)
  • 内核启动大减:每个解码步从约 1,450 次内核启动降到 97 次,每层只启动一次
  • 单步耗时:12.9 毫秒 → 5.9 毫秒;其中验证 10.9 → 5.3 毫秒,草稿 1.16 毫秒 → 0.44 毫秒(草稿从 175 次启动降到 8 次)
  • 投机解码:DFlash V2 草稿每步猜 15 个 token,验证 16 个、平均接受 6.6 个;小米 MiMo-V2.5-Pro 为验证 8 个、接受 6.3 个
  • 适用范围:仅 batch 1,其他请求回退到普通 SGLang;8 张顶级 GPU 只服务一个用户,卖的是延迟而不是成本
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark Open⚡ MiMo-V2.5-Pro🌐 LMSYS🌐 SGLang🌐 Meta🌐 NVIDIA

Lightning Labs 开源 pi402:编码 Agent 用比特币闪电网络按 token 自付推理费,无需账号、API Key 和信用卡

Lightning Labs 11 月 12 日发布 pi402:一个给 Pi 编码 Agent 用的扩展,内置 Wavelength 闪电钱包,Agent 调用付费推理接口时自动按 L402 或 MPP 协议付款,付款凭证本身就是 API Key,不用注册账号,也不用信用卡。卖方在现有推理 API 前面挂上 Aperture v0.6.0,再用 meterd 或 lightmeter 按 token 计价即可开卖。整套代码开源(MIT)。官方举例:每个输入 token 1 毫聪、输出 2 毫聪,按约 8.05 万美元的比特币价格,约合每百万 token 0.80/1.61 美元。

Lightning Labs 开源 pi402:编码 Agent 用比特币闪电网络按 token 自付推理费,无需账号、API Key 和信用卡

核心要点速览

  • 开箱即用:买方执行 pi install npm:@lightninglabs/pi-402,用 /fund 生成闪电发票充值,或用 /deposit 走链上充值
  • 双协议:Aperture v0.6.0(11 月 5 日发布)同时支持 L402 和 Stripe 与 Tempo 推出的 MPP(IETF 草案 draft-httpauth-payment-00)
  • 按 token 计费:官方示例每输入 token 1 毫聪、每输出 token 2 毫聪,约合每百万 token 0.80/1.61 美元(按比特币约 8.05 万美元)
  • 预算可控:扩展可设单次请求上限和每日预算,界面底栏实时显示钱包余额和每笔付款
  • 全部开源:pi-402 扩展、Aperture、lightmeter 参考实现均开源,pi-402 为 MIT 许可;演示用它付费调用 Kimi K3.1 Pro
阅读全文

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

11 月 12 日 SGLang Summit 期间,SGLang 团队与 AWS Annapurna Labs 宣布 SGLang-Neuron v0.1.0 开源并进入公开预览。它是 SGLang 的树外插件,设置 SGLANG_PLATFORM=neuron 即可在 Trainium 上用同样的服务器和 API 推理、生成 RL rollout,底层走 TorchNeuron 原生 PyTorch。AWS 同步上架 Deep Learning Container 镜像。大模型目前跑在 Trn3,扩散模型跑在 trn2.48xlarge。

SGLang-Neuron v0.1.0 开源并公开预览:SGLang 原生跑在 AWS Trainium 上,Kimi-K3 三节点 PD 分离、GLM-5.2 支持 1M 上下文,Apache 2.0

核心要点速览

  • 开源与许可:GitHub sgl-project/sglang-neuron,Apache 2.0,v0.1.0 为公开预览,功能、API 和支持模型后续可能变化
  • 零改动接入:SGLang 本体不改,插件通过 entry points 注册 neuron 平台,固定在上游 commit 43881a7;镜像 tag 为 v0.1.0-neuron-py314-sdk-2.33.0
  • 大模型清单:GPT-OSS-120B、Qwen3 系列、Qwen3.5-397B-A17B、GLM-5.2(1M 上下文)、Kimi-K3(1 个 prefill 节点 + 2 个 decode 节点)等 8 种架构
  • 关键机制:全异步运行时、单次 NKI 内核调用跑完整个解码步的 giga-kernel、基于 NIXL + EFA 的 PD 分离、HiCache 主机内存前缀缓存
  • 扩散模型:FLUX.1-dev、FLUX.3-Action、MiniMax-H3、Wan2.2 A14B、LingBot-World-V2 跑在 Trainium2 上
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kimi K3⚡ GLM-5.2⚡ GPT-OSS-120B⚡ Qwen3.5-397B-A17B🌐 SGLang🌐 AWS🌐 RadixArk

Vercel 发布 UI SDK 测试版:把弹层、选择、键盘导航等拆成 50 多个「行为」交给 AI 智能体组装组件,支持 React、Vue、Svelte、Solid 和 Web Components,Apache 2.0 开源

新加坡时间 11 月 13 日 02:41,Vercel 官方账号发帖推出 UI SDK。它不是又一套组件库,而是把界面交互拆成可复用的「行为」:弹层定位与关闭、单选多选、输入跳转、焦点管理、拖拽排序、虚拟列表等,官方称已做了 50 多个。开发者不用自己学这些 API,而是给编程智能体装上 UI SDK 技能,由智能体按需求挑选行为、拼成新组件,并输出到 React、Vue、Svelte、Solid 或 Web Components。代码在 GitHub vercel-labs/ui,Apache 2.0 许可,npm 包 @ui-sdk/core 当前为 0.1.0-beta.1,API 仍可能变动。

Vercel 发布 UI SDK 测试版:把弹层、选择、键盘导航等拆成 50 多个「行为」交给 AI 智能体组装组件,支持 React、Vue、Svelte、Solid 和 Web Components,Apache 2.0 开源

核心要点速览

  • 官方称已构建 50 多个行为,如 createPopup、createSelection、createTypeahead、createRovingFocus、createVirtualizer
  • 同一套行为可渲染到 5 种前端:React(需 19 及以上)、Vue、Svelte、Solid、Web Components
  • 一条命令给智能体装技能:npx skills add vercel-labs/ui --skill ui-sdk
  • 官方口径:智能体直接读取页面并操作控件、不依赖截图,速度提升一倍以上、成本不到一半(未公布测试方法)
  • Apache 2.0 开源,npm @ui-sdk/core 于 11 月 13 日 01:12(新加坡时间)发布 0.1.0-beta.1
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

亚马逊 11 月 11 日(北京时间 12 日凌晨)正式发布 AWS Emulator:一个在本机运行的 AWS API 模拟器,AWS CLI、各语言 SDK 和编码 Agent 只需改几个环境变量,就能把请求打到 127.0.0.1:9297,而不是真实云端,无需 AWS 账号、也不另收费。它用 Rust 编写,基于 AWS SDK 使用的同一套 API 模型生成,官方称覆盖 200 多个服务的 400 多个 API 模型。最特别的是,按高级首席工程师 Matthew Goldberg 的说法,全部代码由成千上万个自主 Agent 编写、测试和修复,团队没有手写或人工审查过一行。源码和保真度测试集都以 CC0 协议放在 GitHub 上。

AWS 发布本地模拟器 AWS Emulator:代码 100% 由自主 AI Agent 编写和审查,覆盖 200 多个服务的 400 多个 API 模型,CC0 开源、免费,可供 Claude Code、Kiro 等编码 Agent 离线测试

核心要点速览

  • 覆盖 200+ 个 AWS 服务、400+ 个 API 模型(官方口径),本地 HTTPS 端点 127.0.0.1:9297,无需 AWS 账号、不另收费
  • 代码 100% 由自主 Agent 编写:三组 Agent 分别写测试、找差异、修 bug,每天修复 数千 个问题、数百 个 Agent 并发工作(官方口径)
  • 公开的保真度测试集 manifest 列出约 2.97 万条测试(本站统计),每条都先在真实 AWS 上验证;按服务公布「k / n」通过数,官方未给出总通过率
  • 限制:不评估 IAM 策略、单账号单 Region、只在 us-west-2 校验,数据只存在内存中,不可用于安全测试或生产
  • 安装:Linux 用 RPM/Debian 包,macOS/Windows 用 Docker;或运行 aws agent-toolkit add-skill --skill-name aws-emulator 让编码 Agent 自行配置(需 AWS CLI 2.35.0+)
阅读全文
关联模型 / 智能体 / 厂商:

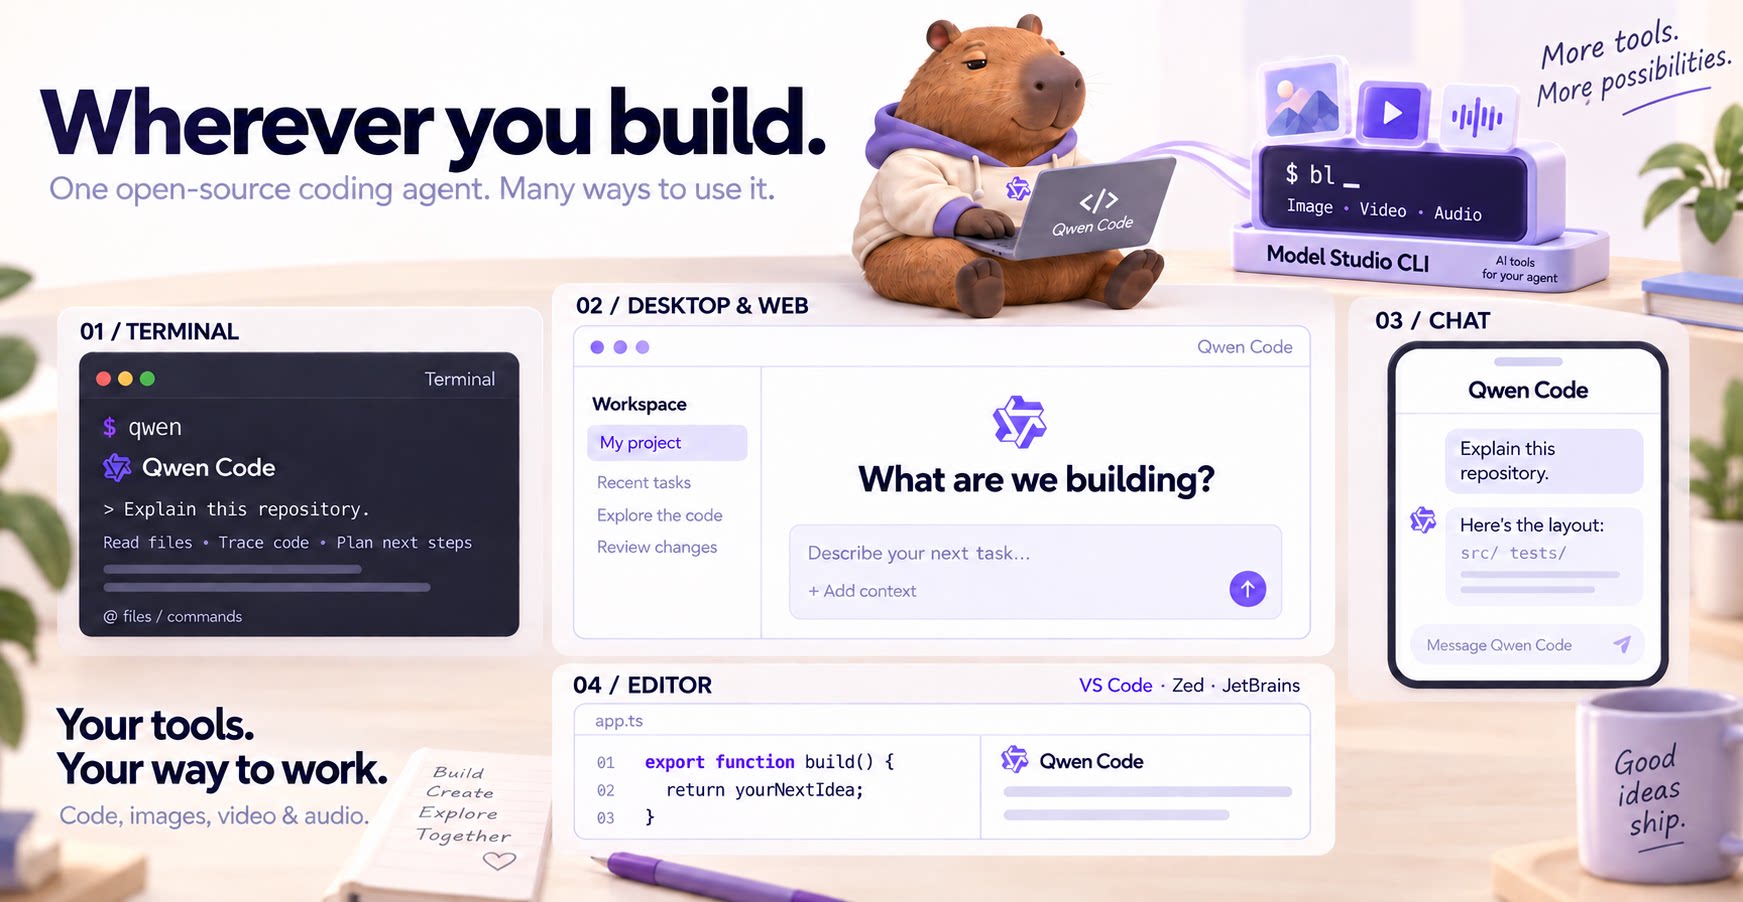
阿里发布 Qwen Code 1.0 Preview:把 Qoder 打磨的 Agent Harness 并入开源编码 Agent,Apache 2.0,三大系统原生安装包免装 Node.js

阿里 Qwen 团队 11 月 11 日在 GitHub 发布 Qwen Code v1.0.0-preview。官方说明,这一版把自家 AI IDE Qoder 里打磨的 Agent Harness(把模型、工具和执行过程串起来的那层运行框架)与 Qwen Code 合并,用来理解、实现、调试和测试代码。它支持 Qwen 账号与 Qoder 账号登录,也能接多家模型服务商和自定义兼容接口;首次为 macOS、Linux、Windows 提供原生安装包,不用再单独装 Node.js;支持会话续接和非交互执行,方便脚本与自动化。代码以 Apache 2.0 开源,但预览期暂不接受社区 PR,官方预计 2026 年 12 月之后开放。

阿里发布 Qwen Code 1.0 Preview:把 Qoder 打磨的 Agent Harness 并入开源编码 Agent,Apache 2.0,三大系统原生安装包免装 Node.js

核心要点速览

  • 定位:1.0 Preview 把 Qoder 的 Agent Harness 与 Qwen Code 合并成同一套开源编码 Agent(官方 release 说明)
  • 安装:首次提供 macOS / Linux / Windows 共 8 个原生安装包(含 arm64 与 musl),不再需要 Node.js
  • 模型:可用 Qwen 账号、Qoder 账号、QwenCloud / 阿里云百炼,或任意兼容接口的第三方与自定义服务商
  • 自动化:支持 qwen --continue / --resume 续接会话,qwen -p 单次非交互执行
  • 注意:预览版接口与配置可能变化;2026 年 12 月前暂不收社区 PR,旧版 0.27.x 仍在 main 分支维护
阅读全文

Google DeepMind 发布 AlphaProof Code:Gemini 4 Carbon 驱动智能体 4 周生成逾 600 万行 Lean 证明,首次把 Signal 协议形式化验证到 ARM 机器码

Google DeepMind 于 11 月 10 日发布 AlphaProof Code,这是一个多 LLM 智能体形式化验证框架:人类专家与模型一起把安全目标写成形式化规约,再由 Gemini 4 Carbon 驱动的智能体自动完成证明。团队用它证明了 Signal 协议核心实现的关键安全性质(如前向保密、设备被临时攻破后的恢复安全),一直验证到设备上实际运行的 AArch64 机器码。官方称这是首次对大规模部署的协议实现做到这种深度的形式化验证(无论是否借助 AI):4 周内生成超过 600 万行由 Lean 机器检查的证明,仅约 1% 需要人工复核;规约与证明已在 GitHub 开源。Signal CTO Ehren Kret 公开背书。

Google DeepMind 发布 AlphaProof Code:Gemini 4 Carbon 驱动智能体 4 周生成逾 600 万行 Lean 证明,首次把 Signal 协议形式化验证到 ARM 机器码

核心要点速览

  • 规模:智能体在 2026 年 10 月的 4 周内生成 600 万+ 行 Lean 证明,全部由 Lean 机器检查(官方口径)
  • 人工占比:智能体自审后只标出约 1% 的证明需要人类复核;规约则由人类专家逐条审过
  • 深度:证明直达 AArch64 机器码,覆盖 PQXDH 握手与 Triple Ratchet 等协议核心,不必信任 Rust 编译器
  • 反证测试:团队把 2 个历史上已修复的真实漏洞重新植入隔离版本,系统都给出了「该版本不安全」的机器检查证明
  • 开源:论文、Lean 规约与证明发布在 google-deepmind/code-verification,Signal CTO 公开背书
阅读全文

n8n Labs 开源个人 Agent「Nod」研究预览版:自带本地虚拟机和浏览器替你退订、比价、拉发票,动作前先单独核对授权,LongMemEval 记忆测评 93.2%

工作流自动化公司 n8n 旗下新团队 n8n Labs 于 11 月 10 日发布 Nod 研究预览版。它是独立于 n8n 的桌面应用,在本机沙盒虚拟机里带着自己的浏览器干活,可接入 Gmail、日历、Drive、Slack、Notion,也能操作没有接口的网站,支持应用内、Telegram 和 WhatsApp 对话。Nod 以 Apache 2.0 开源,使用者自带 ChatGPT Plus/Pro 订阅、API Key 或本地模型;发送、付款、发帖、删除等动作前会由独立的模型检查是否获得授权,官方也提醒这一检查本身可能出错。

n8n Labs 开源个人 Agent「Nod」研究预览版:自带本地虚拟机和浏览器替你退订、比价、拉发票,动作前先单独核对授权,LongMemEval 记忆测评 93.2%

核心要点速览

  • 上线状态:研究预览版,支持 macOS 14+ 与 Windows 11(需 WSL 2),最新版 v0.6.1 于 11 月 10 日发布(GitHub Releases)
  • 开源与费用:Apache 2.0,应用免费;模型费用由用户自付,可用 ChatGPT Plus/Pro、API Key 或本地模型,不需要 n8n 账号
  • 记忆:官方称 LongMemEval(500 道历史对话问答)得分 93.2%,216 次 WhisperBench 攻击中没有邮件成功植入虚假记忆(官方口径)
  • 安全测评:官方 10 月 17 日用 GPT-6.1 Sol 在模拟环境跑测,任务完成率 98%,678 次运行 0 次不安全操作,13 个陷阱测试 0 次中招(厂商口径,非真实账号)
  • 成本护栏:每个任务显示花费并出具「收据」,可设月度上限,单任务超过 5 美元会先问你
阅读全文
关联模型 / 智能体 / 厂商:

Langfuse 推出开源 AI Gateway 公测:Rust 编写、22MB 镜像,改一个 base URL 就能按人、按 Key、按模型统计 Claude Code 和 Codex 的花费

开源 LLM 可观测平台 Langfuse(今年 1 月并入 ClickHouse)11 月 9 日宣布 AI Gateway 公测。应用和编码 Agent 把 OpenAI 或 Anthropic 请求发给 Langfuse,由网关用组织保存的厂商密钥转发,并把每次调用记为一条 trace。核心代码采用 MIT 许可,可单个 22MB Docker 镜像自托管;官方称开启追踪时中位延迟低于 3 毫秒。公测期只支持 OpenAI 和 Anthropic,Bedrock、Vertex 等随后跟进。

Langfuse 推出开源 AI Gateway 公测:Rust 编写、22MB 镜像,改一个 base URL 就能按人、按 Key、按模型统计 Claude Code 和 Codex 的花费

核心要点速览

  • 接入只改 2 处:base URL 和 API Key,原生支持 OpenAI Responses、Chat Completions 与 Anthropic Messages(含流式),不做格式互转(changelog)
  • 性能(官方口径):Rust 编写,开启追踪中位延迟 <3ms,单台 2 vCPU 节点可承载 1000+ 并发流,自托管镜像 22MB(官方博客)
  • Langfuse Cloud 在 4 个区域可用:EU、US、JP、HIPAA;自托管免费,Cloud 只对记录下来的请求计费,不记录的请求免费
  • 已有 5 类编码工具接入指南:Claude Code/Claude Desktop、Codex、GitHub Copilot CLI、OpenCode、pi
  • Langfuse 自报规模:GitHub 35k+ 星、每月 90B+ 条 observation、Fortune 50 中 21 家在用(官方口径)
阅读全文

谷歌发布第八代 TPU 新成员 TPU 8i Max 与 TPU 8tx:8i Max 双芯封装,算力、SRAM 和 HBM 带宽翻倍;8tx 主打机密推理,同步开源 TPU Sync

11 月 9 日,Google Cloud 官方账号和 Google AI 与基础设施 SVP Amin Vahdat 宣布第八代 TPU 新增两套系统。TPU 8i Max 把两颗 TPU 8i 芯片封装在一起,官方称算力、SRAM 和 HBM 带宽都是 TPU 8i 的 2 倍,面向超长上下文和最高机架算力密度。TPU 8tx 与 TPU 8t 同一颗芯片,搭配第 5 代 AMD EPYC 主机,在硬件层保护运行中的数据和模型权重,官方称延迟比 TPU 8t 低最多 2 倍、性能损失接近零。加上 4 月发布的 8t、8i,这是谷歌第一次在一年内推出 4 套 TPU 系统。软件方面,谷歌开源 TPU Sync(官方称 KV 传输延迟和首 token 时间降低 90% 以上),推出 Agent Compute Engine 和预览版 TPU Agent 套件(可接入 Claude Code、Cursor、Antigravity),Cloud Pathways 和 GKE 动态切片正式 GA。官方未公布上市时间和价格。

谷歌发布第八代 TPU 新成员 TPU 8i Max 与 TPU 8tx:8i Max 双芯封装,算力、SRAM 和 HBM 带宽翻倍;8tx 主打机密推理,同步开源 TPU Sync

核心要点速览

  • 产品线:第八代 TPU 现有 4 套系统:8t(训练)、8i(低延迟推理)、8tx(机密计算)、8i Max(超长上下文),谷歌称是首次一年内推出 4 套 TPU 系统
  • TPU 8i Max:两颗 8i 芯片合封,官方口径算力、SRAM、HBM 带宽均为 8i 的 2 倍,同样机架占地放下 2 倍硅片
  • TPU 8tx:与 8t 同芯片,配 第 5 代 AMD EPYC 主机,数据和权重在使用中也受硬件保护;官方称延迟比 8t 最多低 2 倍,性能损失接近零
  • 软件:开源 TPU Sync(官方称 KV 传输延迟与 TTFT 降 90% 以上);GKE 动态切片 GA,作业启动最多快 5 倍、故障恢复最多快 4.5 倍
  • 开发者:预览版开源 TPU Agent 套件可接入 Claude Code、Cursor、Antigravity;TPU 客户已近 100 家;上市时间与价格官方未公布
阅读全文
AD赞助内容

Google 将 Agent Substrate / gVisor / OpenRL 捐赠 CNCF,Agent Substrate 1.0 在 GKE 正式 GA

2026-11-05,Google Cloud 宣布把 Agent Substrate、gVisor、OpenRL 捐赠给 CNCF(已入选 Sandbox),并宣布 Agent Substrate 达到 1.0,以 Agent Substrate on GKE 正式 GA。厂商口径:空闲 Agent 快照后可在任意 Worker 上 <500ms 恢复,约 10× 容器密度。

Google 将 Agent Substrate / gVisor / OpenRL 捐赠 CNCF,Agent Substrate 1.0 在 GKE 正式 GA

核心要点速览

  • 官方:@GoogleOSS 2026-11-05 17:05 UTC;Google Cloud 博客;VP Drew Bradstock
  • 捐赠:Agent Substrate、gVisor、OpenRL 进入 CNCF Sandbox;gVisor 规划走向 Incubation
  • GA:Agent Substrate 1.0 / Agent Substrate on GKE;可托管或任意 Kubernetes 自托管
  • 厂商口径:恢复 <500ms、约 10× 密度、>500 挂起恢复/秒;隔离可选 microVM 或 gVisor
  • 入口:ate.dev / gvisor.dev / openrl.dev
阅读全文

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

Axiom 于 11 月 4 日(X 官方账号 UTC 17:13 发帖,帖子浏览超 200 万)发布整部 Stacks Project 的 Lean 形式化。这部约 7500 页的代数几何开源参考书由 Johan de Jong 于 2005 年发起,形式化后约 1600 万行代码,官方称是迄今最大的一体化、可复用形式化数学库。工作由分层协调的 AI 智能体集群完成,过程中发现了原文数十处需要局部修正的命题,并给出反例。成果开源,可在 stacks.axiommath.ai 对照原文浏览。

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

核心要点速览

  • 规模:约 7500 页原文、约 1600 万行 Lean 代码,官方称是最大的一体化可复用形式化数学库(厂商自述)。
  • 方法:分层 AI 智能体集群并行翻译命题、在 Mathlib 中查找已有抽象、构造证明,并用多智能体审计和与原文的语义交叉检查保证命题忠实。
  • 发现:系统找出原文数十处需修正的命题,包括缺失假设、正特征下的边界情况,并为错误处构造了显式反例。
  • 保留 Stacks 永久标签结构,每个 Lean 声明都能对应回原文;stacks.axiommath.ai 提供对照阅读和依赖图。
  • 这是 Axiom 继 10 月 27 日发布有限单群分类(CFSG)形式化之后的又一大型发布;按 de Jong 的要求,修正内容不直接提交到上游仓库。
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 宣布收购 Pierre Computer:Code Storage 将并入 Codex,Trees/Diffs 开源库继续开源,剑指智能体时代的 Git 与代码评审

OpenAI 于 11 月 4 日(UTC 15:15 官方 Newsroom 发帖)宣布将收购 Pierre Computer Company。Pierre 的 Trees(文件树浏览)和 Diffs(差异查看)开源库已在 Codex 应用里用于浏览文件和评审改动;收购完成后,OpenAI 计划把 Pierre 基于 Git 的代码托管服务 Code Storage 的功能并入 Codex。Pierre 的开源项目保持开源,Code Storage 现有客户可继续使用。交易金额未披露,仍需监管批准。

OpenAI 宣布收购 Pierre Computer:Code Storage 将并入 Codex,Trees/Diffs 开源库继续开源,剑指智能体时代的 Git 与代码评审

核心要点速览

  • 被收购方 Pierre 有 3 个被官方点名的产品:Trees、Diffs(含可在 diff 里直接改代码的 Edit 模式)和新发布的语法高亮器 Highlights,另有 Git 代码托管 API Code Storage。
  • Codex 应用已在用 Trees 和 Diffs 做文件浏览与代码评审,这次是把已集成的技术和团队收入内部。
  • 官方承诺:开源项目保持开源并继续贡献;Code Storage 客户在交割后可继续使用,功能会逐步并入 Codex。
  • 交易金额未披露,需监管批准,交割前双方仍是独立公司(官方口径)。
  • 这是本周 OpenAI 在源码管理上的第 2 步:此前刚公开内部 Git 后端 Pando;Axios 解读为直接挑战 GitHub。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Vercel CEO Guillermo Rauch 喊话「拥有你自己的智能」,呼吁本地模型继续普及、自己掌握 Agent 的 harness 与数据

Vercel CEO Guillermo Rauch 11 月 1 日在 X 上发帖:「拥有你自己的智能。任何反对这一点的人都有东西要卖给你(也许是把你自己的智能再卖回给你)。」他认为本地模型需要继续普及,超大模型暂时跑不了本地,所以最好的选择是保持选择权:自己掌握 harness、数据、连接和运行时,也就是自己的 Agent,并拥抱开源。帖子约 12 小时内获得约 2500 赞、12.8 万浏览,100 多条引用,讨论集中在本地与云端如何取舍。

核心要点速览

  • 这是 Rauch 的个人观点帖,不是 Vercel 官方公告或产品发布。
  • 原帖(2026-11-01 21:08 UTC)约 2533 赞、255 转发、266 回复、107 引用、12.8 万浏览,581 次收藏(抓取时数据)。
  • 核心主张:本地模型要继续普及;在超大模型跑不了本地之前,保持选择权,自己掌握 harness、数据、连接、运行时和 Agent,拥抱开源。
  • Maple AI 联合创始人兼 CEO Mark(@marksuman)引用回应:会是混合形态,云端永远更强,未来要把本地优先的 AI 和私有云配合起来。
  • 工程师 Shantanu Goel(@shantanugoel)引用称「Guillermo 说出了多数人不愿说的真话」,约 37 赞。
阅读全文
关联模型 / 智能体 / 厂商:

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

Y Combinator 的研究项目 YC Labs 与多智能体环境公司 Olam Labs 10 月 29 日发布《Agents in Games》实验报告:50 个 GPT-6.1 Sol 智能体在 Minecraft 生存模式里「建设繁荣文明」3 小时,最后挤在避难所里配给口粮,发了约 5,900 条消息,搞出配给账本、许可证和各种岗位;9 局 Bed Wars 中 10 个 GPT-6.1 Sol 对 10 个 Claude Opus 5.5,GPT 以 6–3 获胜;Mindustry 50 对 50 共 7 局约 9.5 小时,GPT 以 6–1 获胜。报告还发现领导者几乎总是名册上排第一的智能体,GPT 卡住时会自己上网读游戏源码。Minecraft 智能体框架已开源。这是单一机构的实验观察,不是标准化跑分。

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

核心要点速览

  • 对抗结果:Bed Wars 9 局 GPT-6.1 Sol 6–3 胜,Mindustry 7 局 6–1 胜,合计 16 局 12 胜(见 YC Labs 报告)
  • Civ50:50 个 GPT 智能体 3 小时发约 5,900 条消息,34 次死亡中 22 次发生在第一夜,之后整体趋于保守
  • 领导者不靠选举:49 个智能体中 46 个第一条消息发给名册第一的 Ada,她共收到 616 条私信
  • 沟通风格:Bed Wars 一局中 GPT 发出 1,147 条私信、Claude 仅 82 条;GPT 越打越用压缩速记,Claude 用「+1」投票
  • 开源:Minecraft 长时运行智能体框架 yc-software/minecraft-agent-harness 已公开
阅读全文