
Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管
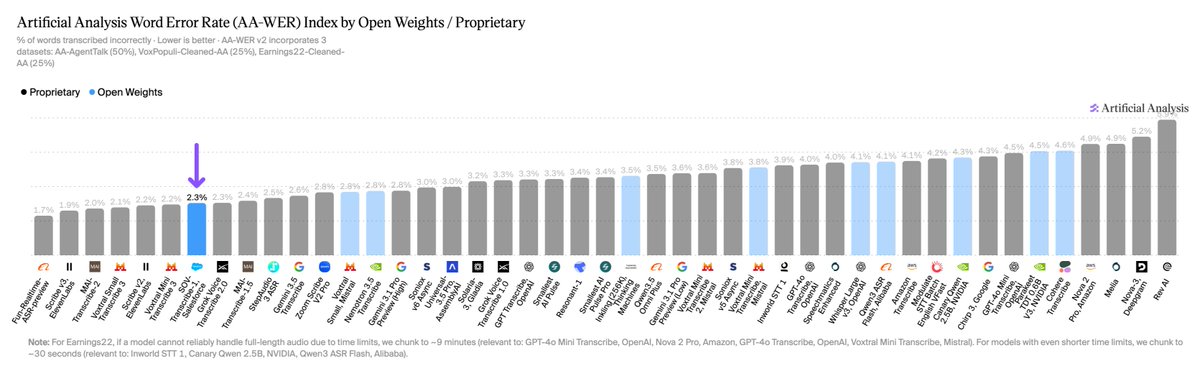
新加坡时间 11 月 13 日 00:30,Artificial Analysis(@ArtificialAnlys)发帖称,Salesforce 新发布的 SOV-Transcribe-1 成为开源权重语音转文字模型第一名:在 AA-WER 指数上词错误率 2.3%,在包括闭源模型在内的 44 个模型中排第 7。它比紧随其后的开源模型 Mistral Voxtral Small 和英伟达 Nemotron 3.5 Transcribe(均为 2.8%)低 0.5 个百分点。模型由 Salesforce 主权 AI(Missionforce Sovereign AI)团队开发,总参数 26.6B、激活参数 4.6B,结构是 Whisper large-v3 音频编码器加 Gemma 4 26B A4B MoE 解码器,权重以 Apache 2.0 许可发布在 Hugging Face。它是非流式模型,适合整段录音转写,不适合实时字幕。
核心要点速览
- AA-WER 2.3%:开源权重第 1、44 个模型中总榜第 7;Voxtral Small 与 Nemotron 3.5 Transcribe 均为 2.8%
- 分数据集:Earnings22 财报电话 4.1%(Voxtral Small 4.8%),VoxPopuli 1.5%(对手 1.8%),AA-AgentTalk 语音客服对话 1.8%,与 Nemotron 持平
- 26.6B 总参数 / 4.6B 激活;Whisper large-v3 编码器 + 投影层 + Gemma 4 26B A4B MoE;BF16,单段音频实测最长 30 分钟,支持英法德西意葡荷 7 种语言
- 官方称 VoiceCodeBench(电话号码、邮箱等实体)任务成功率 76.3%、实体召回 93.4%,23 个系统中排第 2;AppTek 14 种英语口音平均 WER 8.21%,其中 8 种口音最低(含新加坡英语)
- Apache 2.0;可用 vLLM 插件(vLLM 0.32.0)或 Transformers 部署;官方实测单张 RTX PRO 6000 Blackwell 每秒可转写 1,039 秒音频(配合 DFlash 草稿模型)
关联模型 / 智能体 / 厂商:
⚡ SOV-Transcribe-1⚡ Voxtral Small⚡ Nemotron 3.5 Transcribe⚡ Gemma 4⚡ Whisper large-v3🌐 Salesforce🌐 Artificial Analysis🌐 Mistral AI🌐 NVIDIA🌐 Google
